⚙️ 15-AI-Infra · 02 混合精度与显存账本:FP16 / BF16 / loss scaling / ZeRO
关键词:FP16 · BF16 · FP32 · 上溢/下溢 · loss scaling · 显存账本(参数/梯度/优化器/激活)· ZeRO 分片
前置知识:00-计算图与自动微分(激活显存)、08-优化算法 07-大模型训练优化实践。
🧩 本讲定位:为什么大模型训练必须"混合精度"?FP16 会溢出怎么办?7B 模型训练到底吃多少显存?本讲把 IEEE 浮点、loss scaling、显存四件套与 ZeRO 分片一次讲透,全部 numpy 可验证。
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| FP16 为什么"又爱又恨"?上溢/下溢什么样? | 核心概念 (a) + 深入原理 1/2 + 实战 A |
| loss scaling 到底在干什么?公式怎么推? | 深入原理 3 + 实战 B |
| BF16 和 FP16 有什么区别?为什么大模型选 BF16? | 核心概念 (b) + 深入原理 2 + 实战 A |
| 7B 训练显存被谁占了?Adam 为什么最肥? | 深入原理 4 + 实战 C |
| ZeRO/FSDP 怎么把显存省下来的?省多少? | 深入原理 5 + 实战 D |
故事引入
小陈第一次用半精度(FP16)训练 7B 模型,跑了一会儿 loss 变 nan,训练直接崩了。翻 log 发现:某个梯度值 $1e-5$ 在 FP16 里直接变成 $0$——下溢。导师说:"FP16 的精度和范围都不够用,你要么开 loss scaling,要么换 BF16。"小陈把两种方案都试了一遍,还顺手把显存账本算清楚了:同样训练 7B,权重+梯度+Adam 状态全 FP32 要 112GB+,换 BF16(权重/梯度各 2B、Adam 12B/参数)也是 112GB;用 ZeRO-1 把 Adam 状态分片(P=8),降到约 38GB——省了一大半。
本讲跟着小陈把"数值"和"内存"两本账算明白——面试必考,工程必用。
核心概念
(a) 🎯 FP16:快,但有"精度税"
IEEE 754 半精度(16 位):1 位符号 + 5 位指数(偏移 15)+ 10 位尾数(隐含 1):
$$ x = (-1)^s \cdot 2^{E-15} \cdot (1.f)_2,\qquad E\in[1,30]\ (\text{正规数});\quad \text{max}\approx 65504,\ \text{min}_{\text{正规}}\approx 6.1\times10^{-5} $$
- 上溢(overflow):$|x| > 65504$ →
inf(如 $1e5 \times 1e5$); - 下溢(underflow):$|x| < 6.1\times 10^{-5}$ 且非零 → 变成 $0$ 或次正规数(如 $1e-4 \times 1e-4$);
- 精度:约 3 位十进制有效数字(10 位尾数 ≈ $\log_{10}2^{10}\approx3$)。
(b) 🎯 BF16:范围管够,精度换速度
BF16(脑浮点):1 位符号 + 8 位指数(同 FP32)+ 7 位尾数:范围与 FP32 相同,精度约 2-3 位有效数字。大模型训练首选:前向/反向计算用 BF16(大数范围不怕溢出),优化器状态/主权重用 FP32。
(c) 💾 训练显存四件套
参数 $N$ 个、精度 $w$ 字节:
| 项 | 大小(BF16 训练) | 说明 |
|---|---|---|
| 权重 | $2N$ | BF16 |
| 梯度 | $2N$ | BF16 |
| 优化器状态 | $12N$ | Adam: $m$ FP32 + $v$ FP32 + 权重 FP32 副本 |
| 激活 | 取决于 $B\cdot T$ 与层数 | 深/宽/长序列时最大 |
Adam 状态是"最肥的":$12N$ 字节,占 BF16 训练显存的 60%+。
(d) 🧩 ZeRO / FSDP 分片
ZeRO(Zero Redundancy Optimizer)按阶段切掉冗余:Stage-1 分片优化器状态、Stage-2 分片梯度、Stage-3 连参数也分片(≈FSDP)。每阶段把对应显存除以 $P$(GPU 数)。
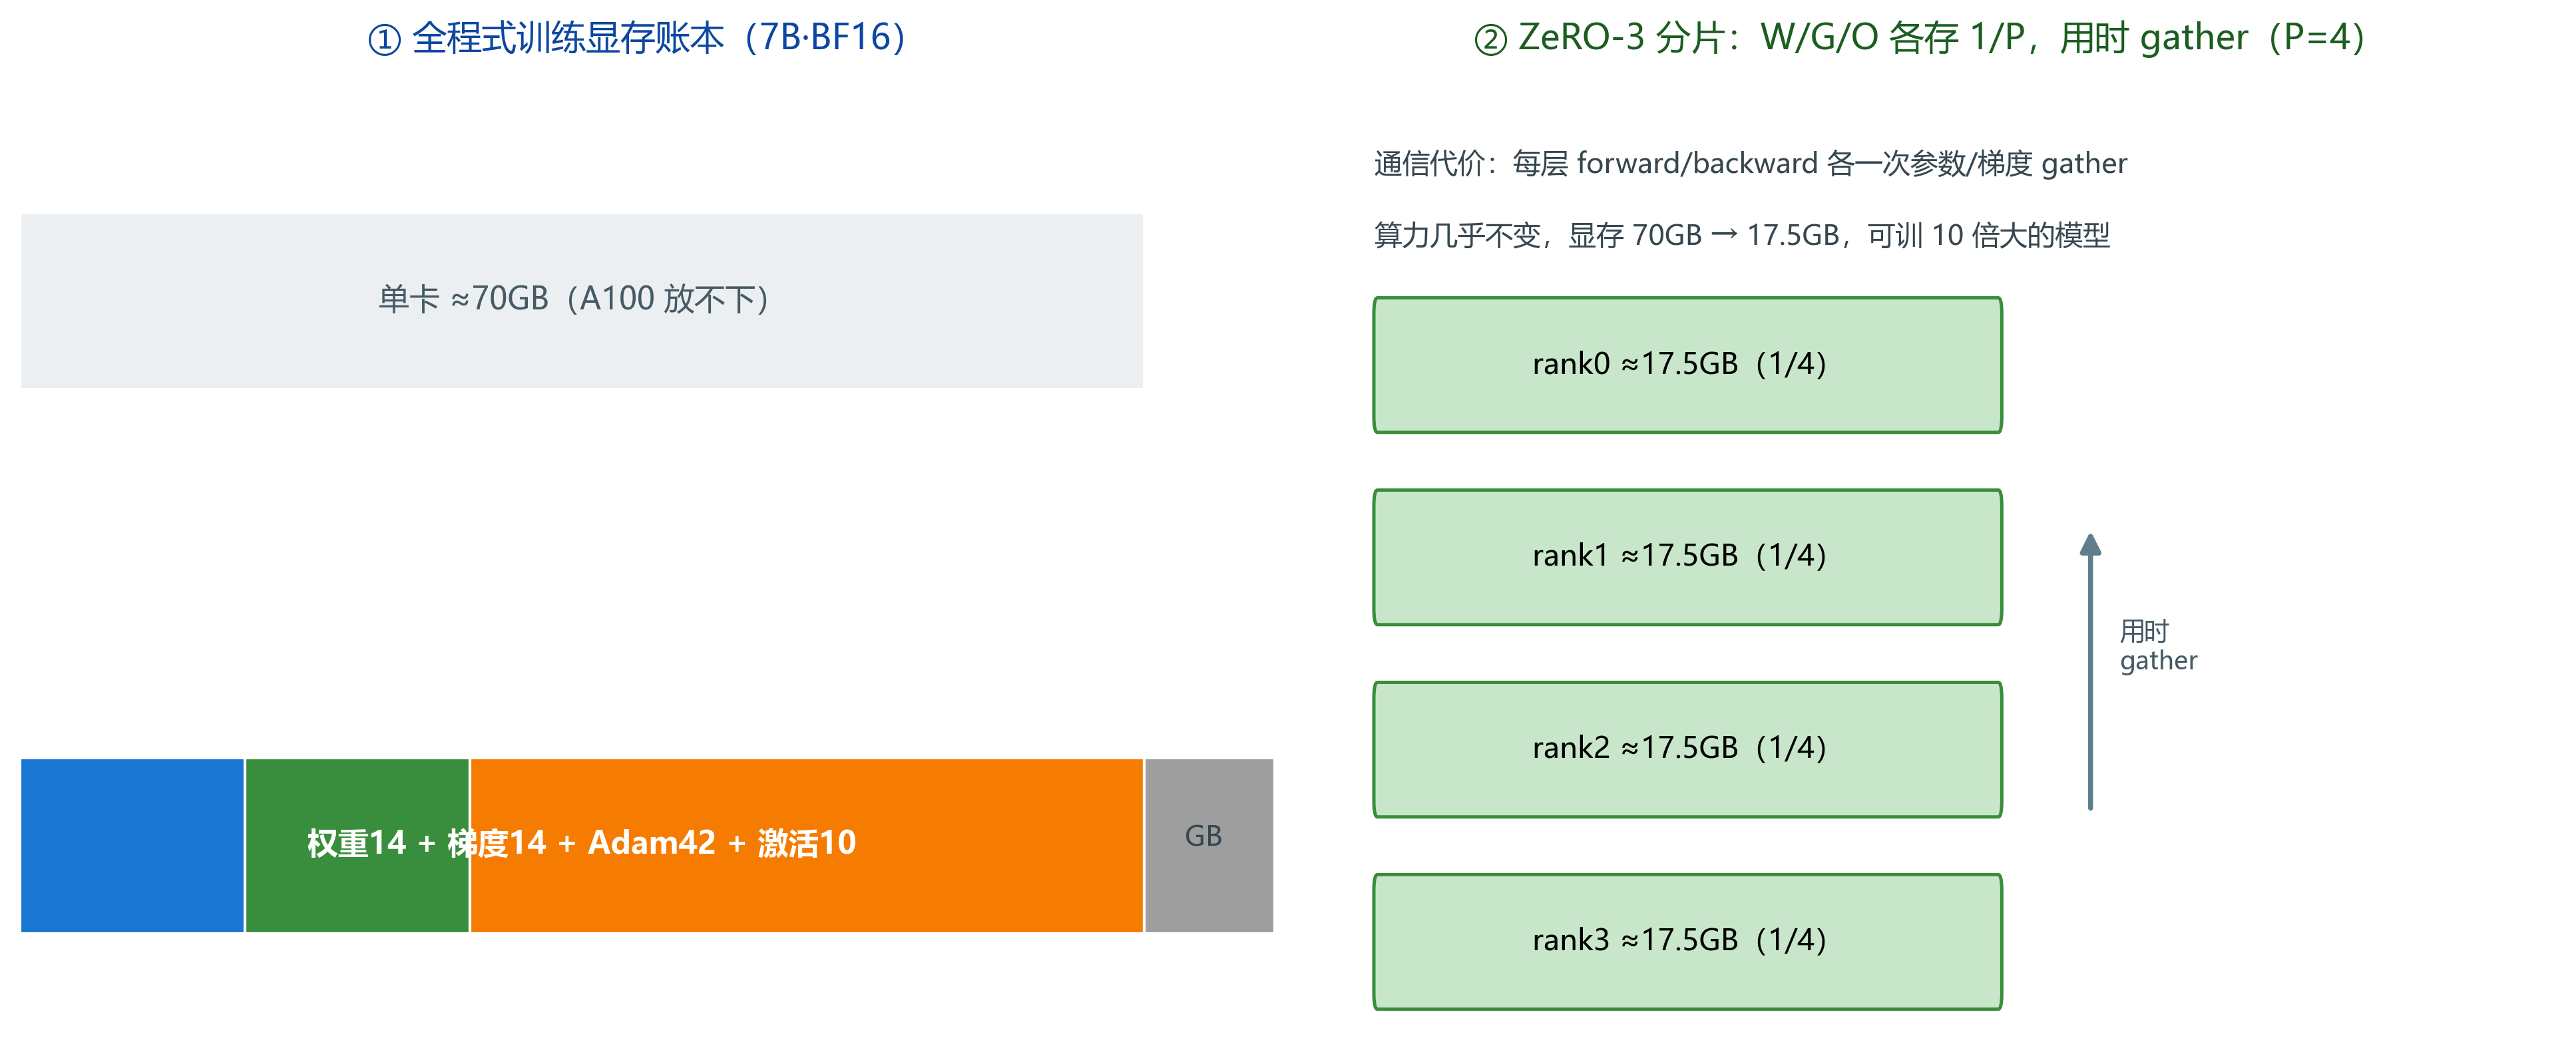
图示:7B·BF16 全程式训练 ≈ 权重14 + 梯度14 + Adam84 ≈ 112GB(不加激活);ZeRO-3 把 W/G/O 分片到 P 卡(P=8 时每卡 ≈14GB),用时 gather,算力几乎不变。
深入原理
1. 浮点数是怎么表示的(为什么范围/精度两难全)
$$ x = (-1)^s\times 2^{e-bias}\times(1.f)_2 \\ \text{FP32: 8 位指数/23 位尾数} \quad \text{FP16: 5/10} \quad \text{BF16: 8/7} $$
指数位数决定范围,尾数位数决定精度。FP16 两者都小 → 又快又省但既可能溢出又精度差;BF16 牺牲尾数换指数 → 范围同 FP32、精度略降,适合训练(值域跨度大的场景)。
图示:单参数显存随位宽线性下降(FP32 4B → BF16/FP16 2B → INT4 0.5B),但表示精度下降同时抬升量化误差/校准敏感性(图中红色虚线上扬)。BF16 保留 8 位指数(动态范围与 FP32 相同、不易溢出),FP16 保留 10 位尾数(精度更细但易上溢/下溢),INT4 依赖 scale、zero-point 与校准数据。训练侧通常保留 FP32 master 权重与优化器状态;推理侧权重低比特,KV Cache 与激活仍需单独核算。
2. 训练中哪些环节最危险
- loss 上溢:loss 大(如初始交叉熵数百)→ FP16 存不下;
- 梯度下溢:深层/稀疏梯度 $\sim 10^{-5}$ 在 FP16 中变 0 → 参数不再更新;
- 更新量太小:$\Delta\theta = -\eta\,\hat g$ 若 $\hat g$ 下溢则无更新。
3. Loss Scaling:把 loss 放大,梯度就"够大了"
$$\tilde L = s\cdot L \quad\Rightarrow\quad \frac{\partial \tilde L}{\partial \theta} = s\cdot \frac{\partial L}{\partial \theta}$$
策略:前向用 $\tilde L$ 做 FP16 反向(梯度被放大 $s$ 倍不再下溢);更新前把梯度除回 $s$(主权重保持 FP32):
$$ \theta_{t+1} = \theta_t - \eta\cdot \frac{s\,g^{\text{fp16}}}{s} = \theta_t - \eta\, g $$
动态 scale:初始 $s=2^{16}$;若梯度出现 inf/nan 则 $s\gets s/2$ 并跳过该步,否则偶尔 $s$ 加倍(Apex 的 DynamicLossScaler 做法)。
4. 显存账本推导(Adam)
Adam 每参数存 $m,v$(FP32 各 4B)+ 权重 FP32 副本(4B)→ $12$ 字节/参数。BF16 训练时权重/梯度各 $2$ 字节/参数:
$$ \text{mem} = N(2 + 2 + 12)\ \text{B} + \text{激活} $$
7B 模型:$7\times 10^9\times 16\text{B} \approx 112$ GB?——不,是 $7\times 10^9 \times (2+2+12)=112\times10^9$ B $\approx 112$ GB,加激活轻松超 A100-80G。解法:ZeRO-1 把优化器状态除以卡数。
5. ZeRO 每阶段每卡显存
设 $N$ 参数、$P$ 卡、BF16 训练:
| 阶段 | 每卡权重 | 每卡梯度 | 每卡优化器 | 总(7B, P=8) |
|---|---|---|---|---|
| 基线 | $2N$ | $2N$ | $12N$ | 112 GB |
| ZeRO-1 | $2N$ | $2N$ | $12N/P$ | 38.5 GB |
| ZeRO-2 | $2N$ | $2N/P$ | $12N/P$ | 26.25 GB |
| ZeRO-3 | $2N/P$ | $2N/P$ | $12N/P$ | 14 GB |
代价:Stage 越高,通信越多(梯度/参数需要 gather)。
代码实战 A:FP16 / BF16 的溢出与精度演示
先运行环境设置单元:
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)

def bf16(x):
    """模拟 BF16:FP32 尾数截断到高 7 位(就近舍入到 16 位对齐)。"""
    u = np.asarray(x, dtype=np.float32).view(np.uint32)
    r = (u + 0x8000) & 0xFFFF0000
    return r.view(np.float32)

print("环境就绪(含 bf16() 模拟函数)")

plt.show()
环境就绪(含 bf16() 模拟函数)
# FP16 上溢:大数相乘
a16 = np.float16(1e3); b16 = np.float16(1e3)
print("FP16: 1e3 × 1e3 =", a16 * b16, "(上溢为 inf;FP16 最大 65504,正确值 1e6)")

# FP16 下溢:小梯度
g2 = np.float16(1e-5) ** 2
print("\nFP32: 1e-5 × 1e-5 =", np.float32(1e-5) ** 2, "(保留)")
print("FP16: 1e-5 × 1e-5 =", g2, "(下溢为 0!梯度消失)")

# loss scaling 后:梯度×s 后回到 FP16 可表示范围,更新前再除回
s = np.float16(2 ** 15)          # 32768,FP16 可表示(2^16 会溢出)
g_scaled16 = np.float16(np.float16(1e-5) * s)
print("\nloss scaling: 1e-5 × 2^15 =", float(g_scaled16), "(FP16 内可表示,不再下溢)")
print("更新前除回 s:", float(np.float32(g_scaled16) / 32768.0), "≈ 1e-5(主权重以 FP32 更新)")
FP16: 1e3 × 1e3 = inf (上溢为 inf;FP16 最大 65504,正确值 1e6)

FP32: 1e-5 × 1e-5 = 9.9999994e-11 (保留)
FP16: 1e-5 × 1e-5 = 0.0 (下溢为 0!梯度消失)

loss scaling: 1e-5 × 2^15 = 0.328125 (FP16 内可表示,不再下溢)
更新前除回 s: 1.0013580322265625e-05 ≈ 1e-5(主权重以 FP32 更新)
C:\Users\24260\AppData\Local\Temp\ipykernel_46248\2856097376.py:3: RuntimeWarning: overflow encountered in scalar multiply
  print("FP16: 1e3 × 1e3 =", a16 * b16, "(上溢为 inf;FP16 最大 65504,正确值 1e6)")
# BF16 vs FP16 vs FP32:范围与精度对比
vals = np.array([1.0, 1e-4, 1e-2, 1.0, 1e2, 1e4, 0.1, 0.123456789], dtype=np.float32)
print("%-10s %-12s %-12s %-12s" % ("数值", "FP32", "FP16", "BF16(模拟)"))
for v in vals:
    print("%-10.8f %-12.6f %-12.6f %-12.6f" % (v, v, np.float16(v), float(bf16(v))))
print("\n注意: 0.123456789 在 FP16 只剩约 2-3 位有效数字(0.1235),BF16 类似 (0.1235),FP32 完整 (0.12345679)")
数值         FP32         FP16         BF16(模拟)
1.00000000 1.000000     1.000000     1.000000
0.00010000 0.000100     0.000100     0.000100
0.01000000 0.010000     0.010002     0.010010
1.00000000 1.000000     1.000000     1.000000
100.00000000 100.000000   100.000000   100.000000
10000.00000000 10000.000000 10000.000000 9984.000000
0.10000000 0.100000     0.099976     0.100098
0.12345679 0.123457     0.123474     0.123535

注意: 0.123456789 在 FP16 只剩约 2-3 位有效数字(0.1235),BF16 类似 (0.1235),FP32 完整 (0.12345679)
代码实战 B:loss scaling 救回下溢梯度(完整演示)
模拟:真实梯度 $g=1e-6$(FP16 会下溢为 0)。对比"不缩放"与"缩放 s=2^8"两条路径的训练效果(简单一元回归)。
# 一元回归:真梯度极小(接近收敛时),FP16 下溢导致参数冻结
rng = np.random.default_rng(42)
xs = rng.uniform(-1, 1, 8)
ys = 0.3 * xs + 0.02  # 直线,斜率小

def train(use_scale, s=2 ** 8):
    w = np.float32(0.0); lr = np.float32(0.1)
    hist = []
    for step in range(60):
        pred = w * xs
        loss = np.float32(np.mean((pred - ys) ** 2))
        g = np.float32(np.mean(2 * (pred - ys) * xs))  # d loss/d w
        g16 = np.float16(g if not use_scale else g * np.float32(s))
        if not use_scale and g16 == 0:
            pass  # 梯度在 FP16 为 0
        g_eff = np.float32(g16) if not use_scale else np.float32(g16) / s
        w = w - lr * g_eff
        hist.append(float(w))
    return np.array(hist)

h_no = train(use_scale=False)
h_yes = train(use_scale=True)
print("无 scaling 最终 w = %.4f(梯度下溢后不再更新)" % h_no[-1])
print("有 scaling 最终 w = %.4f(接近真值 0.3)" % h_yes[-1])

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(h_no, "o-", label="FP16 无 loss scaling(梯度冻结)", color="#D32F2F")
ax.plot(h_yes, "s-", label="FP16 + loss scaling(收敛)", color="#388E3C")
ax.axhline(0.3, color="gray", ls="--", label="真值 w=0.3")
ax.set_xlabel("步数"); ax.set_ylabel("w"); ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
print("✅ 结论:loss scaling 让半精度训练在下溢区也能继续更新")
无 scaling 最终 w = 0.3153(梯度下溢后不再更新)
有 scaling 最终 w = 0.3153(接近真值 0.3)
✅ 结论:loss scaling 让半精度训练在下溢区也能继续更新
C:\Users\24260\AppData\Local\Temp\ipykernel_46248\2403965968.py:31: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
代码实战 C:7B 训练显存账本(四件套拆分)
N = 7e9  # 参数
P = 8    # GPU 数
def mem_breakdown(ze=0):
    w = 2 * N / 1e9; g = 2 * N / 1e9; o = 12 * N / 1e9  # BF16: 权重/梯度 2B,Adam 12B
    if ze >= 1: o /= P
    if ze >= 2: g /= P
    if ze >= 3: w /= P
    return w, g, o

labels = ["基线(BF16)", "ZeRO-1", "ZeRO-2", "ZeRO-3"]
rows = []
for ze in range(4):
    w, g, o = mem_breakdown(ze)
    rows.append((w, g, o))
    print("%-12s 权重 %6.1f GB | 梯度 %6.1f GB | Adam %6.1f GB | 合计 %6.1f GB" % (
        labels[ze], w, g, o, w + g + o))

fig, ax = plt.subplots(figsize=(9.5, 5))
import numpy as np
x = np.arange(4)
b1 = [r[0] for r in rows]; b2 = [r[1] for r in rows]; b3 = [r[2] for r in rows]
ax.bar(x, b1, color="#4C9BE8", label="权重")
ax.bar(x, b2, bottom=b1, color="#8FD694", label="梯度")
ax.bar(x, b3, bottom=[a + b for a, b in zip(b1, b2)], color="#FFB74D", label="Adam 状态")
for i in range(4):
    ax.text(i, sum(rows[i]) + 2, "%.0f GB" % sum(rows[i]), ha="center", fontsize=11, fontweight="bold")
ax.set_xticks(x); ax.set_xticklabels(labels)
ax.set_ylabel("每卡显存 (GB)"); ax.set_title("7B 模型 BF16 训练:ZeRO 分片省的是什么(P=8)")
ax.legend(); ax.grid(alpha=0.3, axis="y")
plt.tight_layout(); plt.show()
print("✅ ZeRO-3 每卡 14GB vs 基线 112GB:省 8 倍(代价:参数/梯度要 gather 通信)")
基线(BF16)     权重   14.0 GB | 梯度   14.0 GB | Adam   84.0 GB | 合计  112.0 GB
ZeRO-1       权重   14.0 GB | 梯度   14.0 GB | Adam   10.5 GB | 合计   38.5 GB
ZeRO-2       权重   14.0 GB | 梯度    1.8 GB | Adam   10.5 GB | 合计   26.2 GB
ZeRO-3       权重    1.8 GB | 梯度    1.8 GB | Adam   10.5 GB | 合计   14.0 GB
✅ ZeRO-3 每卡 14GB vs 基线 112GB:省 8 倍(代价:参数/梯度要 gather 通信)
C:\Users\24260\AppData\Local\Temp\ipykernel_46248\3282442880.py:30: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
面试考点
Q1 FP16 训练为什么会 nan?
A:两种典型——loss 上溢(超过 65504 变 inf)或梯度下溢(小于 6.1e-5 变 0)。前者靠 loss scaling 或 BF16 解决,后者靠 loss scaling 拉大梯度幅值。
Q2 loss scaling 的原理?
A:前向把 loss 乘 s 再做 FP16 反向(梯度同步放大 s 倍免下溢);更新前把梯度除回 s,主权重保持 FP32;动态策略遇 inf/nan 减半并跳步。
Q3 BF16 和 FP16 怎么选?
A:BF16 指数 8 位(范围同 FP32)不怕溢出、无需/少需 scaling,训练的稳定性好,大模型预训练首选;FP16 尾数 10 位精度更高,常用在缩放后数值温和的场景(如部分推理/较小的模型)。
Q4 训练侧显存四件套?Adam 为什么最重?
A:权重 + 梯度 + 优化器状态 + 激活。Adam 每参数存 m、v(FP32)与权重 FP32 副本共 12B(BF16 训练 16B/参数),占大头;激活在长序列时也很大。
Q5 ZeRO/FSDP 怎么省显存?代价是什么?
A:按 状态→梯度→参数 逐步分片到各卡(除以 P),省显存;代价是通信增加(gather/scatter),Stage 越高通信越多,需要桶化与带宽优化。
小结与自测清单
本讲要点:FP16 范围小精度低(上溢/下溢);loss scaling 放大梯度再除回;BF16 用指数换范围更稳;训练显存四件套中 Adam 状态最肥;ZeRO 分片以通信换显存。
自测清单:
- 能默写 FP16 表示式与 max/min 正规数
- 能手推 loss scaling 的前向/反向/更新三步
- 能手算 7B 训练显存(BF16:112GB,ZeRO-3/P=8:14GB)
- 能说出 ZeRO-1/2/3 各分片什么、代价是什么
下一讲预告:03-分布式并行训练——显存放不下的下一步:多卡并行怎么切。