⚙️ 03-深度学习 · 模型笔记 6:激活函数与初始化(梯度消失观察)¶
激活函数决定梯度流,初始化决定起点。本笔记手写激活库、推导 Xavier/He、并用实验「看见」梯度消失。 本 notebook 要求:激活函数、Xavier/He 初始化全部手写 numpy,不调 torch.nn。
运行环境:Python 3.8+,仅依赖 numpy。
核心概念¶
(a) 🗂️ 激活函数与初始化知识结构¶
这篇文章回答两个问题:选什么激活函数让梯度流得动,怎么初始化让起点不偏——并用实验"看见"梯度消失与神经元死亡。
flowchart TB
    Node1["🧠 激活函数家族总览"]
    Node1 --> Node2["😴 sigmoid与tanh的饱和"]
    Node2 --> Node3["💀 ReLU与神经元死亡"]
    Node3 --> Node4["✨ Swish与GELU"]
    Node4 --> Node5["📉 梯度消失实验"]
    Node5 --> Node6["🎲 Xavier 初始化"]
    Node6 --> Node7["🎲 He 初始化"]
    Node7 --> Node8["🔁 全0初始化的对称性坑"]
    Node8 --> Node9["⚠️ 面试常见坑"]
- 激活函数家族总览:sigmoid、tanh、ReLU、LeakyReLU、ELU、Swish、GELU……每个激活都有公式、导数、输出范围和适用场景,是必背表。
- sigmoid与tanh的饱和:sigmoid 导数最大 0.25,tanh 导数最大 1,一旦输入绝对值大就进入饱和区梯度趋近 0。tanh 比 sigmoid 好在零中心,信号不单向漂移。
- ReLU与神经元死亡:ReLU 导数为 1 不饱和、计算便宜,但负半轴导数恒为 0——如果某神经元对所有样本输入恒为负,梯度永远为 0,权重再也更新不了,这就是 dead ReLU。LeakyReLU/ELU 用来缓解。
- Swish与GELU:Swish = x·σ(x),光滑非单调;GELU 是 Transformer 标配,负区接近 0 但不是硬 0,每个点都可导,没有再死的神经元。
- 梯度消失实验:sigmoid 每层乘 0.25,10 层就衰减 4^10≈10^6——固定初始化,比较 sigmoid vs ReLU 网络各层的梯度范数,一眼"看见"消失。
- Xavier 初始化:适用 tanh/sigmoid,令 Var(W)=2/(n_in+n_out),让信号在层间传播时方差不变。就是均匀分布 ±√(6/(fan_in+fan_out))。
- He 初始化:适用 ReLU,ReLU 把一半信号砍掉,所以方差要翻倍:Var(W)=2/n_in。用错组合(sigmoid 配 He)会翻车。
- 全0初始化的对称性坑:全 0 时同层神经元输入输出完全相同、梯度完全相同、更新永远同步,再宽的网络也退化成单神经元。随机初始化给每个神经元不同起点,特征才能分化。
- 面试常见坑:初始化过大 N(0,1) 深网络直接 NaN;LeakyReLU 的 He 要改成 2/(1+α²);softmax 输出层不要用 ReLU(破坏概率解释)。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Andreas Maier · CC BY 4.0
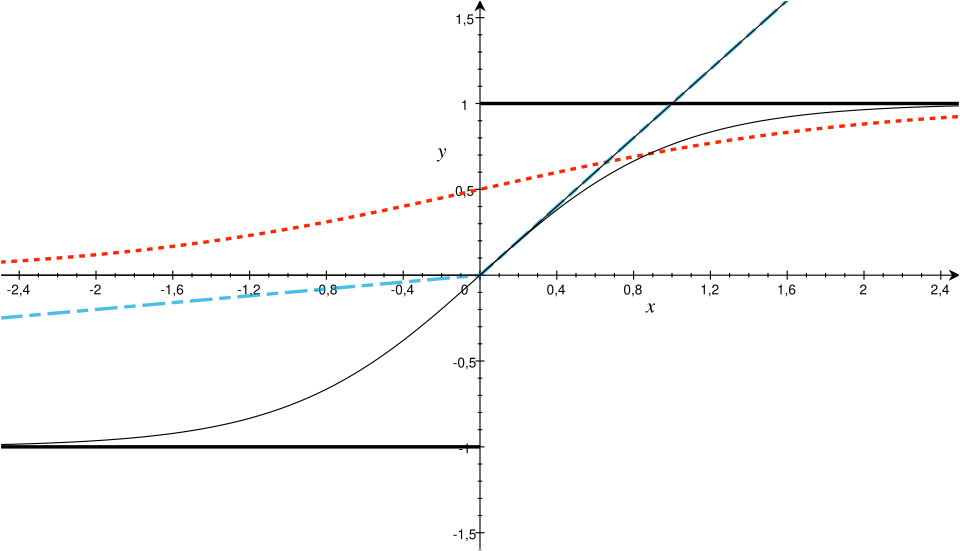
§1 激活函数家族(公式 + 导数,必背表)¶
| 激活 | 公式 $f(z)$ | 导数 $f'(z)$ | 输出范围 | 特点 |
|---|---|---|---|---|
| sigmoid | $\frac{1}{1+e^{-z}}$ | $f(1-f)$ | (0,1) | 历史原因,饱和消失 |
| tanh | $\frac{e^z - e^{-z}}{e^z + e^{-z}}$ | $1 - f^2$ | (-1,1) | 零中心,仍饱和 |
| ReLU | $\max(0, z)$ | $\mathbb{1}[z>0]$ | [0,∞) | 稀疏、快,负侧死亡 |
| LeakyReLU | $z \ (z>0);\ \alpha z$ | 1 或 $\alpha$ | 全实数 | 缓解死亡(α=0.01) |
| ELU | $z \ (z>0);\ \alpha(e^z-1)$ | 1 或 $f+\alpha$ | 全实数 | 平滑、负侧非零 |
| GELU | $z\Phi(z)$ | 见代码 | 全实数 | Transformer 标配 |
| Softmax | $\frac{e^{z_k}}{\sum_j e^{z_j}}$ | $p_k(\delta_{kj}-p_j)$ | 概率单纯形 | 输出层分类 |
为什么输出层用 sigmoid/softmax、隐藏层用 ReLU 家族:隐藏层要梯度畅通(ReLU 导数 1 不饱和),输出层要概率解释。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
import numpy as np

def sigmoid(z):
    z = np.asarray(z, dtype=float)
    out = np.empty_like(z)
    pos = z >= 0
    out[pos] = 1.0 / (1.0 + np.exp(-z[pos]))
    out[~pos] = np.exp(z[~pos]) / (1.0 + np.exp(z[~pos]))
    return out

def d_sigmoid(z):
    f = sigmoid(z)
    return f * (1 - f)

def tanh(z):
    return np.tanh(z)

def d_tanh(z):
    return 1 - np.tanh(z) ** 2

def relu(z):
    return np.maximum(z, 0)

def d_relu(z):
    z = np.asarray(z, dtype=float)   # 兼容 Python 标量(bool 没有 .astype)
    return (z > 0).astype(float)

def leaky_relu(z, alpha=0.01):
    return np.where(z > 0, z, alpha * z)

def d_leaky_relu(z, alpha=0.01):
    return np.where(z > 0, 1.0, alpha)

def gelu(z):
    # GELU ≈ 0.5z(1 + tanh(sqrt(2/pi)(z + 0.044715 z^3)))
    return 0.5 * z * (1 + np.tanh(np.sqrt(2 / np.pi) * (z + 0.044715 * z ** 3)))

print('激活数值表(z 从 -3 到 3):')
print('  z     sigmoid   tanh     relu    leaky(0.01)   gelu')
for z in [-3, -1, 0, 1, 3]:
    print(f'  {z:+d}   {sigmoid(z):.3f}   {tanh(z):+.3f}   {relu(z):.3f}   {leaky_relu(z):+.3f}      {gelu(z):+.3f}')
print('\n导数对比(z=0 附近):')
print('  sigmoid\'(0) =', round(d_sigmoid(0), 4), '(=0.25,最大也就 0.25 → 深层连乘指数衰减)')
print('  tanh\'(0) =', round(d_tanh(0), 4), '(最大 1.0)')
print('  relu\'(0+) =', d_relu(1e-9), '(导数恒 1,不衰减 → 深度网络的功臣)')
Swish / SiLU:光滑的非单调激活(补充)¶
| 函数 | 公式 | 特性 |
|---|---|---|
| Swish / SiLU | $x\cdot\sigma(x)$ | 无上界有下界、光滑、非单调,接近 0 时平滑过零 |
| GELU | $x\cdot\Phi(x)\approx 0.5x(1+\tanh(\sqrt{2/\pi}(x+0.0447x^3)))$ | Transformer 标配,光滑、负区近似 0 而非硬 0 |
ReLU vs GELU/SiLU(面试必答):ReLU 在 0 处不可导,负半轴导数恒为 0——一旦某神经元对所有训练样本的输入恒为负,其梯度就恒为 0,权重再也无法更新(神经元死亡,dead ReLU);GELU / SiLU 在整个实数域光滑可导,负区有非零梯度(GELU 负区只是"近似 0"而非硬 0),梯度信号不会完全中断,能显著缓解神经元死亡问题;代价是激活值与导数都要额外计算(sigmoid/tanh 与乘法),比 $\max(0,z)$ 稍贵,且不产生严格稀疏输出。
# ReLU 神经元死亡实验:1000 步训练后统计「梯度恒 0 / 永久冻结」的神经元数(对比 LeakyReLU)
import numpy as np

N, steps, lr = 10, 1000, 0.05

def run(act, d_act):
    """128 个样本、10 个独立神经元(单输入)做回归,返回 (全负区数, 冻结数)"""
    rng = np.random.default_rng(0)
    x = rng.normal(0, 1, (128, 1))          # 输入
    y = rng.normal(0, 1, (128, N))          # 每列一个神经元的目标
    w = rng.normal(0, 0.5, (1, N))
    b = rng.normal(-0.3, 0.3, (1, N))       # 偏置偏负 → 更容易掉进全负区
    for _ in range(steps):
        z = x @ w + b
        h = act(z)
        g = 2 * (h - y) * d_act(z) / x.shape[0]
        w -= lr * (x.T @ g)
        b -= lr * g.sum(axis=0, keepdims=True)
    z = x @ w + b
    g = 2 * (act(z) - y) * d_act(z) / x.shape[0]
    dw = lr * (x.T @ g)                     # 最终一步的权重更新
    db = lr * g.sum(axis=0, keepdims=True)
    all_neg = (z <= 0).all(axis=0)          # 对所有样本 pre-activation 全负
    frozen = (dw == 0).all(axis=0) & (db == 0).all(axis=0)   # 梯度恒 0 → 永久冻结
    return int(all_neg.sum()), int(frozen.sum())

an_r, fz_r = run(lambda z: np.maximum(z, 0), lambda z: (z > 0).astype(float))
an_l, fz_l = run(lambda z: np.where(z > 0, z, 0.01 * z), lambda z: np.where(z > 0, 1.0, 0.01))
print(f'ReLU    : 全负区 {an_r} 个,其中死亡(梯度恒0/冻结) {fz_r} 个 / {N}')
print(f'LeakyReLU: 全负区 {an_l} 个,其中冻结 {fz_l} 个 / {N}')
print('结论:ReLU 负区梯度恒 0,神经元一旦落入全负区就永久冻结(dead ReLU,无法复活);')
print('LeakyReLU 负区梯度 0.01 ≠ 0,即使全负仍持续更新,几乎不会死亡,存活率更高。')
§2 梯度消失实验(看见问题)¶
深度网络反向传播时梯度每层乘激活导数:
$$\|\delta_l\| \approx \|\delta_{L}\| \cdot \prod_{k=l}^{L-1} \|f'_k(z_k)\|\, \|W_{k+1}\|$$
sigmoid 导数最大 0.25 → 即使权重为 1,每层也衰减 4 倍 → 10 层衰减 $4^{10} \approx 10^6$。
实验:固定随机初始化,比较 sigmoid vs ReLU 网络各层梯度范数。
def layer_grad_norms(activation, depth=10, width=64, seed=0):
    """前向 20 个样本,统计反向到各层的梯度范数(无训练,只看传播)"""
    r = np.random.default_rng(seed)
    X = r.normal(0, 1, (20, width))
    Ws, zs, acts = [], [X], [X]
    for l in range(depth):
        Ws.append(r.normal(0, 1 / np.sqrt(width), (width, width)))
        z = acts[-1] @ Ws[-1]
        zs.append(z)
        acts.append(activation(z))
    y = (acts[-1] ** 2).sum()          # 假损失
    grad = 2 * acts[-1]
    norms = []
    for l in range(depth - 1, -1, -1):
        norms.append(np.linalg.norm(grad))
        if activation is sigmoid:
            dz = grad * d_sigmoid(zs[l + 1])
        else:
            dz = grad * d_relu(zs[l + 1])
        grad = dz @ Ws[l].T
    return np.array(norms)[::-1]

gn_sig = layer_grad_norms(sigmoid, depth=8, seed=0)
gn_relu = layer_grad_norms(relu, depth=8, seed=0)
print('层号 |  sigmoid 网络梯度范数 |  relu 网络梯度范数')
for l in range(len(gn_sig)):
    print(f'  {l:2d}  |     {gn_sig[l]:.4e}    |     {gn_relu[l]:.4e}')
print('\n结论:sigmoid 从输出层到输入层梯度指数衰减(消失);ReLU 梯度保持同量级')
print('消失比例(末层/首层): sigmoid = %.1e,  relu = %.2f' %
      (gn_sig[-1] / gn_sig[0], gn_relu[-1] / gn_relu[0]))
§3 初始化:Xavier 与 He 的方差推导¶
目标:让信号(前向)与梯度(反向)在层间传播时方差不变。
Xavier/Glorot(2010,适用 tanh/sigmoid):要求
$$\operatorname{Var}(W) = \frac{2}{n_{in} + n_{out}} \quad \Rightarrow \quad W \sim \mathcal{U}\Big(-\sqrt{\frac{6}{n_{in}+n_{out}}}, \sqrt{\frac{6}{n_{in}+n_{out}}}\Big)$$
推导(单层,输入零均值方差 $\sigma_x^2$,$W$ 独立零均值):
$$\sigma_y^2 = n_{in} \, \sigma_w^2 \, \sigma_x^2 \ \Rightarrow \ \sigma_w^2 = \frac{1}{n_{in}} \quad \text{(保前向方差)}$$
反向对称地要求 $\sigma_w^2 = \frac{1}{n_{out}}$ → 取调和:$\sigma_w^2 = \frac{2}{n_{in} + n_{out}}$。
He/Kaiming(2015,ReLU):ReLU 砍掉一半输出(激活后方差减半)→ 补回 2 倍:
$$\sigma_w^2 = \frac{2}{n_{in}} \quad (\text{高斯或均匀})$$
经验:sigmoid/tanh → Xavier;ReLU 家族 → He;输出层/embedding 常用小高斯(0.01)。
def xavier(fan_in, fan_out, seed=0):
    bound = np.sqrt(6 / (fan_in + fan_out))
    return np.random.default_rng(seed).uniform(-bound, bound, (fan_out, fan_in))

def he(fan_in, fan_out, seed=0):
    return np.random.default_rng(seed).normal(0, np.sqrt(2 / fan_in), (fan_out, fan_in))

def naive(fan_in, fan_out, seed=0):
    return np.random.default_rng(seed).normal(0, 1, (fan_out, fan_in))

# 方差保持实验:ReLU 网络 6 层,前向信号方差变化
def signal_var(init_fn, depth=6, width=128, seed=1):
    r = np.random.default_rng(seed)
    x = r.normal(0, 1, (50, width))
    vars_ = [x.var()]
    for l in range(depth):
        W = init_fn(width, width, seed + l)
        x = relu(x @ W.T)
        vars_.append(x.var())
    return vars_

print('层  |   naive(N(0,1))   |   He(ReLU)   ')
v_n = signal_var(naive)
v_h = signal_var(he)
for l in range(len(v_n)):
    print(f'  {l:2d} |    {v_n[l]:.3e}    |   {v_h[l]:.3e}')
print('\n观察:naive 初始化方差爆炸(>1e6);He 保持方差 O(1) —— 信号不消失也不爆炸')
print('Xavier 适用 tanh:', 'σ_w² = 2/(n_in+n_out) → 前向反向双稳(面试推导点)')
# seed 参数演示:相同 seed 完全可复现,不同 seed 得到不同权重
W_a = xavier(4, 4)             # 默认 seed=0
W_b = xavier(4, 4)             # 默认 seed=0 → 与 W_a 完全一致
W_c = xavier(4, 4, seed=1)     # 不同 seed → 不同权重
print('相同 seed(默认0) 两次调用是否一致:', np.array_equal(W_a, W_b))
print('不同 seed(0 vs 1) 权重是否不同  :', not np.array_equal(W_a, W_c))
print('W_a[:2] =', np.round(W_a[:2], 4).tolist())
✍️ §3.1 手算方差传播:为什么 He 是「2/n」,naive 会爆炸¶
§3 的推导给了公式,这里逐层手算一遍:设 $n_{in}=4$、输入方差 $\sigma_x^2=1$、$W$ 零均值独立,看信号方差在 He 与 naive 初始化下各层怎么变。
核心公式($z_j=\sum_i w_{ji}x_i$,零均值独立):
$$\sigma_z^2=n_{in}\cdot\sigma_w^2\cdot\sigma_x^2$$
He(ReLU 适用,$\sigma_w^2=2/n_{in}=0.5$):
$$\sigma_{z}^2 = 4\times \frac{2}{4}\times 1 = 2.0$$
$$\text{ReLU 后 } E[h^2] = \tfrac12 \sigma_z^2 = \tfrac12\times 2.0 = 1.0 = \sigma_x^2 \ \checkmark \ (\text{方差恢复})$$
naive($\sigma_w^2=1$):
$$\sigma_{z}^2 = 4\times 1\times 1 = 4.0 \quad\Rightarrow\quad E[h^2]=\tfrac12\times 4=2.0 \ (\text{每层 ×2})$$
多层传播表(输入方差 1.0):
| 层 L | He: Var(z) | He: E[h²] | naive: Var(z) | naive: E[h²] |
|---|---|---|---|---|
| 0 | — | 1.00 | — | 1.00 |
| 1 | 2.00 | 1.00 | 4.00 | 2.00 |
| 2 | 2.00 | 1.00 | 8.00 | 4.00 |
| 3 | 2.00 | 1.00 | 16.0 | 8.00 |
| 4 | 2.00 | 1.00 | 32.0 | 16.0 |
| 5 | 2.00 | 1.00 | 64.0 | 32.0 |
| 6 | 2.00 | 1.00 | 128 | 64.0 |
手算收获:
- He 每层把方差拉回 1(ReLU 砍半 + 2/n 补回);10 层后依然是 O(1)
- naive 每层 ×2:10 层后 $2^{10}=1024$ 倍,激活饱和/爆炸 → 梯度再被压没(消失+爆炸一手造成)
- Xavier 的均匀边界:$a=\sqrt{6/(n_{in}+n_{out})}=\sqrt{0.75}=0.866$,$\text{Var}(U)=a^2/3=0.25=2/8$ ✓ 与目标一致
下面 numpy 复算 + 单层随机实验对照。
# ---- §3.1 验证:numpy 复算方差传播表 + 单层随机实验 ----
import numpy as np

n_in = 4
print('层 L | He Var(z) | He E[h²] | naive Var(z) | naive E[h²]')
for L in range(7):
    vz_he = 0.0; vz_na = 0.0
    eh2_he, eh2_naive = 1.0, 1.0
    for _ in range(L):
        vz_he = n_in * (2 / n_in) * eh2_he          # z 方差 = n_in * Var(W) * E[h²]
        eh2_he = 0.5 * vz_he                        # ReLU 砍半
        vz_na = n_in * 1.0 * eh2_naive
        eh2_naive = 0.5 * vz_na
    print(f'  {L:2d} | {vz_he:8.2f} | {eh2_he:9.2f} | {vz_na:12.2f} | {eh2_naive:12.2f}')

# 单层随机实验(与理论对照)
rng = np.random.default_rng(0)
x = rng.normal(0, 1, (10000, 4))
W_he = rng.normal(0, np.sqrt(2 / 4), (4, 4))
h_he = np.maximum(x @ W_he, 0)
W_na = rng.normal(0, 1, (4, 4))
h_na = np.maximum(x @ W_na, 0)
print(f'\n随机实验(10000 样本):He 一层后 var={h_he.var():.3f}   naive 一层后 var={h_na.var():.3f}')
print('→ He 把 ReLU 后方差拉回输入量级(≈1);naive 膨胀数倍 → 层数一多必然爆炸/饱和')

# Xavier 均匀边界核对
bound = np.sqrt(6 / (4 + 4))
print(f'\nXavier: a=sqrt(6/8)={bound:.4f},  Var(U)=a²/3={bound**2/3:.4f} = 2/8 = {2/8:.4f} ✓')
print('✓ 手算方差表与公式一致')
为什么「全 0 初始化」不行:对称性破坏¶
初始化全 0 时,同层所有神经元的输入相同(0×输入 + 同一偏置),激活输出完全相同; 反向传播时同层神经元收到的梯度也完全相同 → 权重更新量完全相同 → 同层权重永远保持同步, 各神经元学到的特征完全一样,再宽的网络也等价于一个神经元(退化)。 随机初始化(Xavier/He)给每个神经元不同起点:输入不同 → 输出不同 → 梯度不同, 对称性被打破,各神经元才能分化出不同特征。下面用两层 MLP 手写前向 + BP 直观展示。
# 全 0 初始化 vs 随机初始化:对称性小实验(两层 MLP 3→4→1,手写前向 + BP)
import numpy as np

def train_mlp(mode='zero', steps=5, lr=0.1, seed=0):
    """返回训练 steps 步后的隐藏层输出 h(4×4) 与 W1 梯度 dW1(3×4)"""
    rng = np.random.default_rng(seed)
    X = rng.normal(0, 1, (4, 3))            # 4 个样本,3 维输入
    y = rng.normal(0, 1, (4, 1))            # 回归目标
    if mode == 'zero':
        W1, b1 = np.zeros((3, 4)), np.zeros(4)
        W2, b2 = np.zeros((4, 1)), np.zeros(1)
    elif mode == 'const':
        W1, b1 = 0.5 * np.ones((3, 4)), 0.5 * np.ones(4)
        W2, b2 = 0.5 * np.ones((4, 1)), 0.5 * np.ones(1)
    else:  # rand
        W1, b1 = rng.normal(0, 0.5, (3, 4)), rng.normal(0, 0.5, 4)
        W2, b2 = rng.normal(0, 0.5, (4, 1)), rng.normal(0, 0.5, 1)
    for _ in range(steps):
        h = np.tanh(X @ W1 + b1)            # 前向:tanh 隐藏层
        out = h @ W2 + b2
        d_out = out - y                     # L = 0.5·||out − y||²
        d_W2, d_b2 = h.T @ d_out, d_out.sum(axis=0)
        d_h = (d_out @ W2.T) * (1 - h ** 2)
        d_W1, d_b1 = X.T @ d_h, d_h.sum(axis=0)
        W1 -= lr * d_W1; b1 -= lr * d_b1
        W2 -= lr * d_W2; b2 -= lr * d_b2
    return h, d_W1

h0, g0 = train_mlp('zero')
print('\n===== 全 0 初始化(5 步训练后) =====')
print('隐藏层输出 h(4 样本 × 4 神经元):所有行/列完全相同(全 0)→ 同层神经元输出对称')
print(np.round(h0, 4))
print('W1 梯度 dW1:所有行/列完全相同(全 0)→ 权重同步(恒 0)更新,网络完全学不动')
print(np.round(g0, 4))

hr, gr = train_mlp('rand')
print('\n===== 随机初始化(5 步训练后) =====')
print('隐藏层输出 h:各神经元互不相同 → 对称性已打破,神经元开始分化')
print(np.round(hr, 4))
print('W1 梯度 dW1:各神经元互不相同')
print(np.round(gr, 4))

hc, gc = train_mlp('const')
print('\n===== 补充:相同非零常数初始化 0.5(5 步训练后) =====')
print('隐藏层输出 h:每列(神经元)完全相同 → 对称的本质是"同层相同",与值是否为 0 无关')
print(np.round(hc, 4))
print('W1 梯度 dW1:每列完全相同 → 权重仍同步更新,照样退化')
print(np.round(gc, 4))
§4 常见 bug 与边界(面试踩坑区)¶
- 初始化过大:N(0,1) 在深 ReLU 网络 → 激活爆炸 NaN(上面实验可见)
- sigmoid 不配 He:He 假设 ReLU;sigmoid 用 Xavier 才对
- LeakyReLU 的 He 修正:负斜率 α 也影响方差(α=0 就是 ReLU);大 α 时 He 的 2 要改为 2/(1+α²)
- ReLU 死亡:大量 z<0 导数 0 → 神经元永久失活;Leaky/ELU 缓解
- softmax 输出层不要 ReLU:负 logits 被压 0 破坏概率解释
- GELU 近似:精确版用误差函数 erf;tanh 近似误差 <1e-4 可忽略
- 激活与 BN 顺序:BN 前向要看到线性输出(z),激活放 BN 后是常见选择
§6 自测清单(L1 必会 / L2 进阶 / L3 挑战)¶
L1 必会(10 问)¶
- 1. 默写 sigmoid/tanh/ReLU 公式与导数
- 2. 手写激活函数库(含导数)
- 3. 解释 sigmoid 梯度消失(0.25 上限连乘)
- 4. 手写梯度消失观察实验
- 5. Xavier 公式与适用激活
- 6. He 公式与适用激活
- 7. 推导 σ_w² = 1/n_in(前向方差保持)
- 8. 为什么 ReLU 要补 2 倍方差
- 9. 手写 LeakyReLU/ELU 及导数
- 10. 说明输出层为何用 softmax
L2 进阶(10 问)¶
- 11. 手写信号方差传播实验(naive vs He)
- 12. 推导 Xavier 的均匀分布边界 √(6/(n_in+n_out))
- 13. 手写反向梯度方差保持推导
- 14. ReLU 死亡神经元观察实验(输出占比)
- 15. 手写 GELU 精确版(erf)与近似版对比
- 16. LeakyReLU α 对收敛的影响实验
- 17. 手写残差连接下深度网络训练
- 18. 对比多种激活在同任务收敛曲线
- 19. 初始化与 BN 的协同(先用哪个)
- 20. 手写 Orthogonal 初始化
L3 挑战(5 问)¶
- 21. 推导 He 初始化的严格方差分析(含 α)
- 22. 手写 Fixup/Zero-init(无 BN 深度训练)
- 23. 分析 GELU 与 SiLU/Swish 的关系
- 24. 手写 spectral norm 初始化/约束
- 25. 对比 Transformer 初始化方案(GPT-2 尺度)
自测要点¶
- 白板推导:Xavier 方差保持(前向+反向)
- 10 分钟内默写激活导数表
- 讲清「为什么现代网络用 ReLU 家族 + He」