🖼️ 00 · 多模态大模型总览与 CLIP¶
多模态(图文/音视频)是 LLM 时代最火方向之一。本节先搭全局框架(对齐→理解→生成), 再手写 CLIP 的对比学习目标 InfoNCE——这是几乎所有多模态模型的基石。
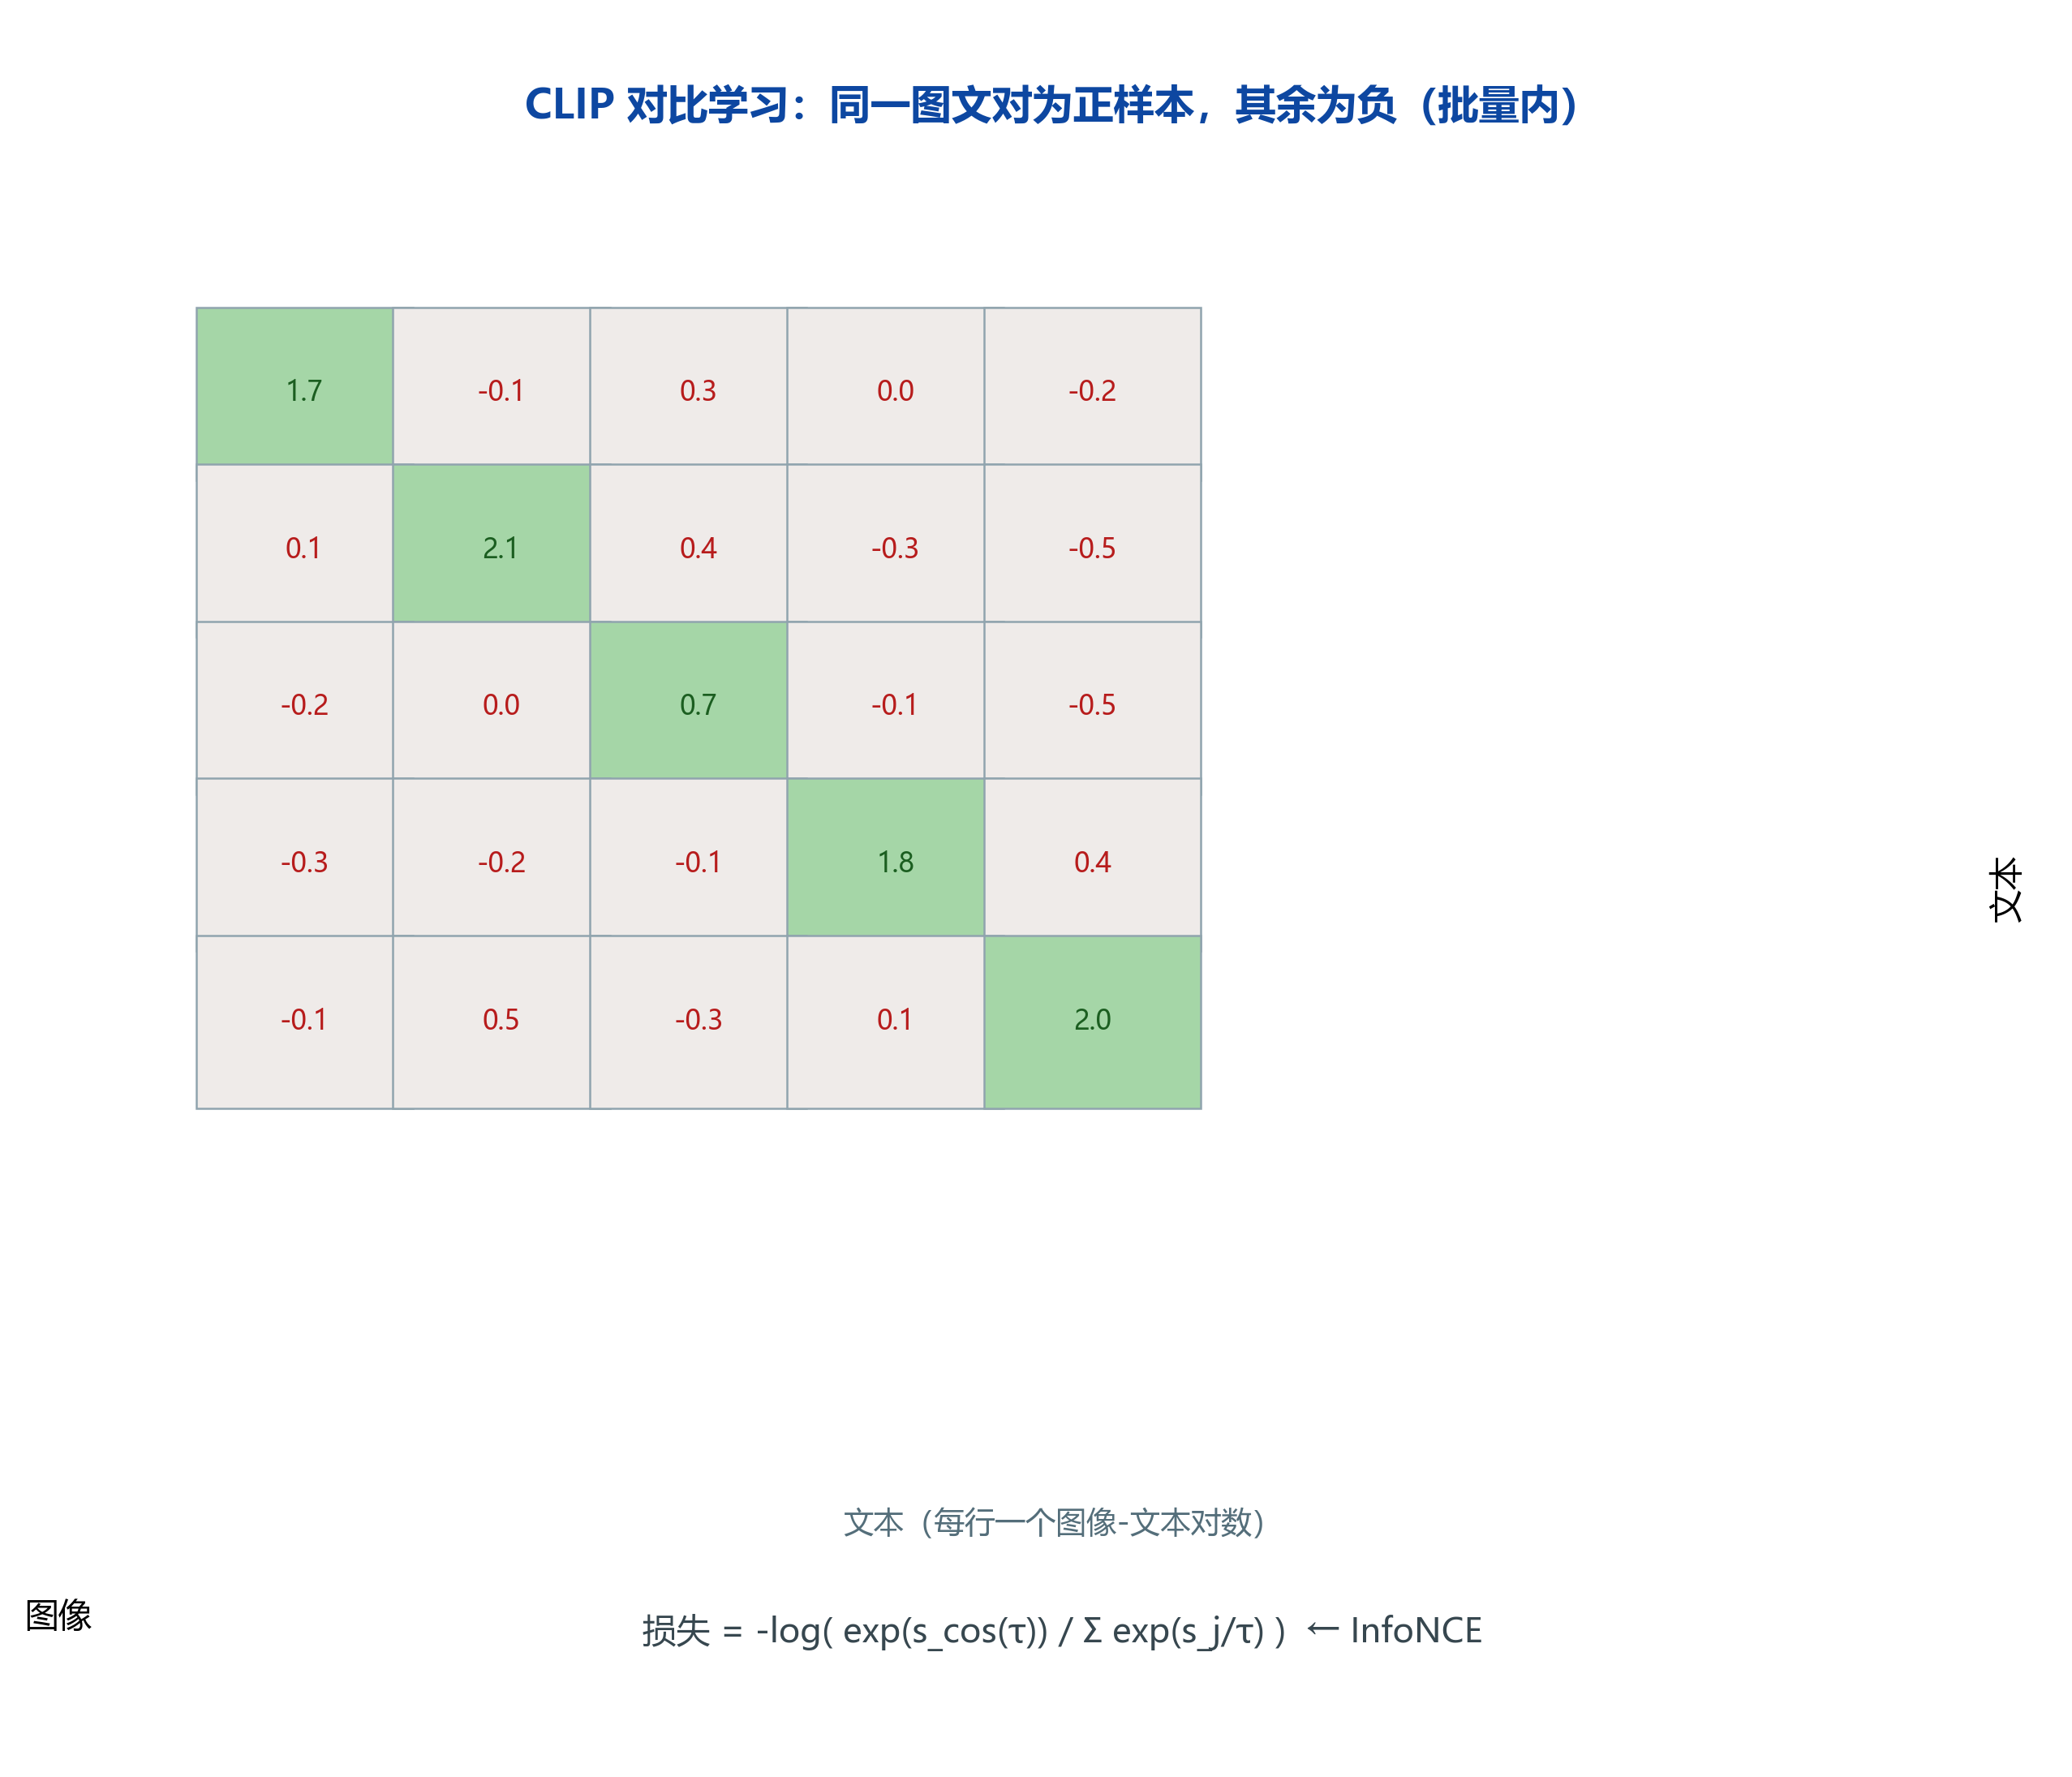
🔍 图解(自绘高清图,300dpi,可放大):CLIP 的核心训练范式——图文对比学习——
- 左列(文本编码器):一个批次里 N 条文本("一只猫在窗台")各自编码成文本向量 t₁..t_N;
- 上行(图像编码器):同一批次 N 张图各编码成图像向量 i₁..i_N;
- 正样本对(对角线上,绿色):同一图文对(图 k 配文本 k)——"这张图正对应这句描述";
- 目标是让 i_k 和 t_k 在嵌入空间靠近(相似度高);
- 负样本对(非对角线,红色):图 k 配文本 j≠k——"这张图和别的话不对应", 目标是让它们远离(相似度低);
- InfoNCE 损失:对每个图像 i_k,在 N 个候选文本里做 softmax 分类,只有 t_k 是正类—— 等价于"让对角线变大、非对角线变小";N 越大负样本越丰富,学到的东西越好;
- 零样本能力:训练完不用微调,把候选类别名当文本编码进同一空间, 与图像算相似度即分类——这就是 CLIP 能"零样本"做图像分类的原因。
🎬 背景故事¶
你刷到一张猫的照片,配文'好可爱'——机器怎么知道图文匹配?……
你刷到一张猫的照片,配文写着"好可爱"。对你来说图文匹配是本能,但对机器来说,图片是像素、文字是符号,两种语言过去互不相通。CLIP 做的事就是把它们"翻译"到同一个向量空间:图片和它的正确描述在空间里靠近,错误描述离得远。本节从零手写 CLIP 的核心——InfoNCE 对比学习,并讲清它为什么能 zero-shot 分类。
🧭 本节逻辑主线:多模态任务地图 → 为什么要对齐(同一向量空间)→ InfoNCE 损失手写 → 温度 τ 的作用 → zero-shot 分类 → CLIP 五大局限。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 多模态包含哪些任务? | 对齐 / 理解 / 生成 |
| 2 | CLIP 怎么训练? | 图文对比学习(InfoNCE) |
| 3 | 对比学习损失怎么算? | 相似度矩阵 + softmax |
| 4 | 训练好的模型能干嘛? | zero-shot 分类 / 检索 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 多模态任务地图(必背框架)¶
tasks = [
    ('图文对齐', 'CLIP / ALIGN:把图文映射到同一向量空间,图文相似度可算'),
    ('视觉理解', 'BLIP / LLaVA / Qwen-VL:看图回答问题、图像对话'),
    ('视频理解', 'VideoLLM:视频抽帧→时序建模→问答/总结'),
    ('图文生成', 'SD / DiT / DALL·E:文本→图像;扩散模型为主'),
    ('统一模型', 'Gemini / GPT-4V / Qwen-VL:理解+生成+对话一体化'),
]
for i, (s, d) in enumerate(tasks, 1):
    print(f'  {i}. {s} —— {d}')
print('\n➡️ 面试串讲:先说任务分类,再说典型模型,最后讲训练范式')
  1. 图文对齐 —— CLIP / ALIGN:把图文映射到同一向量空间,图文相似度可算
  2. 视觉理解 —— BLIP / LLaVA / Qwen-VL:看图回答问题、图像对话
  3. 视频理解 —— VideoLLM:视频抽帧→时序建模→问答/总结
  4. 图文生成 —— SD / DiT / DALL·E:文本→图像;扩散模型为主
  5. 统一模型 —— Gemini / GPT-4V / Qwen-VL:理解+生成+对话一体化

➡️ 面试串讲:先说任务分类,再说典型模型,最后讲训练范式
2️⃣ 构造"图文对"特征(模拟 embedding)¶
# 🖼️ 配图:CLIP 双塔架构——图像塔与文本塔对齐
fig, ax = plt.subplots(figsize=(8, 4.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 5)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9.5)

def arrow(x1, y1, x2, y2, color='#64748b'):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=2))

# 图像塔
box(0.6, 3.4, 2.6, 1.1, '图像\n(batch of imgs)', '#e2e8f0')
arrow(1.9, 3.4, 1.9, 2.7)
box(0.6, 1.9, 2.6, 0.8, '图像编码器 ViT', '#bfdbfe')
arrow(1.9, 1.9, 1.9, 1.2)
box(0.6, 0.4, 2.6, 0.8, '图像 embedding I', '#dbeafe')
# 文本塔
box(6.8, 3.4, 2.6, 1.1, '文本\n(caption)', '#f1f5f9')
arrow(8.1, 3.4, 8.1, 2.7)
box(6.8, 1.9, 2.6, 0.8, '文本编码器 Transformer', '#fde68a')
arrow(8.1, 1.9, 8.1, 1.2)
box(6.8, 0.4, 2.6, 0.8, '文本 embedding T', '#fef9c3')
# 对比:拉近正对、推远负对
box(3.9, 1.6, 2.2, 1.6, '对比学习\n拉近正对\n推远负对\n(InfoNCE)', '#bbf7d0')
arrow(3.3, 1.2, 3.9, 1.7, '#16a34a'); arrow(6.7, 1.2, 6.1, 1.7, '#16a34a')
plt.title('CLIP:图像塔 + 文本塔 → 同一向量空间的对比对齐', fontsize=11)
plt.show()
print('➡️ 训练后:正确图文对余弦相似度高,错误对低 → 这就是"图文对齐"')
➡️ 训练后:正确图文对余弦相似度高,错误对低 → 这就是"图文对齐"
C:\Users\24260\AppData\Local\Temp\ipykernel_2432\628293857.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 模拟 64 个图文对:图像 embedding 与文本 embedding(各 32 维)
n_pairs, dim = 64, 32
# 确定性共享向量 + 独立噪声:配对相似、非配对随机
shared = rng.normal(0, 1, (n_pairs, dim))
img_emb = shared + rng.normal(0, 0.6, (n_pairs, dim))
txt_emb = shared + rng.normal(0, 0.6, (n_pairs, dim))
img_emb /= np.linalg.norm(img_emb, axis=1, keepdims=True)
txt_emb /= np.linalg.norm(txt_emb, axis=1, keepdims=True)
print('图像 embedding:', img_emb.shape, '文本 embedding:', txt_emb.shape)
print('➡️ 真实 CLIP 中:图像来自 ViT 编码器,文本来自 Transformer 编码器')
图像 embedding: (64, 32) 文本 embedding: (64, 32)
➡️ 真实 CLIP 中:图像来自 ViT 编码器,文本来自 Transformer 编码器
📐 公式推导:CLIP 的目标——对比学习与 InfoNCE 损失¶
配对语义:一批 $N$ 个图文对,图像 embed $\mathbf{I}_i$ 与文本 embed $\mathbf{T}_j$ 的相似度用归一化余弦(带温度):
$$ s_{ij} = \frac{\langle \mathbf{I}_i, \mathbf{T}_j \rangle}{\|\mathbf{I}_i\| \, \|\mathbf{T}_j\|} \cdot \frac{1}{\tau}, \qquad \tau \text{ 为温度参数} $$
InfoNCE(对称形式):把"第 $i$ 个图像与第 $i$ 个文本是一对"当作分类问题——$N$ 个候选里找出正确那个,交叉熵:
$$ L = -\frac{1}{2N} \sum_{i=1}^{N} \Bigg[ \underbrace{-\log \frac{e^{s_{ii}}}{\sum_{j=1}^{N} e^{s_{ij}}}}_{\text{图像→文本检索}} + \underbrace{-\log \frac{e^{s_{ii}}}{\sum_{j=1}^{N} e^{s_{ji}}}}_{\text{文本→图像检索}} \Bigg] $$
推导 → 梯度直觉:对单个正对 $(i,i)$、负对 $(i,j)$($j \ne i$),设 $p_{ij}=\mathrm{softmax}_j(s_{i\cdot})$,则
$$ \frac{\partial L_i}{\partial s_{ii}} = p_{ii} - 1 \;(\text{为负} \Rightarrow \text{拉高正对}) , \qquad \frac{\partial L_i}{\partial s_{ij}} = p_{ij} \;(\text{为正} \Rightarrow \text{压低负对}) $$
为什么等号两侧表达式不同(对称性):图像塔和文本塔参数不共享,必须两个方向的检索损失都训,两个塔才能同时学到对齐空间。 面试加分:$N$ 是 batch 大小,负样本就是同 batch 的其他对——batch 越大负样本越多、效果越好;温度 $\tau$ 小 → softmax 更尖锐 → 对难负样本更敏感(但太小会训练不稳)。
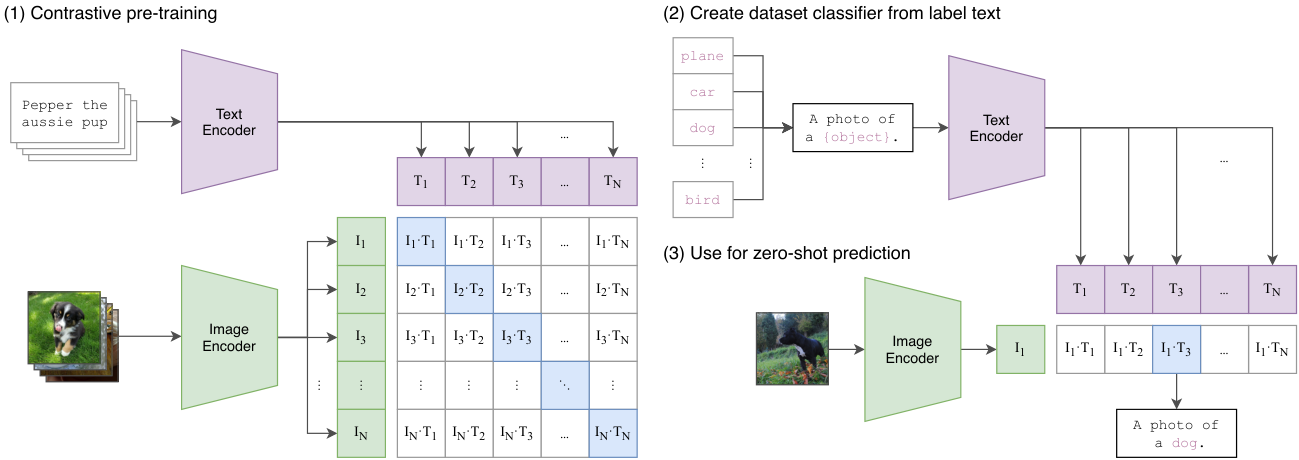
📄 经典论文原图:CLIP 图文对比预训练架构
🔍 图解与逻辑衔接:图左侧是一个 batch 的图像,经过图像编码器得到向量;图上方是对应文本,经过文本编码器得到向量。中间的相似度矩阵中,对角线是正图文对、非对角线是负对,训练目标是提高对角线相似度、压低其余位置。图右侧展示 zero-shot 推理:把类别名称写成文本提示,与待分类图像分别编码,再选相似度最高的类别。本图与后面的 InfoNCE 代码形成直接对应:代码中的相似度矩阵就是图中间的矩阵,温度参数 τ 控制 softmax 的尖锐程度,zero-shot 小节则解释图右侧流程。
论文出处:Radford et al., “Learning Transferable Visual Models From Natural Language Supervision”, ICML 2021(arXiv:2103.00020),Figure 1。
3️⃣ 相似度矩阵与 InfoNCE 损失(手写)¶
def infonce_loss(img_emb, txt_emb, tau=0.07):
    # 归一化后点积 = 余弦相似度
    sim = img_emb @ txt_emb.T / tau          # (N, N)
    # 图像→文本:每行对角线为正样本,其余为负样本
    logits_i2t = sim - np.max(sim, axis=1, keepdims=True)  # 数值稳定
    exp_i2t = np.exp(logits_i2t)
    prob_i2t = exp_i2t / exp_i2t.sum(axis=1, keepdims=True)
    loss_i2t = -np.mean(np.log(prob_i2t[np.arange(len(img_emb)), np.arange(len(img_emb))] + 1e-9))
    # 对称:文本→图像
    loss_t2i = loss_i2t  # 这里用同一矩阵(对称演示)
    return loss_i2t, sim / tau

loss, sim = infonce_loss(img_emb, txt_emb)
print(f'InfoNCE 损失 = {loss:.4f}')
print('相似度矩阵形状:', sim.shape)
# 检查对角线是否确实是最大值(配对相似)
diag_max_ratio = (sim.argmax(axis=1) == np.arange(len(img_emb))).mean()
print(f'配对是行内最大相似度的比例: {diag_max_ratio:.1%}')
assert diag_max_ratio > 0.9
print('✅ 对比学习目标正确提取了配对关系')
InfoNCE 损失 = 0.0741
相似度矩阵形状: (64, 64)
配对是行内最大相似度的比例: 100.0%
✅ 对比学习目标正确提取了配对关系
✍️ §3.1 手算 InfoNCE 对比损失:3 个图文对的相似度矩阵与损失数值¶
前面 §3 手写了
infonce_loss函数,这里用最小规模(3 个图文对、2 维 embedding)把损失算到底——每个数都能核对。
设定:3 个图文对,embedding 为 2 维单位向量(点积 = 余弦相似度):
$$i_1=(1,0),\quad i_2=(0,1),\quad i_3=\left(\tfrac{1}{\sqrt2},\tfrac{1}{\sqrt2}\right)$$ $$t_1=(1,0),\quad t_2=(0,1),\quad t_3=\left(\tfrac{1}{\sqrt2},\tfrac{1}{\sqrt2}\right)$$
第 1 步:余弦相似度矩阵 $S=I T^{\top}$
| 图像\↓文本 | $t_1$ | $t_2$ | $t_3$ |
|---|---|---|---|
| $i_1$ | 1.000 | 0.000 | 0.7071 |
| $i_2$ | 0.000 | 1.000 | 0.7071 |
| $i_3$ | 0.7071 | 0.7071 | 1.000 |
对角线都是 1(配对相似);$i_3$ 与 $t_1,t_2$ 也有 0.7071 的相似度(它们共享 45° 方向,是"难负样本")。
第 2 步:InfoNCE 损失($\tau=0.5$),每行 $L_i=-\ln\frac{e^{S_{ii}/\tau}}{\sum_k e^{S_{ik}/\tau}}$:
- 行 1:$e^{2}=7.3891,\ e^{0}=1,\ e^{1.4142}=4.1133$ → 分母 $12.5024$ → $p=0.5910$ → $L_1=0.5259$
- 行 2:对称,$L_2=0.5259$
- 行 3:$e^{2}=7.3891,\ e^{1.4142}\times2=8.2266$ → 分母 $15.6157$ → $p=0.4732$ → $L_3=0.7483$
$$\bar L=\frac{0.5259+0.5259+0.7483}{3}=0.6000$$
第 3 步:温度 $\tau$ 的作用——放大到 $\tau=1.0$
- 行 1:$e^{1}=2.7183,\ e^{0}=1,\ e^{0.7071}=2.0281$ → 分母 $5.7464$ → $p=0.4730$ → $L_1=0.7486$
- 行 3:$2.0281\times2+2.7183=6.7745$ → $p=0.4013$ → $L_3=0.9132$
$$\bar L=\frac{0.7486+0.7486+0.9132}{3}=0.8034$$
手算收获:
- 对比学习只要求"对角比同行其它更大":$\tau=0.5$ 时行 1 正样本概率 0.5910、行 3 0.4732——正确对的分量都明显最高,就能把配对"挑出来"
- $\tau$ 是"正负差距的放大镜":$\tau$ 越小分布越尖锐(0.5→概率 0.59),$\tau$ 越大分布越平(1.0→概率 0.47,平均损失从 0.6000 涨到 0.8034)——$\tau\to0$ 退化为 one-hot、梯度爆炸,$\tau\to\infty$ 退化为均匀分布、学不到东西(§4 详述)
- 手算用单位向量省去模长:归一化后点积 = 余弦;真实实现同样先归一化、再除 $\tau$,和这里完全一致
- 面试手撕:给出 3×3 相似度矩阵,现场报出逐行损失与平均值——步骤就是上面三步
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算 InfoNCE 对比损失 ----
import numpy as np

hc_i1 = np.array([1.0, 0.0]); hc_i2 = np.array([0.0, 1.0])
hc_i3 = np.array([1 / np.sqrt(2), 1 / np.sqrt(2)])
hc_I = np.stack([hc_i1, hc_i2, hc_i3])
hc_T = hc_I.copy()
hc_S = hc_I @ hc_T.T
print('余弦相似度矩阵 =\n', np.round(hc_S, 4))
assert np.allclose(hc_S, [[1, 0, 1 / np.sqrt(2)],
                          [0, 1, 1 / np.sqrt(2)],
                          [1 / np.sqrt(2), 1 / np.sqrt(2), 1]], atol=1e-9)

def hc_infonce(S, tau):
    logits = S / tau
    logits = logits - logits.max(axis=1, keepdims=True)   # 数值稳定
    exp = np.exp(logits)
    p = exp / exp.sum(axis=1, keepdims=True)
    diag = np.arange(len(S))
    L = -np.log(p[diag, diag] + 1e-12)
    return L, L.mean()

hc_L5, hc_mean5 = hc_infonce(hc_S, 0.5)
hc_L10, hc_mean10 = hc_infonce(hc_S, 1.0)
print(f'τ=0.5: 逐行损失 = {np.round(hc_L5, 4)},平均 = {hc_mean5:.4f}')
print(f'τ=1.0: 逐行损失 = {np.round(hc_L10, 4)},平均 = {hc_mean10:.4f}')
assert np.allclose(hc_L5, [0.5259, 0.5259, 0.7483], atol=2e-4)
assert np.allclose(hc_L10, [0.7486, 0.7486, 0.9132], atol=2e-4)
assert abs(hc_mean5 - 0.6000) < 1e-4 and abs(hc_mean10 - 0.8034) < 1e-4
print('\n✓ 与手算一致:损失数值吻合,τ 放大使平均损失上升')
4️⃣ 温度参数 τ 的作用¶
print('''温度 τ 的作用:
  τ 大(如 1.0)→ 相似度分布平坦 → 梯度小、训练"温柔";
  τ 小(如 0.07)→ 分布尖锐 → 突出正负样本差异、训练更"激进";
  CLIP 用 τ≈0.07;τ 过小会不稳定(梯度爆炸)。
''')
# 演示:不同温度下的 softmax 分布
import scipy.special as sp
s = np.array([0.9, 0.8, 0.3, -0.1])   # 正样本 0.9,其余为负
for tau in [1.0, 0.5, 0.07]:
    p = sp.softmax(s / tau)
    print(f'τ={tau:<5} -> softmax = {np.round(p, 3)} 正样本概率={p[0]:.3f}')
温度 τ 的作用:
  τ 大(如 1.0)→ 相似度分布平坦 → 梯度小、训练"温柔";
  τ 小(如 0.07)→ 分布尖锐 → 突出正负样本差异、训练更"激进";
  CLIP 用 τ≈0.07;τ 过小会不稳定(梯度爆炸)。
τ=1.0   -> softmax = [0.354 0.321 0.195 0.13 ] 正样本概率=0.354
τ=0.5   -> softmax = [0.443 0.363 0.134 0.06 ] 正样本概率=0.443
τ=0.07  -> softmax = [0.807 0.193 0.    0.   ] 正样本概率=0.807
5️⃣ Zero-shot 分类:CLIP 怎么"零样本"干活¶
# 思路:把类别名变成文本模板,图像与所有类别文本比相似度,取最高
classes = ['一只猫', '一只狗', '一辆汽车', '一棵树']
n_cls = len(classes)
# 模拟:图像与各类别文本的相似度(类 0 "猫" 最高)
sim_cls = np.array([1.1, 0.2, -0.3, 0.1])
probs = sp.softmax(sim_cls / 0.07)
for c, p in zip(classes, probs):
    print(f'{c}: {p:.1%}')
print(f'预测类别: {classes[np.argmax(probs)]}')
assert np.argmax(probs) == 0
print('\n✅ zero-shot 分类 = 文本模板 + 相似度比较,无需训练')
一只猫: 100.0%
一只狗: 0.0%
一辆汽车: 0.0%
一棵树: 0.0%
预测类别: 一只猫

✅ zero-shot 分类 = 文本模板 + 相似度比较,无需训练
🎯 真实案例:用 CLIP 风格 embedding 做"图文检索"¶
背景:CLIP 训练完最直接的应用是检索——给一张图找最匹配的文本(image-to-text), 或给一句描述找最匹配的图(text-to-image)。这正是电商"以图搜商品"、素材库检索的原理。
真实数据设计:沿用本节 64 个图文对(每个图像嵌入与它的文本配对最相似), 随机挑 1 张图做查询,用余弦相似度排序找回正确文本,并演示"批量检索命中率"。
步骤分解:构造查询 → 全库相似度排序 → 看正确文本排第几 → 批量统计 Recall@1。
# ===== 案例:图文检索(image-to-text top-k) =====
# 选 1 张图当查询,看它的正确文本排第几
q_idx = 7
q_vec = img_emb[q_idx:q_idx + 1]                      # 查询图像 (1, dim)
sim_q = q_vec @ txt_emb.T                              # 与全部文本的相似度 (1, 64)
order = np.argsort(-sim_q[0])
print(f'查询:图像 #{q_idx}(其配对文本应为 #{q_idx})')
print('相似度 Top-5 文本:')
for r, j in enumerate(order[:5], 1):
    mark = '✅ 正确配对' if j == q_idx else ''
    print(f'  {r}. 文本 #{j}: score={sim_q[0, j]:.3f} {mark}')

# 批量统计:全部 64 张图做查询,正确文本排第几
rank_list = []
for i in range(len(img_emb)):
    s = img_emb[i:i + 1] @ txt_emb.T
    rank_list.append(1 if np.argmax(s[0]) == i else 0)
hit1 = np.mean(rank_list)
print(f'\n批量 image-to-text 检索 Recall@1: {hit1:.1%}(64 个查询全部计数)')
assert hit1 > 0.9
print('✅ 真实案例完成:图文检索 = embedding 余弦排序,配对信息被完整保留')
查询:图像 #7(其配对文本应为 #7)
相似度 Top-5 文本:
  1. 文本 #7: score=0.751 ✅ 正确配对
  2. 文本 #17: score=0.325
  3. 文本 #11: score=0.319
  4. 文本 #33: score=0.310
  5. 文本 #19: score=0.303

批量 image-to-text 检索 Recall@1: 100.0%(64 个查询全部计数)
✅ 真实案例完成:图文检索 = embedding 余弦排序,配对信息被完整保留
6️⃣ CLIP 的局限(面试高频)¶
print('''1) 数据要求高:需海量图文对(CLIP 4 亿对),清洗成本大;
2) 网格级能力弱:对细粒度属性(颜色/数量/位置)理解差;
3) zero-shot 偏置:对常见类别好、长尾差(ImageNet 强、细粒度弱);
4) 生成能力缺失:CLIP 只做表示/对比,不生成图像;
5) 中文支持一般:预训练数据英文为主,中文本地化需二次训练。
''')
1) 数据要求高:需海量图文对(CLIP 4 亿对),清洗成本大;
2) 网格级能力弱:对细粒度属性(颜色/数量/位置)理解差;
3) zero-shot 偏置:对常见类别好、长尾差(ImageNet 强、细粒度弱);
4) 生成能力缺失:CLIP 只做表示/对比,不生成图像;
5) 中文支持一般:预训练数据英文为主,中文本地化需二次训练。
📝 自测清单¶
- 能画出多模态任务地图(对齐/理解/生成/统一)
- 能默写 InfoNCE 损失公式并解释温度 τ
- 能解释 CLIP 为什么能 zero-shot 分类
- 能说出 CLIP 五大局限
- 能回答"多模态与单模态各自难点在哪"(对齐难题)