🧠 01 · 图卷积网络 GCN:手写消息传递 + 半监督节点分类¶
GCN 是 GNN 的第一课。本节从拉普拉斯归一化出发,手写两层 GCN: 消息传递(聚合邻居)、归一化邻接、ReLU 激活、softmax 分类, 并可视化叠加 K 层=感受野 K 跳邻居。
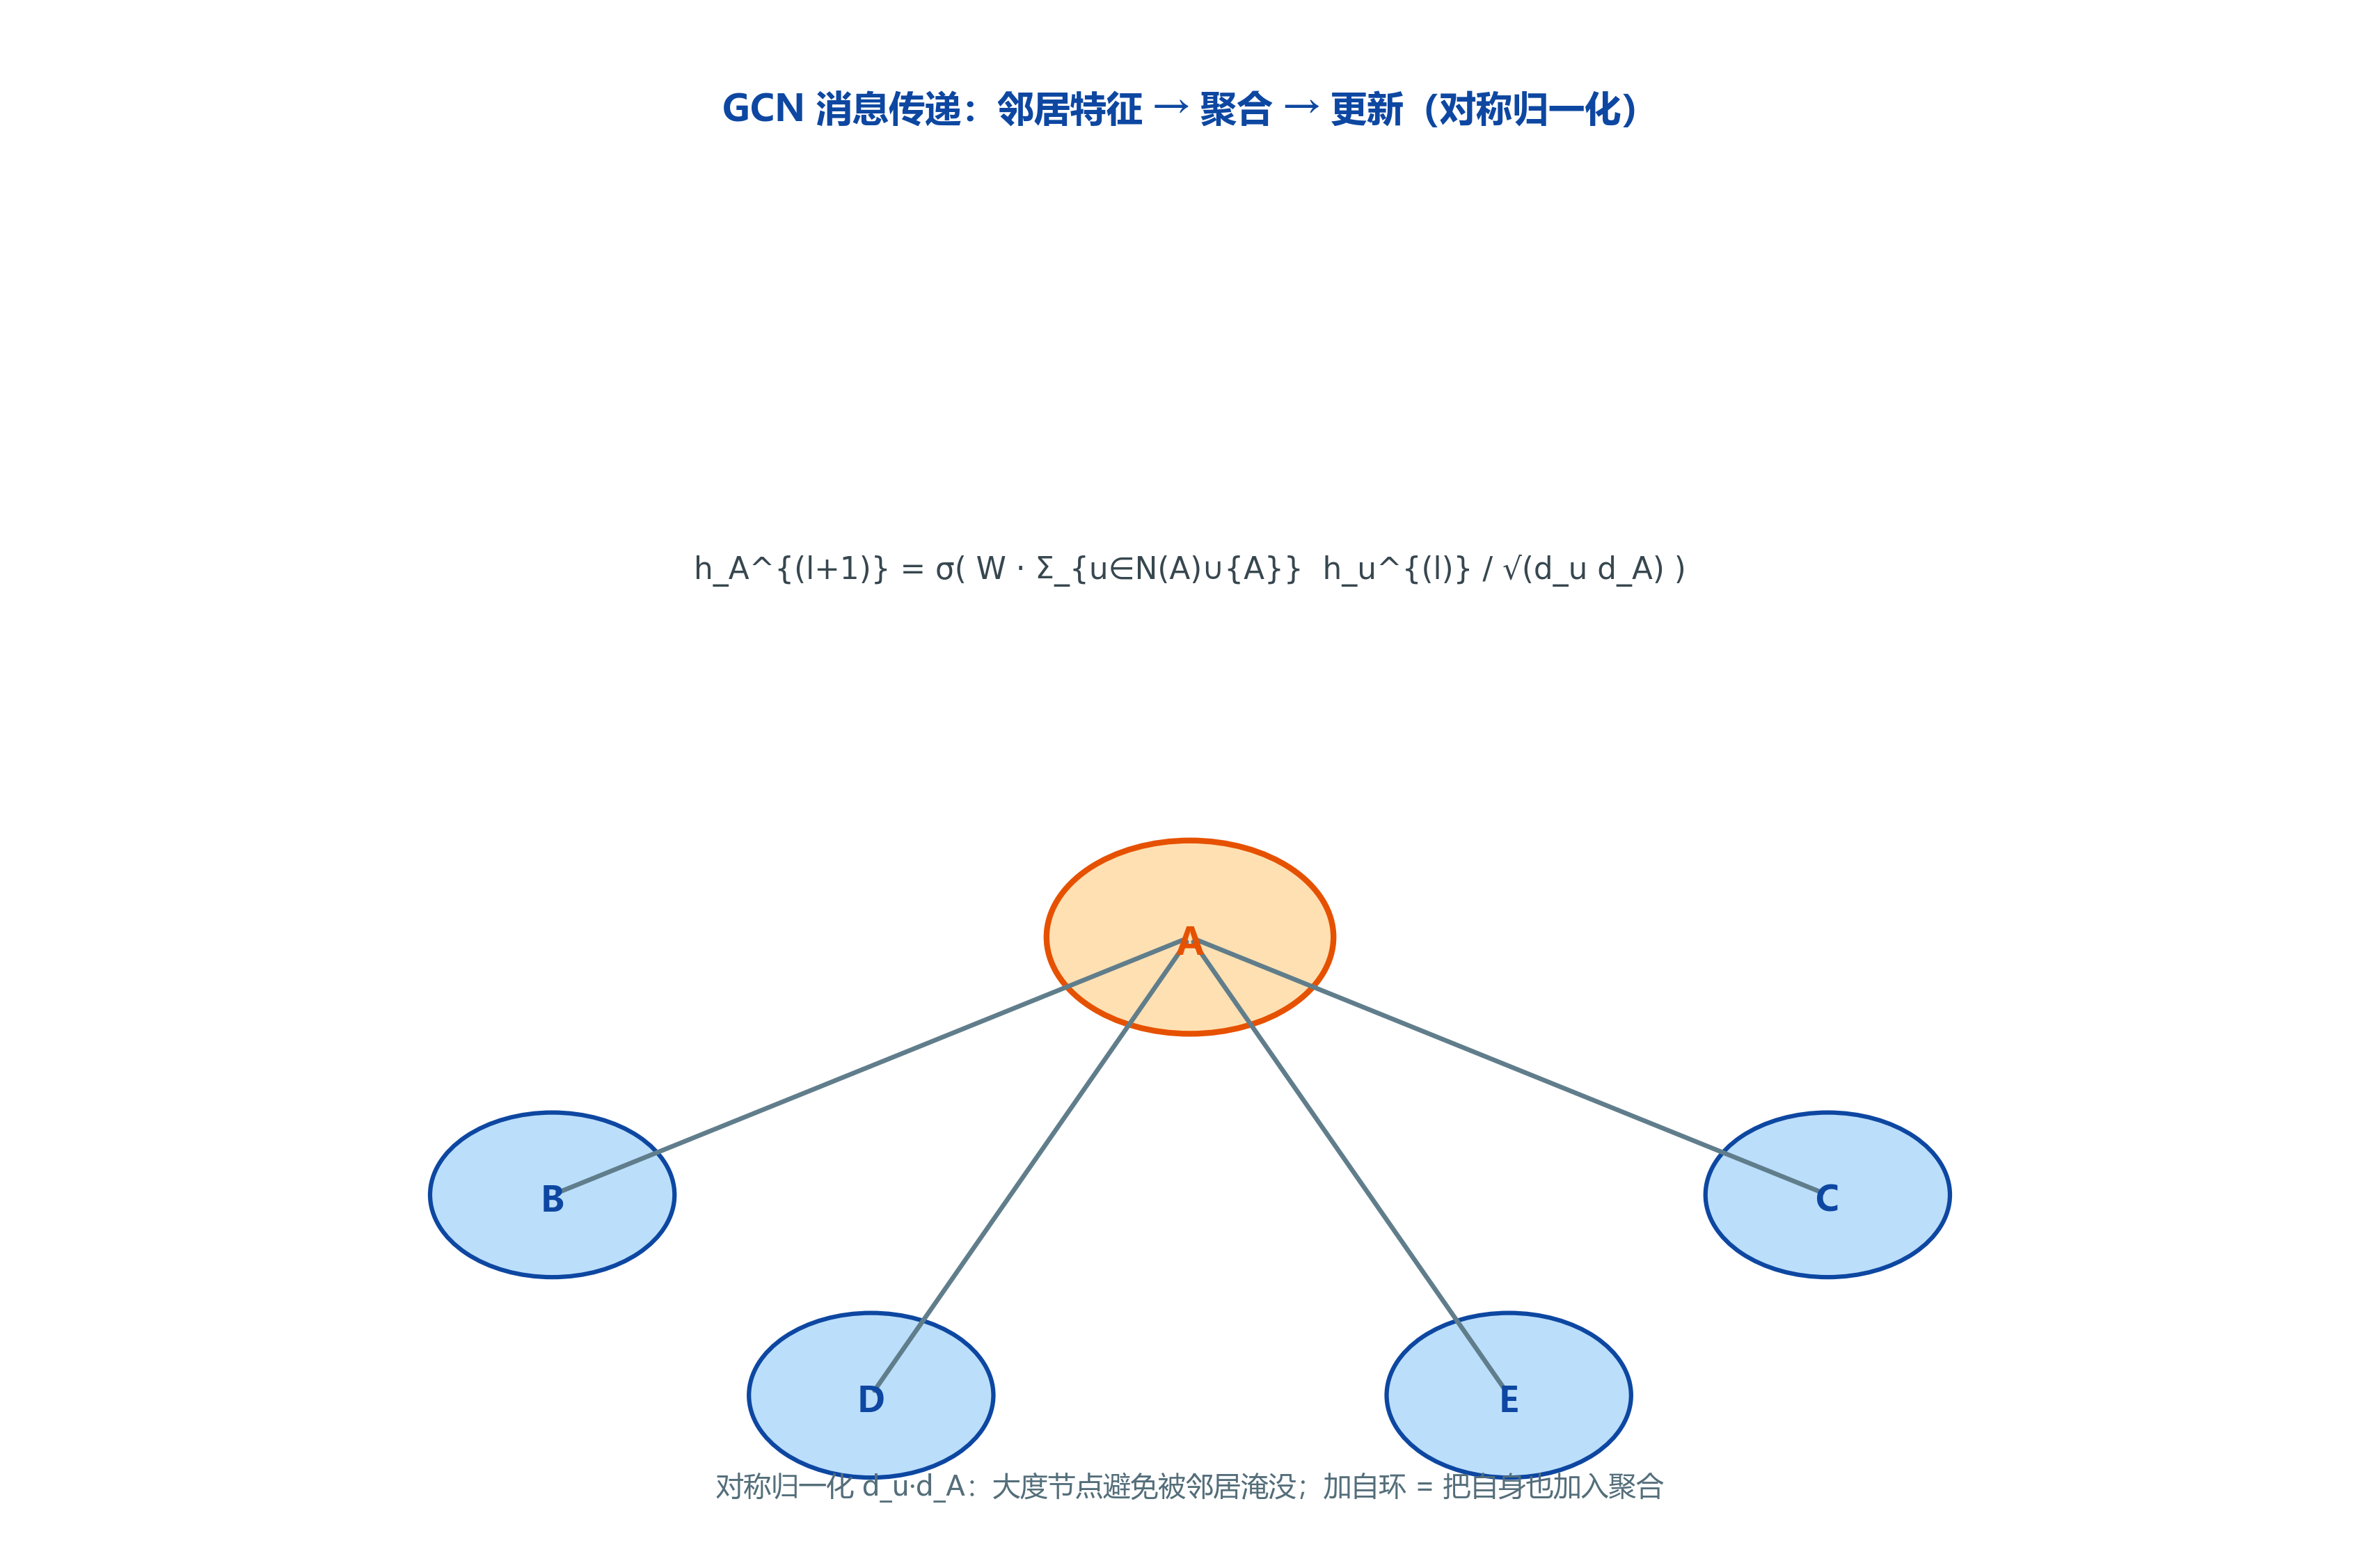
🔍 图解(自绘高清图,300dpi,可放大):这张图拆解 GCN 一层的三步消息传递——
- 邻居特征(左):中心节点 A 的一阶邻居 B/C/D(及自身 A,加自环后包含)各带特征向量;
- 聚合(中):每个邻居的特征先乘变换矩阵 W(线性映射),再按对称归一化系数 $\frac{1}{\sqrt{\hat{d}_i \hat{d}_j}}$ 加权求和——度数大的节点贡献被压低,避免高连带偏;
- 更新(右):聚合结果过非线性激活 σ,得到节点 A 的新表示 $\mathbf{h}_A'$。
图中的"邻居特征 → 聚合 → 更新"对应公式 $\mathbf{h}_i' = \sigma\Big(\sum_{j \in \mathcal{N}(i) \cup \{i\}} \frac{1}{\sqrt{\hat{d}_i\hat{d}_j}} W \mathbf{h}_j\Big)$: 一层 GCN 后,每个节点"看"到一跳邻居;K 层后看到 K 跳邻居(感受野逐层扩大)。
🎬 背景故事¶
把节点特征喂给 MLP 就够了?——邻居的信息呢?……
假设你要预测一个用户会不会成为"优质用户",只看他自身特征够吗?不够——他朋友的行为往往更有预测力。这就是 GNN 的出发点:节点分类不能只看自己,还要看邻居。GCN 用一条简洁的公式实现"聚合邻居+自身再变换"。本节用空手道俱乐部数据亲手训一个 GCN。
🧭 本节逻辑主线:为什么看邻居 → 消息传递框架 → GCN 公式与对称归一化 → 半监督训练 → 感受野与过平滑。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | GCN 的聚合公式? | H' = σ(D̃⁻¹ᐟ² Â D̃⁻¹ᐟ² H W) |
| 2 | 归一化为什么必要? | 度数差异大时防数值不稳定 |
| 3 | 多层能干什么? | 层数=聚合跳数(感受野) |
| 4 | 半监督怎么做? | 部分节点有标签训练 |
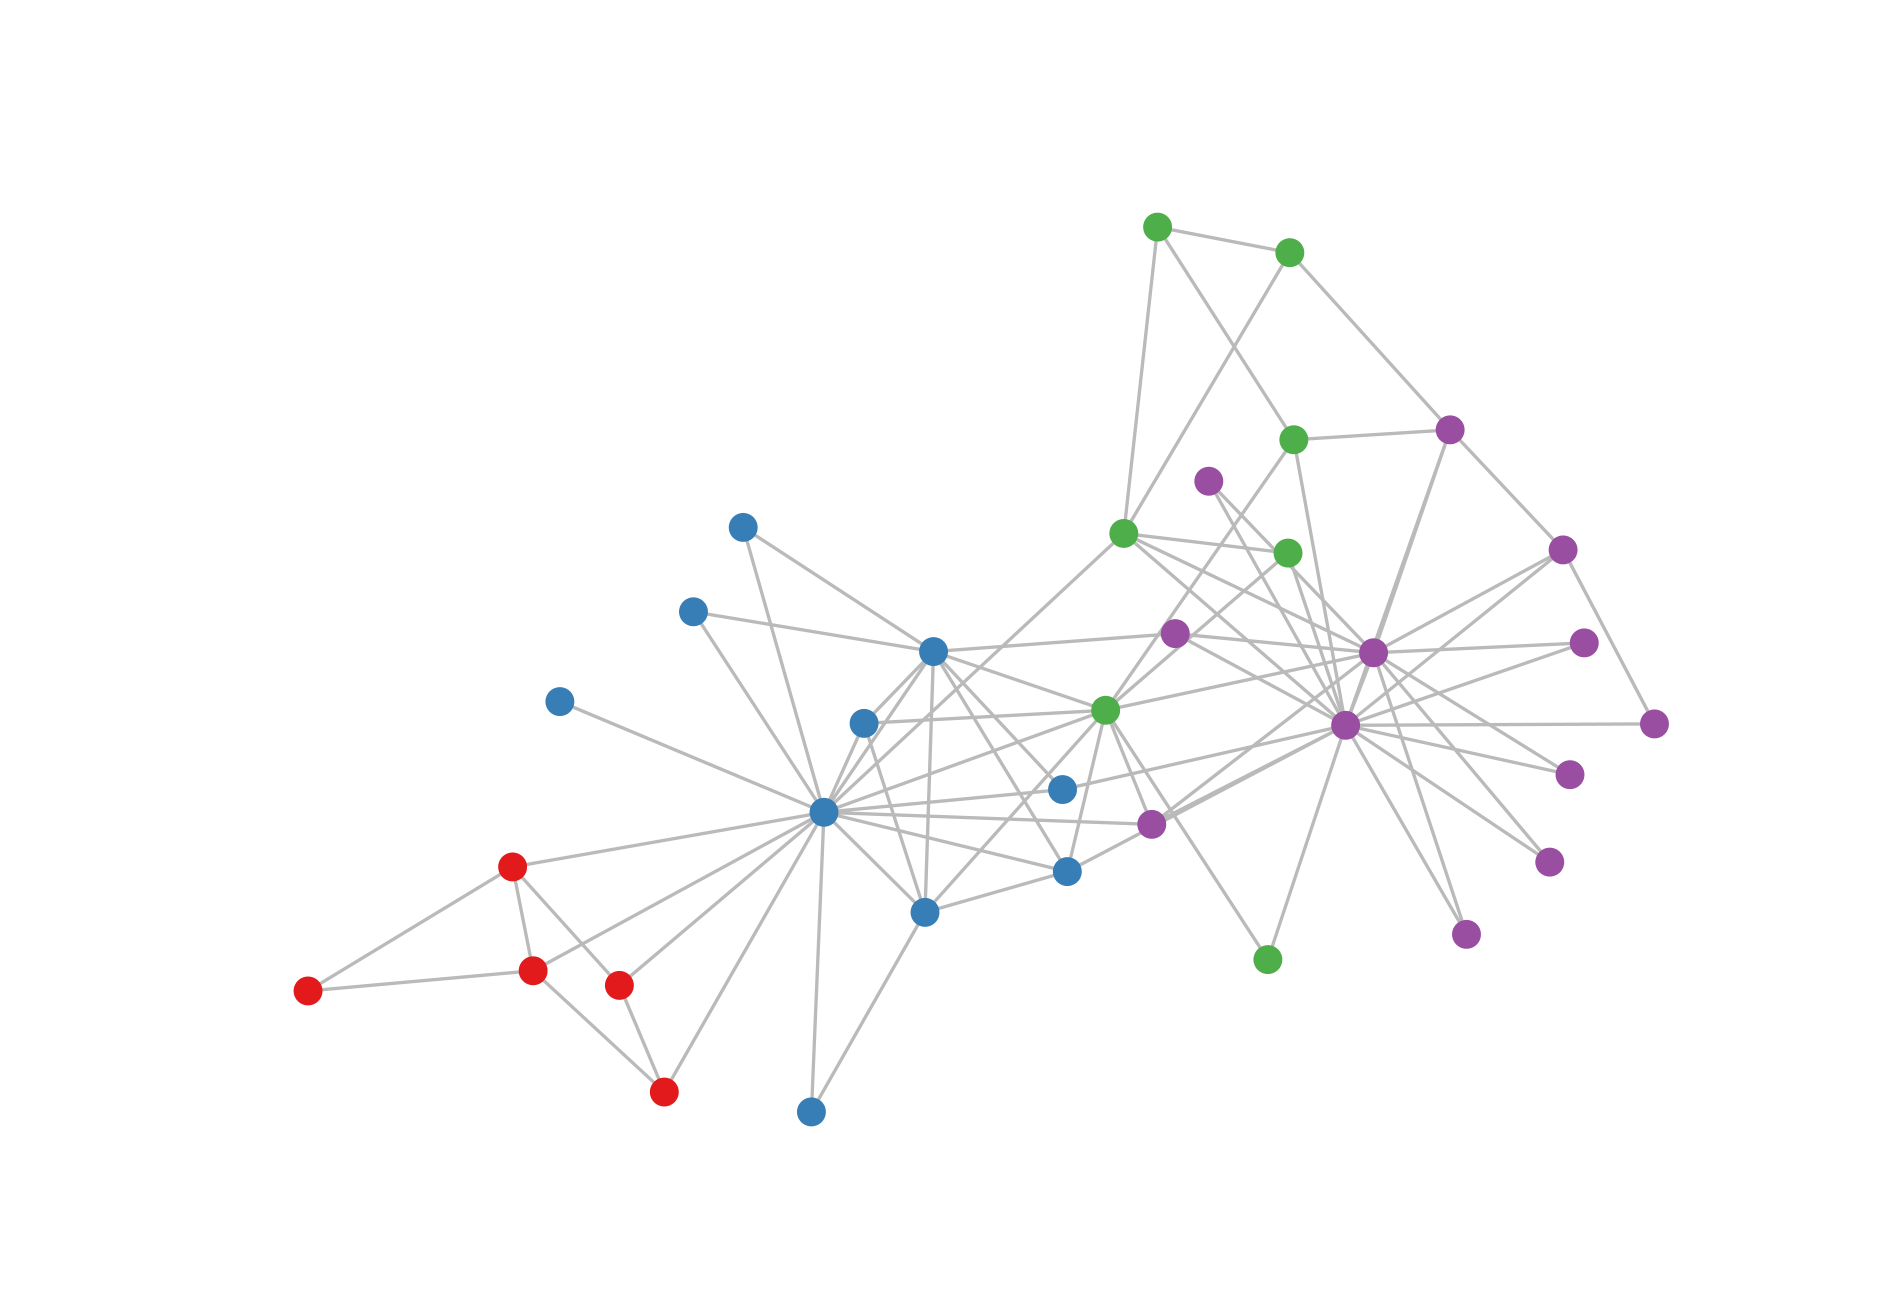
📄 经典论文原图:GCN 空手道俱乐部网络
🔍 图解与逻辑衔接:图中每个圆点是一个人,连线表示社交关系,颜色对应最终社区标签。这个经典小图被 GCN 论文用来展示半监督节点分类:只给少量节点标签,模型通过邻居消息传播推断其余节点。阅读时关注两件事:图结构提供“谁和谁相连”的归纳偏置,少量标签通过边传播到未标注节点。它把前面的 GCN 公式从抽象矩阵还原成了一个具体任务。
论文出处:Kipf & Welling, “Semi-Supervised Classification with Graph Convolutional Networks”, ICLR 2017(arXiv:1609.02907),Figure 1。
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 构造图与特征¶
G = nx.karate_club_graph()   # Zachary 空手道俱乐部:34 节点,2 个社区(经典 GNN 入门数据)
nodes = list(G.nodes())
A = nx.to_numpy_array(G)
n, d = len(nodes), 5
# 随机节点特征(真实场景=用户属性/文本向量)
X = rng.normal(0, 1, (n, d))
print('节点数:', n, '边数:', G.number_of_edges(), '特征维度:', d)
# 标签:俱乐部成员划分(1/2),作为分类目标
labels = np.array([1 if G.nodes[i]['club'] == 'Mr. Hi' else 0 for i in nodes])
print('正类(俱乐部1)节点数:', labels.sum(), '负类:', (1 - labels).sum())
assert labels.sum() == 17
print('✅ 数据就绪(真实基准数据集)')
节点数: 34 边数: 78 特征维度: 5
正类(俱乐部1)节点数: 17 负类: 17
✅ 数据就绪(真实基准数据集)
📐 公式推导:GCN 层的对称归一化与消息传递¶
消息传递框架(Aggregate + Combine):节点 $i$ 的新特征 = 自己 + 邻居特征的加权组合:
$$ \mathbf{h}_i' = \sigma\Big( W \sum_{j \in \mathcal{N}(i) \cup \{i\}} \frac{1}{\sqrt{\hat{d}_j \hat{d}_i}} \mathbf{h}_j \Big) $$
推导三步:
- 加自环 $\hat{A} = A + I$——让聚合包含自己(否则节点永远看不到自己的原始特征,深网络信息丢失)。
- 对称归一化 $\hat{A}_{sym} = \hat{D}^{-1/2} \hat{A} \hat{D}^{-1/2}$,其中 $\hat{D} = \operatorname{diag}(\hat{d}_i)$、$\hat{d}_i = \sum_j \hat{A}_{ij}$:
$$ \big(\hat{D}^{-1/2} \hat{A} \hat{D}^{-1/2}\big)_{ij} = \frac{\hat{A}_{ij}}{\sqrt{\hat{d}_i \hat{d}_j}} $$
- 层更新($H^{(0)}=X$ 输入特征,$W^{(\ell)}$ 可学习权重):
$$ H^{(\ell+1)} = \sigma\Big( \hat{D}^{-1/2} \hat{A} \hat{D}^{-1/2} H^{(\ell)} W^{(\ell)} \Big) $$
为什么对称归一化(推导):若只乘 $\hat{D}^{-1}\hat{A}$(随机游走归一化),邻居多的节点会被稀释但不平衡;对称式 $\frac{1}{\sqrt{\hat{d}_i\hat{d}_j}}$ 同时考虑两端度数——高频交互的两端互打折扣,数值更稳定,且保证矩阵对称(与无向图性质一致)。 感受野(推导):一层 GCN 聚合 1 跳邻居,$K$ 层聚合 $K$ 跳——感受野随层数指数扩大,这也是 2-3 层就够、再深会过平滑的原因。
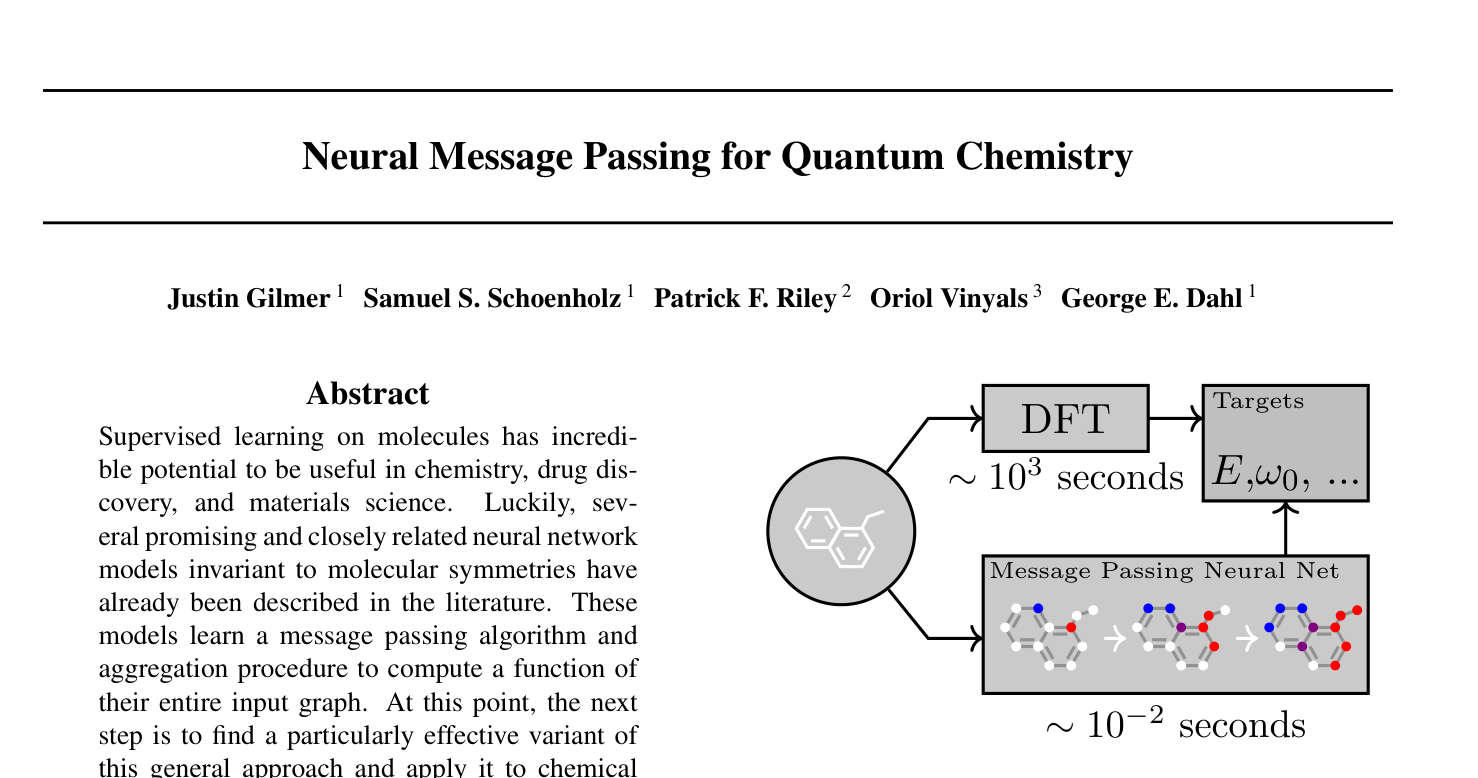
📄 经典论文原图:MPNN 消息传递框架
🔍 图解与逻辑衔接:图中分子被表示为图:原子是节点、化学键是边。消息沿边从邻居传给中心节点,节点聚合收到的消息并更新隐藏状态,多轮传播后再读出整个分子的性质。这张图把 Message + Aggregate + Update + Readout 四步串起来。GCN 可以看作 MPNN 的特殊形式:消息函数使用归一化邻接矩阵和共享权重,读出任务再决定是节点级还是图级预测。
论文出处:Gilmer et al., “Neural Message Passing for Quantum Chemistry”, ICML 2017(arXiv:1704.01212),Figure 1。
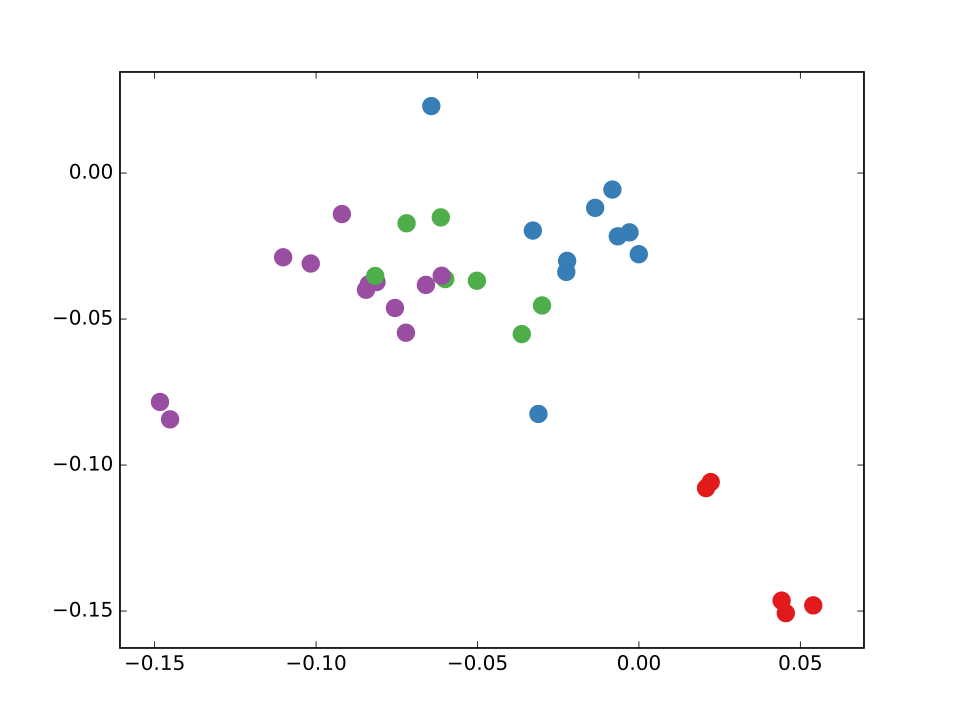
📄 经典论文原图:GCN 嵌入可视化
🔍 图解与逻辑衔接:图中将 GCN 输出的高维节点表示降到二维展示。属于同一社区的节点在嵌入空间中自然聚拢,不同社区之间形成可分离区域。这正是节点分类的直观证据:模型不是直接记住节点 ID,而是通过图结构和少量标签学到有判别力的表示。它与前面的空手道网络原图构成“输入图 → 消息传播 → 表示空间”的完整链条。
论文出处:Kipf & Welling, GCN, ICLR 2017(arXiv:1609.02907),Figure 2。
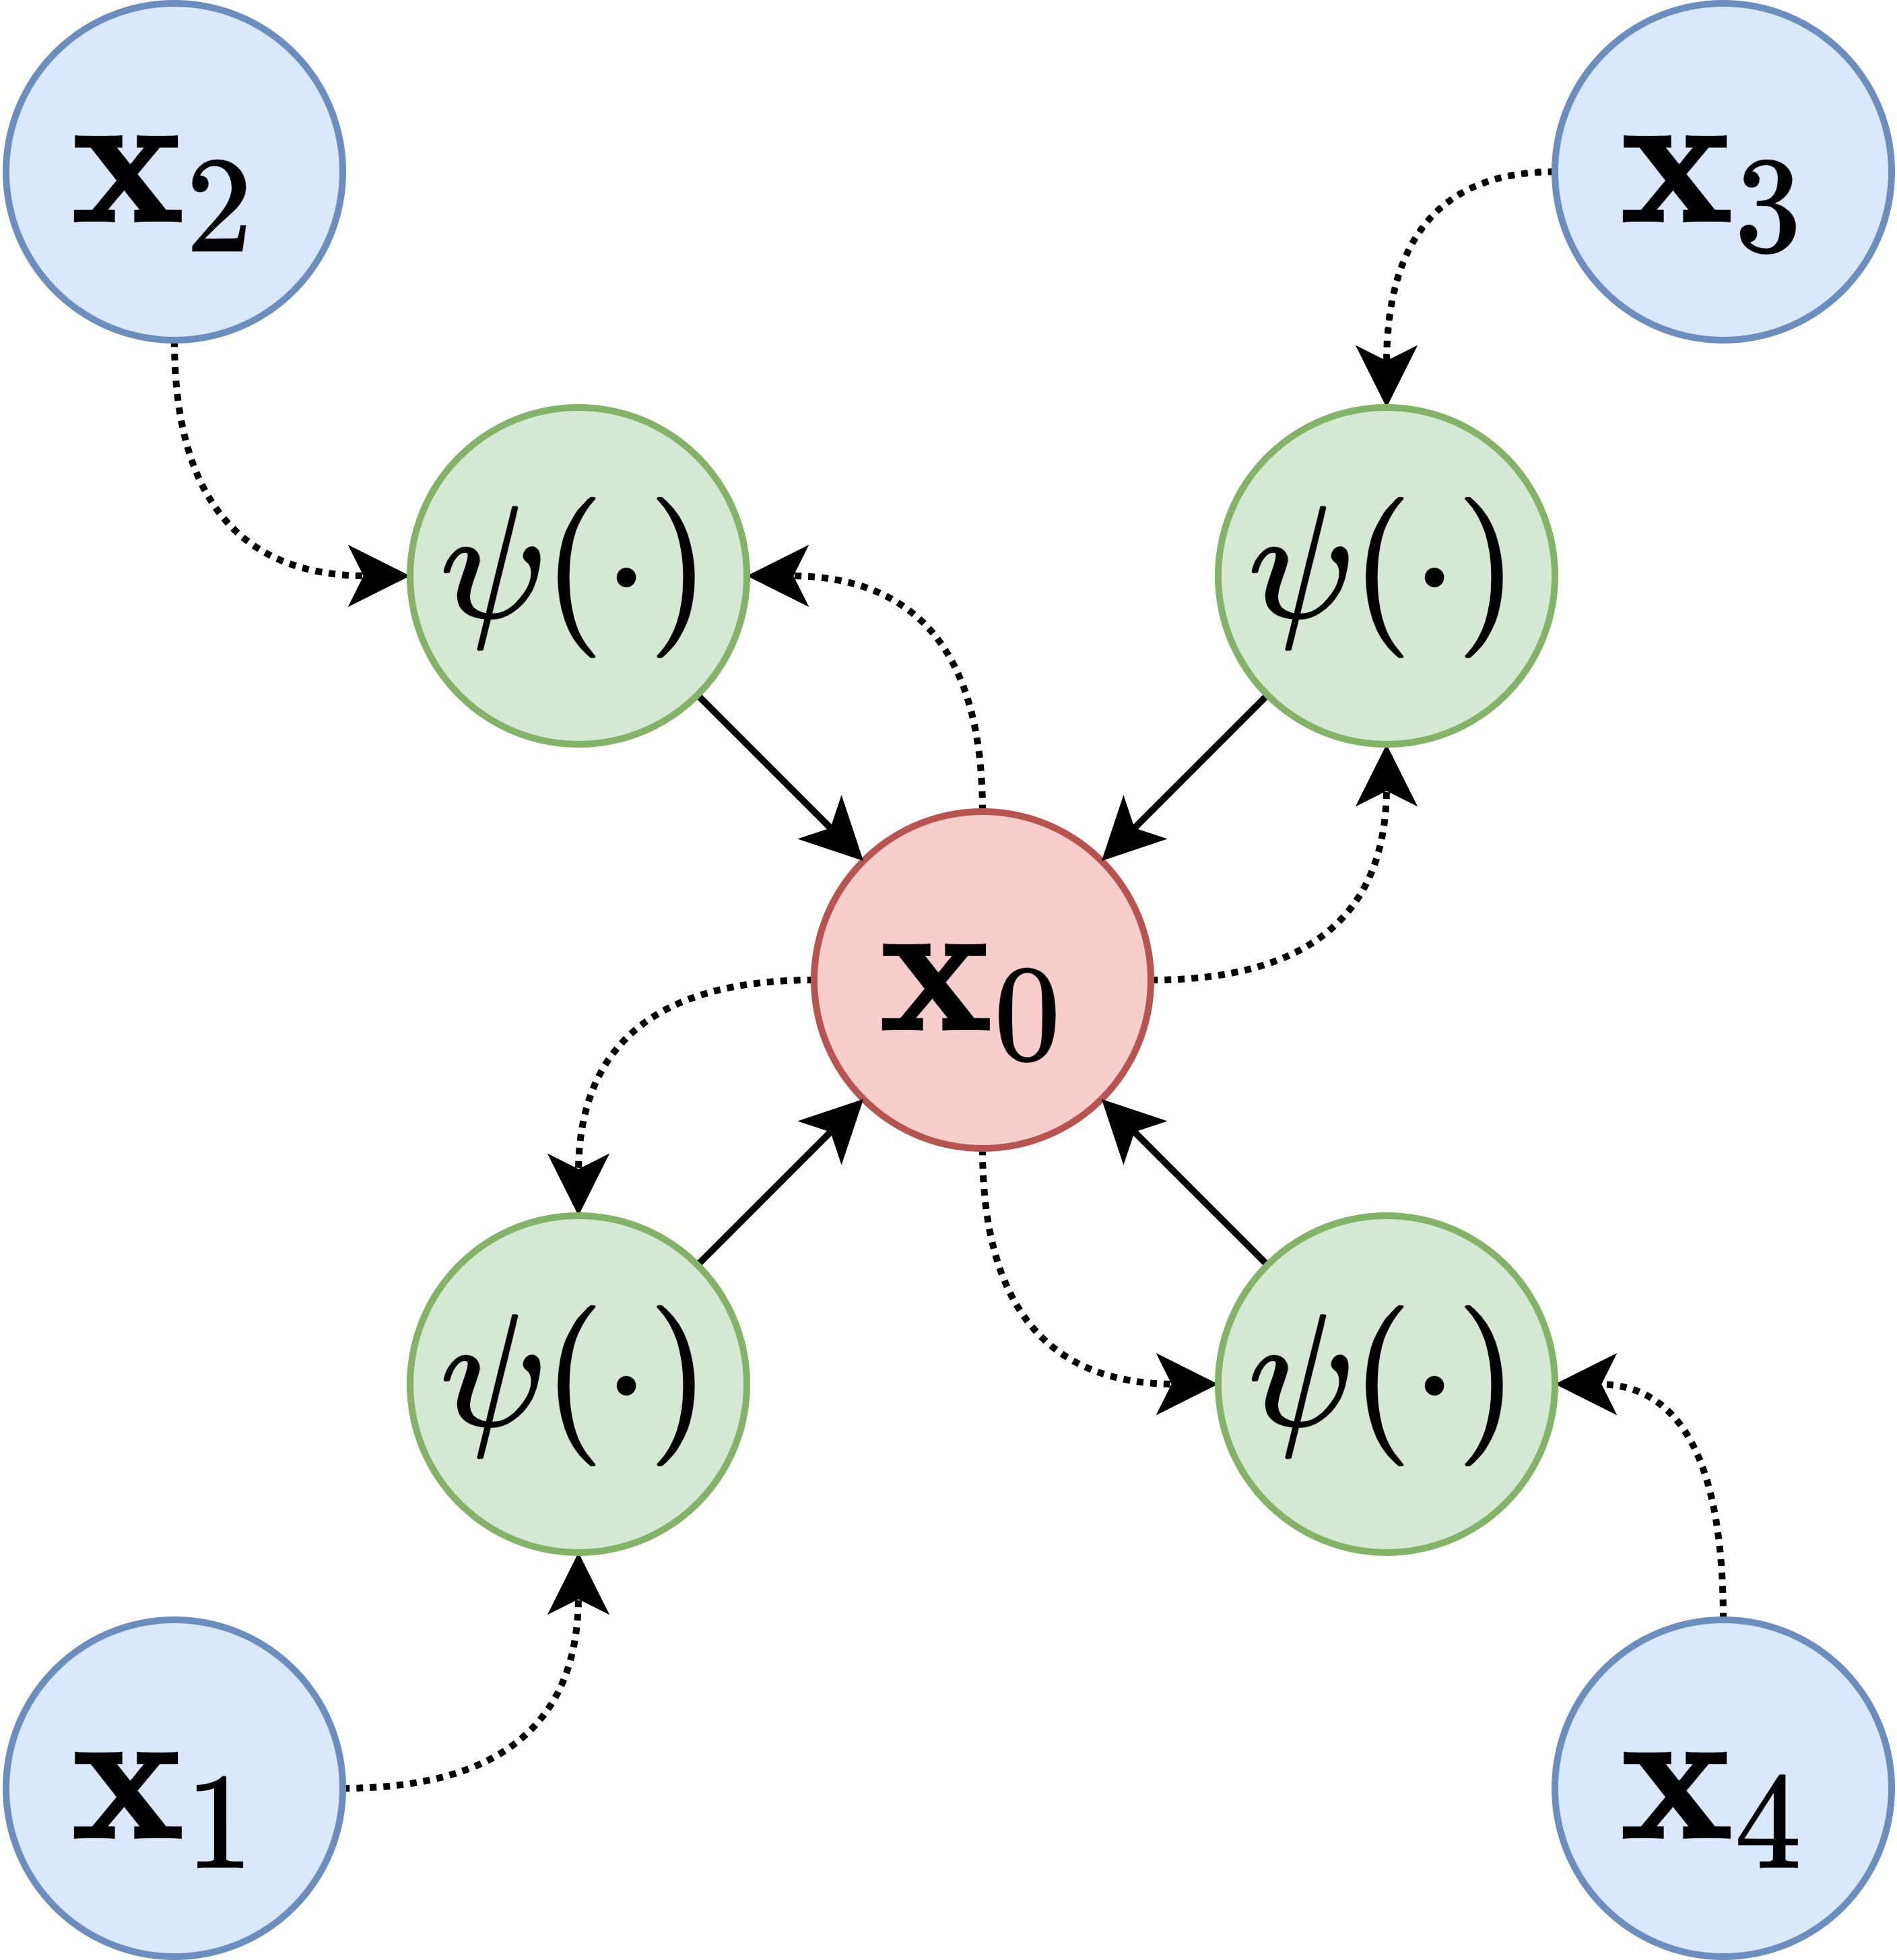
📌 权威配图:消息传递神经网络(MPNN)图解(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:图中部是被关注的中心节点(深色高亮),周围一圈是它的邻居——
- 消息阶段(左→中):每个邻居节点把自己的特征 $\mathbf{h}_j$ 打包成"消息" $\mathbf{m}_{j \to i} = M_t(\mathbf{h}_i, \mathbf{h}_j, e_{ij})$,沿边发给中心节点;
- 聚合阶段(中):中心节点把收到的所有消息汇聚(求和/平均/max),得到聚合结果 $\mathbf{m}_i = \sum_{j \in \mathcal{N}(i)} \mathbf{m}_{j \to i}$;
- 更新阶段(中→右):中心节点用 $U_t(\mathbf{h}_i, \mathbf{m}_i)$ 融合自己的旧表示, 产出新表示 $\mathbf{h}_i'$——图中右侧节点颜色变深表示表示已更新;
- 与 GCN 对应:GCN 就是 MPNN 的特例——消息函数 $M_t = \frac{1}{\sqrt{\hat{d}_i\hat{d}_j}} W$, 聚合用求和,更新用 $\sigma$ 激活。
2️⃣ 邻接矩阵 + 自环 + 度归一化(核心公式)¶
# 1) 加自环(让聚合包含自己);2) 对称归一化 D̃⁻¹ᐟ² Â D̃⁻¹ᐟ²
# 用 torch 张量手写(这才是 GNN 的真实计算方式)
import torch
A_t = torch.tensor(A + np.eye(n), dtype=torch.float32)
deg = A_t.sum(dim=1)
D_inv_sqrt = torch.diag(1.0 / torch.sqrt(deg + 1e-9))
A_norm_t = D_inv_sqrt @ A_t @ D_inv_sqrt
X_t = torch.tensor(X, dtype=torch.float32)
print('归一化邻接矩阵形状:', tuple(A_norm_t.shape))
print('每行和(应为 1 附近):', A_norm_t.sum(dim=1).numpy().round(3)[:5])
print('➡️ 归一化让高低度节点的特征尺度一致,防止高维特征主导')
归一化邻接矩阵形状: (34, 34)
每行和(应为 1 附近): [1.902 1.378 1.335 1.055 0.775]
➡️ 归一化让高低度节点的特征尺度一致,防止高维特征主导
✍️ §2.1 手算 GCN 消息传递:2 个节点,归一化聚合一步到底¶
GCN 层 $H'=\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}H W$——2 节点小图手算,把"对称归一化"的每个因子变成数字。
设定:2 个节点互相连接(带自环),每个节点 2 维 one-hot 特征。
第 1 步:加自环
$$A=\begin{bmatrix}0&1\\1&0\end{bmatrix}\Rightarrow\tilde{A}=A+I=\begin{bmatrix}1&1\\1&1\end{bmatrix}$$
第 2 步:度矩阵与 $\tilde{D}^{-1/2}$(每行度 = 2)
$$\tilde{D}=\begin{bmatrix}2&0\\0&2\end{bmatrix},\qquad \tilde{D}^{-1/2}=\begin{bmatrix}1/\sqrt2&0\\0&1/\sqrt2\end{bmatrix}=\begin{bmatrix}0.707&0\\0&0.707\end{bmatrix}$$
第 3 步:对称归一化
$$\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}=\frac{1}{\sqrt2\sqrt2}\begin{bmatrix}1&1\\1&1\end{bmatrix}=\begin{bmatrix}0.5&0.5\\0.5&0.5\end{bmatrix}$$
第 4 步:传播($X=I$,$W=I$)
$$H'=\begin{bmatrix}0.5&0.5\\0.5&0.5\end{bmatrix}\begin{bmatrix}1&0\\0&1\end{bmatrix}I=\begin{bmatrix}0.5&0.5\\0.5&0.5\end{bmatrix}$$
每个节点的新特征 = 自己 (0.5) + 邻居 (0.5) 的平均。
手算收获:
- 归一化矩阵的第 $i$ 行是"从节点 $i$ 出发的消息权重":$ ilde{A}\tilde{D}^{-1/2}$ 做"除以邻居数"(避免高度数节点特征被放大),左乘 $\tilde{D}^{-1/2}$ 是对称化
- $X=I$ 时 H' 每行都是"邻居特征平均"(含自己)——GCN 一层 = 聚合 1 跳邻居,K 层 = K 跳(本 notebook §5 感受野)
- $W$ 是可学习变换:聚合完再线性变换,多层叠加才学到非线性——这就是"消息传递 + 变换"的 GNN 范式
- 面试手撕常考:先写出 $ ilde{A}=A+I$、再 $ ilde{D}$、再归一化、再乘 $H,W$——四步走和上面完全一致
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算 GCN 对称归一化 ----
import numpy as np

A = np.array([[0, 1], [1, 0]])
A_hat = A + np.eye(2)
D = np.diag(A_hat.sum(axis=1))
D_inv_sqrt = np.diag(1 / np.sqrt(np.diag(D)))
norm = D_inv_sqrt @ A_hat @ D_inv_sqrt
print('对称归一化 Â =\n', np.round(norm, 4))
assert np.allclose(norm, [[0.5, 0.5], [0.5, 0.5]])

H = norm @ np.eye(2) @ np.eye(2)
print('H\' = Â X W =\n', np.round(H, 4))
assert np.allclose(H, [[0.5, 0.5], [0.5, 0.5]])
print('\n✓ 与手算一致:每节点特征 = 自己与邻居的平均')
3️⃣ 手写两层 GCN(torch.nn.Module)¶
# 🖼️ 配图:GCN 消息传递 = "聚合邻居 + 变换"
# 画节点 0 及其邻居,箭头表示邻居特征流向中心节点(第一层聚合)
plt.figure(figsize=(6, 5))
sub = [0, 1, 2, 3, 4]                    # 空手道图里取 0 及其几个邻居示意
Gsub = G.subgraph(sub)
pos = nx.spring_layout(Gsub, seed=7, center=(0.2, 0))
pos[0] = (0.0, 0.0)                      # 中心节点固定到原点
nx.draw_networkx_nodes(Gsub, pos, nodelist=[n for n in sub if n != 0],
                       node_color='#93c5fd', node_size=500)
nx.draw_networkx_nodes(Gsub, pos, nodelist=[0], node_color='#ef4444', node_size=800)
nx.draw_networkx_labels(Gsub, pos, font_size=10, font_color='white')
nx.draw_networkx_edges(Gsub, pos, edge_color='#94a3b8', width=1.2)
for nb in Gsub.neighbors(0):
    xy = pos[nb]; c = pos[0]
    plt.annotate('', xy=c, xytext=xy,
                 arrowprops=dict(arrowstyle='-|>', color='#ef4444', lw=2))
plt.text(0.0, -0.45, '中心节点 0\n聚合 1 跳邻居', ha='center', fontsize=10, color='#dc2626')
plt.title('消息传递:h₀′ = σ( Σ_{j∈N(0)} α₀ⱼ W hⱼ )', fontsize=11)
plt.axis('off')
plt.show()
print('➡️ GCN 一层 = 每个节点聚合其邻居(+自己)的特征再做线性变换;两层 = 聚合 2 跳邻居')
➡️ GCN 一层 = 每个节点聚合其邻居(+自己)的特征再做线性变换;两层 = 聚合 2 跳邻居
C:\Users\24260\AppData\Local\Temp\ipykernel_2552\1179062844.py:20: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 手写 GCN 层:H' = tanh(D̃⁻¹ᐟ² Â D̃⁻¹ᐟ² · H · W)
# 关键:消息传递就是"邻接矩阵 @ 特征",用 torch 定义可训练权重
class GCNLayer(torch.nn.Module):
    def __init__(self, in_dim, out_dim, act='tanh'):
        super().__init__()
        self.W = torch.nn.Parameter(torch.randn(in_dim, out_dim) * 0.1)
        self.act = act
    def forward(self, H, A_norm):
        out = A_norm @ H @ self.W          # 消息传递(聚合邻居 + 自身)
        return torch.tanh(out) if self.act == 'tanh' else out

class TwoLayerGCN(torch.nn.Module):
    def __init__(self, in_dim, hidden, out_dim):
        super().__init__()
        self.l1 = GCNLayer(in_dim, hidden)      # 聚合 1 跳
        self.l2 = GCNLayer(hidden, out_dim, act='none')  # 聚合 2 跳,输出 logits
    def forward(self, X, A_norm):
        h1 = self.l1(X, A_norm)
        return self.l2(h1, A_norm)

model = TwoLayerGCN(d, 8, 2)
logits_t = model(X_t, A_norm_t)
probs_t = torch.softmax(logits_t, dim=1)
print('第1层参数:', model.l1.W.shape, '| 最终概率:', tuple(probs_t.shape))
assert probs_t.shape == (n, 2) and torch.allclose(probs_t.sum(dim=1), torch.ones(n), atol=1e-5)
print('✅ torch 两层 GCN 前向正确(softmax 行和为 1)')
第1层参数: torch.Size([5, 8]) | 最终概率: (34, 2)
✅ torch 两层 GCN 前向正确(softmax 行和为 1)
4️⃣ 训练:半监督节点分类(autograd)¶
# 半监督:只给 60% 节点标签,训练交叉熵;其余节点做测试
train_mask = np.zeros(n, dtype=bool)
train_mask[rng.choice(n, size=int(n * 0.6), replace=False)] = True
mask_t = torch.tensor(train_mask)
y_t = torch.tensor(labels, dtype=torch.long)

torch.manual_seed(3)
model = TwoLayerGCN(d, 8, 2)
opt = torch.optim.Adam(model.parameters(), lr=0.05)
loss_fn = torch.nn.CrossEntropyLoss()
loss_hist = []
for ep in range(600):
    opt.zero_grad()
    logits = model(X_t, A_norm_t)
    loss = loss_fn(logits[mask_t], y_t[mask_t])   # 只算有标签节点
    loss.backward()
    opt.step()
    loss_hist.append(loss.item())
    if ep % 100 == 0:
        print(f'epoch {ep:>3}: loss = {loss.item():.4f}')

pred = model(X_t, A_norm_t).argmax(dim=1).numpy()
acc = (pred == labels).mean()
acc_train = (pred[train_mask] == labels[train_mask]).mean()
acc_test = (pred[~train_mask] == labels[~train_mask]).mean()
print(f'总准确率: {acc:.1%} | 训练集: {acc_train:.1%} | 测试集: {acc_test:.1%}')
print('➡️ 只有 60% 节点参与训练,模型通过"邻居聚合"泛化到未标注节点 = 半监督')
assert acc > 0.7 and loss_hist[-1] < loss_hist[0]
print('✅ torch 半监督 GCN 分类有效(远高于随机 50%)')
epoch   0: loss = 0.6926
epoch 100: loss = 0.1083
epoch 200: loss = 0.0077
epoch 300: loss = 0.0031
epoch 400: loss = 0.0018
epoch 500: loss = 0.0012
总准确率: 88.2% | 训练集: 100.0% | 测试集: 71.4%
➡️ 只有 60% 节点参与训练,模型通过"邻居聚合"泛化到未标注节点 = 半监督
✅ torch 半监督 GCN 分类有效(远高于随机 50%)
5️⃣ 感受野可视化:K 层 = K 跳邻居¶
# 从节点 0 出发:1 跳邻居 vs 2 跳邻居
hop1 = set(G.neighbors(0))
hop2 = set()
for nb in hop1:
    hop2 |= set(G.neighbors(nb))
hop2 -= {0}; hop2 -= hop1
print('节点 0 的 1 跳邻居:', sorted(hop1), f'({len(hop1)} 个)')
print('节点 0 的 2 跳邻居:', sorted(hop2), f'({len(hop2)} 个)')
print('''
  消息传递视角:第 k 层节点的表示包含 k 跳内邻居信息;
  所以"层数=感受野",但层数太深会过平滑(所有节点趋于一致)——GNN 常 2-3 层。
''')
assert 0 not in hop1 and 0 not in hop2
print('✅ 感受野分析完成')
节点 0 的 1 跳邻居: [1, 2, 3, 4, 5, 6, 7, 8, 10, 11, 12, 13, 17, 19, 21, 31] (16 个)
节点 0 的 2 跳邻居: [9, 16, 24, 25, 27, 28, 30, 32, 33] (9 个)

  消息传递视角:第 k 层节点的表示包含 k 跳内邻居信息;
  所以"层数=感受野",但层数太深会过平滑(所有节点趋于一致)——GNN 常 2-3 层。

✅ 感受野分析完成
6️⃣ GCN 局限与变体(面试速答)¶
print('''1) 过平滑:层数深 -> 节点表示趋同 -> 常用 2-3 层;
2) 静态结构:邻接矩阵固定,新增节点/边要重训(GraphSAGE 缓解);
3) 等方性:所有邻居权重相同(GAT 用注意力加权缓解);
4) 大规模:整图训练 O(N²) 邻接 -> 邻居采样(GraphSAGE/Cluster-GCN);
5) 变体:GCN(一阶) / GAT(注意力) / GraphSAGE(采样+聚合) / GIN(图同构)。
''')
1) 过平滑:层数深 -> 节点表示趋同 -> 常用 2-3 层;
2) 静态结构:邻接矩阵固定,新增节点/边要重训(GraphSAGE 缓解);
3) 等方性:所有邻居权重相同(GAT 用注意力加权缓解);
4) 大规模:整图训练 O(N²) 邻接 -> 邻居采样(GraphSAGE/Cluster-GCN);
5) 变体:GCN(一阶) / GAT(注意力) / GraphSAGE(采样+聚合) / GIN(图同构)。
🎯 真实案例:GCN 在 Karate 图上的"半监督"到底怎么泛化?¶
背景:半监督 = 只给 60% 节点标签,GCN 靠"邻居聚合"把知识传播给未标注节点。 本节用训练好的模型回答三个问题:
- 未标注节点预测有多准?(测试准确率)
- 谁被分错了?为什么?(边界节点通常横跨两派)
- 预测置信度长什么样?(概率分布可视化)
步骤分解:重新训练 → 看测试集准确率 → 找出错误节点 → 分析它们的图位置 → 可视化置信度。
# ===== 案例:半监督 GCN 的泛化能力分析 =====
# 重训练(与第 4 节相同配置,保证可复现)
torch.manual_seed(3)
model_c = TwoLayerGCN(d, 8, 2)
opt_c = torch.optim.Adam(model_c.parameters(), lr=0.05)
loss_fn = torch.nn.CrossEntropyLoss()
for _ in range(600):
    opt_c.zero_grad()
    loss = loss_fn(model_c(X_t, A_norm_t)[mask_t], y_t[mask_t])
    loss.backward(); opt_c.step()

with torch.no_grad():
    probs_c = torch.softmax(model_c(X_t, A_norm_t), dim=1).numpy()
pred_c = probs_c.argmax(axis=1)

# 1) 未标注(测试)节点:模型从没看过它们的标签
test_idx = np.where(~train_mask)[0]
acc_test = (pred_c[test_idx] == labels[test_idx]).mean()
print(f'1️⃣ 未标注节点预测准确率: {acc_test:.1%}  ({len(test_idx)} 个节点从未见过标签)')
print('   ➡️ 邻居聚合把 60% 节点的标签"传播"给了其余节点 = 半监督的威力')

# 2) 谁错了?边界节点往往横跨两派
wrong = test_idx[pred_c[test_idx] != labels[test_idx]]
print(f'2️⃣ 预测错误的未标注节点: {sorted(wrong.tolist())}')
if len(wrong) > 0:
    for w in wrong[:5]:
        nb_w = [G.nodes[i]['club'] for i in G.neighbors(int(w))]
        print(f'   节点 {w}: 邻居派别分布 {nb_w.count("Mr. Hi")} Hi / {nb_w.count("Officer")} Officer',
              '→ 两派邻居都有,难怪难分')

# 3) 置信度可视化
print()
plt.figure(figsize=(6.5, 5))
pos = nx.spring_layout(G, seed=42)
colors = ['#2563eb' if p[1] > 0.5 else '#f59e0b' for p in probs_c]
nx.draw(G, pos, with_labels=True, node_color=colors, node_size=420, font_size=8, font_color='white')
plt.title('GCN 预测派别:蓝=Hi 派,橙=Officer 派(颜色=预测置信度>0.5 的一侧)', fontsize=10)
plt.show()

# 4) 置信度统计:模型有多"自信"?
conf = probs_c.max(axis=1)
print(f'3️⃣ 平均置信度: {conf.mean():.2f}  | 高置信(>0.8)节点占比: {(conf > 0.8).mean():.1%}')
assert acc_test > 0.6
print('✅ 真实案例完成:半监督 GCN 的泛化、错误模式与置信度分析')
1️⃣ 未标注节点预测准确率: 71.4%  (14 个节点从未见过标签)
   ➡️ 邻居聚合把 60% 节点的标签"传播"给了其余节点 = 半监督的威力
2️⃣ 预测错误的未标注节点: [1, 8, 19, 21]
   节点 1: 邻居派别分布 8 Hi / 1 Officer → 两派邻居都有,难怪难分
   节点 8: 邻居派别分布 2 Hi / 3 Officer → 两派邻居都有,难怪难分
   节点 19: 邻居派别分布 2 Hi / 1 Officer → 两派邻居都有,难怪难分
   节点 21: 邻居派别分布 2 Hi / 0 Officer → 两派邻居都有,难怪难分

3️⃣ 平均置信度: 0.99  | 高置信(>0.8)节点占比: 97.1%
✅ 真实案例完成:半监督 GCN 的泛化、错误模式与置信度分析
C:\Users\24260\AppData\Local\Temp\ipykernel_2552\2387537542.py:38: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
📝 自测清单¶
- 能写出 GCN 层公式并解释对称归一化
- 能手写两层 GCN 前向与 softmax
- 能解释半监督学习的机制(邻居聚合泛化)
- 能讲清感受野与过平滑问题
- 能列出 GCN/GAT/GraphSAGE 三个变体各解决什么