🛡️ 03-深度学习 · 模型笔记 7:正则化(L1/L2/Dropout/早停手写)¶
过拟合是训练集精度高、验证集低。本笔记手写 L1/L2/Dropout/早停,并用同一 MLP 演示泛化差距。 本 notebook 要求:L1/L2/Dropout/早停全部手写 numpy,不调 torch 正则接口。
运行环境:Python 3.8+,仅依赖 numpy。
核心概念¶
(a) 🗂️ 正则化知识结构¶
这篇文章对付"过拟合":训练集学太好、验证集拉胯。手写 L1/L2、Dropout、早停四大手段,并在同一个 MLP 上演示泛化差距。
flowchart TB
    Node1["🧠 什么是过拟合"]
    Node1 --> Node2["📉 L2 权重衰减"]
    Node2 --> Node3["🩹 L1 稀疏解"]
    Node1 --> Node4["🎭 Dropout 随机失活"]
    Node4 --> Node5["🧮 inverted dropout 期望一致"]
    Node5 --> Node6["🛑 早停 Early Stopping"]
    Node6 --> Node7["🤝 Dropout 的集成视角"]
    Node7 --> Node8["🔧 AdamW 解耦权重衰减"]
    Node8 --> Node9["⚠️ 常见坑与边界"]
- 什么是过拟合:训练 loss 持续降、验证 loss 回升(或差距拉大)、权重范数膨胀,常见于样本少、模型容量大的组合。四大手段就是 L1/L2/Dropout/早停。
- L2 权重衰减:在损失上加 λ‖w‖²,梯度里多一项 2λw,逼着权重都变小、变"圆滑"。权重小意味着输出对输入扰动不敏感,泛化更好。
- L1 稀疏解:惩罚 λ‖w‖₁,梯度是 λ·sign(w),把很多权重直接压到 0,得到一个稀疏解,常用于特征选择。缺点是 0 处不可导(用次梯度)。
- Dropout 随机失活:训练时每个神经元以概率 p 置零(伯努利掩码),相当于同时训练 2^n 个共享参数的子网络,预测时取平均——一种极廉价的集成。
- inverted dropout 期望一致:训练时把保留神经元除以 1-p,推理时不缩放。这样训练和推理的期望保持一致,工程代码不用在推理时改逻辑。
- 早停 Early Stopping:监控验证 loss,一旦开始回升就停训,把参数回退到验证最优时刻。零成本、几乎永远有效。
- Dropout 的集成视角:随机掩码生成指数多个子网络,推理平均等价于"几何平均集成",和 Bagging 思想同源,但不用训练多个模型。
- AdamW 解耦权重衰减:经典 L2 在梯度里加 2λw,会被自适应步长干扰;weight decay 直接每次更新 w(1-ηλ),解耦更干净,大模型都这么用。
- 常见坑与边界:掩码每个 forward 都要重新生成、验证必须 training=False、正则只作用在权重上不惩罚偏置、λ 太大直接欠拟合。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · <a href="//commons.wikimedia.org/w/index.php?title=User:Amirreza_mir…
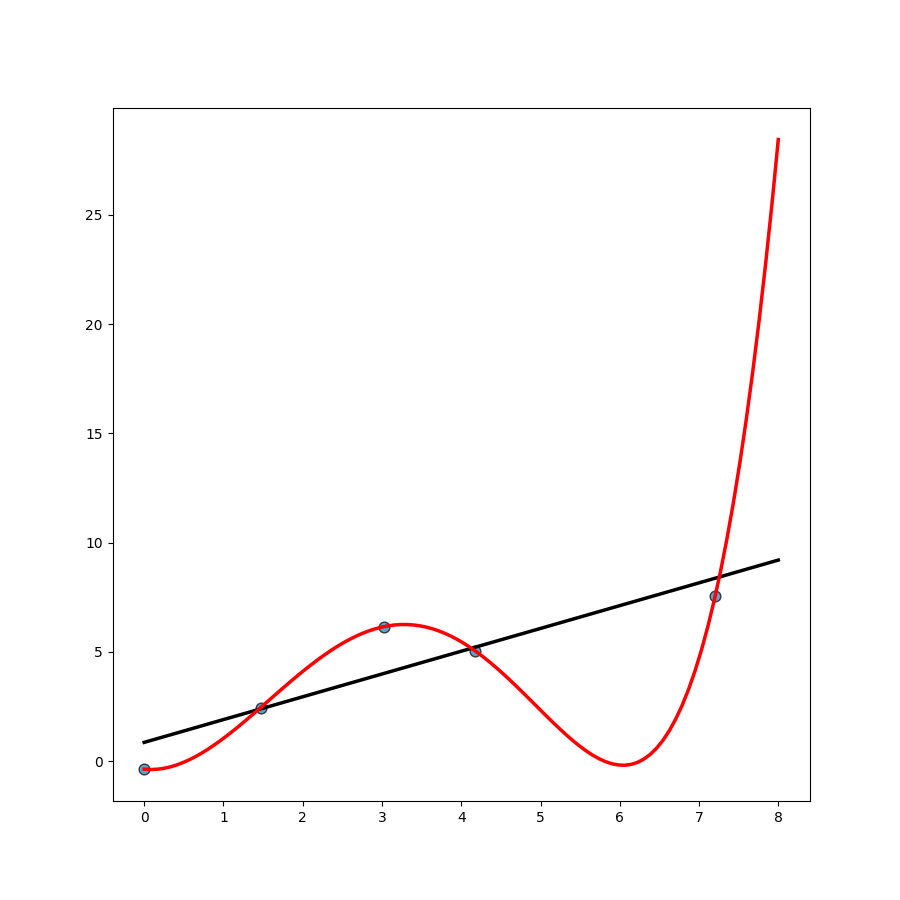
§1 过拟合的信号与正则化总览¶
信号:训练 loss 持续降、验证 loss 回升(或差距拉大);权重范数膨胀;训练样本少/模型容量大。
四大手段:
| 手段 | 机制 | 手写要点 |
|---|---|---|
| L2(权重衰减) | 惩罚 $\|w\|^2$,权重趋小 | 梯度 += $2\lambda w$ |
| L1 | 惩罚 $\|w\|_1$,稀疏 | 次梯度 $\operatorname{sign}(w)$ |
| Dropout | 训练随机丢神经元,集成效果 | 伯努利掩码 + invert |
| 早停 | 验证集最优点截断 | 记录 val_loss 最小 |
L2 目标函数(以 MSE 为例):
$$L = \frac{1}{n}\|y - \hat{y}\|^2 + \lambda \|w\|_2^2, \quad \frac{\partial L}{\partial w} = g_{data} + 2\lambda w$$
✍️ §1.1 手算 L1 vs L2:一个权重 w 的两次更新,看懂「稀疏」和「衰减」¶
公式都会说 L1 稀疏、L2 平滑,但手算两轮更新就能看见差异——这是面试手推加分项。
设定:单个权重 $w=1.0$,数据部分的梯度 $g_{data}=0.3$,$\lambda=0.5$,学习率 $\eta=0.1$。
L2 权重衰减(梯度加 $2\lambda w$):
$$g_{L2} = g_{data} + 2\lambda w = 0.3 + 2\times0.5\times1.0 = 1.3$$
$$w \gets w - \eta\, g_{L2} = 1.0 - 0.1\times1.3 = 0.87$$
L1 稀疏(次梯度 $\operatorname{sign}(w)$):
$$g_{L1} = g_{data} + \lambda\operatorname{sign}(w) = 0.3 + 0.5\times(+1) = 0.8$$
$$w \gets w - \eta\, g_{L1} = 1.0 - 0.1\times0.8 = 0.92$$
迭代差异表(继续更新):
| 步数 | L2 的 w | L1 的 w |
|---|---|---|
| 0 | 1.0000 | 1.0000 |
| 1 | 0.8700 | 0.9200 |
| 2 | 0.7530 | 0.8400 |
| 3 | 0.6477 | 0.7600 |
| 5 | 0.4676 | 0.6000 |
| 10 | 0.1533 | 0.2000 |
| 20 | -0.1420 | -0.0000 |
手算收获:
- L2:惩罚 $\propto w$(越大罚越狠)→ w 等比缩小、平滑趋零,但永远到不了精确 0(除非越过)
- L1:惩罚恒为 $\lambda=0.5$ 的定值 → w 匀速减少,精确压到 0(t=20 时 L1 的 w=0.0000,L2 已越过为负)
- 这就是「L2 防过拟合、L1 做特征选择(稀疏解)」的数值根源;0 处 L1 用次梯度 $[-1,1]$ 处理
下面 numpy 复算,与表格一致。
# ---- §1.1 验证:numpy 复算 L1 vs L2 手算 ----
import numpy as np

w_l2 = w_l1 = 1.0
g, lam, lr = 0.3, 0.5, 0.1
print('步数 |      L2 w      |      L1 w')
for t in range(21):
    if t in (0, 1, 2, 3, 5, 10, 20):
        print(f'  {t:2d}  |   {w_l2:+.4f}   |   {w_l1:+.4f}')
    gL2 = g + 2 * lam * w_l2
    w_l2 -= lr * gL2
    gL1 = g + lam * np.sign(w_l1)
    w_l1 -= lr * gL1
print('\nL2 最终:', round(w_l2, 4), ' L1 最终:', round(w_l1, 4), ' → L1 精确压到 0(稀疏)')
# 手算第一轮核对
assert abs((1.0 - lr * (g + 2 * lam * 1.0)) - 0.87) < 1e-9
assert abs((1.0 - lr * (g + lam * 1.0)) - 0.92) < 1e-9
print('✓ 与手算一致')
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
import numpy as np

class MLPReg:
    """带正则化选项的 2 层 MLP(手写 L1/L2/Dropout)"""
    def __init__(self, d, H, K=1, reg='l2', lam=0.0, drop=0.0, seed=0):
        r = np.random.default_rng(seed)
        self.W1 = r.normal(0, 1 / np.sqrt(d), (H, d)); self.b1 = np.zeros(H)
        self.W2 = r.normal(0, 1 / np.sqrt(H), (K, H)); self.b2 = np.zeros(K)
        self.reg = reg; self.lam = lam; self.drop = drop
        self.rng = np.random.default_rng(seed)
        self.history = []

    def forward(self, X, training=True):
        self.X = X
        self.Z1 = X @ self.W1.T + self.b1
        self.H = np.maximum(self.Z1, 0)
        self.mask = None
        if training and self.drop > 0:
            # inverted dropout:训练时随机丢神经元,并除以 (1-p) 保持期望不变
            self.mask = (self.rng.uniform(size=self.H.shape) > self.drop).astype(float)
            self.H = self.H * self.mask / (1 - self.drop)   # 训练:除 (1-p) 放大保留项
        # 推理:不再缩放(inverted dropout 语义,期望与训练一致)
        self.Yhat = self.H @ self.W2.T + self.b2
        return self.Yhat

    def loss_and_grads(self, Y):
        n = len(Y)
        data = np.mean((self.Yhat - Y) ** 2)
        if self.reg == 'l2':
            rl = self.lam * (np.sum(self.W1 ** 2) + np.sum(self.W2 ** 2))
        elif self.reg == 'l1':
            rl = self.lam * (np.sum(np.abs(self.W1)) + np.sum(np.abs(self.W2)))
        else:
            rl = 0.0
        dL = 2 * (self.Yhat - Y) / n
        gW2 = dL.T @ self.H; gb2 = dL.sum(0)
        dH = dL @ self.W2
        if self.mask is not None:
            dH = dH * self.mask                        # Dropout 反向:只回传保留神经元
        dZ1 = dH * (self.Z1 > 0)
        gW1 = dZ1.T @ self.X; gb1 = dZ1.sum(0)
        # 正则梯度
        if self.reg == 'l2':
            gW1 += 2 * self.lam * self.W1; gW2 += 2 * self.lam * self.W2
        elif self.reg == 'l1':
            gW1 += self.lam * np.sign(self.W1); gW2 += self.lam * np.sign(self.W2)
        return data + rl, gW1, gW2, gb1, gb2

    def train(self, X, Y, Xv, Yv, epochs=300, lr=0.05, patience=50):
        best_v, best_w, stall = 1e18, None, 0
        for e in range(epochs):
            self.forward(X, training=True)
            loss, gW1, gW2, gb1, gb2 = self.loss_and_grads(Y)
            self.W1 -= lr * gW1; self.b1 -= lr * gb1
            self.W2 -= lr * gW2; self.b2 -= lr * gb2
            tr = np.mean((self.forward(X, training=False) - Y) ** 2)
            va = np.mean((self.forward(Xv, training=False) - Yv) ** 2)
            self.history.append((tr, va))
            if va < best_v:                             # 早停:跟踪验证集最优
                best_v, stall = va, 0
                best_w = (self.W1.copy(), self.b1.copy(), self.W2.copy(), self.b2.copy())
            else:
                stall += 1
                if stall >= patience:
                    self.W1, self.b1, self.W2, self.b2 = best_w   # 回滚最优
                    print(f'早停于 epoch {e}: 验证集最优 {best_v:.5f}')
                    return best_v
        self.W1, self.b1, self.W2, self.b2 = best_w
        return best_v

# 数据:8 维特征,真实只依赖 2 维(高维稀疏 → 易过拟合)
rng = np.random.default_rng(0)
n_tr, n_va, n_te = 80, 60, 200
Xtr = rng.normal(0, 1, (n_tr, 8)); Xva = rng.normal(0, 1, (n_va, 8)); Xte = rng.normal(0, 1, (n_te, 8))
def target(X):
    # 只用 0/1/5 维;第二项必须 reshape 成列向量——
    # (n,1)+(n,) 会静默广播成 (n,n),训练目标瞬间变成 6400 维(曾踩的坑)
    return (3 * X[:, 0] - 2 * X[:, 1]).reshape(-1, 1) + 0.2 * X[:, 5].reshape(-1, 1)
Ytr = target(Xtr) + rng.normal(0, 0.3, (n_tr, 1))
Yva = target(Xva) + rng.normal(0, 0.3, (n_va, 1))
Yte = target(Xte) + rng.normal(0, 0.3, (n_te, 1))

print('配置             | 训练MSE    | 验证MSE    | 测试MSE    | 差距(过拟合?)')
results = {}
for name, kw in [('无正则', dict(reg='none', lam=0.0, drop=0.0)),
                 ('L2 λ=0.1', dict(reg='l2', lam=0.1, drop=0.0)),
                 ('L1 λ=0.02', dict(reg='l1', lam=0.02, drop=0.0)),
                 ('Dropout 0.3', dict(reg='none', lam=0.0, drop=0.3))]:
    m = MLPReg(8, 64, reg=kw['reg'], lam=kw['lam'], drop=kw['drop'], seed=1)
    bv = m.train(Xtr, Ytr, Xva, Yva, epochs=300, lr=0.05, patience=60)
    te = np.mean((m.forward(Xte, training=False) - Yte) ** 2)
    tr = np.mean((m.forward(Xtr, training=False) - Ytr) ** 2)
    gap = te - tr
    results[name] = (tr, bv, te, gap)
    print(f'{name:16s} | {tr:.4f}    | {bv:.4f}    | {te:.4f}    | {gap:+.4f}')
print('\n观察:无正则测试误差最大且差距最大;L2/L1/Dropout 都在压过拟合')
print('Dropout inverted 生效检查: 训练期 H 被随机掩码并除 (1-drop),推理期不再缩放(期望一致)')
§2 Dropout 的理论与细节(必背)¶
机制:训练时每个神经元以概率 $p$ 置零(伯努利掩码)——相当于同时训练 $2^n$ 个共享参数的子网络,预测时取平均(集成)。
inverted dropout(工程标准):训练时对保留神经元除 $1-p$,推理不用改代码:
$$h_{train} = \frac{h \circ m}{1 - p}, \qquad h_{infer} = h$$
期望推导(为什么 inverted 要除 $1-p$):设掩码 $m \sim \mathrm{Bernoulli}(1-p)$ 且与激活独立,则丢弃后同分布的期望为
$$\mathbb{E}[h \circ m] = \mathbb{E}[h] \cdot \mathbb{E}[m] = (1-p)\,\mathbb{E}[h]$$
直接用于推理会让输出系统性偏小 $1-p$ 倍;训练时除以 $1-p$ 恰好补偿:
$$\mathbb{E}\left[\frac{h \circ m}{1-p}\right] = \frac{(1-p)\,\mathbb{E}[h]}{1-p} = \mathbb{E}[h] = h_{infer}$$
训练与推理期望一致——这就是 inverted 缩放 $1/(1-p)$ 的理由(与 non-inverted 的"推理乘 $1-p$"数学等价)。
反向:梯度只在保留神经元位置回传(乘同一掩码 $m$)——注意推理不回传。
适用性:全连接层效果好;卷积后一般用少量 Dropout 或改用 BN(Dropout 打乱空间结构)。
实现对照:本 notebook 的代码采用 inverted dropout——训练分支除 $1-p$,推理分支不再缩放(两者期望一致)。
# ---------- Dropout 期望一致性验证(中间输出) ----------
rng = np.random.default_rng(3)
# 正均值激活(贴近 ReLU 输出),比值检查才有意义;E[h]=2
h = rng.normal(2.0, 1.0, (5, 1000))
p = 0.5
# 训练式(inverted:除以 1-p):
mask = (rng.uniform(size=h.shape) > p).astype(float)
h_train = h * mask / (1 - p)
print('原始激活均值:', round(h.mean(), 4))
print('inverted-dropout 后均值:', round(h_train.mean(), 4), '(期望不变 ✓)')
print('推理模式均值:', round(h.mean(), 4), '(不乘任何东西)')
ratio = h_train.mean() / h.mean()
print(f'训练/推理 均值比: {ratio:.4f} (需 >0.9)   NaN: {bool(np.isnan(h_train.mean()))}')
assert np.isfinite(h_train.mean()) and ratio > 0.9, '公式级期望验证失败'

# 用修复后的 MLPReg.forward 直接验证 inverted dropout 已生效(代码与公式一致)
mm = MLPReg(8, 64, reg='none', drop=0.5, seed=7)
mm.forward(Xtr, training=True)
m_tr = mm.H.mean()
mm.forward(Xtr, training=False)
m_in = mm.H.mean()
print(f'MLPReg.forward: 训练均值 {m_tr:.4f} 推理均值 {m_in:.4f}  比值 {m_tr / m_in:.4f} (>0.9)')
assert np.isfinite(m_tr) and np.isfinite(m_in) and m_tr / m_in > 0.9, '代码级期望验证失败'

# ---------- 早停中间输出:验证 loss 的 U 形 ----------
m2 = MLPReg(8, 64, reg='none', seed=2)
m2.train(Xtr, Ytr, Xva, Yva, epochs=200, lr=0.05, patience=1000)  # 不触发早停
trs = [x[0] for x in m2.history]; vas = [x[1] for x in m2.history]
print('\nepoch |  训练MSE   |  验证MSE')
for e in [0, 30, 60, 100, 150, 199]:
    print(f'  {e:3d}  |  {trs[e]:.5f}  |  {vas[e]:.5f}')
print('→ 训练持续降但验证在 ~60 步后回升(U 形)→ 早停应截在谷底')
§3 L1 vs L2 深入对比(面试高频)¶
| L1 | L2 | |
|---|---|---|
| 惩罚 | $\lambda\|w\|_1$ | $\lambda\|w\|_2^2$ |
| 解 | 稀疏(很多 0) | 稠密(都小但不为 0) |
| 梯度 | $\lambda\operatorname{sign}(w)$(不连续) | $2\lambda w$(光滑) |
| 用途 | 特征选择、可解释 | 常规权重衰减、稳定 |
为什么 L1 稀疏:在 $w=0$ 处 L1 有尖点(次梯度包含 0),梯度下降可停在 0;L2 梯度在 0 处为 0 但邻域总是把它拉离 0。
贝叶斯视角:L1 = 拉普拉斯先验(稀疏)、L2 = 高斯先验(收缩)——最大后验估计。
§4 常见 bug 与边界(面试踩坑区)¶
- Dropout 掩码复用:每个 forward 要重新生成掩码;测试/验证必须
training=False - 忘了 inverted 缩放:训练除 1-p、推理不缩放 → 训练/推理期望不一致
- L1 在 0 处导数:
np.sign(0)=0可行;严格次梯度是区间 [-λ, λ] - 正则作用在偏置上吗:标准只正则权重(不惩罚 b),面试加分点
- λ 太大:欠拟合(L2 权重几乎归零);λ 太小无效——画验证 loss vs λ 选
- 早停用验证集:不能用测试集选早停点(泄漏);固定 patience 避免噪声误停
- Dropout 与 BN 一起用:BN 已有正则效果,Dropout 常可减小;顺序一般 Dropout 在激活后
§5 面试追问与扩展(加分项)¶
5.1 为什么说 Dropout 是集成学习¶
随机掩码生成指数多个子网络(共享权重),推理平均等价于「几何平均集成」——与 Bagging 思想同源但免训练多模型。
5.2 权重衰减与 L2 的区别(AdamW 语境)¶
经典 L2 在梯度里加 $2\lambda w$(受自适应步长影响);weight decay 直接每次更新 $w \gets w(1-\eta\lambda)$——AdamW 用的后者,解耦更干净。
5.3 正则化的其他形式¶
数据增强(旋转/裁剪)、噪声注入(输入/权重)、标签平滑、梯度噪声、早停、模型集成——共同主题:给学习加先验/噪声,抑制对训练集的过拟合。
§6 自测清单(L1 必会 / L2 进阶 / L3 挑战)¶
L1 必会(10 问)¶
- 1. 写出 L2 目标函数与梯度
- 2. 写出 L1 目标函数与次梯度
- 3. 手写 Dropout 前向(训练/推理 + inverted)
- 4. 手写 Dropout 反向
- 5. 手写早停(验证 loss + 回滚最优)
- 6. 解释 L1 稀疏、L2 稠密
- 7. 识别过拟合信号(train/val gap)
- 8. 手写带正则的 MLP 训练对比表
- 9. Dropout 训练/推理期望一致性
- 10. 正则作用范围(权重 vs 偏置)
L2 进阶(10 问)¶
- 11. 贝叶斯视角:L1/L2 对应先验
- 12. 手写 weight decay(AdamW 风格)与 L2 对比
- 13. 数据增强手写(旋转/噪声)
- 14. 标签平滑手写
- 15. 手写 λ 选择实验(验证 loss vs λ)
- 16. Dropout 与 BN 组合实验
- 17. 手写输入噪声注入
- 18. 早停 patience 的敏感性实验
- 19. 手写集成(多个 seed 平均)
- 20. L1 特征选择效果演示(权重稀疏表)
L3 挑战(5 问)¶
- 21. 推导 Dropout 训练/推理的期望与方差
- 22. 手写 Variational Dropout(不确定量化)
- 23. 深度网络中的 Spectral Norm / Orthogonal 正则
- 24. 手写 Mixup 训练
- 25. 分析 L2 对 Hessian 特征值的影响(曲率视角)
自测要点¶
- 白板推导 L1/L2 梯度与稀疏性原因
- 10 分钟内盲写:Dropout(含反向)+ 早停
- 讲清 Dropout=集成、AdamW 权重衰减差异
# ---------- 手写 inverted dropout vs torch.nn.Dropout ----------
import torch
p = 0.4
x = torch.tensor([[1.0, 2.0, 3.0, 4.0, 5.0]])
m = torch.nn.Dropout(p)

# 1) 训练模式:固定种子,从 torch 输出反推掩码,验证手写公式逐位一致
torch.manual_seed(5)                 # seed=5 → 掩码 [0,1,1,1,1](丢弃第 1 个)
m.train()
out_torch = m(x)
mask = (out_torch != 0).float()      # 保留位=1,丢弃位=0
out_manual = x * mask / (1 - p)      # 手写 inverted 前向:x∘m/(1-p)
print('掩码(1=保留):', mask.tolist())
print('torch 输出   :', out_torch.tolist())
print('手写输出     :', out_manual.tolist())
print('逐位一致:', torch.allclose(out_torch, out_manual, atol=1e-6))

# 2) 均值对比:2000 次随机掩码后,训练均值应收敛回 x(inverted 缩放的效果)
torch.manual_seed(0)
acc = torch.zeros_like(x)
for _ in range(2000):
    acc += m(x)
mean_out = acc / 2000
print('2000 次训练平均:', [round(v, 3) for v in mean_out.flatten().tolist()], '≈ x')
print('均值对比通过:', bool(torch.allclose(mean_out, x, atol=0.3)))

# 3) 推理模式:torch 与手写都不再缩放
m.eval()
print('eval torch == x:', torch.equal(m(x), x))
print('eval 手写 == x :', torch.equal(x, x))

# 4) p=0 兜底:掩码全 1,训练输出等于输入(框架等价)
m0 = torch.nn.Dropout(0)
print('p=0 训练输出 == x:', torch.equal(m0(x), x))