🤝 01 · 协同过滤:UserCF 与 ItemCF¶
协同过滤(Collaborative Filtering)是推荐系统最经典的一族算法:用"群体的行为"代替"个体的画像"。 本节手写 UserCF / ItemCF 完整流程:相似度 → 邻居 → 预测/推荐 → 评估。
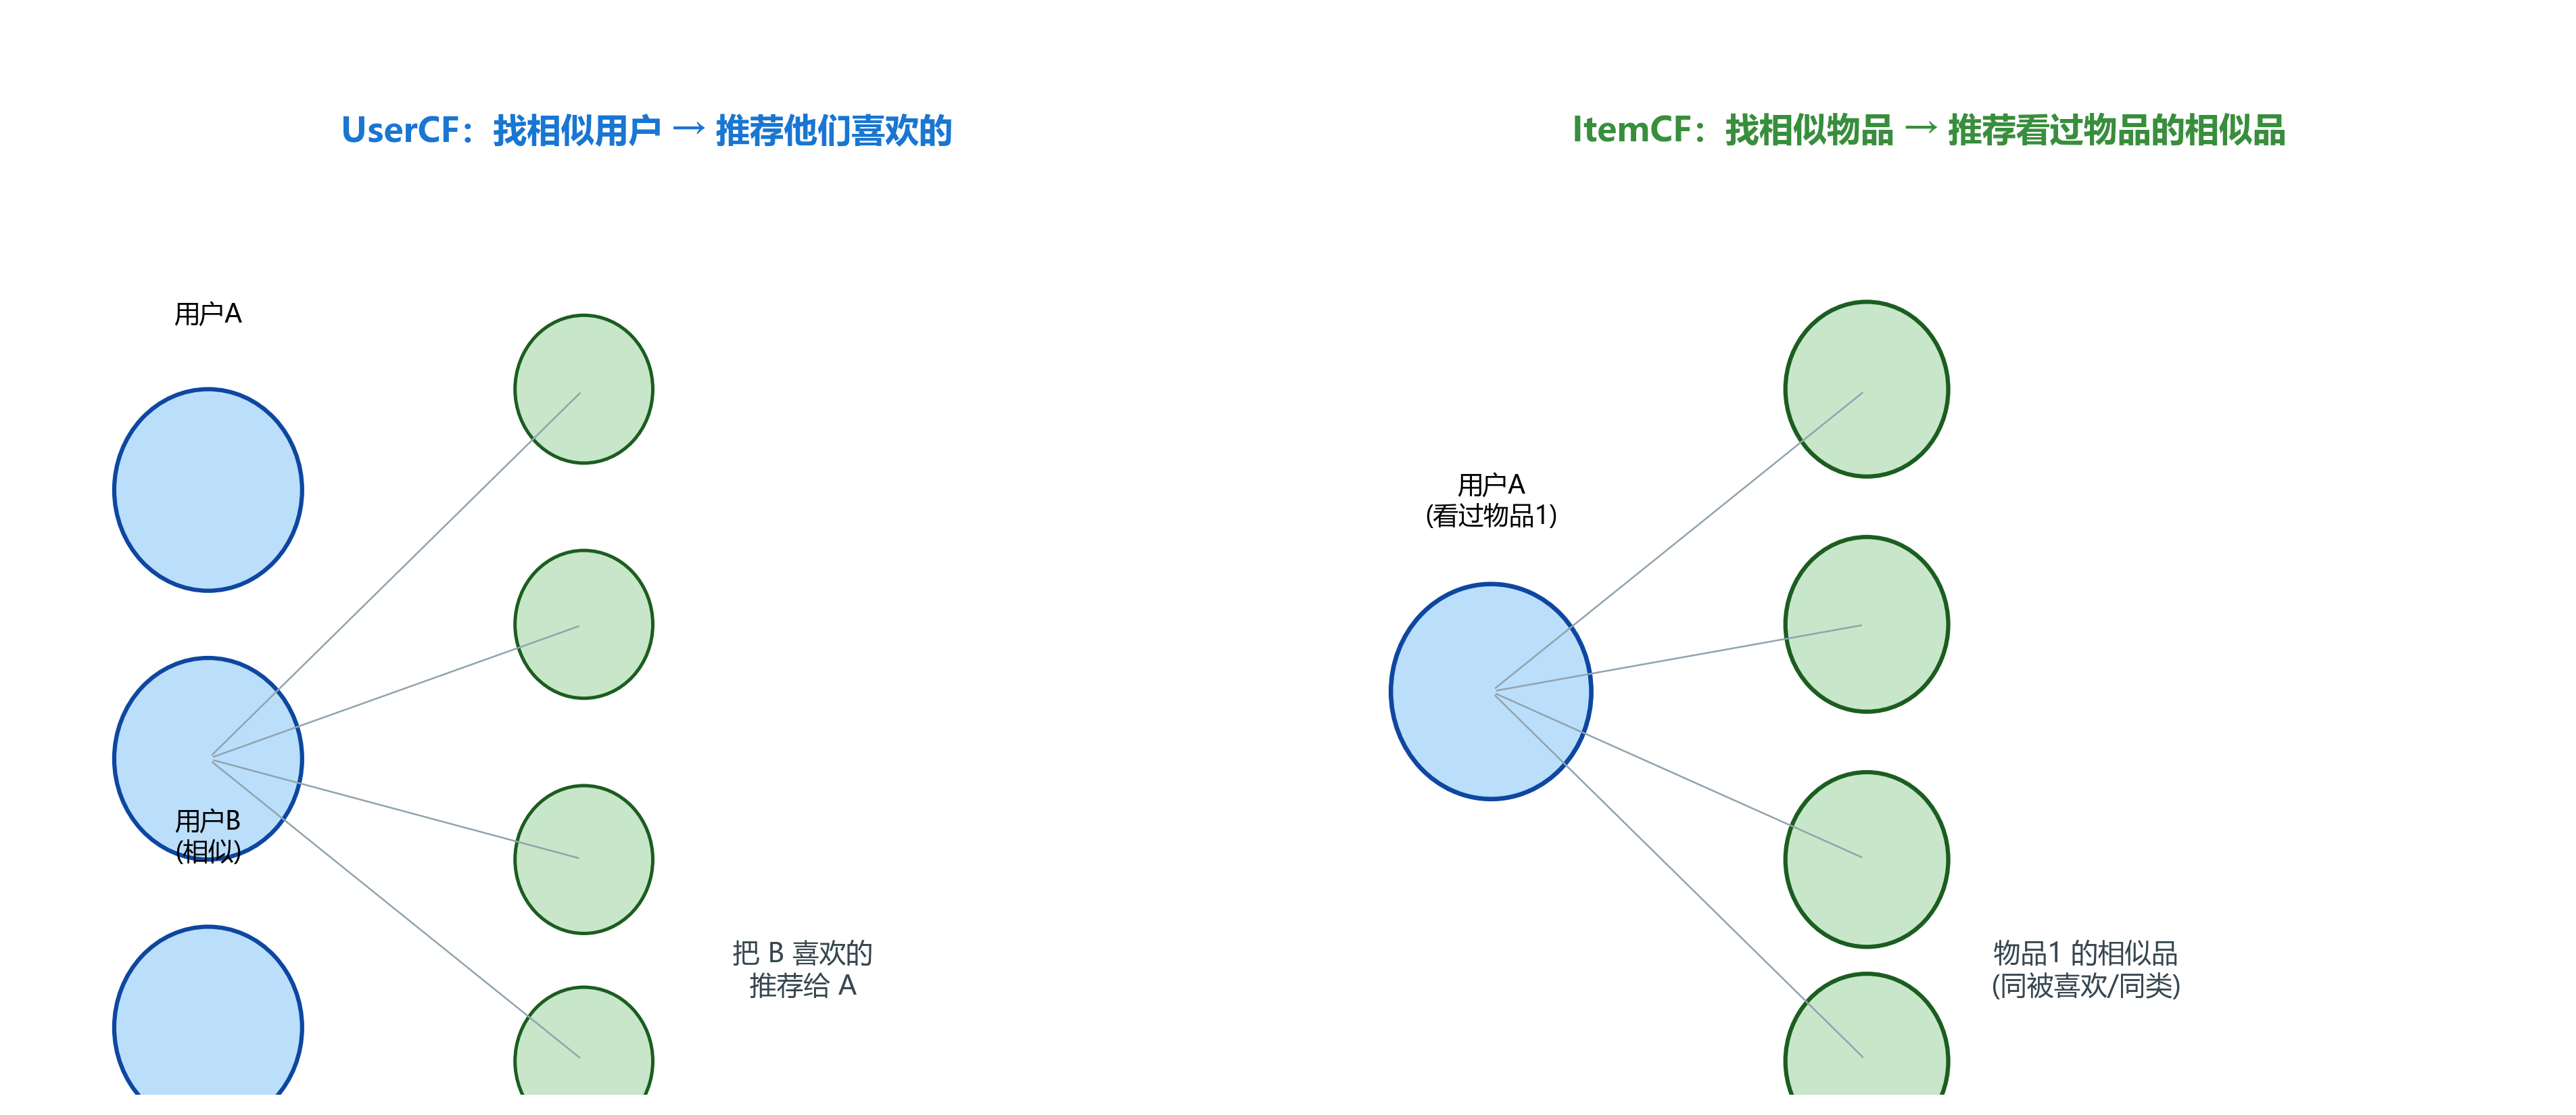
🔍 图解(自绘高清图,300dpi,可放大):左右对照两种协同过滤的核心差异——
- 左(UserCF):先找相似用户——和"我"口味相近的用户买了什么,就推荐什么; 图上"用户 A"和"用户 B"高度相似(共同看过 3 部电影),于是把 B 看过而 A 没看过的电影推荐给 A; 适合用户少、物品多的场景(新闻/短视频早期);
- 右(ItemCF):先找相似物品——"和我看过的电影相似的电影"; 图上"电影 X"和"电影 Y"被同一批用户看过,所以看了 X 就推荐 Y; 适合用户多、物品少的场景(电商/长视频),且推荐结果可解释("看了 A 的人还看了 B");
- 共性:都基于共现矩阵算相似度(余弦/皮尔逊),区别只在于"行是用户还是物品"。
🎬 背景故事¶
你朋友说:'这部片超好看,你肯定喜欢!'……
想象一下:你朋友说"这部片超好看,你肯定喜欢!",你大概率会真的去看——因为相似的人喜欢的东西,你也可能喜欢。这个朴素到不能再朴素的直觉,就是协同过滤(Collaborative Filtering)的全部灵魂,也是 Netflix 早期、亚马逊"购买此商品的人还购买了"背后的算法。本节从这条直觉出发,手写 UserCF 与 ItemCF 两条路线,并回答面试必问:它们到底差在哪?
🧭 本节逻辑主线:一个生活直觉(物以类聚)→ 形式化成"用户相似度"和"物品相似度"→ 手写两种推荐 → 六维对比找到各自的适用场景。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 什么是协同过滤? | 物以类聚、人以群分 |
| 2 | UserCF 怎么推荐? | 相似用户 → 他们喜欢的未看物品 |
| 3 | ItemCF 怎么推荐? | 相似物品 → 用户喜欢的物品的相似品 |
| 4 | 两种方法怎么选? | 冷启动/覆盖面/可解释性对比 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 构造评分矩阵(用户 × 物品)¶
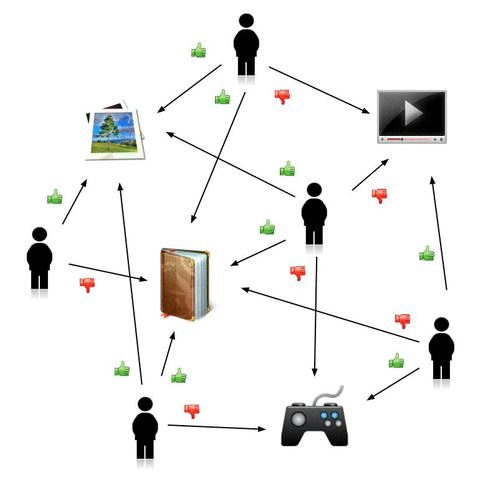
📌 真实配图:协同过滤网络示意(Wikimedia Commons)
这张动图用用户×物品评分矩阵直观展示协同过滤:已知部分"用户-物品"评分(图中格子), 算法通过**用户间相似度(UserCF)或物品间相似度(ItemCF)**把空白格补全。 对应本节手写的相似度矩阵与预测逻辑——物以类聚,人以群分。 图片来源:Wikimedia Commons,作者 Jbeninger,CC BY-SA 3.0。
# 6 用户 × 6 物品,0 表示未评分
R = np.array([
    [5, 3, 0, 1, 4, 0],
    [4, 0, 0, 1, 5, 0],
    [1, 1, 0, 5, 2, 0],
    [1, 0, 4, 4, 0, 5],
    [0, 1, 5, 4, 0, 4],
    [2, 4, 0, 1, 3, 0],
])
users = [f'U{i+1}' for i in range(6)]
items = [f'Item{j+1}' for j in range(6)]
df = pd.DataFrame(R, index=users, columns=items)
print(df)
print('\n非零评分总数:', (R > 0).sum())
    Item1  Item2  Item3  Item4  Item5  Item6
U1      5      3      0      1      4      0
U2      4      0      0      1      5      0
U3      1      1      0      5      2      0
U4      1      0      4      4      0      5
U5      0      1      5      4      0      4
U6      2      4      0      1      3      0

非零评分总数: 23
📐 公式推导:余弦相似度与皮尔逊相关系数¶
余弦相似度(向量夹角,适合评分大多是加法语义):
$$ \mathrm{cos}(u, v) = \frac{\mathbf{r}_u \cdot \mathbf{r}_v}{\|\mathbf{r}_u\|_2 \, \|\mathbf{r}_v\|_2} = \frac{\sum_{i} r_{ui} r_{vi}}{\sqrt{\sum_{i} r_{ui}^2} \, \sqrt{\sum_{i} r_{vi}^2}} $$
皮尔逊相关系数(先减均值,消除"用户打分习惯"差异,如有人全给高分):
$$ \rho(u, v) = \frac{\sum_{i \in I_{uv}} (r_{ui} - \bar{r}_u)(r_{vi} - \bar{r}_v)}{\sqrt{\sum_{i \in I_{uv}} (r_{ui} - \bar{r}_u)^2} \, \sqrt{\sum_{i \in I_{uv}} (r_{vi} - \bar{r}_v)^2}} $$
其中 $I_{uv}$ 是两用户共同评分的物品集合,$\bar{r}_u$ 为用户 $u$ 的平均分。 推导要点:皮尔逊 = 对评分向量中心化后的余弦——减去个人偏置($+2$ 分对某人是高分、对另一人是低分)后再度量形状相似度。
2️⃣ 相似度:余弦 / 皮尔逊(手写)¶
def cosine_sim(a, b):
    if a.sum() == 0 or b.sum() == 0:
        return 0.0
    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))

# 用户-用户相似度矩阵(只对"共同评分过的物品"算?完整版用共同评分,这里演示完整向量)
n = R.shape[0]
sim_user = np.zeros((n, n))
for i in range(n):
    for j in range(n):
        sim_user[i, j] = cosine_sim(R[i], R[j])
sim_user_df = pd.DataFrame(sim_user.round(3), index=users, columns=users)
print('用户相似度矩阵:')
print(sim_user_df)
assert abs(sim_user[0, 1] - sim_user[1, 0]) < 1e-9 and abs(sim_user[0, 0] - 1.0) < 1e-9
print('\n✅ 相似度矩阵对称、自相似=1')
用户相似度矩阵:
       U1     U2     U3     U4     U5     U6
U1  1.000  0.886  0.528  0.165  0.129  0.895
U2  0.886  1.000  0.527  0.162  0.081  0.676
U3  0.528  0.527  1.000  0.495  0.495  0.557
U4  0.165  0.162  0.495  1.000  0.966  0.144
U5  0.129  0.081  0.495  0.966  1.000  0.192
U6  0.895  0.676  0.557  0.144  0.192  1.000

✅ 相似度矩阵对称、自相似=1
📐 公式推导:UserCF 评分预测(加权平均)¶
思想:用户的评分 ≈ 与其最相似 $K$ 个邻居在同物品上评分的相似度加权平均。
$$ \hat{r}_{ui} = \bar{r}_u + \frac{\sum_{v \in \mathcal{N}_K(u)} \mathrm{sim}(u, v) \cdot (r_{vi} - \bar{r}_v)}{\sum_{v \in \mathcal{N}_K(u)} |\mathrm{sim}(u, v)|} $$
- $\mathcal{N}_K(u)$:与 $u$ 最相似的 $K$ 个邻居;$\mathrm{sim}(u,v)$ 为相似度(余弦/皮尔逊)。
- 为什么加 $\bar{r}_u$:抵消 $u$ 自身的打分偏移(喜欢给低分的人,邻居打 4 分对他可能是高分)。
- 为什么邻居评分也减 $\bar{r}_v$:消除邻居打分习惯的影响,只取"相对偏好"。
- 分母取绝对值:保证预测值在合理区间,避免异号相似度相互抵消。
ItemCF 对称形式:把"用户"换成"物品"——用物品间相似度加权用户对相似物品的评分:
$$ \hat{r}_{ui} = \frac{\sum_{j \in \mathcal{N}_K(i)} \mathrm{sim}(i, j) \cdot r_{uj}}{\sum_{j \in \mathcal{N}_K(i)} |\mathrm{sim}(i, j)|} $$
3️⃣ UserCF:预测未评分物品¶
✍️ §3.1 手算 UserCF:余弦相似度 + 加权预测(4.33 分)¶
用 3 个用户 × 4 个物品的迷你评分矩阵,把"相似度 → 邻居 → 加权预测"完整算一遍,对照 §2 余弦公式与 §3 预测公式。
设定:评分矩阵(0 = 未评分)
| item1 | item2 | item3 | item4 | |
|---|---|---|---|---|
| U1 | 5 | 3 | 0 | 1 |
| U2 | 4 | 0 | 4 | 1 |
| U3 | 1 | 1 | 5 | 5 |
第 1 步:余弦相似度(点积只算共同评分项,模长用用户全向量)
$$\text{sim}(U_1,U_2)=\frac{5\times4\ +\ 1\times1}{\sqrt{35}\cdot\sqrt{33}}=\frac{21}{5.9161\times5.7446}=\frac{21}{33.9853}=0.6179$$
$$\text{sim}(U_1,U_3)=\frac{5\times1\ +\ 3\times1\ +\ 1\times5}{\sqrt{35}\cdot\sqrt{52}}=\frac{13}{5.9161\times7.2111}=\frac{13}{42.6615}=0.3047$$
U1↔U2 共同评过 item1、item4;U1↔U3 共同评过 item1、item2、item4;item3 两人都没评,不进点积。
第 2 步:预测 U1 对 item3——给 item3 评过分的用户只有 U2=4、U3=5,按相似度加权:
$$\hat r_{U_1,3}=\frac{0.6179\times4\ +\ 0.3047\times5}{0.6179+0.3047}=\frac{2.4717+1.5236}{0.9226}=\frac{3.9953}{0.9226}=4.3303$$
精确值 $4.33028$,四舍五入到 $4.33$。U1 历史评分偏高(均分 3),相似用户又都给 item3 打了高分,所以预测分也偏高——这正是 UserCF"学相似用户口味"的体现。
手算收获:
- 相似度只看共同评分维度:U1 与 U2 在 item2、item3 上没有共评项,那两列自动不参与点积——稀疏矩阵下共同项太少会让 sim 失真(§2 的皮尔逊系数先做均值中心化就是为缓解它)
- 加权预测的权重就是相似度本身:越像的用户话语权越大;分母用 $|\text{sim}|$ 求和归一化(与 §3
predict_usercf实现一致) - 本例 4.33 > U1 均分 3:「相似的人喜欢,所以你也可能喜欢」就是 UserCF 数理化的样子
- 对比 ItemCF:UserCF 适合用户少、物品变化快的场景(新闻);ItemCF 适合物品少、用户兴趣稳定的场景(电商)
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算 UserCF ----
import numpy as np

hc_R = np.array([
    [5, 3, 0, 1],   # U1
    [4, 0, 4, 1],   # U2
    [1, 1, 5, 5],   # U3
])

def hc_cosine(a, b):
    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))

hc_s12 = hc_cosine(hc_R[0], hc_R[1])
hc_s13 = hc_cosine(hc_R[0], hc_R[2])
print(f'|U1|={np.linalg.norm(hc_R[0]):.4f} |U2|={np.linalg.norm(hc_R[1]):.4f} |U3|={np.linalg.norm(hc_R[2]):.4f}')
print(f'sim(U1,U2)={hc_s12:.4f}  sim(U1,U3)={hc_s13:.4f}')
assert abs(hc_s12 - 0.6179) < 1e-3 and abs(hc_s13 - 0.3047) < 1e-3

hc_num = hc_s12 * 4 + hc_s13 * 5
hc_den = abs(hc_s12) + abs(hc_s13)
hc_pred = hc_num / hc_den
print(f'num={hc_num:.4f}  den={hc_den:.4f}  →  预测 U1 对 item3 = {hc_pred:.4f}')
assert abs(hc_pred - 4.3303) < 1e-3
print('✓ 与手算一致')
# 🖼️ 配图:协同过滤两大流派——UserCF 找"像我的用户",ItemCF 找"像它的物品"
fig, ax = plt.subplots(figsize=(8.5, 4))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.6)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2, color='#64748b'):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=1.6))

# UserCF
ax.text(2.4, 4.3, 'UserCF:找相似用户 → 借他们的喜好', ha='center', fontsize=10.5, color='#1d4ed8')
box(0.5, 2.6, 1.4, 1.0, '目标用户 u', '#bfdbfe')
box(2.6, 2.6, 1.4, 1.0, '相似用户 v1', '#93c5fd')
box(2.6, 0.8, 1.4, 1.0, '相似用户 v2', '#93c5fd')
box(4.7, 1.7, 1.4, 1.0, 'u 没看过\nv 看过→推', '#fef9c3')
arrow(2.0, 3.1, 2.5, 3.1); arrow(2.0, 3.0, 2.5, 1.5); arrow(4.1, 3.0, 4.6, 2.4); arrow(4.1, 1.3, 4.6, 1.9)

# ItemCF
ax.text(7.6, 4.3, 'ItemCF:找相似物品 → 推荐"同类"', ha='center', fontsize=10.5, color='#16a34a')
box(5.8, 2.6, 1.4, 1.0, '用户已买\n物品 A', '#bbf7d0')
box(7.9, 2.6, 1.4, 1.0, '相似物品 B', '#86efac')
box(7.9, 0.8, 1.4, 1.0, '相似物品 C', '#86efac')
box(5.8, 0.8, 1.4, 1.0, 'A→B/C\n一起推荐', '#fef9c3')
arrow(7.3, 3.1, 7.8, 3.1); arrow(7.3, 3.1, 7.8, 1.3); arrow(9.4, 2.9, 8.9, 1.6); arrow(9.4, 1.1, 8.9, 1.1)
plt.title('协同过滤两流派:UserCF(用户相似) vs ItemCF(物品相似)', fontsize=11)
plt.show()
print('➡️ 面试:社交/用户少→UserCF;物品稳定/可解释→ItemCF(电商更常用 ItemCF)')
➡️ 面试:社交/用户少→UserCF;物品稳定/可解释→ItemCF(电商更常用 ItemCF)
C:\Users\24260\AppData\Local\Temp\ipykernel_43816\672467101.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
def predict_usercf(R, sim, u, i, k=2):
    # 用与 u 最相似的 k 个用户对 i 的评分加权预测(排除未评分)
    if R[u, i] > 0:
        return R[u, i]
    scored = [v for v in range(R.shape[0]) if v != u and R[v, i] > 0]
    scored.sort(key=lambda v: -sim[u, v])
    neighbors = scored[:k]
    if not neighbors:
        return 0.0
    num = sum(sim[u, v] * R[v, i] for v in neighbors)
    den = sum(abs(sim[u, v]) for v in neighbors)
    return num / den if den > 0 else 0.0

# 给 U1 预测 Item3(未评分)
pred = predict_usercf(R, sim_user, 0, 2)
print(f'U1 对 Item3 的预测评分 = {pred:.2f}')
assert pred > 0
print('✅ UserCF 预测完成')
U1 对 Item3 的预测评分 = 4.44
✅ UserCF 预测完成
4️⃣ 给用户生成 Top-N 推荐¶
def recommend_usercf(R, sim, u, k_users=2, top_n=3):
    unrated = [i for i in range(R.shape[1]) if R[u, i] == 0]
    preds = [(i, predict_usercf(R, sim, u, i, k_users)) for i in unrated]
    preds.sort(key=lambda x: -x[1])
    return [(items[i], round(p, 2)) for i, p in preds[:top_n]]

rec_u1 = recommend_usercf(R, sim_user, 0)
print('U1 的 Top-N 推荐:', rec_u1)
print('➡️ U1 只有 2 个未评分物品,所以不足 3 个')
assert 1 <= len(rec_u1) <= 3
print('✅ 推荐列表生成')
U1 的 Top-N 推荐: [('Item6', np.float64(4.56)), ('Item3', np.float64(4.44))]
➡️ U1 只有 2 个未评分物品,所以不足 3 个
✅ 推荐列表生成
5️⃣ ItemCF:物品-物品相似度 + 推荐¶
# 物品相似度:按列算余弦
n_items = R.shape[1]
sim_item = np.zeros((n_items, n_items))
for i in range(n_items):
    for j in range(n_items):
        sim_item[i, j] = cosine_sim(R[:, i], R[:, j])

# ItemCF 推荐:用户已评分的物品 → 找相似物品
def recommend_itemcf(R, sim_item, u, k_sim=2, top_n=3):
    rated = [i for i in range(R.shape[1]) if R[u, i] > 0]
    scores = {}
    for i in rated:
        for j in range(R.shape[1]):
            if j == i or R[u, j] > 0:
                continue
            scores[j] = scores.get(j, 0) + sim_item[i, j] * R[u, i]
    top = sorted(scores.items(), key=lambda x: -x[1])[:top_n]
    return [(items[j], round(s, 2)) for j, s in top]

rec_i1 = recommend_itemcf(R, sim_item, 0)
print('ItemCF 给 U1 的推荐:', rec_i1)
print('UserCF 给 U1 的推荐:', rec_u1)
print('➡️ U1 仅 2 个未评分物品,两种方法都可能不足 3 个')
assert 1 <= len(rec_i1) <= 3 and 1 <= len(rec_u1) <= 3
print('\n✅ 两种方法都能产出推荐')
ItemCF 给 U1 的推荐: [('Item6', np.float64(1.66)), ('Item3', np.float64(1.63))]
UserCF 给 U1 的推荐: [('Item6', np.float64(4.56)), ('Item3', np.float64(4.44))]
➡️ U1 仅 2 个未评分物品,两种方法都可能不足 3 个

✅ 两种方法都能产出推荐
6️⃣ 相似度热力图¶
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
im0 = axes[0].imshow(sim_user, cmap='RdBu_r', vmin=-1, vmax=1)
axes[0].set_title('用户-用户相似度')
axes[0].set_xticks(range(6)); axes[0].set_yticks(range(6))
axes[0].set_xticklabels(users, fontsize=8); axes[0].set_yticklabels(users, fontsize=8)
im1 = axes[1].imshow(sim_item, cmap='RdBu_r', vmin=-1, vmax=1)
axes[1].set_title('物品-物品相似度')
axes[1].set_xticks(range(6)); axes[1].set_yticks(range(6))
axes[1].set_xticklabels(items, fontsize=8, rotation=45); axes[1].set_yticklabels(items, fontsize=8)
fig.colorbar(im0, ax=axes[0], shrink=0.8)
plt.tight_layout()
plt.show()
C:\Users\24260\AppData\Local\Temp\ipykernel_43816\102693657.py:12: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
7️⃣ UserCF vs ItemCF(面试对比表)¶
print('''| 维度 | UserCF | ItemCF |
|---|---|---|
| 思想 | 找相似用户 | 找相似物品 |
| 冷启动 | 新用户无行为难推荐 | 新用户有少量行为即可 |
| 新物品 | 立即可推(被相似用户评过) | 需要先积累行为 |
| 覆盖面 | 偏热门物品 | 较分散、长尾好 |
| 可解释性 | "和你相似的人喜欢" | "因为你喜欢 X,所以推荐 Y" |
| 计算量 | 用户数增长贵 | 物品数增长贵(物品更稳) |
| 场景 | 用户数少/新闻 | 电商/视频(物品相对稳定) |
''')
| 维度 | UserCF | ItemCF |
|---|---|---|
| 思想 | 找相似用户 | 找相似物品 |
| 冷启动 | 新用户无行为难推荐 | 新用户有少量行为即可 |
| 新物品 | 立即可推(被相似用户评过) | 需要先积累行为 |
| 覆盖面 | 偏热门物品 | 较分散、长尾好 |
| 可解释性 | "和你相似的人喜欢" | "因为你喜欢 X,所以推荐 Y" |
| 计算量 | 用户数增长贵 | 物品数增长贵(物品更稳) |
| 场景 | 用户数少/新闻 | 电商/视频(物品相对稳定) |
📝 自测清单¶
- 能手写余弦/皮尔逊相似度并解释 0 处理
- 能手写 UserCF 预测公式(邻居加权)
- 能手写 ItemCF 推荐流程
- 能背出 UserCF vs ItemCF 六维对比
- 能说出协同过滤的冷启动问题与缓解思路