⚙️ 01-梯度下降与迭代优化入门¶
目标:从沿负梯度下降这个最小动作出发,建立「步长(学习率)→ 收敛性 → 噪声」的直觉,并为后续 动量 / 自适应 / 二阶方法搭好对照系。
§1 为什么从梯度下降讲起¶
所有优化器(SGD / Momentum / AdaGrad / Adam / 牛顿法)都共享同一个骨架:
$$w_{t+1} = w_t - \eta \, \text{(某种更新方向)}$$
区别只在更新方向怎么构造:
| 家族 | 更新方向 | 解决什么 | 代价 |
|---|---|---|---|
| SGD | $-g$ | 最基本 | 病态曲率震荡 / 无历史 / 一刀切 lr |
| 动量族 | 历史梯度 EMA $v$ | 震荡、平坦区 | 多一份状态 $v$ |
| 自适应 | $g/\sqrt{E[g^2]}$ | 逐参数步长(稀疏) | 多一份状态、泛化争议 |
| 二阶 | $H^{-1}g$ | 曲率自适应(牛顿) | $H$ 是 $n^2$ 存不下 |
本节先只讲 SGD:学习率怎么选、为什么过大发散、mini-batch 噪声从哪来。
核心概念¶
(a) 🗂️ 梯度下降与迭代优化知识地图¶
这篇是优化算法的总入口:为什么大问题只能用迭代法、为什么走负梯度方向、学习率怎么选,以及收敛速度、条件数、BGD/SGD/Mini-batch 噪声等核心概念,为后面所有优化器打底。
flowchart TB
    Node1["🧠 迭代优化 vs 解析解"]
    Node1 --> Node2["🧠 负梯度方向"]
    Node2 --> Node3["🧠 学习率 lr"]
    Node3 --> Node4["🧠 收敛速度三档"]
    Node4 --> Node5["🧠 条件数 κ"]
    Node5 --> Node6["🧠 BGD / SGD / Mini-batch"]
    Node6 --> Node7["🧠 凸/强凸/非凸"]
    Node7 --> Node8["🧠 数值稳定性排查"]
    Node8 --> Node9["🧠 学习率三步法"]
- 节点1(迭代优化 vs 解析解):高维非凸问题没有解析解,只能从一个初始点出发反复迭代"走一步看一步"。解析解像一次算出答案,迭代法像爬山下坡一步步逼近谷底。
- 节点2(负梯度方向):梯度指向函数上升最快的方向,所以往负梯度走是"局部最陡下降",一阶泰勒展开就能说明它必然让函数暂时变小。
- 节点3(学习率 lr):步长有三档命运:太小爬得慢,太大震荡甚至发散,合适才收敛。在一维 f=½ax² 上最优步长 η=1/a 可解析算出,用来建立"步长=曲率倒数"的直觉。
- 节点4(收敛速度三档):线性、亚线性、超线性——线性最慢(误差每步乘常数),牛顿类方法超线性最快;SGD 的收敛率 O(1/√t) 就是亚线性。
- 节点5(条件数 κ):κ = 最大特征值/最小特征值,衡量地形"椭圆"得有多扁;κ 越大,梯度下降在峡谷里来回震荡,收敛率 O((1−κ⁻¹)^t) 越慢。
- 节点6(BGD / SGD / Mini-batch):全批量最稳但慢,SGD 每样本一更新、噪声大但能逃离鞍点,Mini-batch 是折中:噪声"可控"且能向量化。
- 节点7(凸/强凸/非凸):凸函数保证全局最优,强凸保证线性收敛率;非凸曲面有鞍点和对称破缺问题,梯度下降可能只到局部最优,这是深度学习的常态。
- 节点8(数值稳定性排查):NaN/Inf 从哪来:lr 太大、梯度爆炸、除以 0、溢出;给出一张按序排查表(梯度范数 → 中间量 → 损失 → 数据),面试加分。
- 节点9(学习率三步法):先扫数量级(1e-1 到 1e-5)→ 看损失曲线趋势调 → 固定最优附近精细调;SGD 的三大短板(慢、震荡、难调)引出后文的动量与自适应方法。
§1.1 历史背景:为什么是「迭代法」而不是解析解¶
优化问题与微积分同龄:费马(Fermat,1637 前后) 就提出极值点处切线水平、即 $f'(x)=0$,把「求最优」归结为「解方程」。但在真实问题里这条路几乎走不通:
- 解不出来:五次以上多项式没有通用求根公式(阿贝尔-鲁菲尼定理),而神经网络的损失是百万维非线性的 $f$,$\nabla f=0$ 根本无解析解;
- 代价爆炸:即使可解,直接解析也常要 $O(n^3)$ 量级操作,而一步梯度计算只要 $O(n)$;
- 目标是移动靶:训练数据不断变化,最优解本身在动,静态的解析解没有意义。
所以现代优化走迭代法:从初始点出发,每步做一次廉价的 $O(n)$ 更新,用「足够多步」逼近答案。牛顿 1669 年用切线法迭代求方程根,就是这个思路的最早雏形——把非线性问题局部线性化、反复逼近。理解这一点,才能明白后面所有优化器为何都是「$w_{t+1}=w_t-\eta\cdot(\text{方向})$」的重复。
§1.2 为什么偏偏是「负梯度」方向¶
对可微的 $f$,在 $w$ 处沿单位方向 $d$ 迈一小步,函数值的一阶近似为 $$f(w+\epsilon d)\approx f(w)+\epsilon\,d^{\mathsf T}\nabla f(w),\qquad \|d\|=1.$$ 要让 $f$ 下降得最快,就要让 $d^{\mathsf T}\nabla f(w)$ 尽量负。由柯西-施瓦茨不等式 $d^{\mathsf T}\nabla f(w)\ge -\|\nabla f(w)\|$,等号当且仅当 $d=-\nabla f(w)/\|\nabla f(w)\|$——负梯度是当前点的最速下降方向。
两个几何事实请记牢:
- 梯度垂直于等高线:在等高线 $f(w)=c$ 上,梯度与切线满足 $\nabla f^{\mathsf T}d=0$,所以负梯度总是指向等值线内侧;
- 「最速」是局部概念:它只对当前点附近的无穷小步长最优。真正迈出一步后地形变了,最优方向也随之改变——这正是必须「迭代」而非「一步到位」的深层原因,也是下篇动量「看得更远」的动机。
从「函数」到「地形」的三个数学视角¶
要真正读懂优化,需要把 $f(w)$ 从「一个公式」翻译成「一张地形图」,三个视角缺一不可:
- 切平面 / 线性化:在 $w_0$ 处 $f(w)\approx f(w_0)+\nabla f(w_0)^{\mathsf T}(w-w_0)$。梯度 $\nabla f$ 正是切平面的「坡度向量」:分量 $\partial f/\partial w_i$ 是沿第 $i$ 个坐标轴的斜率,方向导数 $\nabla f^{\mathsf T}d$ 是沿任意方向 $d$ 的斜率;
- 等高线:把高度相同的点连成线。等高线越密坡度越陡;$\nabla f$ 与等高线法向一致(负梯度垂直指向等值线内侧);
- Hessian = 曲率:$\nabla^2 f$ 描述等高线是圆、椭圆还是马鞍;特征向量方向是「曲率主轴」,特征值越大、该方向坡度变化越剧烈。
本章所有结论(步长上界、条件数、收敛率)都可以用这三个视角各自推一遍——尤其「椭圆碗 + 主轴」的视角,直接预告了 02 篇峡谷地形与 03 篇自适应步长的全部动机。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# ---------- 手写梯度下降(统一接口:step(w, g, t) -> w) ----------
def sgd_step(w, g, t, lr=0.1):
    return w - lr * g

def run_gd(f, grad_f, w0, steps, step_fn):
    w = w0.copy()
    hist = [w.copy()]
    for t in range(steps):
        g = grad_f(w)
        w = step_fn(w, g, t)
        hist.append(w.copy())
    return np.array(hist)

plt.show()
§1.3 手算范例:$f(x)=\tfrac12 ax^2$ 上的三种命运¶
所有步长直觉都可以在一维二次函数上验证。设 $f(x)=\tfrac12ax^2$,梯度 $f'(x)=ax$,梯度下降更新为 $$x_{t+1}=x_t-\eta\,ax_t=(1-\eta a)\,x_t.$$ 这是一个等比数列:$\eta a=1$ 时一步到谷底;$\eta a<1$ 时按 $|1-\eta a|$ 收缩(线性收敛);$1<\eta a<2$ 时围绕 0 振荡但收敛;$\eta a>2$ 时 $|1-\eta a|>1$,振幅逐次放大而发散。
取 $a=2,\eta=1.1$(等比因子 $1-2.2=-1.2$,模长 1.2)手算前几步:
$$x_0=2.00 \to x_1=-0.40 \to x_2=0.48 \to x_3=-0.576 \to x_4=0.6912\to\cdots$$
每一步都是前一步的 $-1.2$ 倍,绝对值只增不减——这就是「学习率过大」的现场:loss 反复跳向 inf。反之 $\eta=0.05$ 时等比因子 $1-0.1=0.9$,30 步后仍停在 $x\approx2\times0.9^{30}\approx0.085$,典型的「蜗牛爬」。
把这三个数字对照下面的实验 1:同样的 $a=2$、同样的起点 $x_0=2$,只改 $\eta$,三种命运一目了然。
# ---------- 实验 1:一维凸函数 f(x)=x^2,最优步长可解析 ----------
# 解析最优步长:f(x)=0.5*a*x^2 -> 梯度=a*x -> 最优 eta=1/a(一步到位)
a = 2.0
f = lambda x: 0.5 * a * x**2
gf = lambda x: a * x

fig, axes = plt.subplots(1, 3, figsize=(12, 3.4))
cases = [('eta=0.5 (一步到位)', 0.5, 5, '#55A868'),
         ('eta=1.1 (发散)', 1.1, 6, '#C44E52'),
         ('eta=0.05 (过小)', 0.05, 30, '#4C72B0')]
xs = np.linspace(-2.5, 2.5, 400)
for ax, (ttl, eta, steps, col) in zip(axes, cases):
    ax.plot(xs, f(xs), color='#8E8E93', lw=1.5, label='f(x)')
    hist = run_gd(f, gf, np.array([2.0]), steps, lambda w, g, t: w - eta * g)
    ax.plot(hist[:, 0], f(hist[:, 0]), 'o-', color=col, lw=1.2, ms=4, label='GD 轨迹')
    ax.axhline(0, color='k', lw=0.6)
    ax.set_title(ttl, fontsize=11)
    ax.set_xlim(-2.6, 2.6); ax.set_ylim(-0.4, 7)
    ax.legend(fontsize=8, loc='upper center')
    ax.grid(alpha=0.3)
fig.suptitle('学习率三态:一步到位 / 发散 / 蜗牛爬', fontsize=12)
plt.tight_layout(); plt.show()
print('结论:eta > 1/a 时 |w| 逐次放大 -> 发散;eta 过小则收敛极慢')
复盘实验 1:同一个函数、同一个起点,只有 lr 不同¶
上图三幅子图对应 $f(x)=x^2$(即 $a=2$)上 $x_0=2$ 出发的三种学习率:
- $\eta=0.5$(一步到位):满足 $\eta a=1$,$x_1=0$ 直接落在谷底,说明「最优步长」确实存在且可解析;
- $\eta=1.1$(发散):$\eta a=2.2>2$,等比因子模长 1.2,6 步内振幅 $|x|$ 从 2.0 涨到约 1.0 且不减反增——按 $-1.2$ 倍继续放大,十几步就会冲破画幅,这正是训练时
loss=nan的幕后元凶; - $\eta=0.05$(过小):每步只衰减 10%,30 步后还在 $x\approx0.085$,收敛速度肉眼可见地慢。
对一般强凸二次型,安全区间约为 $\eta<2/\lambda_{\max}$,经验最优值约 $2/(\lambda_{\min}+\lambda_{\max})$。工程铁律:一旦 loss=nan,第一反应是把学习率除以 10 重试,而不是先怀疑模型写错。
小练习:自己算一遍,胜过读十遍¶
拿纸笔完成三个小演算(答案在文末自查题附近):
- $f(x)=\tfrac12\cdot3\,x^2$,$x_0=1$:求 $\eta=1/3$ 时 $x_1,x_2$;再求 $\eta=0.7$ 时 $x_1,x_2,x_3$(应出现振荡但收敛);
- $f(w)=w_1^2+16w_2^2$:条件数 $\kappa$ 是多少?若 $\eta=0.1$,$w_0=(1,0.5)$ 时 $w_2$ 第一步会怎么变?会不会一步就「过冲」到对面?
- 上题改用 $\eta=0.05$:写出两维各自的缩放因子 $|1-\eta\lambda_i|$,判断哪个方向是收敛瓶颈。
提示:第 2 题答案 $\kappa=16$($A=\mathrm{diag}(2,32)$),$w_2$ 第一步从 0.5 冲到 $-1.1$;第 3 题缩放因子分别是 $0.9$ 与 $0.6$——$w_1$ 方向是瓶颈。这三题直接对应本节三个知识点:一步到位条件、发散/过冲判据、条件数主导收敛。
收敛速度三档:线性、亚线性、超线性¶
衡量迭代法质量的核心指标是误差每步缩小的方式。设 $e_t=f(w_t)-f^*$:
- 线性收敛:$e_{t+1}\le q\,e_t$($0<q<1$),误差按等比级数衰减。SGD 在强凸问题上就是这种——衰减因子 $q\approx1-1/\kappa$,$\kappa$ 越大 $q$ 越接近 1、收敛越慢;
- 亚线性收敛:$e_t\le C/t^p$。出现在仅凸(非强凸)或随机噪声主导的情形——SGD 后期常退化为 $O(1/t)$,所以 loss 的「尾巴」拖得很长;
- 超线性收敛:$e_{t+1}\le C\,e_t^r$($r>1$),误差按平方级收缩。牛顿法接近最优时是二次收敛($r=2$),代价是要算 $\nabla^2 f$。
实用判读:把 loss 画在对数坐标上——直线段=线性收敛,曲线逐渐走平=亚线性,骤然下坠=超线性。深度学习训练曲线的尾巴几乎总是亚线性的,这是 mini-batch 噪声的功劳,也是 05 篇学习率调度要应对的物理现实。
§1.4 收敛速度 $O((1-\kappa^{-1})^t)$ 是怎么来的¶
用强凸二次型 $f(w)=\tfrac12 w^{\mathsf T}Aw$($A$ 对称正定,特征值 $\lambda_1\le\cdots\le\lambda_n$)看最清楚。梯度下降 $w_{t+1}=(I-\eta A)w_t$ 在特征基下逐分量独立:把 $w_0$ 按特征向量分解 $w_0=\sum_i c_i u_i$,则 $$w_t=\sum_i c_i(1-\eta\lambda_i)^t u_i.$$ 取最优步长 $\eta=\frac{2}{\lambda_{\min}+\lambda_{\max}}$ 时,最慢分量的衰减因子为 $$\rho=\max_i|1-\eta\lambda_i|=\frac{\kappa-1}{\kappa+1},\qquad \kappa=\frac{\lambda_{\max}}{\lambda_{\min}}.$$ 于是 $f(w_t)-f^*\le\rho^{2t}(f(w_0)-f^*)$。注意 $\rho^2=\left(\frac{\kappa-1}{\kappa+1}\right)^2\approx 1-\frac{4}{\kappa}\ (\kappa\gg1)$,写成 $O((1-1/\kappa)^t)$ 就是这个道理。
代入数字感受量级:$\kappa=10$ 时每步误差降到约 0.67,约 30 步压到 $10^{-5}$;$\kappa=10^6$ 时每步只降到 $1-4\times10^{-6}$,要百万步量级。「病态曲率」不是玄学:峡谷地形就是 $\kappa$ 极大,SGD 在其中步履维艰正是本节公式的直接推论,也是下篇动量的用武之地。
§1.5 Mini-batch 的噪声为什么「可控」¶
记全体梯度 $g=\frac1N\sum_i g_i$,mini-batch 梯度 $\hat g=\frac1B\sum_{i\in\mathcal B}g_i$。取期望: $$\mathbb E[\hat g]=\frac1B\sum_{i\in\mathcal B}\mathbb E[g_i]=g.$$ 所以 mini-batch 梯度是真实梯度的无偏估计,方向上不会系统跑偏。噪声体现在方差:独立采样假设下(带有限总体修正) $$\operatorname{Var}[\hat g]=\frac{1}{B}\operatorname{Var}[g_i]\cdot\frac{N-B}{N-1}.$$ 方差随 $B$ 反比下降——这是「大 batch 更稳」的数学根源。但每 epoch 只能更新 $N/B$ 次,小 batch 用「更多次、更吵的更新」换来了凸问题上往往更快的整体收敛。
换个角度看:噪声不是 bug 而是特性。它天然带一点随机探索,且不会让优化器死粘在一条刚硬的轨迹上,在非凸曲面上甚至能帮忙逃出小陷阱。下一篇会看到,动量的角色之一正是「滤掉噪声、保留趋势」。
epoch / batch / iteration 与「通量」视角¶
三个术语先对齐:iteration = 一次参数更新;batch size $B$ = 一次更新用的样本数;epoch = 完整过一遍训练集(共 $N/B$ 次更新)。把「收敛速度」换算成成本,必须引入通量视角:
- 固定 epoch 数时,BGD 只看了 $N$ 条样本、只更新 1 次;$B=16$ 的 mini-batch 看同样 $N$ 条样本却更新 $N/16$ 次——「每读到一条样本带来的信息增益」上,小 batch 反而更高;
- 代价是方差:$B$ 越小梯度越吵(§1.5 方差公式)。于是存在一个「噪声-通量」最优区间,经验上 $B\in[32,512]$;
- 并行扩展:固定墙钟预算下,大 batch 靠吞吐、小 batch 靠更新频率;用更大的 lr 补偿大 batch 的低通量(线性缩放律)是现代分布式训练的标准玩法。
一句话:优化器的收敛是数学问题,训练的收敛是通量问题——两者常被混为一谈,面试时分开说会显得很稳。
# ---------- 实验 2:BGD / SGD / Mini-batch 的噪声来源 ----------
rng = np.random.default_rng(42)
N, D = 200, 2
X = rng.normal(size=(N, D)); X[:, 0] = 1.0  # 带偏置
w_true = np.array([0.5, -1.2])
y = X @ w_true + rng.normal(scale=0.3, size=N)

def loss_grad(w, idx):  # 在 idx 子集上算平均梯度
    r = X[idx] @ w - y[idx]
    return X[idx].T @ r / len(idx)

def train(mode, epochs=60, batch=16, lr=0.2):
    w = np.zeros(D); hist = [w.copy()]
    for e in range(epochs):
        if mode == 'BGD':
            g = loss_grad(w, np.arange(N))
        elif mode == 'SGD':
            g = loss_grad(w, np.array([rng.integers(N)]))
        else:
            idx = rng.integers(N, size=batch)
            g = loss_grad(w, idx)
        w = w - lr * g
        hist.append(w.copy())
    return np.array(hist)

fig, ax = plt.subplots(figsize=(7.5, 4.2))
for mode, col in [('BGD', '#4C72B0'), ('Mini-batch', '#55A868'), ('SGD', '#C44E52')]:
    hist = train(mode)
    dist = np.linalg.norm(hist - w_true, axis=1)
    ax.plot(dist, label=f'{mode}(每步 1 次小梯度)', color=col, lw=1.4)
ax.set_xlabel('epoch'); ax.set_ylabel('||w - w*||')
ax.set_title('三种梯度估计的收敛轨迹(同数据同初始,仅梯度估计方式不同)', fontsize=11)
ax.legend(fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
print('BGD 平滑单调;Mini-batch 有小噪声但快;SGD(单样本)噪声最大')
复盘实验 2:三条曲线的读法¶
上图横轴是 epoch(完整过一遍数据),纵轴是 $\|w-w^*\|$(到最优解的距离),三种模式共享同一数据与初始点:
- BGD(蓝):平滑单调、确定性下降,代价是每 epoch 只有 1 次更新且要算全量梯度;
- Mini-batch(绿,$B=16$):曲线带小毛刺但整体下滑最快,前几轮就逼近最优;
- SGD(红,$B=1$):毛刺最大、残差最大,但每次更新的计算量也最小——如果横轴换成「读过的样本数」,它往往反超。
这是工程上最早要权衡的矛盾:稳定性(大 batch)vs 更新频率(小 batch)。深度学习惯用 $B\in[32,512]$,既保持无偏、又不让方差失控。
图 1(Wikimedia Commons,CC0) 是一段梯度下降动画:点从曲面(等高线图)的外侧出发,沿负梯度方向一步步「走下」曲面,越接近中心、等高线越密,每一步的落点也越贴合地形。它直观回答了一个常见疑问:为什么梯度下降不走一条直线直达谷底? 因为「当前点的最速方向」随位置不断改变,路线只能是一条折线。建议把图 1 与实验 1 的三幅子图对照:一个看连续动画、一个看离散迭代,本质是同一件事。
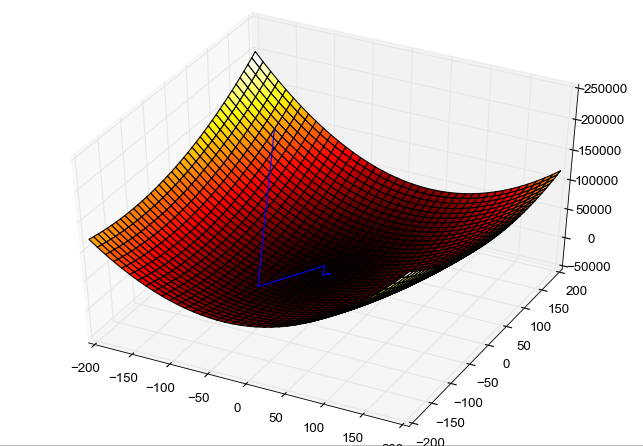
图 2(Wikimedia Commons,CC0) 是一维视角的梯度下降示意:曲线上标出一串迭代点,每个点沿该处的下降方向滑下一段,再在落点重复。注意步长 $\eta$ 是固定的水平距离,而曲线上实际滑过的斜距取决于当地坡度——坡度越陡,同样的水平步长在纵轴上走得越多。这与实验 2 的 BGD 曲线呼应:每个迭代点都精确落在函数曲线上,是「确定性梯度」的写照;mini-batch 则相当于给每步方向附加一个小扰动,轨迹因此带毛刺。
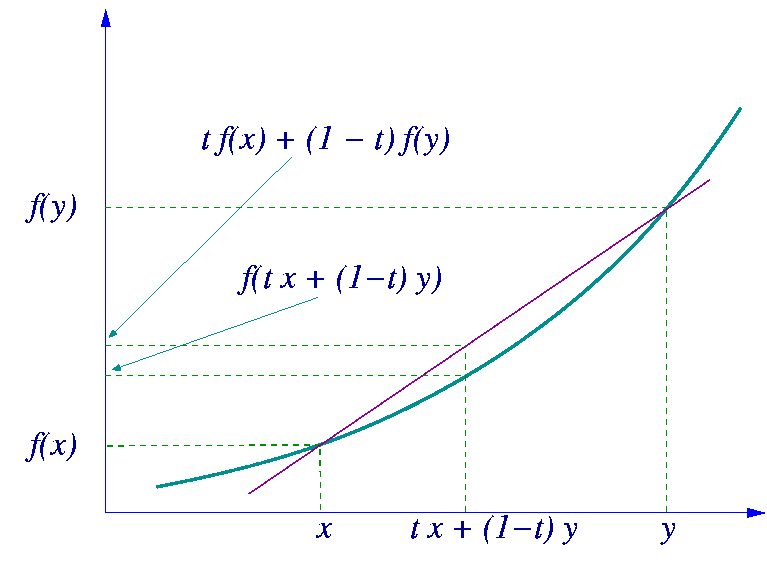
图 3(Wikimedia Commons,CC0) 展示凸函数的几何定义:曲线上任意两点的连线都位于图像上方,即 $$f(\theta x+(1-\theta)y)\le\theta f(x)+(1-\theta)f(y),\qquad\theta\in[0,1].$$ 对凸函数,任何局部极小都是全局极小,因此本章的收敛结论可以放心使用;神经网络是非凸的,定理不能直接套用,但「碗状 vs 波浪状」的直觉依然成立——波浪里每个谷底都是一个局部极小,优化器可能停在任何一个里。
§1.6 凸、强凸、条件数:把「收敛保证」说清楚¶
三者的关系是递进的:
- 凸:一阶条件 $f(y)\ge f(x)+\nabla f(x)^{\mathsf T}(y-x)$ 或图上连线在图像上方。保证局部=全局,但没有速率保证(如 $f(x)=|x|$ 一类函数收敛可能慢到亚线性);
- 强凸:$f(y)\ge f(x)+\nabla f(x)^{\mathsf T}(y-x)+\tfrac{\mu}{2}\|y-x\|^2$,碗底至少像 $\tfrac{\mu}{2}\|\cdot\|^2$ 一样向上翘。它带来线性收敛——误差每步乘以一个 $<1$ 的常数;
- 条件数 $\kappa=\lambda_{\max}/\lambda_{\min}$:刻画碗的椭圆程度。$\kappa=1$ 是正圆,任意方向一步收敛;$\kappa$ 越大,沿陡方向易过冲、沿缓方向几乎不动(想想 $f=w_1^2+100w_2^2$ 的形状)。
深度学习里这些定理虽不能直接套用,却解释了一切调参现象的骨架:为什么归一化让训练更快(等价于把 $\kappa$ 从 $10^4$ 压向 $10^1$)、为什么动量能救峡谷(02 篇的核心)。
§1.7 初始点、非凸曲面与「对称破缺」¶
迭代法还需要一个初始点 $w_0$。在非凸问题上,初始点直接决定落进哪个局部极小:
- 对称破缺:两个相同权重的神经元若初始完全一样,梯度也永远一样(对称性不破缺),它们会学到同一件事——所以必须随机初始化;
- 尺度敏感:初始值太大,早期梯度饱和;太小,信号传不进深层——于是有 Xavier / He 等按层宽 $\sqrt{1/n_{\text{in}}}$ 量级缩放的初始化;
- 高维的另一番风景:高维非凸空间中,鞍点($\nabla f=0$ 但既非极小也非极大)远比局部极小常见,SGD 恰好因噪声而容易「滑过」鞍点——这是后面「动量穿鞍」话题的伏笔。
收敛性定理负责「从好起点如何到好终点」,初始化负责「产生好起点」,两者缺一不可。
梯度下降的适用边界:什么情况它不灵¶
任何方法都有边界,梯度下降的软肋是:
- 不可微:$f$ 带尖点(如 $|x|$)、ReLU 拐点、L1 项时梯度不存在或分段恒定——需要次梯度、近端梯度(proximal)等专门方法;
- 约束:$w$ 必须待在可行域内($\|w\|\le C$、整数约束等)时,无约束下降会「越界」——需要投影梯度或拉格朗日法(13 篇 KKT 会系统讲);
- 极度非凸 / 多模态:梯度下降只能保证到达最近的局部极小——全局搜索要靠随机重启、模拟退火、遗传算法(10–12 篇);
- 病态 + 小样本:$\kappa$ 巨大且数据量小时,一阶方法的收敛时间不可接受——此时二阶/拟牛顿(L-BFGS)更合适。
判断一个优化问题「值不值得用梯度下降」的顺序:可微?凸/近似凸?有约束?规模多大?——四问之后答案自然浮现。
公式与直觉(背诵)¶
- 更新:$w \gets w - \eta g$,$g = \nabla_w \mathcal{L}$
- 一阶必要条件:局部极小处 $\nabla f = 0$(凸函数时即全局)
- 凸函数:$f(\theta x + (1-\theta)y) \le \theta f(x) + (1-\theta)f(y)$ → 梯度下降保证收敛
- 收敛速度(强凸):$f(w_t)-f^* \le O((1-\kappa^{-1})^t)$,条件数 $\kappa=\lambda_{max}/\lambda_{min}$ 越大越慢
- 为什么 mini-batch:期望等于全梯度(无偏估计),方差随 batch 反比下降,单样本噪声大但算得快
§3 常见 bug 与边界¶
- lr 与特征尺度不匹配:特征未归一化时,不同维度的梯度差几个数量级,一个 lr 顾此失彼 → 先标准化
- lr 过大立即 NaN:检查第一步 loss 是否为 inf
- 忘记梯度清零:手写时每次迭代
g = grad(w)而不是g += grad(w) - 停止条件:
||g|| < tol或 loss 相对下降 < tol,不要只看绝对 loss
§4 面试追问与扩展¶
- 学习率怎么选:先 0.01/0.001/0.1 三档粗扫,再观察 loss 曲线(震荡→降 lr;太缓→升)
- 凸 vs 非凸:神经网络非凸,收敛保证不适用;但局部极小通常足够好(高维时鞍点比局部极小更常见)
- 为什么有时 loss 曲线毛刺:mini-batch 噪声 → 用指数滑动平均平滑后观察趋势
- 梯度下降与牛顿法关系:牛顿法 = 梯度下降在「以 H 为度量的内积空间」里的最速下降(见 06 篇)
§5 自测清单¶
- 手写 SGD 并在 $f=0.5x^2$ 上验证「$\eta=1/a$ 一步到位」
- 解释 lr 过大的发散机制($|w_{t+1}| = |1-\eta a||w_t| > |w_t|$)
- 说明 BGD / SGD / Mini-batch 的噪声-速度权衡
- 默写强凸收敛速率 $O((1-\kappa^{-1})^t)$ 并说明条件数含义
- 能回答「loss 曲线震荡怎么办」
💡 下节预告:峡谷地形 + 历史动量(02 篇),自适应步长(03 篇)。
面试四连问(附参考答案)¶
- 为什么不直接解 $\nabla f=0$? 高维非线性无解析解;解析计算常要 $O(n^3)$ 量级操作,迭代只要 $O(n)$/步;且数据在变、解是移动靶(详见 §1.1)。
- 学习率从多少开始试? 在 0.001~0.1 的对数区间粗扫;更激进的做法是「lr 扫描」:lr 按指数增长跑几百步,画 loss-lr 曲线,取最低点左侧一档。
- loss 震荡但整体下降,怎么办? 先确认不是发散(趋势向上或
nan):加 batch、降 lr、或只看 EMA 平滑曲线;若尾部落不下去,多半进入亚线性阶段,需要衰减调度(05 篇)。 - 为什么说「最速下降」不一定最快? 「最速」只在当前点、无穷小步长、欧氏内积下成立;真实有限步长下锯齿路径让它在病态问题上效率低下,动量与二阶方向因此更优。
这四题覆盖「动机—实践—诊断—理论」四层,是面试官最常打的组合拳。
§1.8 收束:SGD 的三个短板与后文的解药¶
| 短板 | 典型现象 | 对策(详见篇目) |
|---|---|---|
| 病态曲率震荡 | 峡谷地形沿壁来回摆 | 动量族(02 篇) |
| 一刀切学习率 | 稀疏/陡峭参数互相拖累 | AdaGrad/RMSProp/Adam(03、04 篇) |
| 收敛尾声摆荡 | 固定 lr 无法精细落底 | 学习率调度(05 篇) |
| 只用一阶信息 | 对曲率不敏感 | 二阶方法(06 篇) |
一句话记忆:SGD 只回答了「往哪走」,没回答「走多远、要不要看路况」。动量看历史路况,自适应看当前路况,二阶方法看地形的曲率。
方法的全景图:一张 2×2 表看懂所有优化器¶
把「梯度是否带噪声」与「用了多少阶信息」两个维度交叉,所有主流优化器都能对号入座:
| 确定性梯度(全量) | 随机梯度(mini-batch) | |
|---|---|---|
| 一阶 | BGD、普通下降 | SGD,及其动量 / NAG / 自适应变体 |
| 二阶 | 牛顿法($H^{-1}g$) | 对角近似(AdaHessian 等) |
读这张表的三个要点:
- 深度学习默认落在「随机×一阶」格——既有噪声正则效应,又有 $O(n)$ 廉价更新;
- 二阶方法在「确定性」格才有完整理论——$H$ 的估计在 mini-batch 下噪声被放大;
- 后续篇章全部是「随机×一阶」格里的精装修:动量修方向、自适应修步长、调度修时间表。
面试时先画出这张表再展开,能干净利落地回答「优化器之间到底是什么关系」这类开放题。
§1.9 易错点与面试追问(进阶)¶
- lr 与特征尺度:$f=x_1^2+100x_2^2$ 上 $x_2$ 方向梯度大 100 倍,一个 lr 要么让 $x_2$ 发散、要么让 $x_1$ 蜗牛爬。解法:先标准化特征,或后续的逐参数自适应步长——这是面试「为什么必须归一化」的标准答案;
- warmup 与动量的相互作用:训练初期动量状态 $v$ 还是 0、梯度方差又大,直接上大 lr 会把 $v$ 在头几轮灌爆。warmup 不只是调 lr,更要考虑动量对早期噪声的放大(05 篇展开);
- 停止条件:不要只看绝对 loss——1.0 对百万参数可能是优秀模型,对十几个参数可能还很差。看相对下降或梯度范数 $\|g\|<\text{tol}$;
- 「梯度下降=最速下降」的迷思:只在「当前点、无穷小步长、欧氏度量」下成立。换成 $H$ 加权的度量,最速方向就变成牛顿方向(06 篇)。
数值稳定性:NaN / Inf 的完整排查表¶
训练崩溃九成是数值问题,按出现位置排查:
- 第一步就 NaN:lr 过大($\eta a>2$ 的多元版)或数据含 Inf/NaN——先查数据清洗,再 lr$\div10$;
- 中途突然 NaN:局部梯度爆炸(深层网络常见)——加梯度裁剪,或检查某层权重初始化是否过大;
- loss 是 NaN 但梯度检查正常:可能 log 了非正数(交叉熵前漏 clip)、或除了恰好为 0 的项——用
np.errstate定位第一个 NaN 的来源; - 收敛但 loss 波动极大:fp16 下求和顺序导致的舍入——关键累加用 float32/64 master copy。
排查工具:np.isnan(x).any() 逐层检查 weights/grads;PyTorch 可用 torch.autograd.detect_anomaly。记住:NaN 是症状不是病灶,定位「第一个出现 NaN 的张量」比反复调参高效得多。
学习率选择:一套可复制的三步法¶
- 粗扫:在 $\{0.1,0.01,0.001\}$(必要时补 0.3、0.03)里各跑几百步,看 loss 是否下降、是否
nan,划掉发散的档位; - 判读 loss 曲线:震荡剧烈→降 lr(或加 batch);几乎不动→升 lr;先降后弹→lr 偏大;平滑单调但太慢→lr 偏小;
- 精修:在粗扫最优值附近做 $\times3$、$\div3$ 的微调,记录时用 log 空间(0.01→0.003→0.001)而非线性等距。
一个实用小技巧:画 loss 的指数滑动平均曲线再判读,能滤掉 mini-batch 毛刺、看清真实趋势(这其实就是在用「动量」的思路看训练曲线,与 02 篇一脉相承)。另外,学习率与 batch size 常按线性缩放律联动:batch 翻倍、lr 大致也翻倍,可以显著节省调参轮次——注意这只在 batch 与 lr 同向缩放、且超参范围合理时成立。
本节小结:一条因果链记住 §1¶
解析解不可得 → 迭代法 $w\gets w-\eta g$ → 步长三态(一步到位 / 发散 / 蜗牛爬)→ 强凸保证 $O((1-1/\kappa)^t)$ → mini-batch 无偏但有方差 → 方差与 $B$ 反比 → 病态曲率($\kappa$ 大)与梯度噪声是 SGD 的两大敌人。
自测三连问:① 为什么 $\eta a>2$ 发散而 $1<\eta a<2$ 只振荡不发散?② 条件数 10 与 1000 各约需多少步让误差降 5 个数量级?(提示:$\kappa=10$ 约 30 步,$\kappa=1000$ 约 3000 步)③ SGD 的噪声来自估计偏差还是方差?——答不出来就回头翻 §1.3–§1.5。
§1.10 延伸阅读与知识图谱¶
- 经典教材:Boyd & Vandenberghe《Convex Optimization》第 9 章(最速下降与收敛性分析);Goodfellow《Deep Learning》第 8 章(深度学习优化实践);
- 原始论文:Robbins & Monro (1951)《A stochastic approximation method》,随机梯度方法的奠基之作;
- 图谱:本页 SGD → 02 动量/NAG → 03 自适应步长 → 04 Adam 变体 → 05 学习率调度 → 06 二阶方法 → 07 大模型训练实践;
- 自查题:$\kappa=100$ 的病态二次型上,SGD 的理论误差每步约乘 $1-4/\kappa=0.96$,估算把误差压到 $10^{-5}$ 需要多少步?(提示:$0.96^t\approx e^{-t/25}$,答案约 300 步量级——这正是 02 篇要攻克的数字。)