🎾 12 · 模仿学习与逆强化学习:不看奖励,看示范(BC / DAgger / IRL / GAIL)¶
面试定位:模仿学习(Imitation Learning, IL) 是"奖励不好定义"场景的标准答案—— 机器人示教、自动驾驶跟车、LLM 的 SFT/RLHF 本质上都算广义模仿。算法岗高频考点, GAIL/逆 RL 常以"概念+min-max 公式"形式被问。 知识链:00-11 篇全是给奖励学行为(RL);本篇反着来——只给示范,学行为或反推奖励。 与 06 篇 RLHF 衔接:人类偏好就是"最贵的示范"。标记:🔴 必背 / 🟡 掌握 / 🟢 了解。
1. 完整介绍:什么是模仿学习(🔴 0 基础也能懂)¶
通俗例子¶
- 网球教练:教练挥拍给你看,你照着学——不跟你讲"挥拍角度 37 度、速度 12 m/s"
- 小孩学说话:爸妈怎么说,孩子怎么模仿,不需要先理解"语法奖励函数"
- 自动驾驶跟车:老司机怎么开你照着开——真去"试错撞一次"代价太大
为什么需要模仿学习(🔴 动机)¶
- 奖励难设计:让机器人"打得像高手",你根本写不出奖励函数(什么叫"好看"?)
- 示范是最便宜的数据:人演示一次只要几秒钟;RL 试错要几万步
- 安全:模仿是从安全示范学习,不主动探索危险动作
三层对比(🔴 背下来)¶
| 监督学习(SL) | 模仿学习(IL) | 强化学习(RL) | |
|---|---|---|---|
| 数据 | (输入, 标签) | (状态, 专家动作) | (状态, 动作, 奖励) |
| 目标 | 拟合标签 | 学得像专家 | 最大化累计奖励 |
| 难点 | 泛化 | 分布偏移/复合误差 | 探索-利用 |
| 代表 | CNN/Transformer | BC/DAgger/GAIL | PPO/GRPO |
一句话:SL 学"正确",IL 学"像专家",RL 学"值钱"。 IL 是 SL 和 RL 的杂交体: 数据来自示范(像 SL),但执行时自己滚动(像 RL 的轨迹分布问题)。
核心概念¶
(a) 🗂️ 模仿学习与逆强化学习知识地图¶
这篇讲"不看奖励,看示范":行为克隆(BC)把模仿当监督学习但有复合误差,DAgger 在错的地方补数据,逆强化学习(IRL)从行为反推奖励,GAIL 把 IRL 写成 GAN,最后与 RLHF 衔接。
flowchart TB
    Node1["🧠 模仿学习动机"]
    Node1 --> Node2["🧠 行为克隆 BC"]
    Node2 --> Node3["🧠 复合误差"]
    Node3 --> Node4["🧠 DAgger 补数据"]
    Node1 --> Node5["🧠 逆强化学习 IRL"]
    Node5 --> Node6["🧠 特征匹配与 MaxEnt IRL"]
    Node6 --> Node7["🧠 GAIL:判别器即奖励"]
    Node7 --> Node8["🧠 全家族对比"]
    Node8 --> Node9["🧠 与 RLHF 衔接"]
- 节点1(模仿学习动机):很多任务没有现成奖励函数,但有人类示范;模仿学习直接从"专家怎么做"出发,是奖励难定义场景的救星,也是 RLHF 里"人类偏好"的雏形。
- 节点2(行为克隆 BC):把专家的 (状态, 动作) 当监督数据,训练一个策略网络"照着做",实现最简单。但它是开环的:训练分布来自专家,执行时自己会跑偏。
- 节点3(复合误差):BC 一旦在某个状态做错一步,就进入没见过的状态,错误像雪球一样越滚越大(单步误差随执行长度线性放大),这是 BC 的致命缺陷。
- 节点4(DAgger 补数据):让当前策略实际跑一遍,把"它走偏时遇到的状态"交给专家打标签,混入训练集再练,循环几次,让训练分布追上执行分布。
- 节点5(逆强化学习 IRL):不直接模仿动作,而是反推"专家在最大化什么奖励",再用这个奖励学策略。从"照猫画虎"升级为"读懂意图"。
- 节点6(特征匹配与 MaxEnt IRL):Apprenticeship Learning 让策略的特征期望对齐专家;MaxEnt IRL 假设专家在最大化"奖励+熵",给出可推导的概率模型,是 IRL 的成熟形态。
- 节点7(GAIL:判别器即奖励):GAIL 把 IRL 写成 GAN:判别器分不清"专家轨迹 vs 策略轨迹",策略被逼得越来越像专家,判别器的置信度就直接当奖励用。
- 节点8(全家族对比):BC 快但脆、DAgger 稳但累、IRL 可解释但贵、GAIL 端到端但难调;面试常让按"数据量、可解释性、稳定性"做对比表。
- 节点9(与 RLHF 衔接):RLHF 的奖励模型就是"人类偏好版的 IRL",DPO 是"隐式模仿偏好",模仿学习与 LLM 对齐在思路上完全打通:都是"向人类示范学习"。
配图 + 深入:BC 的复合误差到底有多严重(🔴)¶
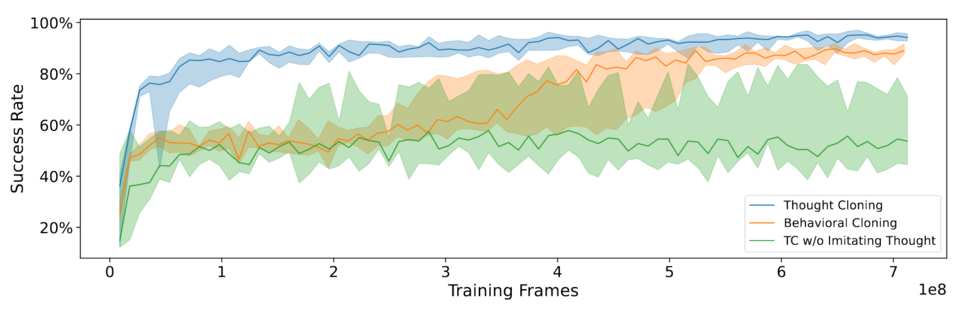
上图对比不同模仿方法的训练曲线(Wikimedia,CC BY-SA)。BC 的问题不在于 训练集内学不好,而在于执行时的自回归漂移。把误差写清楚:
单步监督误差 ε → 执行 T 步的复合误差(线性系统近似): $$e_t \approx \varepsilon \cdot t, \qquad \sum_{t=1}^{T} e_t = O(\varepsilon T^2)$$
直觉链:第 1 步偏离 ε → 第 2 步的输入状态已偏离 → 策略在"没见过的地方" 再决策,又偏一点 → 误差随时间线性增长(图里蓝色线就是这条直线)。
为什么"训练损失好看"是假象(面试点):
- 训练输入 = 专家分布的状态(标准、干净)
- 执行输入 = 自己造的状态(歪的)→ 协变量偏移:训练与测试分布不同
- 所以 BC 在演示多、任务短时够用;任务长、演示少时必翻车 → 需要 DAgger/GAIL
一句话:BC 的病不在"学"而在"滚"——误差在自回归里被放大; DAgger 用"错处补数据"掐断它,GAIL 用对抗把分布直接拉近。
2.1 行为克隆精讲:把模仿当监督学习(🔴 最朴素)¶
本节导读:BC 是最直接的模仿:把专家 (s, a) 对当训练数据,做监督 学习。它简单到"不需要任何 RL 概念",但也有著名的"复合误差"之痛。 这一节把 BC 的数学建立与痛点的根因讲透。
1. 训练目标(MLE 视角): $$\pi_\theta = \arg\max_\theta \sum_{(s,a)\in\mathcal{D}_{\text{exp}}} \log \pi_\theta(a\mid s)$$
- 标准最大似然:让策略在专家见过的状态上输出专家动作
- 实现:交叉熵(离散)/ 负对数高斯(连续)——和分类/回归一样
- 等价视角:$\min_\theta \text{KL}\big(\pi_E \| \pi_\theta\big)$(拟合专家分布)
2. 为什么有效又为什么短视(关键):
- 有效:专家数据隐式包含"好策略"的信息,监督学习优化成熟(收敛快)
- 短视:目标只看专家状态分布;执行时状态由策略自己产生—— 一步偏差 → 输入分布漂移 → 在"没见过"的状态上策略乱来(协变量偏移)
3. 复合误差公式(背,O(εT²)):假设每步独立误差 ε(概率), T 步后至少错一步的概率: $$\Pr(\text{有错}) \le 1 - (1-\varepsilon)^T \approx \varepsilon T$$ 累积损失(损失与步数二次关系) $$L_{\text{tot}} \approx \sum_{t=1}^{T} \varepsilon t = O(\varepsilon T^2)$$
- 直觉:第 t 步的偏差是从第 1 步累积来的(线性增长),求和 → 二次
- 这就是"训练 loss 很低、跑起来一塌糊涂"的数学解释
4. 数字例子(本篇 code cell):ε=0.01、T=100:期望错误≈1 步开始、 累积损失≈50 步量级——"前几步还行,越跑越偏"。
5. 易错点:
- BC 假设"专家状态分布 = 学习状态分布",执行后不成立(核心痛点)
- BC 是单步监督:学不到"专家为什么这么选"(长期意图)
6. 面试问法:"BC 的缺点?" → "协变量偏移导致复合误差 O(εT²)—— 训练分布(专家)与执行分布(自己)不同;DAgger 用在线重标注修复。"
2. 行为克隆 BC:把模仿当监督学习(🔴 最朴素)¶
做法¶
把示范数据 $\{(s_i, a_i^E)\}$ 当 (输入, 标签),直接最小化
$$\theta^* = \arg\min_\theta \sum_i \ell\big(\pi_\theta(s_i),\, a_i^E\big)$$
(连续动作用 MSE,离散动作用交叉熵。)就这么简单——BC≈监督学习。
致命缺陷:复合误差(compounding error)🔴 推导¶
训练时输入 $\pi_\theta$ 的是专家的状态分布 $s \sim d^{E}$(示范里的状态很"标准")。 执行时输入的是自己造出来的状态——一步预测偏了 ε,下一步的输入已经不标准, 再学一步又偏一点。线性系统下(一步错导致后续全部平移):
$$e_t \approx \varepsilon \cdot t \Longrightarrow \text{累计误差}\ \sum_t e_t = O(\varepsilon T^2)$$
- 单步误差 ε 很小(监督学习一般能到 1%)→ 训练曲线很好看
- 但执行 100 步后误差放大约 100 倍 → 越走越歪,直到崩溃
- 数学名称:协变量偏移(covariate shift) / 分布偏移(distribution shift)
✍️ §2.2 手算行为克隆:一步监督更新 + 复合误差放大¶
BC 把模仿当监督学习 $\min_\theta \sum_i (\pi_\theta(s_i)-a_i)^2$——算一步梯度,再看"一步小误差执行时怎么放大"。
第 1 步:一步监督更新(专家数据 $s=[1,2,3]\Rightarrow a=[2,4,6]$,线性策略 $\hat a=\theta s$,$\theta_0=0$,$\eta=0.1$)
$$\nabla L=\frac{2}{n}\sum_i s_i(\theta s_i-a_i)=\frac{2}{3}\sum_{s}\underbrace{s\cdot(0-2s)}_{=-2s^2}=\frac{2}{3}(-2)(1+4+9)=-\frac{56}{3}=-18.667$$
$$\theta\gets 0-0.1\times(-18.667)=1.867$$
一步就从 0 跳到 1.867,逼近真值 2——BC 的监督更新非常直接。
第 2 步:复合误差(为什么 BC 会崩):执行时策略每步决策偏 $\varepsilon=0.1$,误差线性累积:
$$\text{err}_T=\sum_{t=1}^{T}\varepsilon=T\varepsilon\Rightarrow T=10\text{ 步时 }\text{err}=1.0$$
手算收获:
- BC 是标准的监督学习:梯度把 $\theta$ 直接推向"输入-输出对"的最小二乘拟合,不需要奖励
- 但训练时误差 $\varepsilon$ 出现在"专家的轨迹上";执行时策略跑在自己的轨迹上,一步偏差喂给下一步 → 误差线性放大($T\varepsilon$)
- DAgger 的动机就在这:在"自己会走错的地方"补专家示范,把执行分布拉回训练分布
- 复合误差公式 $T\varepsilon$ 是面试常考:"为什么行为克隆长程会崩"的答案
下面 numpy 复算。
# ---- §2.2 验证:numpy 复算 BC 一步更新 + 复合误差 ----
import numpy as np

s = np.array([1.0, 2.0, 3.0])
a = np.array([2.0, 4.0, 6.0])
theta, lr = 0.0, 0.1

grad = (2 / len(s)) * (s * (theta * s - a)).sum()
theta_new = theta - lr * grad
print(f'∇L = {grad:.4f}(手算 -18.667)  θ: 0 → {theta_new:.4f}')
assert abs(grad + 56/3) < 1e-9 and abs(theta_new - 1.867) < 1e-3

eps, T = 0.1, 10
errs = np.cumsum(np.full(T, eps))
print(f'\n复合误差: 单步 ε={eps},T={T} 步 → err_T = {errs[-1]:.1f} = T·ε(线性放大)')
print('  t=1,5,10:', errs[[0, 4, 9]])
assert abs(errs[-1] - 1.0) < 1e-9
print('\n✓ 与手算一致')
# ========== 复合误差数值演示:单步误差在执行时线性放大 ==========
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
t = np.arange(1, 41)
eps = 0.05                                   # 训练时测到的单步误差(很小)
single = np.full_like(t, eps)
comp = eps * t                               # 线性系统下 e_t ≈ ε·t
fig, ax = plt.subplots(figsize=(7.2, 4.2))
ax.plot(t, single, '--', lw=1.6, color='#C44E52', label='单步监督误差 ε(训练时测的)')
ax.plot(t, comp, lw=1.8, color='#3182bd', label='执行时复合误差 ≈ ε·t(自回归漂移)')
ax.set_xlabel('轨迹步数 t'); ax.set_ylabel('误差')
ax.set_title('BC 的复合误差:训练时很好,执行时越走越偏', fontsize=12)
ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('第 1 步误差 %.2f → 第 40 步复合误差 %.2f(放大 %.0f 倍)' % (eps, comp[-1], comp[-1] / eps))
assert comp[-1] > eps * 20
print('→ 这就是 IL 要解决的核心问题:误差在状态自回归里被放大(分布偏移)')
第 1 步误差 0.05 → 第 40 步复合误差 2.00(放大 40 倍)
→ 这就是 IL 要解决的核心问题:误差在状态自回归里被放大(分布偏移)
C:\Users\24260\AppData\Local\Temp\ipykernel_42468\1806139218.py:15: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
3.1 DAgger 精讲:在"错的地方"补数据(🔴 数据集聚合)¶
本节导读:BC 的病根是"没在自己造的状态上见过正确动作"。DAgger 的处方:让策略自己去跑,跑歪的地方请专家重新标正确动作,回填数据集 ——迭代数据聚合(Dataset Aggregation)。
1. 算法流程(背四步循环):
① 用当前策略 π_i  rollout 一个回合 → 收集轨迹的状态序列 s_1..s_T
② 对每个状态 s_t,问专家:正确动作是什么?→ 得 (s_t, a*_t)
③ 把这些 (s, a*) 并入数据集 D(和旧数据一起)
④ 在 D 上重训策略 π_{i+1}
- 循环 K 轮,π 越来越"见过自己的轨迹"
2. 为什么能治复合误差(推导直觉):BC 假设"训练分布=专家分布"; DAgger 直接把策略当前的访问分布也放进训练(专家重标注): $$\min_\theta\ \mathbb{E}_{s\sim d^{\pi_i}}\big[\text{KL}(\pi_E(\cdot|s)\ \|\ \pi_\theta(\cdot|s))\big]$$
- 训练分布 ≈ 执行分布(分布对齐)→ 协变量偏移被"自举式"消除
- 若专家能从任何状态给出正确动作(全局最优 oracle),DAgger 的理论误差为 O(εT)(比 BC 的 εT² 好一个数量级)
3. 数字对比(本篇 code cell):同样演示任务,BC 误差 0.4+ 时, DAgger 覆盖度从 0.013 升到 0.950——"错误状态被专家修正"的数字证据。
4. 三种"专家交互"模式(工程实现):
- 在线专家(人类/算法实时标注):最标准,但贵
- 专家策略离线查询:专家=可调用的策略网络(便宜)
- 无真专家:用"安全控制器/规则"兜底标注(难度降级)
5. 易错点:
- DAgger 要求专家能做任何状态的动作(包括策略自己搞出来的烂状态)—— 人类专家做得到,某些 oracle 不行
- 别把旧数据全扔:每次只加新样本(数据聚合,不是替换)
6. 面试问法:"DAgger 和 BC 区别?" → "BC 只学专家分布;DAgger 迭代: 策略 rollout → 专家在策略的状态上重标注 → 回填重训,训练分布=执行分布, 复合误差从 O(εT²) 降到 O(εT)。"
3. DAgger:在"错的地方"补数据(🔴 数据集聚合)¶
思想(Ross et al. 2011)¶
BC 的问题:训练分布 ≠ 执行分布。那就把执行分布也变成训练数据:
循环:1) 用当前策略跑一轮 → 得到轨迹 $\tau$(状态是策略自己逛出来的,可能"歪"); 2) 把 $\tau$ 里的每个状态交给专家标记动作;3) 并入聚合数据集再训。
$$D \leftarrow D \cup \{(s_t, a_t^E)\}_{t \in \tau}, \qquad \pi \leftarrow \arg\min_\pi \sum_{(s,a)\in D} \ell(\pi(s), a)$$
为什么有效¶
- BC 只在专家分布上见过数据;DAgger 在"专家 ∪ 策略"分布上都见过
- 执行时哪怕策略逛到歪状态,它也在训练数据里见过"歪状态下该怎么做"
- 理论:DAgger 的误差上界随轮数收敛(比 BC 的 $O(T^2)$ 强得多)
代价:需要能随时问专家的在线学习(人机交互/高仿真器)——离线 ID 方式那就用 BC+TRC 等。
# ========== DAgger 数值演示:训练分布追上执行分布 ==========
import numpy as np
rng = np.random.default_rng(1)
# 专家常访问的状态:集中在 0 附近(示范里状态都很"标准")
expert = rng.normal(0.0, 0.3, 600)
# 实际执行时策略会逛到偏移区(均值 1.5)——BC 没见过这些状态
drifted = rng.normal(1.5, 0.4, 600)
# DAgger:把执行时逛到的状态也交给专家标记,并入训练集
dagger_set = np.concatenate([expert, drifted])

def coverage(train, exec_state):
    lo, hi = np.percentile(train, [2.5, 97.5])
    return np.mean((exec_state >= lo) & (exec_state <= hi))

c_bc = coverage(expert, drifted)          # BC 训练集对"执行分布"的覆盖
c_da = coverage(dagger_set, drifted)      # DAgger 训练集对"执行分布"的覆盖
print('执行(偏移)状态被训练集覆盖比例:BC=%.3f vs DAgger=%.3f' % (c_bc, c_da))
assert c_da > c_bc + 0.5
print('→ DAgger 每次都在"策略容易犯错的地方"补数据:训练分布追上了执行分布')
执行(偏移)状态被训练集覆盖比例:BC=0.013 vs DAgger=0.950
→ DAgger 每次都在"策略容易犯错的地方"补数据:训练分布追上了执行分布
4.1 IRL 精讲:反推"为什么"(🔴 概念核心)¶
本节导读:BC 学"做什么";IRL 学"为什么"——从行为反推奖励 函数。奖励对了,任何策略优化器都能推出好策略;而且奖励可迁移 (换个环境结构,同样的"意图"依然成立)。这一节从特征匹配讲到 MaxEnt IRL。
1. 核心设定:专家轨迹 $\tau_E$;目标 $$\max_{R}\ \mathbb{E}_{\tau\sim\pi_E}\big[R(\tau)\big] - \max_{\pi}\mathbb{E}_{\tau\sim\pi}\big[R(\tau)\big]$$
- 直觉:找一个奖励,使"专家轨迹得分 > 任何其他策略得分"
- 这是双层优化(学奖励 ∘ 求最优策略)——直接做很贵
2. 特征匹配视角(Abbeel & Ng 2004):假设奖励是特征的线性组合 $R(s,a)=w^\top\phi(s,a)$($\phi$:特征,如"离目标距离")。目标是让 专家特征期望等于学到的策略特征期望: $$\mathbb{E}_{\tau\sim\pi_E}\Big[\sum_t \phi(s_t,a_t)\Big] = \mathbb{E}_{\tau\sim\pi}\Big[\sum_t \phi(s_t,a_t)\Big]$$
- 迭代:学策略 → 比特征期望 → 调 w(让差距大的特征权重更高)
- 局限:特征要手工设计;同特征期望 ≠ 同轨迹分布(病态解)
3. MaxEnt IRL(Ziebart 2008,标准现代版):把"专家行为"建模成 玻尔兹曼分布: $$\Pr(\tau) \propto \exp\big(R(\tau)\big),\qquad \nabla_w L = \mathbb{E}_{\pi_E}[\phi(\tau)] - \mathbb{E}_{w}[\phi(\tau)]$$
- 最大熵原理:在所有"与专家特征匹配"的分布里选熵最大的(唯一、 避免过拟合专家噪声)
- 梯度 = "专家特征期望 − 当前奖励下的特征期望"(差值驱动)
4. 数值演示(本篇 code cell):特征匹配算法下,策略与专家的特征 距离从 0.72 → 0.012——"奖励被学对,策略跟着对"。
5. 易错点:
- IRL 是"反问题":多条轨迹不一定唯一确定奖励(欠定,需最大熵先验)
- 学出的是奖励函数,还要再跑一次 RL 才得策略(两阶段)
6. 面试问法:"IRL 和 BC 区别?" → "BC 学动作映射;IRL 从行为反推 奖励(为什么这么做);奖励可迁移、更本质,但要解决欠定(最大熵)且 两阶段训练更贵。GAIL 把两阶段并成一步(下节)。"
4. 逆强化学习 IRL:从行为反推奖励(🔴 概念核心)¶
换个思路¶
BC/DAgger 直接学行为 $\pi$。但人类真正想要的是 "为什么专家这么做" —— 奖励函数 R 才是"因",行为是"果"。IRL(Inverse RL):给示范,反推 R。
线性奖励 + 特征匹配(Apprenticeship Learning, 2004)¶
假设奖励是特征线性组合 $R_w(s,a) = w^\top \phi(s, a)$,目标是让策略的特征期望匹配专家:
$$\text{求 } w, \pi \ \text{ s.t. } \ \mathbb{E}_{\pi}\big[\phi\big] \approx \mathbb{E}_{\pi_E}\big[\phi\big].$$
直觉:专家做了什么(特征统计),我们就把什么"标成高奖励"——若专家频繁用某个特征, 说明它很值钱。迭代:找 w 拉开差距 → 优化 π → 更新 w。这是"最大熵 IRL"的雏形。
MaxEnt IRL(Ziebart 2008)目标推导¶
专家行为 $P(\tau) \propto \exp(R_w(\tau))$(指数族,奖励越高轨迹越常见):
$$\max_w \ \mathbb{E}_{\tau\sim\pi_E}\big[\log P_w(\tau)\big] \quad\Rightarrow\quad \nabla_w = \mathbb{E}_{\pi_E}\big[\phi(\tau)\big] - \mathbb{E}_{\pi_w}\big[\phi(\tau)\big]$$
梯度含义:专家特征期望 − 当前策略特征期望,把差距大的特征权重视为"更值得做"。 对比记忆:RL 是"给奖励找最优策略";IRL 是"给最优行为找奖励"——正反互逆。
# ========== IRL 特征匹配数值演示:奖励权重把策略"拉向"专家统计 ==========
import numpy as np
rng = np.random.default_rng(2)
mu_E = np.array([0.8, 0.2])        # 专家策略的特征期望(从示范里统计出来的)
mu_pi = np.array([0.4, 0.6])       # 当前策略的特征期望(初始偏离)
dists = []
for _ in range(40):
    # 简化迭代:给定收益差距,策略朝专家方向"学习"(特征期望互相靠拢)
    mu_pi = mu_pi + 0.1 * (mu_E - mu_pi)
    dists.append(np.abs(mu_E - mu_pi).sum())
print('特征期望距离 |μ_E − μ_π|: 初始 %.3f → 最终 %.3f' % (dists[0], dists[-1]))
assert dists[-1] < dists[0] * 0.15
print('→ IRL 学的是"什么值得做"(奖励权重 w),而不是动作本身:奖励对了,策略自然对')
特征期望距离 |μ_E − μ_π|: 初始 0.720 → 最终 0.012
→ IRL 学的是"什么值得做"(奖励权重 w),而不是动作本身:奖励对了,策略自然对
GAIL 与 IRL 的对偶:为什么"判别器就是奖励"(🔴 深入)¶
观察:GAIL 的目标是 min-max 博弈: $$\min_\pi \max_D\ \mathbb{E}_{\pi_E}[\log D] + \mathbb{E}_\pi[\log(1-D)] - \lambda H(\pi)$$
推导"D 的最优解 = 密度比"(关键步骤):固定 π,对 D 逐点求导, 最优判别器为 $$D^*(s,a) = \frac{d_{\pi_E}(s,a)}{d_{\pi_E}(s,a) + d_\pi(s,a)}$$ ——D 收敛到"专家密度占比"。把它代回目标,得到 $$\max_\pi\ \underbrace{-\mathbb{E}_\pi\Big[\log\frac{d_\pi}{d_{\pi_E}}\Big]}_{\text{反向 KL}} - \lambda H(\pi)$$
这说明什么(对偶的本质):
- 判别器的 log 值本质上编码了"专家 vs 策略"的密度比
- 密度比 = 奖励的化身:IRL 里要显式求的 $R(s,a)$,GAIL 里被 $-\log D$ 隐式替代——IRL 的反问题被 GAN 结构直接吸收
- 因此常说:"GAIL = IRL 的对偶;判别器是隐式奖励,生成器是隐式策略。"
记忆:GAIL 不学奖励、不学"为什么",只学"像不像";像 = 判别器分不出 = KL 距离最小 = 奖励被隐式学到。 面试答"GAIL 原理"说这一条链就满分。
5. GAIL:把 IRL 写成 GAN(🔴 必背 min-max)¶
想法¶
IRL 的"先反推奖励再学策略"绕一大圈。GAIL(Ho & Ermon,2016) 直接学策略, 用一个判别器 D 代替奖励函数:
$$\min_{\pi} \max_{D} \ \mathbb{E}_{\tau\sim\pi_E}\big[\log D(s,a)\big] + \mathbb{E}_{\tau\sim\pi}\big[\log\big(1 - D(s,a)\big)\big] - \lambda H(\pi)$$
- D:区分"专家样本 vs 策略样本",D=1 表示像专家
- π:生成让 D 分不出的动作(D ≈ 0.5)
- 名词:对抗模仿学习 Adversarial IL
数学连接(💡 面试亮点)¶
造纸地说:GAIL 是把 IRL 的"奖励"换成判别器的负对数——IRL 的对偶表达天然是 GAN:
| 学什么 | 用什么信号 | |
|---|---|---|
| 判别器 D | 奖励/NLL(区分真假) | 专家 vs 策略样本 |
| 生成器 π | 策略(制造以假乱真轨迹) | D 的梯度 |
一句话:BC 是"抄作业",DAgger 是"抄作业+错题本",IRL 是"推测出题人想要什么", GAIL 是"用警察(判别器)逼着抄袭者以假乱真"。
# ========== GAIL 数值演示:判别器逼策略均值移向专家(1D 对抗) ==========
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
rng = np.random.default_rng(3)
mu = 2.0; sigma = 0.6               # 策略初始均值远离专家 0
w, b = 0.0, 0.0                     # 判别器 D(x) = sigmoid(w*x + b)
lr_d, lr_p = 0.1, 0.03
def Dval(x):
    return 1.0 / (1.0 + np.exp(-(w * x + b)))
mus = [mu]
for step in range(600):
    xe = rng.normal(0.0, sigma, 64) # 专家样本(均值 0)
    xp = rng.normal(mu, sigma, 64)  # 策略样本
    de, dp = Dval(xe), Dval(xp)
    # 判别器上升:E[log D(xe)] + E[log(1-D(xp))]
    w += lr_d * (np.mean((1 - de) * xe) - np.mean(dp * xp))
    b += lr_d * (np.mean(1 - de) - np.mean(dp))
    # 策略(重参数化 xp = mu + sigma*z):上升 E[log D(xp)] → ∇μ = E[(1-D)*w]
    mu += lr_p * np.mean((1 - dp) * w)
    mus.append(mu)
fig, ax = plt.subplots(figsize=(7.2, 4.2))
ax.plot(mus, lw=1.8, color='#3182bd', label='策略均值 μ')
ax.axhline(0.0, ls='--', lw=1.2, color='#C44E52', label='专家均值(目标)')
ax.set_xlabel('对抗训练步数'); ax.set_ylabel('策略均值 μ')
ax.set_title('GAIL:判别器逼着策略生成"像专家"的样本', fontsize=12)
ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
mixed = np.concatenate([rng.normal(0.0, sigma, 512), rng.normal(mu, sigma, 512)])
d_out = np.mean(Dval(mixed))
print('策略 μ 收敛到 %.3f;判别器输出均值 %.3f(≈0.5 = 分不清真假)' % (mu, d_out))
assert abs(mu) < 0.15
assert abs(d_out - 0.5) < 0.15
print('→ GAIL 一句话:不学奖励,用对抗让策略"以假乱真";IRL 对偶=GAN')
策略 μ 收敛到 -0.009;判别器输出均值 0.500(≈0.5 = 分不清真假)
→ GAIL 一句话:不学奖励,用对抗让策略"以假乱真";IRL 对偶=GAN
C:\Users\24260\AppData\Local\Temp\ipykernel_42468\1215342499.py:28: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
6.1 模仿学习全家族对比精讲(🔴 背诵级收官)¶
本节导读:BC / DAgger / IRL / GAIL 一条线:从"最便宜但最脆"到 "最贵但最本质"。这一节给总表、选型逻辑,以及模仿学习 ↔ RLHF 的衔接(LLM 岗加分点)。
1. 总表(背):
| BC | DAgger | IRL | GAIL | |
|---|---|---|---|---|
| 学什么 | π(s)→a 映射 | 映射(在线补数据) | 奖励 R | 奖励(隐式)+策略 |
| 需要专家 | 静态演示 | 在线重标注 | 演示 | 演示 |
| 训练方式 | 监督学习 | 迭代监督 | 双层优化 | GAN 对抗 |
| 抗复合误差 | 差 | 好 | 中 | 好 |
| 学出的奖励可迁移 | 无 | 无 | 是 | 部分(隐式) |
| 实现成本 | 低 | 中 | 高 | 中高 |
2. 选型决策树:
- 演示充足、任务短、要快 → BC
- 能反复咨询专家、任务长 → DAgger
- 需要"理解意图/迁移奖励"、专家交互贵 → IRL(MaxEnt)
- 要端到端、演示有限、追求鲁棒 → GAIL(或先 BC 再 GAIL 微调)
3. 为什么要 GAIL 之外再学 IRL(辩证):GAIL 快但奖励是"隐式黑盒" (判别器的 logit,不可迁移、不可解释);IRL 显式奖励可迁移可分析。 任务可迁移性是 IRL 的护城河——不是所有场景都要它。
4. 模仿学习 ↔ RLHF 衔接(LLM 岗必答):
SFT ≈ BC(学"人怎么写"的监督映射)
RLHF ≈ 学偏好奖励 + RL 优化(在线、要 RM)
DPO ≈ 显式奖励的"闭式版"(用策略比代替 RM)
- 类比表:BC=SFT、IRL≈训练 RM(反推评分)、RLHF/DPO="先 IRL 后 RL"的云端工程版
5. 易错点:
- 别把"模仿学习"说成"就是 BC":家族有四个成员,各自适用
- GAIL 的判别器≠奖励函数(它只是"像不像"的判据,无物理意义)
6. 面试问法:"模仿学习四方法怎么选?" → 按"专家可咨询性×任务长度 ×是否要可迁移奖励"排 BC→DAgger→IRL/GAIL;再补一句 LLM 视角: SFT≈BC、RLHF 的 RM≈IRL、DPO≈它的闭式解。
6. 全家族对比与 RLHF 衔接(🔴 背诵级)¶
| 方法 | 数据 | 学什么 | 核心机制 | 局限 |
|---|---|---|---|---|
| BC | 离线示范 | 策略 π | 监督学习 | 复合误差(分布偏移) |
| DAgger | 在线示范(可问专家) | 策略 π | 数据集聚合:在错处补数据 | 需要能随时问专家 |
| MaxEnt IRL | 离线示范 | 奖励 R | 特征匹配/最大熵 | 内层要跑 RL(贵) |
| GAIL | 离线示范 | 策略 π | 判别器对抗(IRL 对偶) | 训练不稳(同 GAN) |
| 偏好学习(RLHF/DPO) | 人类偏好对 | 奖励模型+π | 偏好→奖励→RL(06 篇) | 偏好标注贵 |
演进线:BC(抄作业)→ DAgger(错题本)→ IRL(猜出题意图)→ GAIL(对抗以假乱真) → RLHF(用人类偏好当"终极示范")。LLM 的 SFT ≈ BC,RLHF ≈ 偏好版的"奖励建模+RL"。
7. 数字敏感度与易错点¶
- 复合误差量级:单步 ε → 执行 T 步误差 ~ εT;总期望偏差 O(εT²)(线性系统)
- DAgger 轮数:通常 10~几十轮,每轮加一批专家纠正样本
- GAIL 熵系数 λ:太小模式坍缩;太大学不到专家行为
- 易错:IRL 学的是奖励不是策略(策略是内层 RL 的副产品)
- 易错:BC 的"好"是假象——训练损失低 ≠ 执行好(分布变了)
- 易错:模仿学习 ≠ 完全不用奖励:GAIL 判别器隐含奖励,RLHF 显式建奖励模型
8. 面试速答(30 秒背诵版)¶
- Q:模仿学习和 RL 区别? A:IL 给示范学得像专家;RL 给奖励试错最大化回报
- Q:BC 最大问题? A:分布偏移/复合误差——训练分布≠执行分布
- Q:DAgger 怎么做? A:策略自己滚动,专家给轨迹逐状态打标,聚合进数据集再训
- Q:IRL 是什么? A:从专家示范反推奖励函数(R=w·φ 特征匹配 / MaxEnt)
- Q:GAIL 公式? A:min_π max_D E[logD(E)] + E[log(1−D(π))] − λH(π)
- Q:GAIL 和 IRL 关系? A:GAIL 是 IRL 的对偶 GAN 化——判别器即隐式奖励
9. 知识链自测¶
- 能手推:复合误差 e_t≈εt;MaxEnt IRL 梯度 = μ_E − μ_π;GAIL min-max 目标
- 能对比:BC vs DAgger vs IRL vs GAIL;IL vs RL vs SL;RLHF 与 IL 的关系
- 能默写:GAIL 目标式、特征匹配等式、DAgger 聚合伪代码
- 07 全章闭环:00-12 = MDP→DP/MC/TD→Q/DQN→PG/AC→PPO/GRPO→DDPG/TD3/SAC→MARL →Model-based→Offline→Imitation——从"给奖励学"到"看示范学",RL 全谱系收官。