🎲 00 · 马尔可夫决策过程 MDP 与贝尔曼方程(强化学习地基)¶
面试定位:MDP 五元组、价值函数、贝尔曼期望/最优方程是所有 RL 岗位的第一问。 本篇以手写 numpy 实现一个 4×4 网格世界,把每条公式变成可见的数字。 标记:🔴 必背 / 🟡 掌握 / 🟢 了解。
1. 强化学习是什么(🔴 与其他 ML 的区别)¶
一句话定义¶
强化学习(Reinforcement Learning, RL) 是智能体(Agent)在环境(Environment)中通过试错学习"在什么状态做什么动作能获得最多累积奖励"的范式。
与监督/无监督学习对比(背)¶
| 维度 | 监督学习 | 无监督学习 | 强化学习 |
|---|---|---|---|
| 数据来源 | 标注样本 (x, y) | 无标注样本 | 与环境交互产生的轨迹 |
| 学习信号 | 标签 y | 结构/分布 | 标量奖励 r(稀疏、延迟) |
| 数据分布 | 静态 i.i.d. | 静态 | 非 i.i.d.(自己影响后续数据) |
| 目标 | 泛化误差最小 | 结构发现 | 累积回报最大(长期) |
| 典型问题 | 分类/回归 | 聚类/降维 | 游戏/控制/推荐/LLM 对齐 |
面试金句:RL 的核心难点是 信用分配(credit assignment)——延迟的奖励要回溯到"哪一步动作";以及 探索与利用的权衡。
经典应用(背三例)¶
- 游戏:AlphaGo / Atari / Dota2(状态=棋面/画面,动作=落子/操作)
- 机器人控制:机械臂抓取、四足行走(状态=关节角速度,动作=力矩)
- LLM 对齐:RLHF(状态=已生成 token 序列,动作=下一个 token,奖励=人类偏好)→ 见 10 篇
核心概念¶
(a) 🗂️ MDP 与贝尔曼方程知识地图¶
这篇是强化学习的地基:用马尔可夫决策过程(MDP)把"智能体如何与环境互动、如何累积奖励"这件事用数学语言讲清楚,再靠贝尔曼方程把"无穷步的回报"折叠成一步递推。后面所有算法(DP、MC、TD、DQN、PPO)都从这里出发。
flowchart TB
    Node1["🧠 交互回路"]
    Node1 --> Node2["🧠 MDP 五元组"]
    Node2 --> Node3["🧠 回报与折扣 γ"]
    Node3 --> Node4["🧠 V 与 Q 价值函数"]
    Node4 --> Node5["🧠 贝尔曼期望方程"]
    Node4 --> Node6["🧠 贝尔曼最优方程"]
    Node5 --> Node7["🧠 两种求解视角"]
    Node6 --> Node7
    Node2 --> Node8["🧠 马尔可夫性质与 POMDP"]
- 节点1(交互回路):智能体看状态、选动作、环境给奖励并跳到新状态,这个循环不断重复。就像下棋:你观察棋盘(状态)、走一步(动作)、对手回应(环境跳转)、输赢决定你赚了多少(奖励)。
- 节点2(MDP 五元组):MDP 用 (S, A, P, R, γ) 五样东西完整描述一个决策问题:有哪些状态、能做什么动作、转移概率 P、奖励 R 和折扣 γ。它像一份"世界说明书",连环境的不确定性也写进去了。
- 节点3(回报与折扣 γ):回报是把一路上所有奖励按折扣 γ 折现后加起来,γ 在 [0,1] 之间,表示"未来的钱值多少"。γ 越小越短视(只在乎眼前),γ 越大越看重长远;γ=1 且回合无限时回报可能发散,这也是折扣存在的理由。
- 节点4(V 与 Q 价值函数):V(s) 是"站在状态 s 平均还能赚多少",Q(s,a) 是"在 s 先做动作 a 再按策略走能赚多少"。V 像评估"这个位置好不好",Q 像评估"这个位置做这个动作好不好",两者可以互相换算。
- 节点5(贝尔曼期望方程):它把"当前价值"写成"当前奖励 + 下一个状态的价值",把无穷求和折叠成一步递归,是策略评估的灵魂公式。就像"今天赚多少 + 明天还能赚多少",一条等式概括整段旅程。
- 节点6(贝尔曼最优方程):在期望方程基础上把动作换成"挑最好的那个(max)",得到最优价值 V*,最优策略就是每步都选让 V* 最大的动作。它回答的是"怎么选才是最好的"。
- 节点7(两种求解视角):价值既可以通过迭代一步步逼近(值迭代/策略评估),也可以写成 V = R + γPV 的线性方程组直接解。好比同一个问题既能"反复试错逼近",也能"列方程一次解出"。
- 节点8(马尔可夫性质与 POMDP):马尔可夫性质假设"下一步只由当前状态决定",历史都浓缩在当前状态里,这大大简化了问题。当状态看不见(POMDP)或状态多到组合爆炸时,表格方法就走不远,为后面的函数近似埋下伏笔。
1.5 先看图:强化学习的"交互回路"(🔴 一切的地基)¶
强化学习整体就一张图:智能体(Agent)在环境(Environment)里反复"行动-观测-得赏"。
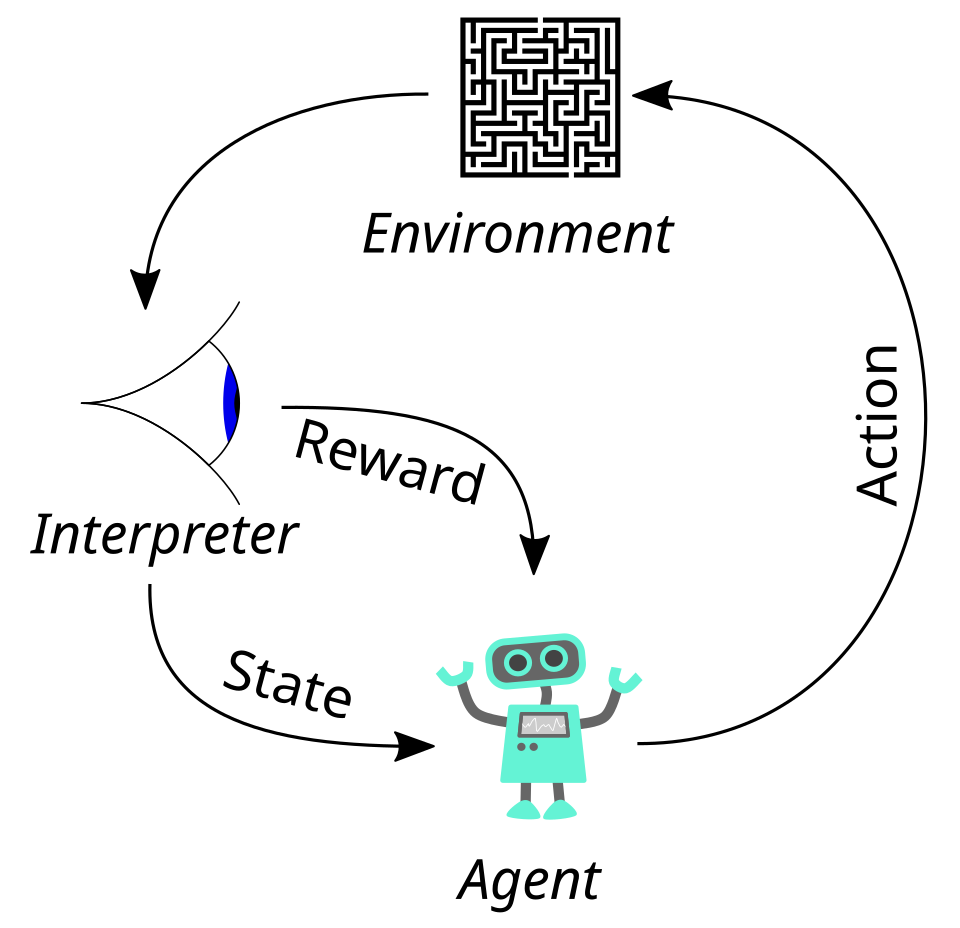
回路五步(配合上图背流程)¶
- 智能体观测当前状态 $s_t$(环境给智能体的"眼睛")
- 智能体按策略选动作 $a_t$(决策)
- 环境执行动作,转移到下一状态 $s_{t+1}$(按 $P(s'|s,a)$)
- 环境返回即时奖励 $r_t$($R(s,a)$)
- 回到第 1 步,直到终止
把真实问题映射进回路(面试常考举例)¶
| 场景 | 状态 s | 动作 a | 奖励 r | 环境 |
|---|---|---|---|---|
| 下围棋 | 当前棋面 | 落子位置 | 赢+1 / 输-1(终局才给) | 棋盘规则 |
| 自动驾驶 | 传感器+地图 | 方向盘/油门 | 到达+1、碰撞-10 | 真实道路 |
| LLM 对话 | 上下文 token | 下一个 token | 人类/奖励模型打分 | 用户+评分器 |
记忆:回路 = (s,a,r,s') 四元组循环。后面所有算法(DQN/PPO/GRPO…)都是在 把这个回路里"怎么选动作"这件事学聪明。 图源:Wikimedia Commons(CC BY-SA,Reinforcement learning diagram)。
2.1 五元组精讲:一个 MDP 到底"规定了什么"(🔴 必背,像书一样读)¶
本节导读:为什么要一个"五元组"?因为要描述"一个能反复做决策的世界", 必须回答五个问题:有哪些处境(S)、有哪些选择(A)、选了会怎样(P)、 会得到什么(R)、怎么看待未来(γ)。缺任何一个,问题就不完整。
1. 直觉引入:把 MDP 想象成"人生决策器"。你(智能体)每天醒来面对 一个处境(状态 S),要做一个选择(动作 A),选择后世界会变化(转移 P), 并给你反馈(奖励 R),而你对"远未来的在乎程度"由 γ 决定。这个比喻对应 所有场景:下棋、开车、聊天机器人、交易。
2. 正式定义:一个马尔可夫决策过程是五元组 $$\langle \mathcal{S},\ \mathcal{A},\ \mathcal{P},\ \mathcal{R},\ \gamma\rangle$$
- $\mathcal{S}$:状态集合(离散/连续)。状态必须足够描述决策所需的全部信息
- $\mathcal{A}$:动作集合。可以是离散的(上/下/左/右)或连续的(力矩大小)
- $\mathcal{P}$:状态转移概率 $P(s'|s,a)$——在状态 $s$ 做动作 $a$ 后, 到达 $s'$ 的概率(对 $\sum_{s'}P(s'|s,a)=1$)
- $\mathcal{R}$:奖励函数 $R(s,a)$(或 $R(s,a,s')$)——这一步的即时回报
- $\gamma\in[0,1]$:折扣因子——未来奖励相对现在的权重
3. 为什么"马尔可夫"这么重要(推导性质): "给定当前状态,未来与过去无关"(无后效性)。写作 $$P(s_{t+1}\mid s_t, a_t, s_{t-1}, a_{t-1}, \dots) = P(s_{t+1}\mid s_t, a_t)$$ 这个性质不是免费的:它要求状态定义里包含做决策所需的全部信息。 如果状态漏了信息(比如下棋时只看"还剩几步"不看棋面),马尔可夫性就破。 代价是:只要状态够好,最优决策只依赖当前状态,不需要记忆历史—— 这是贝尔曼方程能"递归"的数学前提。
4. 举例:4×4 网格世界(本篇实验场):S=16 个格子、A=4 个方向、 P=确定性转移、R=每步 -1、到达目标 +10、γ=0.9。
5. 易错点:
- MDP 不是"环境模拟器":它只是问题的数学描述;P/R 可以已知(DP 用) 也可以未知(MC/TD 学)
- γ 属于 MDP 定义的一部分:同一个环境,γ 不同就是不同的问题
- 奖励和回报是两回事:R 是单步的,回报 G 是累积的(下一节)
6. 面试问法:"给我讲讲 MDP 五元组" → 先答五个符号含义,再答马尔可夫 性质为什么重要,最后补一句"所有 RL 算法都是在这个五元组上求解最优策略"。
2. MDP 五元组(🔴 必背定义)¶
形式定义¶
一个马尔可夫决策过程由五元组 $\langle \mathcal{S}, \mathcal{A}, \mathcal{P}, \mathcal{R}, \gamma \rangle$ 组成:
- $\mathcal{S}$(状态集):智能体所处的所有可能状态,如网格世界的每个格子
- $\mathcal{A}$(动作集):每个状态下可执行的动作,如 上下左右
- $\mathcal{P}$(状态转移概率):$P(s'|s,a)$ —— 在状态 $s$ 执行动作 $a$ 后转移到 $s'$ 的概率
- $\mathcal{R}$(奖励函数):$R(s,a,s')$ 或 $R(s)$ —— 转移时获得的即时奖励
- $\gamma \in [0,1]$(折扣因子):未来奖励的折现程度
马尔可夫性质(🔴)¶
$$P(s_{t+1}|s_t, a_t, s_{t-1}, a_{t-1}, \dots) = P(s_{t+1}|s_t, a_t)$$
当前状态已经包含了做决策所需的全部历史信息——历史被"压缩"进当前状态。这是 MDP 能被贝尔曼方程求解的前提。
与马尔可夫链 / 马尔可夫奖励过程的关系(🟡 层级)¶
马尔可夫链 MC : <S, P>                     (无动作无奖励)
马尔可夫奖励过程 MRP : <S, P, R, γ>        (无动作, 有奖励)
马尔可夫决策过程 MDP : <S, A, P, R, γ>     (有动作, 智能体决策)
面试追问:MDP 假设了"状态完全可观测"。真实环境部分可观测时 → POMDP(状态被观测/隐状态建模,用信念状态 b(s))。答出这条直接加分。
3. 手写 4×4 网格世界(本篇的实验场)¶
规则设计(经典 Cliff 环境的温柔版):
- 网格
4×4=16个格子,坐标(row, col),起点(0,0),终点(3,3) - 动作:上/下/左/右 四选一;撞墙不动(转移概率演示)
- 移入终点奖励
+10,其他正常移动奖励-1(鼓励走最短路径) - 转移概率:
P(s'|s,a)用确定性移动 + 撞墙自环模拟(简单但够用于教学)
下面用代码把它表示出来——状态编号 0~15,动作编号 0=上 1=下 2=左 3=右。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# gridworld.py —— 手写 MDP 组件: 状态 / 动作 / 转移 / 奖励(不依赖 gym)
import numpy as np

SIZE = 4
N_STATES = SIZE * SIZE      # 16
N_ACTIONS = 4               # 0上 1下 2左 3右
GOAL = N_STATES - 1         # 15 = (3,3)
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]   # 上 下 左 右

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    """返回 (s_next, reward)。
    确定性版本: 撞墙自环, 到达终点给 +10 并终止(episode 结束)。
    """
    if s == GOAL:
        return GOAL, 0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0          # 撞墙: 留在原地, 惩罚
    s_next = nr * SIZE + nc
    return (GOAL, 10.0) if s_next == GOAL else (s_next, -1.0)

# 快速自检: 从 0 向下走到 4, 奖励应为 -1
print('状态 (0,0) 向下 →', step(0, 1))
# 从 14 向右走到终点
print('状态 14 向右 →', step(14, 3))
# 从 0 向上撞墙: 自环
print('状态 0 向上(撞墙) →', step(0, 0))
# 底边 12 向下撞墙
print('状态 12 向下(撞墙) →', step(12, 1))
状态 (0,0) 向下 → (4, -1.0)
状态 14 向右 → (15, 10.0)
状态 0 向上(撞墙) → (0, -1.0)
状态 12 向下(撞墙) → (12, -1.0)
4.1 回报精讲:从"每一步的奖励"到"整段旅程的得分"(🔴)¶
本节导读:奖励 R 只是"一步的反馈",智能体真正优化的是整段旅程的累积 折扣回报。这一节建立全书最重要的对象:$G_t$。
1. 直觉引入:马拉松不是"每跑 1 米给 1 分,加总"那么简单——因为 今天的 1 分比明年的 1 分更值钱(钱有时间价值)。折扣回报就是 "把未来收益折现到现在":越远越打折。
2. 正式定义:从时刻 $t$ 开始的(折扣)回报: $$G_t = r_{t+1} + \gamma r_{t+2} + \gamma^2 r_{t+3} + \cdots = \sum_{k=0}^{\infty}\gamma^k r_{t+1+k}$$
3. 逐步推导(γ 为什么必须小于 1——几何级数): 当奖励恒为 1 时, $$G_t = 1 + \gamma + \gamma^2 + \cdots = \frac{1}{1-\gamma}\quad(\gamma<1)$$
- $\gamma<1$:无穷和收敛(等比求和公式),无限过程也可用
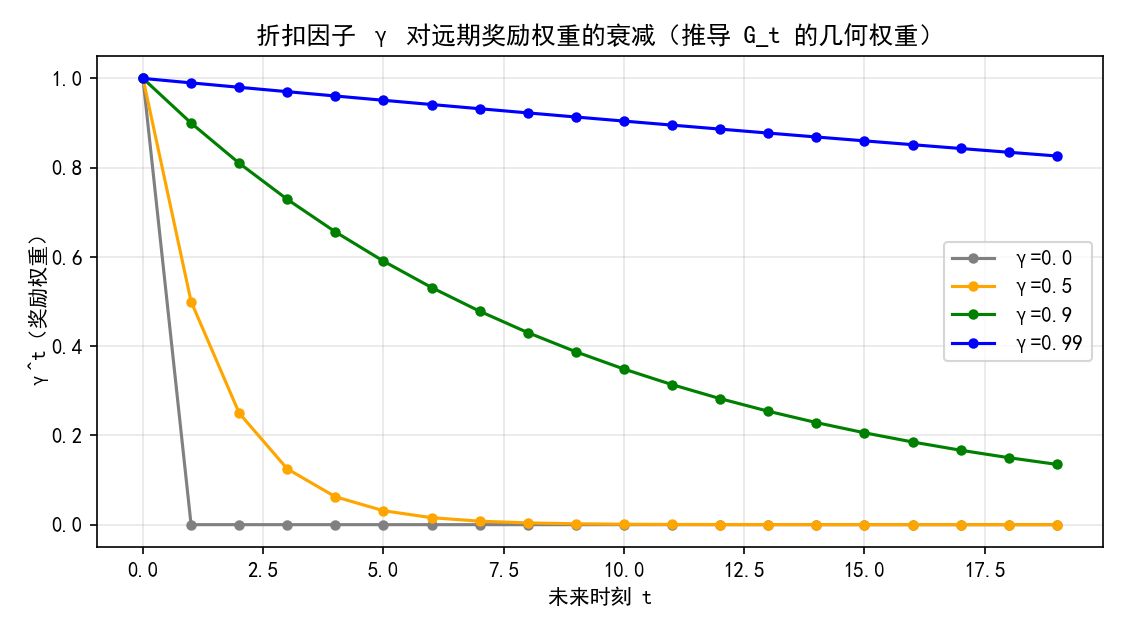
- $\gamma=0$:只看眼前一步奖励(短视)——多臂老虎机就是 γ=0 的特例
- $\gamma=1$:不打折。有限 horizon 合法;无限 horizon 可能发散
4. 数字例子:轨迹奖励 $[-1,-1,+10]$,$\gamma=0.9$: $$G_0 = -1 + 0.9\times(-1) + 0.9^2\times 10 = -1 - 0.9 + 8.1 = 6.2$$ (对比:γ=0 时 G₀=-1;γ=1 时 G₀=8。)同一个轨迹,γ 不同 → 打分完全不同。
5. 易错点:
- G 是"随机变量":同一策略下不同轨迹的 G 不同(转移/动作随机)
- 下标:$G_t$ 从 $r_{t+1}$ 开始(动作后的第一个奖励),不是 $r_t$
- γ 小 ≠ 奖励小:是"远期的奖励权重小"
6. 面试问法:"回报和奖励的区别?" → "奖励是单步即时反馈,回报是从当前 时刻起的所有未来奖励按 γ 折现的累积和;RL 优化的对象是回报的期望。"
4. 回报 Return 与折扣因子 γ(🔴)¶
累积回报定义¶
从 $t$ 时刻开始的累积折扣回报:
$$G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1}$$
γ 的三种含义(背)¶
- 数学上:$\gamma<1$ 保证无限 horizon 的回报收敛($\sum \gamma^k = \frac{1}{1-\gamma}$)
- 直觉上:$\gamma$ 小 → 近视(只关心短期);$\gamma$ 大 → 远视(看重长期)
- 建模上:$\gamma=0$ 等价于"贪心只看下一步";$\gamma\to1$ 等价于"总和回报"
边界情况(面试易错)¶
- $\gamma=0$:$G_t = R_{t+1}$,只看一步(多臂老虎机场景)
- $\gamma=1$ 且任务有限长:回报 = 不加权总和(有限 horizon 收敛)
为什么需要折扣(选答)¶
① 收敛性;② 人类/动物天然偏好即时奖励(延迟满足有限);③ 避免无限回报发散;④ 处理不确定性(未来奖励置信度低)。
# return_demo.py —— 折扣回报数值演示: 一条轨迹的 G_t 怎么算
import numpy as np

def discounted_return(rewards, gamma, t=0):
    """从 t 时刻起的折扣回报 G_t"""
    return sum(gamma ** k * r for k, r in enumerate(rewards[t:]))

# 示例轨迹奖励: 前面一直 -1, 最后一步 +10
rewards = [-1, -1, -1, -1, 10]

print(f'{"γ":<6}{"G_0":>8}{"G_3":>8}    (G_3 只看最后两步)')
for gamma in [0.0, 0.5, 0.9, 0.99]:
    g0 = discounted_return(rewards, gamma, 0)
    g3 = discounted_return(rewards, gamma, 3)
    print(f'{gamma:<6}{g0:>8.3f}{g3:>8.3f}')

print()
print('γ=0.9 时逐步展开 G_0:')
g = 0.0
for k, r in enumerate(rewards):
    g += 0.9 ** k * r
    print(f'  时刻 {k}: 累加到 {g:.3f}')
print('当 γ→1, G 趋向(+10 永不被深度折扣掩盖), 而 γ 小则后期 +10 几乎无感')
γ          G_0     G_3    (G_3 只看最后两步)
0.0     -1.000  -1.000
0.5     -1.250   4.000
0.9      3.122   8.000
0.99     5.666   8.900

γ=0.9 时逐步展开 G_0:
  时刻 0: 累加到 -1.000
  时刻 1: 累加到 -1.900
  时刻 2: 累加到 -2.710
  时刻 3: 累加到 -3.439
  时刻 4: 累加到 3.122
当 γ→1, G 趋向(+10 永不被深度折扣掩盖), 而 γ 小则后期 +10 几乎无感
γ 的三个数学事实(🔴 讲透)¶
事实 1:几何级数收敛
当奖励恒为 1($r_k=1,\ \forall k$)且回合无限时:
$$G_t = \sum_{k=0}^{\infty} \gamma^k \cdot 1 = \frac{1}{1-\gamma}$$
这是等比数列求和公式 $\sum_{k=0}^{\infty} q^k = \dfrac{1}{1-q}\ (|q|<1)$ 的直接应用—— γ<1 是无限和有限的前提。
事实 2:γ 决定"有效视野"
$1/(1-\gamma)$ 叫有效时间尺度:γ=0.9 → 10 步;γ=0.99 → 100 步;γ=0.999 → 1000 步。 面试说"γ 控制智能体看多远"就是指这个量。
事实 3:γ=1 的歧义与陷阱
- 无限 horizon 时 $\sum \gamma^k$ 发散(除非奖励和有限)——所以无限过程必须 γ<1
- 有限 horizon(如 10 步小游戏)γ=1 合法,等于"不打折直接累加"
- 算法上 γ<1 还保证贝尔曼算子收缩(§23 数值实验),值迭代才收敛、解才唯一
γ 的"方差正则"视角(进阶直觉)¶
γ 越小,远期奖励权重被压得越平 → 回报方差越小(对未来的不确定性不敏感), 但偏差越大(短视、忽略长期后果)。γ 是 RL 里第一个"偏差-方差权衡"旋钮, 后面 TD(λ)、GAE、SAC 的温度还会反复出现同样的权衡。
折扣的两种等价写法(推导细节)¶
从 $t$ 时刻的回报定义出发,把求和拆成"第 0 项 + 余项":
$$G_t = r_{t+1} + \gamma r_{t+2} + \gamma^2 r_{t+3} + \cdots = r_{t+1} + \gamma\big(r_{t+2} + \gamma r_{t+3} + \cdots\big) = r_{t+1} + \gamma G_{t+1}$$
这就是贝尔曼方程中 γ 位置的来源——不是拍脑袋加的折扣, 而是从 $G_t$ 的递归定义自然长出来的。面试手推时从这一行开始。
5.1 价值函数精讲:把"不确定的未来"压缩成一个数(🔴)¶
本节导读:回报 G 是一条具体轨迹的运气;价值函数是在所有运气上取平均 ——"在这个状态(做这个动作),平均能拿多少回报"。这是从"轨迹视角" 切换到"状态视角"的关键一跃,也是贝尔曼方程的土壤。
1. 直觉引入:两个人下棋,同一局面:高手说"这局面值 +0.3"(白优), 新手觉得差不多。价值函数就是给"局面"打分——好的估值能让决策只看当前 局面,不用每步都脑内模拟整盘。
2. 正式定义(策略 $\pi$ 固定时): $$V^{\pi}(s) = \mathbb{E}_{\pi}\big[G_t \mid S_t = s\big] = \mathbb{E}_{\pi}\Big[\sum_{k=0}^{\infty}\gamma^k r_{t+1+k}\,\Big|\, S_t=s\Big]$$ 动作价值(先做动作再按 π 走): $$Q^{\pi}(s,a) = \mathbb{E}_{\pi}\big[G_t \mid S_t=s, A_t=a\big]$$
3. 两者的关系(推导核心,必背): $$V^{\pi}(s) = \sum_{a} \pi(a|s)\, Q^{\pi}(s,a)$$
- 策略 π 告诉你"各动作的概率";价值 = 动作价值的加权平均
- 反过来:$Q^{\pi}(s,a) = \sum_{s'} P(s'|s,a)\big[R(s,a) + \gamma V^{\pi}(s')\big]$
- V 是"状态好坏的度量",Q 是"状态+动作好坏的度量"——决策需要 Q (比较动作),评估局面用 V
4. 数字例子(网格世界):状态 (2,2) 处,策略随机:四个方向各 25%, Q 分别为 -8、-6、-5、-7 → $V^{\pi}(2,2)=0.25(-8-6-5-7)=-6.5$。
5. 易错点:
- V/Q 都依赖策略 π:换策略 → 价值全变。$V^{\pi}$ 不是"环境的固有属性"
- Q 的下标:$Q^{\pi}(s,a)$ 是"在 s 先做 a、之后都按 π"的价值
- 价值是期望:单次走出来的 G 不等于 V(有方差)
6. 面试问法:"V 和 Q 什么区别?" → "V 是状态层面的平均价值(按策略 加权动作),Q 是状态-动作对的价值;决策用 Q,评估用 V;V=Σπ(a|s)Q(s,a)。"
5. 状态价值 V(s) 与动作价值 Q(s,a)(🔴 必背定义)¶
状态价值函数(在策略 π 下)¶
$$V^{\pi}(s) = \mathbb{E}_{\pi}\left[G_t \,\middle|\, S_t = s\right]$$
含义:从状态 $s$ 出发,按照策略 $\pi$ 行动,能获得的期望累积回报。
动作价值函数¶
$$Q^{\pi}(s,a) = \mathbb{E}_{\pi}\left[G_t \,\middle|\, S_t = s, A_t = a\right]$$
含义:在状态 $s$ 先执行动作 $a$,之后按 $\pi$ 行动,的期望累积回报。
V 与 Q 的关系(背)¶
$$V^{\pi}(s) = \sum_{a} \pi(a|s)\, Q^{\pi}(s,a)$$
- $V$ 是对动作按策略概率加权平均的 $Q$
- 若策略是确定性的($\pi(a|s)=1$ 对某 $a$),则 $V^{\pi}(s) = Q^{\pi}(s, a_{\pi})$
最优价值函数¶
$$V^*(s) = \max_{\pi} V^{\pi}(s), \qquad Q^*(s,a) = \max_{\pi} Q^{\pi}(s,a)$$
面试金句:$V$ 回答"这个状态有多好",$Q$ 回答"这个状态下做这个动作有多好";$Q$ 比 $V$ 多一个"动作"维度,所以 $Q$ 可以直接指导决策($a^*=\arg\max_a Q^*(s,a)$),而模型需要知道策略才能用 $V$。
6.1 贝尔曼期望方程精讲:把"无穷求和"折叠成"一步递归"(🔴 全章灵魂)¶
本节导读:$G_t$ 是无穷项求和,直接算要等到天荒地老。贝尔曼的洞察: $G_t$ 的"尾巴" $G_{t+1}$ 和自己长得一模一样——于是无穷和可以折叠成 一步等式。这一步折叠是 DP、MC、TD、DQN、PPO 所有算法的共同出发点。
1. 直觉引入:爬楼梯看高度:想知道"从这层到顶要走多远",不用数完 每一级——"从这层到顶 = 这一级的高度 + 从下一层到顶的距离"。价值 也一样:当前价值 = 立即奖励 + 下一状态的价值(打 γ 折)。
2. 形式定义(状态价值版): $$V^{\pi}(s) = \sum_{a}\pi(a|s)\sum_{s'} P(s'|s,a)\Big[R(s,a) + \gamma V^{\pi}(s')\Big]$$
3. 逐步推导(面试手推,逐行): ① 从定义出发:$V^{\pi}(s)=\mathbb{E}_\pi[G_t\mid S_t=s]$ ② 拆开回报:$G_t = r_{t+1} + \gamma G_{t+1}$(递归性质) ③ 代入:$V^{\pi}(s) = \mathbb{E}_\pi\big[r_{t+1} + \gamma G_{t+1}\mid S_t=s\big]$ ④ 把期望拆开:动作按 π 加权 → $\sum_a\pi(a|s)\cdot$;转移按 P 加权 → $\sum_{s'}P(s'|s,a)\cdot$ ⑤ 用定义代回尾巴:$\mathbb{E}_\pi[G_{t+1}\mid S_{t+1}=s'] = V^{\pi}(s')$ ⑥ 得到方程。推导关键就一行:$G_t = r_{t+1} + \gamma G_{t+1}$。
4. 为什么是"方程"(线性代数视角): 对 |S| 个状态有 |S| 个未知数 $V^{\pi}(s)$,方程个数 = 未知数个数 → 可以解。矩阵形式:$V^\pi = R_\pi + \gamma P_\pi V^\pi$, 移项得 $V^\pi = (I - \gamma P_\pi)^{-1} R_\pi$(本篇 §14 数值验证)。
5. 易错点:
- 期望方程没有 max(给定策略求价值);最优方程才有 max(下一节)
- $V^{\pi}(s')$ 里的 π 与外面同一个——"按 π 走下去"的一致性
- 别漏 $R(s,a)$:它是 (s,a) 的立即奖励,不在期望里打折扣
6. 面试问法:"推导贝尔曼期望方程" → 按第 3 步六行背出,落点在 "G_t = r + γG_{t+1} 的递归折叠"。
6. 贝尔曼期望方程(🔴 推导要会)¶
状态价值版¶
把 $G_t$ 拆成"立即奖励 + 折扣的下一状态价值":
$$V^{\pi}(s) = \sum_{a} \pi(a|s) \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma V^{\pi}(s') \right]$$
动作价值版¶
$$Q^{\pi}(s,a) = \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma \sum_{a'} \pi(a'|s') Q^{\pi}(s',a') \right]$$
推导三步(背下来,面试让手推就写这个)¶
① 展开: V(s) = E[ R_{t+1} + γ G_{t+1} | S_t=s ]
② 拆期望: 对 a 求和(策略) × 对 s' 求和(转移概率)
③ 递归: E[G_{t+1}|S_{t+1}=s'] = V(s')
贝尔曼方程的结构(一句话)¶
贝尔曼方程 = 立即奖励 + 折扣 × 下一步价值的期望 —— 它让"未来的价值"变成了"当前价值的线性方程",于是可以迭代求解。
# bellman_policy_eval.py —— 随机策略下的策略评估: 迭代求解 V^π
# 用贝尔曼期望方程迭代: V_{k+1}(s) = Σ_a π(a|s) Σ_s' P(s'|s,a)[R + γV_k(s')]
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    """确定性转移: 返回 [(概率, s', r)]"""
    if s == N - 1:
        return [(1.0, s, 0.0)]          # 终点吸收
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]         # 撞墙
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

# 随机策略: 每个状态四个动作等概率
pi = np.full((N, 4), 0.25)

V = np.zeros(N)
for it in range(200):
    V_new = np.zeros(N)
    for s in range(N):
        v = 0.0
        for a in range(4):
            for p, s2, r in trans(s, a):
                v += pi[s, a] * p * (r + GAMMA * V[s2])
        V_new[s] = v
    if np.max(np.abs(V_new - V)) < 1e-8:
        V = V_new
        break
    V = V_new

print(f'迭代 {it + 1} 轮后收敛')
print('随机策略下每个状态的价值 V(s)(2 位小数):')
print(np.round(V.reshape(SIZE, SIZE), 2))
print()
print('解读: 离终点越近价值越高; 角落 (0,0) 因为随机乱走绕远, 价值为负')
迭代 148 轮后收敛
随机策略下每个状态的价值 V(s)(2 位小数):
[[-8.58 -8.26 -7.72 -7.22]
 [-8.26 -7.72 -6.67 -5.49]
 [-7.72 -6.67 -4.26 -0.57]
 [-7.22 -5.49 -0.57  0.  ]]

解读: 离终点越近价值越高; 角落 (0,0) 因为随机乱走绕远, 价值为负
把贝尔曼方程"读出来"(配图)——为什么必然长这样¶
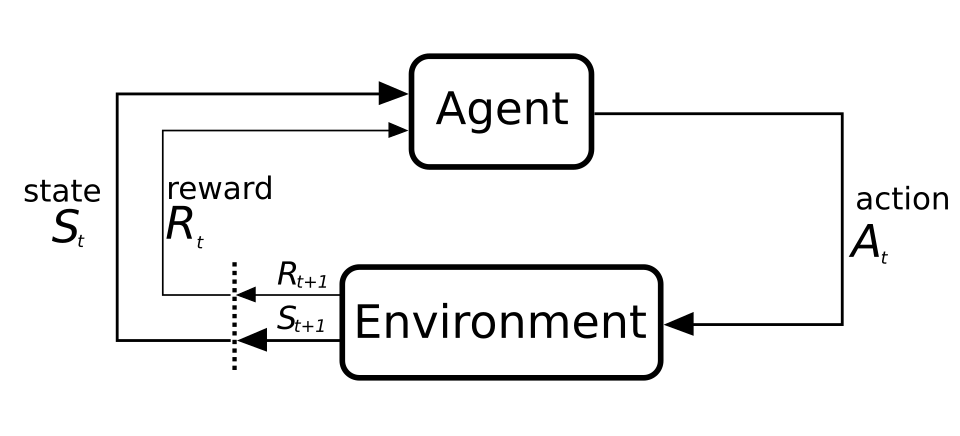
从左到右读这张 MDP 图:状态 $s$ 下选动作 $a$ → 以概率 $P(s'|s,a)$ 跳到 $s'$ → 拿奖励 $R(s,a)$。 贝尔曼方程就是把"未来价值"沿这条路径按概率折现回卷。
状态价值版($\pi$ 下先按策略取期望动作、再按转移取期望后继):
$$V^{\pi}(s) = \underbrace{\sum_{a}\pi(a|s)}_{\text{① 按策略加权动作}} \underbrace{\sum_{s'} P(s'|s,a)}_{\text{② 按转移概率加权}} \Big[\underbrace{R(s,a)}_{\text{③ 立即奖励}} + \underbrace{\gamma V^{\pi}(s')}_{\text{④ 折扣的未来价值}}\Big]$$
四个"为什么"(面试讲透)¶
- 为什么是期望? 随机策略 + 随机转移 → 未来不是确定的,只能取平均
- 为什么有折扣 γ? ① 钱越远越不值钱;② 数学上保证收敛(收缩算子)
- 为什么叫"方程"? 两边都有 $V^{\pi}$:$|S|$ 个未知数、$|S|$ 个方程 → 可解 (§14 的线性方程组视角:$V = (I - \gamma P_\pi)^{-1} R_\pi$)
- 为什么说它把"多步"变"一步"? 无穷多步求和被递归折叠进 $V^{\pi}(s')$ 一项—— 这是 DP / RL 一切算法的出发点
对比记忆:期望方程 vs 最优方程(一句话)¶
| 期望方程 | 最优方程 | |
|---|---|---|
| 主语 | 给定策略 $\pi$ 的价值 | 最优策略下的价值 |
| 动作怎么选 | $\sum_a \pi(a\|s)$(按策略平均) | $\max_a$(只留最好的动作) |
| 用途 | 策略评估 | 策略改进/求解 |
一句话:贝尔曼方程 = "眼前的奖励 + 打折后的未来",而未来的未来又递归地包在里面。 图源:Wikimedia Commons(CC BY-SA,Markov diagram v2,基于 Sutton & Barto 图 3.4)。
7.1 贝尔曼最优方程精讲:从"评价策略"到"找到最好策略"(🔴)¶
本节导读:期望方程回答"给定策略值多少";最优方程回答"最好的策略值多少、 最好的策略是什么"。它是所有 RL 目标的形式化——解出 V*,贪心即最优。
1. 直觉引入:选餐厅:期望方程 = "按我平时的口味(策略)平均打分"; 最优方程 = "每次都选最喜欢的(max)"。最优策略就是"处处贪心于最优价值"。
2. 形式定义: $$V^{*}(s) = \max_{a}\sum_{s'} P(s'|s,a)\Big[R(s,a) + \gamma V^{*}(s')\Big]$$ $$Q^{*}(s,a) = \sum_{s'} P(s'|s,a)\Big[R(s,a) + \gamma\, \max_{a'} Q^{*}(s',a')\Big]$$
3. 推导(与期望方程的唯一区别 + 为什么成立):
- 期望方程把动作按 π(a|s) 加权;最优方程取 max——"按最好的动作走"
- 关键性质:对任意策略 π,$V^{\pi}(s) \le V^{*}(s)$;且若 $V^{\pi}$ 满足 最优方程,则 π 是最优策略(策略改进定理保证,01 篇展开)
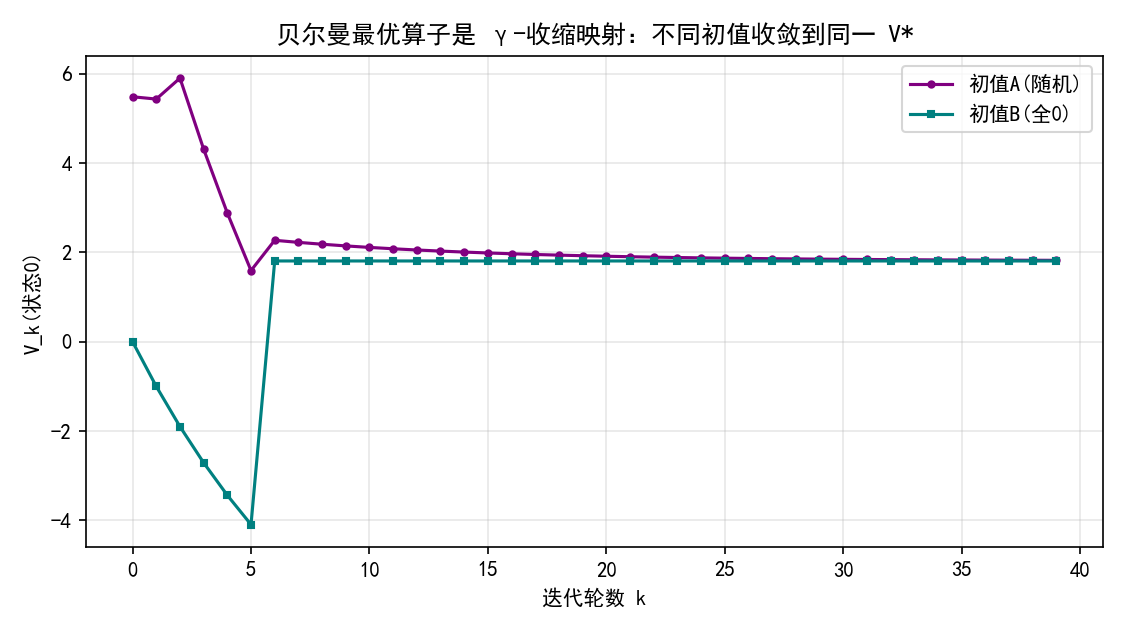
- 解的唯一性:γ<1 时贝尔曼算子 $T$ 是收缩映射(§23 数值实验), 不动点唯一 → 从任意初始 V 迭代都能收敛到 $V^{*}$
4. 数字例子(网格角落):状态 (0,0) 只有向右/向下两动作: $Q^*((0,0),\text{右}) = -1 + 0.9\,V^*(0,1)$,$Q^*((0,0),\text{下}) = -1 + 0.9\,V^*(1,0)$; $V^*(0,0)=\max(\dots)$——"看一步 + 之后用最优价值"。
5. 易错点:
- max 在里面不在外面:先对动作取 max,再对转移取期望(顺序别反)
- $V^*$ 的最优策略 $\pi^*$ 是贪心的:$\pi^*(s)=\arg\max_a Q^*(s,a)$
- 最优方程非线性(有 max),不能直接解线性方程组——所以用迭代(值迭代)
6. 面试问法:"值迭代和策略迭代区别" → 值迭代每轮 V←max 一步到位; 策略迭代评估/改进分开(01 篇)。先背最优方程一行,再补这个对比。
7. 贝尔曼最优方程(🔴)¶
最优状态价值¶
$$V^*(s) = \max_{a} \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma V^*(s') \right]$$
最优动作价值¶
$$Q^*(s,a) = \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma \max_{a'} Q^*(s',a') \right]$$
与期望方程的区别(背)¶
| 贝尔曼期望方程 | 贝尔曼最优方程 | |
|---|---|---|
| 里面的策略 | 固定策略 π(加权平均) | max over 动作(选最优) |
| 解 | V^π(该策略的价值) | V^*(最优价值) |
| 求解 | 策略评估(迭代) | 值迭代 / 策略迭代 |
最优策略的性质¶
- 至少存在一个确定性最优策略:$\pi^*(a|s) = \mathbb{1}\{a = \arg\max_a Q^*(s,a)\}$
- 只要找到 $Q^*$,$\pi^*$ 直接取 argmax 即可——这就是 Q-learning 的思想来源
两个不动点方程¶
贝尔曼最优方程是非线性的(因为 max),但它的解 $V^*$ 是唯一不动点;值迭代就是对这个不动点做压缩映射迭代(Banach 不动点定理保证收敛)。
# value_iteration.py —— 值迭代求解最优 V* 与最优策略(手写, 无调包)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
ACTIONS = ['↑', '↓', '←', '→']

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

V = np.zeros(N)
for it in range(1000):
    V_new = np.zeros(N)
    for s in range(N):
        best = -np.inf
        for a in range(4):
            v = sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a))
            best = max(best, v)
        V_new[s] = best
    if np.max(np.abs(V_new - V)) < 1e-9:
        V = V_new
        break
    V = V_new

# 由 V* 恢复最优策略: 每格选让 V*(s) 最大的动作
policy = []
for s in range(N):
    vals = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
    policy.append(ACTIONS[int(np.argmax(vals))])

print(f'值迭代 {it + 1} 轮收敛')
print('最优价值 V*:')
print(np.round(V.reshape(SIZE, SIZE), 2))
print()
print('最优策略(每格箭头, * 为终点):')
for r in range(SIZE):
    row = ''
    for c in range(SIZE):
        s = r * SIZE + c
        row += ('  *' if s == N - 1 else '  ' + policy[s])
    print(row)
print()
print('验证: 从起点沿箭头走 → 路径价值应等于 V*(0,0)')
值迭代 7 轮收敛
最优价值 V*:
[[ 1.81  3.12  4.58  6.2 ]
 [ 3.12  4.58  6.2   8.  ]
 [ 4.58  6.2   8.   10.  ]
 [ 6.2   8.   10.    0.  ]]

最优策略(每格箭头, * 为终点):
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  →  →  →  *

验证: 从起点沿箭头走 → 路径价值应等于 V*(0,0)
8. 面试高频追问与易错点(🔴)¶
追问速答¶
Q: γ=0 和 γ=1 分别代表什么? A: γ=0 只看立即奖励(多臂老虎机);γ=1 看全程总回报且要求有限 horizon。
Q: V(s) 和 Q(s,a) 哪个更有用? A: Q 含动作维度,可直接 argmax 得到策略;V 需要配合策略模型。DQN 家族学 Q,Policy Gradient 家族学策略 π。
Q: 贝尔曼方程为什么能迭代求解? A: 它是关于 V 的线性/非线性不动点方程,满足收缩映射 → Banach 不动点定理保证唯一解与收敛。
Q: MDP 和 POMDP 区别? A: MDP 状态完全可观测;POMDP 只有部分可观测 → 需用信念状态 b(s) 或历史/RNN 近似,难解。
Q: 为什么需要折扣因子(除收敛外)? A: 模型不确定、奖励延迟折价符合直觉、避免无限回报发散。
易错点清单¶
- ❌ 把"回报 G"和"价值 V"搞混:G 是一条轨迹的实际累积奖励;V 是期望(对所有轨迹平均)
- ❌ 忘记 $V^\pi(s)=\sum_a \pi(a|s)Q^\pi(s,a)$ 中的动作要先按策略加权
- ❌ 值迭代里用 $\max$、策略评估里用 $\sum_a \pi(a|s)$——两个方程结构不同,别混
- ❌ 转移概率 $P(s'|s,a)$ 与环境相关、不是智能体学的;智能体学的是价值/策略
9. 自测清单(L1 必会 / L2 进阶)¶
- L1:默写 MDP 五元组和马尔可夫性质
- L1:写出 $V^\pi$、$Q^\pi$、$V^*$、$Q^*$ 四个定义式
- L1:能解释 V 与 Q 的换算关系 $V^\pi(s)=\sum_a \pi(a|s)Q^\pi(s,a)$
- L1:手推贝尔曼期望方程(三步:展开/拆期望/递归)
- L2:说出贝尔曼最优方程为什么非线性、怎么保证收敛
- L2:能比较策略评估与值迭代的更新式差异
- L2:现场手写一个 3×3 网格的值迭代(10 分钟内)
下一篇
01-动态规划与表格方法:策略迭代 / 价值迭代的工程细节 + 收敛性实验。
# trans_table.py —— 打印完整转移表: 每个(s,a)的后继与奖励
import numpy as np

SIZE, N = 4, 16
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
GOAL = N - 1

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def successors(s, a):
    """返回 [(s_next, reward)], 确定性转移"""
    if s == GOAL:
        return [(GOAL, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(s, -1.0)]
    s2 = nr * SIZE + nc
    return [(GOAL, 10.0)] if s2 == GOAL else [(s2, -1.0)]

print('状态 s | 动作 a | 后继 s′(prime) | 奖励 r   (部分状态示例)')
print('-' * 48)
for s in [0, 1, 5, 14]:
    for a in range(4):
        for s2, r in successors(s, a):
            print(f'  {s:3d}  |   {a}    |   {s2:3d}   |  {r:5.1f}')
print()
print('撞墙演示: 状态 0(左上角) 执行"上"(a=0) → 自环 0, 奖励 -1')
print('终态 15 是吸收态: 任何动作都留在 15, 奖励 0')
状态 s | 动作 a | 后继 s′(prime) | 奖励 r   (部分状态示例)
------------------------------------------------
    0  |   0    |     0   |   -1.0
    0  |   1    |     4   |   -1.0
    0  |   2    |     0   |   -1.0
    0  |   3    |     1   |   -1.0
    1  |   0    |     1   |   -1.0
    1  |   1    |     5   |   -1.0
    1  |   2    |     0   |   -1.0
    1  |   3    |     2   |   -1.0
    5  |   0    |     1   |   -1.0
    5  |   1    |     9   |   -1.0
    5  |   2    |     4   |   -1.0
    5  |   3    |     6   |   -1.0
   14  |   0    |    10   |   -1.0
   14  |   1    |    14   |   -1.0
   14  |   2    |    13   |   -1.0
   14  |   3    |    15   |   10.0

撞墙演示: 状态 0(左上角) 执行"上"(a=0) → 自环 0, 奖励 -1
终态 15 是吸收态: 任何动作都留在 15, 奖励 0
11.1 马尔可夫性质精讲:这个假设到底"贵不贵"(🔴 概念辨析)¶
本节导读:所有公式都依赖"状态包含全部决策信息"。这一节把"什么算好状态、 什么算坏状态"讲清楚——很多算法失效的根因是状态定义漏了信息。
1. 直觉引入:医疗诊断:医生只看"当前化验单"(状态)就能决策吗? 如果化验单漏了关键病史,只看当下就会误诊——状态不完整,决策必错。
2. 形式化:马尔可夫性质要求 $$P\big(s_{t+1}\mid s_t, a_t, s_{t-1}, a_{t-1}, \dots\big) = P\big(s_{t+1}\mid s_t, a_t\big)$$ 含义:给定当前状态+动作,历史不提供额外信息。
3. 三种破局姿势(推导级理解):
- 状态足够(满足性质):直接建模 MDP
- 状态不够但可补:把"最近 k 步历史"也并进状态(k 阶马尔可夫 → 状态膨胀)
- 状态不够且补不了:POMDP(§18)——需要"信念状态"(对隐藏状态的分布)
4. 例子(判断练习):掷骰子游戏,状态 = "上一局的点数"。
- 若下一局点数独立于历史 → 马尔可夫成立
- 若点数依赖"过去两局的和" → 单状态漏信息,需把上一局也纳入状态 本篇 code cell 有 3 个判断题,对应这三种情况。
5. 易错点:
- "马尔可夫"不是环境的固有属性,而是状态定义的属性——同一环境, 状态定义变,性质变
- 深度 RL 里"帧堆叠"(stack k 帧)就是在手工补历史信息,保持近似马尔可夫性
6. 面试问法:"为什么 RL 要马尔可夫假设?" → "保证最优决策只依赖当前 状态(贝尔曼方程递归的前提);状态定义是建模自由,建模者要负责把信息补齐。"
11. 马尔可夫性质判定练习(🔴 概念辨析)¶
三问自测¶
- 棋盘游戏中只看当前棋面能否做决策? → 能:棋面包含全部信息 → 马尔可夫
- 股市只看当前价格做决策? → 不能:价格历史(趋势/波动率)有信息 → 非马尔可夫,需把历史特征(MA5/波动率)并入状态
- 机器人只看当前关节角能否控制? → 通常不能:还需要速度(一阶历史)→ 状态应扩为 (位置, 速度)
工程上怎么"马尔可夫化"(背)¶
把记忆变成状态的一部分:
非马尔可夫:  S_t = 观测 o_t
马尔可夫化:  S_t = (o_t, o_{t-1})      → 一阶记忆
             S_t = (o_t, o_{t-1}, ..., o_{t-k})  → k 阶记忆
             S_t = RNN 隐状态            → 无限记忆近似
面试金句:POMDP 的"信念状态"就是马尔可夫化的最一般形式——把所有可能真实状态的概率分布 $b(s)$ 当状态,转移是贝叶斯更新。
# markov_check.py —— 判断给定"状态定义"是否满足马尔可夫性(工程练习)
# 规则: 若下一状态转移只依赖当前状态 → 是马尔可夫

def is_markov(state_desc, needs_history):
    """needs_history=True 表示必须依赖历史才能预测"""
    return not needs_history

cases = [
    ('棋面(ChessBoard)', '预测合法走法', False),        # 棋面含全部信息
    ('仅当前股价', '预测明天涨跌', True),               # 需要趋势
    ('(位置, 速度) 的机器人', '预测下一秒位置', False),  # 牛顿力学一阶马尔可夫
    ('LLM 当前 token 序列', '预测下一个 token', False),  # 序列即历史压缩
]
for state, pred, needs in cases:
    mk = is_markov(state, needs)
    print(f'{state:<22} 预测任务: {pred:<14} → 马尔可夫: {"是" if mk else "否"}')

print()
print('结论: 状态定义得够不够"全",决定了马尔可夫性是否成立')
print('RL 工程的核心手艺之一: 把状态设计到"当前即可决策"')
棋面(ChessBoard)         预测任务: 预测合法走法         → 马尔可夫: 是
仅当前股价                  预测任务: 预测明天涨跌         → 马尔可夫: 否
(位置, 速度) 的机器人          预测任务: 预测下一秒位置        → 马尔可夫: 是
LLM 当前 token 序列        预测任务: 预测下一个 token    → 马尔可夫: 是

结论: 状态定义得够不够"全",决定了马尔可夫性是否成立
RL 工程的核心手艺之一: 把状态设计到"当前即可决策"
12. 回报计算手练习题(🔴 计算基本功)¶
题 1¶
轨迹奖励 $[-1, -1, +10]$,$\gamma=0.9$,求 $G_0$:
$$G_0 = -1 + 0.9\times(-1) + 0.9^2\times 10 = -1 - 0.9 + 8.1 = 6.2$$
题 2(陷阱题)¶
$\gamma=0.5$,同样轨迹:$G_0 = -1 + 0.5\times(-1) + 0.25\times 10 = 1.0$——注意 γ 小会让后期大奖励大幅缩水。
题 3¶
无限长常量奖励 $r$:$G = r + \gamma r + \gamma^2 r + \cdots = \dfrac{r}{1-\gamma}$($\gamma<1$)。
- $r=1, \gamma=0.9$ → $G=10$;$\gamma=0.5$ → $G=2$——γ 越大"同样奖励流"越值钱。
# return_math.py —— 三题计算 + 几何级数收敛验证
import numpy as np

def G(rewards, gamma, t=0):
    return sum(gamma ** k * r for k, r in enumerate(rewards[t:]))

print('题1: [-1,-1,+10], γ=0.9 → G0 =', round(G([-1, -1, 10], 0.9), 3), '(手算 6.2)')
print('题2: [-1,-1,+10], γ=0.5 → G0 =', round(G([-1, -1, 10], 0.5), 3), '(手算 1.0)')
print()

# 题3: 无限常量奖励流的收敛: 前 N 项部分和逼近 r/(1-γ)
gamma = 0.9
r = 1.0
true = r / (1 - gamma)
partial = 0.0
for k in range(50):
    partial += gamma ** k * r
print(f'题3: r=1, γ=0.9 → 理论 {true:.3f}, 前50项部分和 {partial:.6f}, 误差 {abs(partial-true):.2e}')
print()
print('验证: γ<1 时部分和以指数速度逼近极限 —— 这就是折扣保证收敛的底层原因')
# 若 γ=1: 部分和线性增长不收敛
print('若 γ=1: 前 100 项和 =', sum(1.0 for _ in range(100)), '(线性增长, 不发散约束则无定义)')
题1: [-1,-1,+10], γ=0.9 → G0 = 6.2 (手算 6.2)
题2: [-1,-1,+10], γ=0.5 → G0 = 1.0 (手算 1.0)

题3: r=1, γ=0.9 → 理论 10.000, 前50项部分和 9.948462, 误差 5.15e-02

验证: γ<1 时部分和以指数速度逼近极限 —— 这就是折扣保证收敛的底层原因
若 γ=1: 前 100 项和 = 100.0 (线性增长, 不发散约束则无定义)
13. V 与 Q 的数值互验(🔴 用代码证明公式)¶
要验证的两条关系¶
$$Q^{\pi}(s,a) = \sum_{s'} P(s'|s,a)\left[ R + \gamma V^{\pi}(s') \right], \qquad V^{\pi}(s) = \sum_a \pi(a|s) Q^{\pi}(s,a)$$
- 由 $V^\pi$ 可推出 $Q^\pi$(第一条)
- 由 $Q^\pi$ 加权可得 $V^\pi$(第二条)
- 两条互相咬合 → 就是贝尔曼方程的两个视角
为什么这个关系重要(面试)¶
"有了 $V$ 想得到 $Q$"只用一步环境查询(模型已知时);"有了 $Q$ 想得到 $V$"只用策略加权。在做 policy evaluation 时它们等价,但 Q 表更耗内存(多一个动作维度)。
# vq_relation.py —— 数值验证 V-Q 互推关系
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

# 已知 V^π(从 01 篇的策略评估得来; 这里直接迭代到收敛)
pi = np.full((N, 4), 0.25)
V = np.zeros(N)
for _ in range(500):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2]) for a in range(4) for p, s2, r in trans(s, a))
    V = Vn

# ① 由 V 推 Q
Q = np.zeros((N, 4))
for s in range(N):
    for a in range(4):
        Q[s, a] = sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a))

# ② 由 Q 加权推 V
V_rebuilt = (pi * Q).sum(axis=1)

print('关系验证: max|V - ΣπQ| =', float(np.max(np.abs(V - V_rebuilt))))
print('(< 1e-8 即两条关系完全成立)')
print()
print('示例: 状态 0 的四个 Q 值:', np.round(Q[0], 3))
print('      状态 0 的 V^π =', round(V[0], 3), '= 0.25 × ΣQ ✓')
关系验证: max|V - ΣπQ| = 0.0
(< 1e-8 即两条关系完全成立)

示例: 状态 0 的四个 Q 值: [-8.722 -8.438 -8.722 -8.438]
      状态 0 的 V^π = -8.58 = 0.25 × ΣQ ✓
# bellman_linsolve.py —— 迭代解 vs 线性方程组精确解对比
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

pi = np.full((N, 4), 0.25)

# 组装: V = R_π + γ P_π V  =>  (I - γP)V = R
P = np.zeros((N, N))
R = np.zeros(N)
for s in range(N):
    for a in range(4):
        for p, s2, r in trans(s, a):
            P[s, s2] += pi[s, a] * p
            R[s] += pi[s, a] * p * r

# 迭代解
V_it = np.zeros(N)
for _ in range(500):
    V_it = R + GAMMA * P @ V_it

# 精确解
V_exact = np.linalg.solve(np.eye(N) - GAMMA * P, R)

print('迭代解 vs 精确解 最大误差:', float(np.max(np.abs(V_it - V_exact))))
print('精确解 V(起点):', round(V_exact[0], 6))
print('迭代解 V(起点):', round(V_it[0], 6))
print()
print('含义: 策略评估 = 解线性方程组; 迭代法(≈Jacobi)对大规模更可行')
迭代解 vs 精确解 最大误差: 3.552713678800501e-15
精确解 V(起点): -8.579748
迭代解 V(起点): -8.579748

含义: 策略评估 = 解线性方程组; 迭代法(≈Jacobi)对大规模更可行
# gamma_sweep.py —— γ 扫描: 起点价值与最优策略随 γ 变化
import numpy as np

SIZE = 4
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
ACTIONS = ['↑', '↓', '←', '→']

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a, gamma):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def value_iteration(gamma):
    V = np.zeros(N)
    for _ in range(1000):
        Vn = np.zeros(N)
        for s in range(N):
            best = max(sum(p * (r + gamma * V[s2]) for p, s2, r in trans(s, a, gamma)) for a in range(4))
            Vn[s] = best
        if np.max(np.abs(Vn - V)) < 1e-9:
            V = Vn
            break
        V = Vn
    # 恢复策略并测量路径长度(从0沿贪心箭头走)
    pol = []
    for s in range(N):
        q = [sum(p * (r + gamma * V[s2]) for p, s2, r in trans(s, a, gamma)) for a in range(4)]
        pol.append(int(np.argmax(q)))
    s, path_len = 0, 0
    seen = set()
    while s != N - 1 and s not in seen and path_len < 100:
        seen.add(s)
        s = trans(s, pol[s], gamma)[0][1]   # 沿贪心动作转移(确定性环境唯一后继)
        path_len += 1
    return V[0], path_len

print(f'{"γ":<6}{"V*(0,0)":>12}{"贪心路径步数":>12}')
for gamma in [0.1, 0.5, 0.9, 0.99]:
    v0, plen = value_iteration(gamma)
    print(f'{gamma:<6}{v0:>12.3f}{plen:>12}')
print()
print('观察: γ=0.1 时 V* 最小(远期+10 几乎被抹掉); γ→0.99 时 V* 最大且路径趋于最短路')
γ          V*(0,0)      贪心路径步数
0.1         -1.111           6
0.5         -1.625           6
0.9          1.810           6
0.99         4.609           6

观察: γ=0.1 时 V* 最小(远期+10 几乎被抹掉); γ→0.99 时 V* 最大且路径趋于最短路
# stochastic_grid.py —— 随机转移网格 + 值迭代求解最优策略
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans_stochastic(s, a, p_slip=0.2):
    """p_slip 概率向垂直方向随机偏转"""
    if s == N - 1:
        return [(1.0, s, 0.0)]
    out = []
    perp = [(a + 1) % 2 * 2, a % 2 * 2 + (1 if a % 2 == 0 else -1)]  # 近似垂直的两个方向
    acts = [a] * 3 + [perp[0]] + [perp[1]]          # 80% 直行, 20% 分给垂直
    probs = [0.8] + [0.1, 0.1] if False else [0.8, 0.1, 0.1]
    # 简化: 直行 0.8, 两个垂直候选各 0.1 (若候选不存在则并入自环)
    candidates = [a, (a + 1) % 4, (a + 3) % 4]
    for cand, p in zip(candidates, [0.8, 0.1, 0.1]):
        r, c = divmod(s, SIZE)
        dr, dc = MOVE[cand]
        nr, nc = r + dr, c + dc
        if not in_bounds(nr, nc):
            out.append((p, s, -1.0))                # 撞墙自环
        else:
            s2 = nr * SIZE + nc
            out.append((p, N - 1, 10.0) if s2 == N - 1 else (p, s2, -1.0))
    return out

V = np.zeros(N)
for _ in range(1000):
    Vn = np.zeros(N)
    for s in range(N):
        best = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans_stochastic(s, a)) for a in range(4))
        Vn[s] = best
    if np.max(np.abs(Vn - V)) < 1e-9:
        V = Vn
        break
    V = Vn

ACTIONS = ['↑', '↓', '←', '→']
print('随机转移(直行80%/偏转20%)下的最优价值 V*:')
print(np.round(V.reshape(SIZE, SIZE), 2))
print()
print('与确定性版对比: 角落价值更低(噪声把撞墙概率放大了)')
print('最优策略依然指向终点, 但会避开"贴墙走"的路线(贴墙更容易被噪声撞墙)')
随机转移(直行80%/偏转20%)下的最优价值 V*:
[[-0.83  0.44  2.05  3.93]
 [ 0.44  1.77  3.73  6.09]
 [ 2.05  3.73  6.08  8.9 ]
 [ 3.93  6.09  8.9   0.  ]]

与确定性版对比: 角落价值更低(噪声把撞墙概率放大了)
最优策略依然指向终点, 但会避开"贴墙走"的路线(贴墙更容易被噪声撞墙)
17. 价值热力图可视化(🟢 直观理解 V*)¶
用 matplotlib 把最优价值画成热力图:颜色越亮 = 价值越高。视觉上一眼看出"价值从终点向四周衰减"。
本仓库统一自绘 matplotlib 图(外部图片源不可达),中文字体 SimHei/Microsoft YaHei。
# value_heatmap.py —— V* 热力图 + 最优策略箭头叠加
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

V = np.zeros(N)
for _ in range(1000):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
    if np.max(np.abs(Vn - V)) < 1e-9:
        V = Vn
        break
    V = Vn

# 最优动作箭头方向
arrows = []
for s in range(N):
    q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
    a = int(np.argmax(q))
    arrows.append(MOVE[a])
arrows = np.array(arrows)

fig, ax = plt.subplots(figsize=(4.6, 4.6), dpi=150)
im = ax.imshow(V.reshape(SIZE, SIZE), cmap='viridis', origin='upper')
for r in range(SIZE):
    for c in range(SIZE):
        s = r * SIZE + c
        if s == N - 1:
            ax.text(c, r, '★', ha='center', va='center', fontsize=16, color='white')
            continue
        dr, dc = arrows[s]
        ax.annotate('', xy=(c + dc * 0.32, r + dr * 0.32),
                    xytext=(c - dc * 0.18, r - dr * 0.18),
                    arrowprops=dict(arrowstyle='->', color='white', lw=1.4))
        ax.text(c, r + 0.38, f'{V[s]:.1f}', ha='center', va='center',
                fontsize=7, color='white', alpha=0.9)
ax.set_title('4×4 网格最优价值热力图 + 最优策略箭头', fontsize=11)
fig.colorbar(im, ax=ax, fraction=0.046)
plt.tight_layout()
plt.savefig('rl_00_heatmap.png', dpi=150)
plt.show()
print('已保存 rl_00_heatmap.png(价值热力图)')
print('终点价值最高, 向角落递减; 箭头全部指向价值上升方向')
已保存 rl_00_heatmap.png(价值热力图)
终点价值最高, 向角落递减; 箭头全部指向价值上升方向
C:\Users\24260\AppData\Local\Temp\ipykernel_49628\3230664010.py:64: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
18.1 POMDP 精讲:看不见的世界怎么决策(🔴 进阶概念)¶
本节导读:真实系统几乎都"看不全"(传感器噪声、遮挡、部分状态)。POMDP 把"观测"和"真实状态"分开——决策不再是状态函数,而是"信念"的函数。
1. 直觉引入:捉迷藏:你看不见对方(状态),只有听到的脚步声(观测)。 你会对"他在哪"保持一个概率分布(信念),每次听到声音更新它。 POMDP 就是在"信念空间"里做决策。
2. 形式定义:POMDP = MDP + 观测模型,写作七元组 $$\langle \mathcal{S}, \mathcal{A}, \mathcal{P}, \mathcal{R}, \Omega, \mathcal{O}, \gamma\rangle$$
- $\Omega$:观测集合;$\mathcal{O}(o\mid s', a)$:在 $s'$、动作 $a$ 后看到 $o$ 的概率
- 策略:$\pi(b_t)$ 是信念 $b_t$(对状态的分布)的函数,不是 $s_t$ 的函数
3. 关键推导(信念更新,贝叶斯滤波): $$b'(s') \propto \mathcal{O}(o\mid s',a)\sum_{s} P(s'\mid s,a)\, b(s)$$ "先按转移预测 → 再用观测修正",即贝叶斯公式的两步。
4. 为什么 POMDP 难(复杂度直觉):
- 状态空间:$|S|$;信念空间:$|S|-1$ 维连续单纯形
- 精确最优策略可以任意复杂(分段线性),一般用近似/采样(如粒子滤波)
- LLM 场景常见:对话历史=观测序列,用户意图=隐藏状态
5. 易错点:
- POMDP 的最优策略是信念的函数,不是观测的函数(观测不够!)
- 不要和"状态随机性"混淆:随机转移仍在 MDP 内;POMDP 多的是看不见
6. 面试问法:"MDP 和 POMDP 区别?" → "MDP 状态全可见;POMDP 只能看 观测,策略基于信念,信念用贝叶斯更新。"
18. POMDP:状态观测不到的 MDP(🟡 了解概念)¶
定义¶
部分可观测马尔可夫决策过程 = MDP + 观测模型 $O(o|s',a)$:
- 智能体看不到真实状态 $s$,只能看到观测 $o$
- 例:自动驾驶只有传感器数据(观测),真实"路面状态"不可见
解法核心(背一句话)¶
用信念状态 $b(s) = P(S_t = s | 历史)$ 替代真实状态,转移 = 贝叶斯更新:
$$b'(s') \propto O(o|s',a) \sum_s P(s'|s,a) b(s)$$
为什么难¶
信念空间是连续概率分布(无限维)→ 精确求解 PSPACE-hard;工程上用近似(粒子滤波/DRQN/RNN 隐状态)。
面试金句:"RL 处理部分可观测的标准套路是 ①把状态定义成历史特征 ②用 RNN 隐状态 ③用信念状态做规划"。
19.1 状态爆炸精讲:为什么表格方法走不远(🔴 规模直觉)¶
本节导读:价值函数 $V(s)$ 要对每个状态存一个数。状态数一涨, 表格直接炸。理解"组合爆炸"是理解 DQN(函数近似)动机的必经之路。
1. 直觉引入:井字棋 9 格约 5 千个局面;国际象棋约 $10^{43}$; 围棋约 $10^{170}$(比宇宙原子数 $10^{80}$ 还多)。给每个局面存一个数? 不可能。但围棋仍能下——靠"相似局面共享参数"(函数近似)与搜索。
2. 组合爆炸公式: $$\text{状态数} = \text{每维取值数}^{\text{维度数}}$$
| 场景 | 维度 | 状态数 | 表格 V 表 |
|---|---|---|---|
| 4×4 网格 | 2 维 × 4 | 16 | 16 个数 |
| 20×20 网格 | 2 维 × 20 | 400 | 400 |
| 围棋 | ~361 维 × ~2 | $10^{170}$ | 装不下 |
| 连续控制(机器人) | 关节角度/力矩连续 | ∞ | 表格不存在 |
3. 为什么"函数近似"是解药(推导级理解):
- 表格:每个状态独立一个参数 → 参数 = 状态数
- 网络:$V_\theta(s)$ 用共享参数 θ 概括所有状态 → 参数 << 状态数
- 代价:相邻状态会互相干扰(泛化是把双刃剑),这是 DQN 一章的主题
4. 例子:自动驾驶状态 = 位置+速度+朝向+前车距离(连续值)。 表格要离散化 → 精度与规模矛盾;网络直接吃连续输入。
5. 易错点:
- "状态多"和"维度高"是两回事:16 格不多,但维度一高指数爆炸
- 表格 V 内存 $O(|S|)$,表格 Q 是 $O(|S||A|)$——别忘了乘动作数
6. 面试问法:"为什么大问题不用 Q 表?" → "状态数随维度指数爆炸、 表格 Q 需要 O(|S||A|) 存储、无法泛化;函数近似用共享参数解决,代价是 收敛性和稳定性变难(DQN 三件套的由来)。"
# state_explosion.py —— 状态爆炸数字演示
import math

def log10_space(grid_size):
    """粗略估: 每像素 256 灰度, 状态数 = 256^(像素数)"""
    return grid_size * grid_size * math.log10(256)

for grid in [4, 21, 84, 210]:
    e = log10_space(grid)
    print(f'Atari 画面 {grid}x{grid}: 状态数 ≈ 10^{e:.0f}  (宇宙原子 ≈ 10^80)')
print()
print('结论: 16 个格子能画表格, 21x21 已不可能, 84x84 完全是天文数字')
print('→ 深度 RL 用神经网络把"输入画面 → 价值"泛化出来, 而不是枚举状态')
Atari 画面 4x4: 状态数 ≈ 10^39  (宇宙原子 ≈ 10^80)
Atari 画面 21x21: 状态数 ≈ 10^1062  (宇宙原子 ≈ 10^80)
Atari 画面 84x84: 状态数 ≈ 10^16993  (宇宙原子 ≈ 10^80)
Atari 画面 210x210: 状态数 ≈ 10^106203  (宇宙原子 ≈ 10^80)

结论: 16 个格子能画表格, 21x21 已不可能, 84x84 完全是天文数字
→ 深度 RL 用神经网络把"输入画面 → 价值"泛化出来, 而不是枚举状态
20. 本章易错点补充(🔴)¶
- 回报是轨迹量、价值是期望量:G 是"这一条走出来的",V 是"平均意义上"——面试画图题常考
- V→Q 要查环境(用 P/R),Q→V 只要策略加权——别把两者来源搞混
- 折扣收敛 vs 无限回报:γ<1 才保证无限 horizon 收敛;γ=1 只对有限任务有定义
- 马尔可夫 ≠ 无记忆:是"状态已含足够记忆",不是"不需要记忆"
- 随机策略 vs 确定性策略:表格法两者都支持;随机策略对博弈环境(石头剪刀布)必要
- POMDP 不是"加了噪声的 MDP":是观测缺失,解法是信念状态而不是加大状态
21. 本章面试追问扩展(🟡 进阶 8 问)¶
- Q: γ 调大会有什么副作用? A: 价值更长远但收敛更慢、方差更大;无限 horizon 需 γ<1。
- Q: 值迭代每轮复杂度? A: O(|S|²|A|)(每个 (s,a) 遍历所有后继),实际用稀疏转移优化。
- Q: 状态转移概率未知怎么用 V→Q? A: 采样估计:$Q(s,a)\approx \frac{1}{N}\sum [r + \gamma V(s')]$(用经验平均)。
- Q: 为什么叫"模型"? A: P 和 R 就是环境模型;model-based = 用它们做规划,model-free = 不学它们。
- Q: 回报 G 的方差为什么大? A: 轨迹随机性(随机策略 + 随机转移)全部累积进 G。
- Q: 半马尔可夫(SMDP)? A: 动作持续随机时长才结束(时间抽象);选项(options)框架。
- Q: 状态聚合/抽象? A: 把相似状态合并成抽象状态降维(如 tile coding);是表格到函数近似的桥梁。
- Q: 多步回报 G_{t:t+n}? A: n 步截断回报 = n 步真实奖励 + 第 n+1 步价值估计;MC 与 TD 的统一视角。
22. 自测清单(L3 冲刺)¶
- L3:能现场推出 $Q^\pi$ 与 $V^\pi$ 的互推公式
- L3:解释"策略评估 = 解线性方程组 (I-γP)V=R"并说明迭代法对应 Jacobi
- L3:画出状态爆炸量级对比(棋盘/Atari/围棋)
- L3:说出 POMDP 的信念状态更新式
- L3:γ 敏感性实验的预期结论随口能讲
# bellman_contraction.py —— 贝尔曼算子的收缩性数值演示(Banach 不动点)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def bellman_op(V):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
    return Vn

# 取两个初始价值, 迭代一步看距离变化: ||T(V1)-T(V2)|| <= γ·||V1-V2||
rng = np.random.RandomState(0)
V1 = rng.rand(N) * 10
V2 = rng.rand(N) * 10
for step in range(1, 4):
    d_before = np.max(np.abs(V1 - V2))
    V1, V2 = bellman_op(V1), bellman_op(V2)
    d_after = np.max(np.abs(V1 - V2))
    print(f'第{step}步: 距离 {d_before:.3f} -> {d_after:.3f}  (收缩系数≤γ={GAMMA})')

print()
print('→ 贝尔曼最优算子 T 是 γ-收缩映射 → 迭代必收敛到唯一 V*')
第1步: 距离 8.454 -> 6.184  (收缩系数≤γ=0.9)
第2步: 距离 6.184 -> 5.566  (收缩系数≤γ=0.9)
第3步: 距离 5.566 -> 5.009  (收缩系数≤γ=0.9)

→ 贝尔曼最优算子 T 是 γ-收缩映射 → 迭代必收敛到唯一 V*
# vq_inequality.py —— 数值验证: max_a Q(s,a) >= V(s)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

# 随机策略的 V 与 Q
pi = np.full((N, 4), 0.25)
V = np.zeros(N)
for _ in range(400):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                    for a in range(4) for p, s2, r in trans(s, a))
    V = Vn

Q = np.zeros((N, 4))
for s in range(N):
    for a in range(4):
        Q[s, a] = sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a))

ok = all(np.max(Q[s]) >= V[s] - 1e-9 for s in range(N))
print(f'所有状态满足 max_a Q(s,a) >= V(s) ? {ok}')
print('差值示例(状态0): maxQ-V =', round(np.max(Q[0]) - V[0], 4))
print('→ 价值与动作价值的不等式: 按更好动作走至少不比平均差')
所有状态满足 max_a Q(s,a) >= V(s) ? True
差值示例(状态0): maxQ-V = 0.142
→ 价值与动作价值的不等式: 按更好动作走至少不比平均差
25. 本章终极易错点(🔴 考前 10 分钟看)¶
- γ=0 时 V(s)=E[R] 与价值无关——多臂老虎机问题
- 回报 G 与累计折扣 Σγ^k r 是一回事——别在计算里重复折扣
- 贝尔曼方程适用任意策略(期望式);只有最优方程里是 max
- 状态转移概率是对"环境"的建模,不是策略——策略是智能体选择动作的规则
- V 唯一、最优策略不唯一*(多个动作同样最优)
- 表格 vs 函数近似的分水岭:能否枚举所有状态
26. 自测清单(00 篇终版)¶
- L1-L3 全部旧条目可背写
- 新增:能解释贝尔曼算子收缩性的一句话证明
- 新增:随手画一个 3 状态 MDP 并手算一步 V 更新
- 新增:说出"为什么要折扣"的 4 个理由
27. 本章公式总表(🔴 考前速背)¶
| 概念 | 公式 |
|---|---|
| 回报 | $G_t = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1}$ |
| 状态价值 | $V^{\pi}(s)=\mathbb{E}_\pi[G_t\mid S_t=s]$ |
| 动作价值 | $Q^{\pi}(s,a)=\mathbb{E}_\pi[G_t\mid S_t=s,A_t=a]$ |
| V↔Q | $V^{\pi}(s)=\sum_a \pi(a\mid s)Q^{\pi}(s,a)$ |
| 贝尔曼期望 | $V^{\pi}(s)=\sum_a\pi(a\mid s)\sum_{s'}P(s'\mid s,a)[R+\gamma V^{\pi}(s')]$ |
| 贝尔曼最优 | $V^*(s)=\max_a\sum_{s'}P(s'\mid s,a)[R+\gamma V^*(s')]$ |
| 最优策略 | $\pi^*(a\mid s)=\mathbb{1}\{a=\arg\max_a Q^*(s,a)\}$ |
考前把这张表默写 3 遍,MDP 篇就过关了。
28. 与最优控制/强化学习家族的关系图(🟢 知识面)¶
动态规划(Bellman) ── 连续版 → HJB 方程(最优控制)
        │
        ├── 有模型表格: 策略/值迭代(01)
        ├── 无模型表格: MC/TD/Q-learning(02/03)
        └── 函数近似:   DQN/PPO/SAC(04-06)
强化学习 = 动态规划 + 蒙特卡洛 + 函数近似 三线合流
面试若问"RL 的数学根基",答:马尔可夫 + 贝尔曼最优性 + 大数定律(采样估计),三句话收尾。
# mdp_manual_exercise.py —— 手动小练习: 3 状态 MDP 一步 V 更新(带答案校验)
import numpy as np

# 3 状态 MDP: 状态2 是吸收(奖励0); 状态0/1 动作0->状态1(奖励1), 动作1->状态2(奖励5)
# V 初始为 [0,0,0], 计算一步策略评估(确定性策略: 全部动作0)
GAMMA = 0.9
R = {0: 1.0, 1: 1.0, 2: 0.0}
next_s = {0: 1, 1: 2, 2: 2}

V = np.zeros(3)
for step in range(3):
    Vn = np.array([R[s] + GAMMA * V[next_s[s]] for s in range(3)])
    print(f'第{step+1}步: V = {np.round(Vn, 3)}')
    V = Vn

print()
print('手算: V0(1) = 1 + 0.9*V1(0) = 1; V0(2) = 1+0.9*1 = 1.9; V0(3)=1+0.9*1.9=2.71')
print('→ 与程序一致 → 贝尔曼一步更新的手感建立')
第1步: V = [1. 1. 0.]
第2步: V = [1.9 1.  0. ]
第3步: V = [1.9 1.  0. ]

手算: V0(1) = 1 + 0.9*V1(0) = 1; V0(2) = 1+0.9*1 = 1.9; V0(3)=1+0.9*1.9=2.71
→ 与程序一致 → 贝尔曼一步更新的手感建立
29. 回看:从"环境"到"求解"的完整闭环(🔴 串讲)¶
环境(4×4网格) → MDP 五元组(S,A,P,R,γ) → 价值函数(V/Q) → 贝尔曼方程
  → 迭代求解(值迭代/策略评估) → 最优策略 π* → 用 ε-greedy 部署
本篇完成后你应该能:给出任意网格→写出 MDP→手算 V/Q→跑值迭代→画出最优路径。这一整条流水线是 RL 岗位面试的第一问。
30. 变种模型谱系:MRP / MDP / POMDP / BMDP(🔴 推导关系)¶
三步演进(背推导链)¶
MRP  : <S, P, R, γ>                    无动作, 只做预测
MDP  : <S, A, P, R, γ>   MRP + 动作   智能体可决策
BMDP : <S, A, Q>         已知 Q 表     查表即最优
POMDP: <S, A, O, P, R, γ>  部分可观    状态不可见, 用信念状态
关键推导:MDP → 策略诱导的 MRP¶
给定策略 $\pi$,把"状态-动作"揉进状态转移:
$$P^{\pi}(s' \mid s) = \sum_a \pi(a \mid s) P(s' \mid s, a), \qquad R^{\pi}(s) = \sum_a \pi(a \mid s) R(s, a)$$
推导一步(背):有了 $\langle S, P^{\pi}, R^{\pi}, \gamma \rangle$,这就是一个 MRP——所以 $V^{\pi}$ 满足 MRP 的贝尔曼方程。**"策略的价值 = 该策略诱导出的 MRP 的价值"**是整条谱系的枢纽。
31. 贝尔曼方程逐步推导(🔴 面试手推模板)¶
出发定义¶
$$V^{\pi}(s) = \mathbb{E}_{\pi}\left[ G_t \mid S_t = s \right], \qquad G_t = R_{t+1} + \gamma G_{t+1}$$
四步展开(背)¶
① 代入回报递归:  V(s) = E[ R_{t+1} + γ·G_{t+1} | S_t = s ]
② 拆期望:       = E[ R_{t+1} | s ] + γ·E[ G_{t+1} | s ]
                    a           a'
③ 对内层期望按动作展开(策略 π):
       = Σ_a π(a|s) R(s,a) + γ·Σ_a π(a|s) Σ_s' P(s'|s,a) · E[G_{t+1}|s']
④ 识别 V(s'):   = Σ_a π(a|s) [ R(s,a) + γ Σ_s' P(s'|s,a) V(s') ]   ∎
易错点:第 ③ 步的 $E[G_{t+1}|s']$ 在马尔可夫性下等于 $V(s')$——这一步去掉条件 $S_t=s$ 是"马尔可夫性"的直接使用,面试官会盯着这里问。
# fig_discount.py —— 过程图①: 折扣回报的权重衰减(不同 γ)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False
import os

steps = np.arange(0, 20)
fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
for gamma, c in [(0.0, 'gray'), (0.5, 'orange'), (0.9, 'green'), (0.99, 'blue')]:
    ax.plot(steps, gamma ** steps, 'o-', ms=4, label=f'γ={gamma}', color=c)
ax.set_xlabel('未来时刻 t'); ax.set_ylabel('γ^t(奖励权重)')
ax.set_title('折扣因子 γ 对远期奖励权重的衰减(推导 G_t 的几何权重)')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
import os as _os
out = _os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if _os.path.basename(_os.getcwd()) == '教学':
    out = _os.path.join(_os.getcwd(), 'images')
_os.makedirs(out, exist_ok=True)
fig.savefig(_os.path.join(out, 'bellman_discount.png'), dpi=150)
print('已保存 images/bellman_discount.png')
plt.close(fig)
plt.show()
已保存 images/bellman_discount.png
C:\Users\24260\AppData\Local\Temp\ipykernel_49628\4128801900.py:27: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# fig_contraction.py —— 过程图②: 贝尔曼算子收缩(不同初值收敛到同一 V*)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_b(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_b(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def bellman_op(V):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a))
                    for a in range(4))
    return Vn

rng = np.random.RandomState(0)
V_a, V_b = rng.rand(N) * 10, np.zeros(N)
trace_a, trace_b = [], []
for _ in range(40):
    trace_a.append(V_a[0]); trace_b.append(V_b[0])
    V_a, V_b = bellman_op(V_a), bellman_op(V_b)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
ax.plot(trace_a, 'o-', ms=3, label='初值A(随机)', color='purple')
ax.plot(trace_b, 's-', ms=3, label='初值B(全0)', color='teal')
ax.set_xlabel('迭代轮数 k'); ax.set_ylabel('V_k(状态0)')
ax.set_title('贝尔曼最优算子是 γ-收缩映射:不同初值收敛到同一 V*')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'bellman_contraction.png'), dpi=150)
print('已保存 images/bellman_contraction.png')
plt.close(fig)
plt.show()
已保存 images/bellman_contraction.png
C:\Users\24260\AppData\Local\Temp\ipykernel_49628\2094820525.py:57: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()