🔁 01 · 动态规划:策略评估 / 策略迭代 / 价值迭代¶
面试定位:DP 是**有模型(model-based)**的规划方法——已知 $P$ 和 $R$,不与环境交互,直接解贝尔曼方程。 本篇沿用 4×4 网格世界,手写三种算法并对比收敛速度。 标记:🔴 必背 / 🟡 掌握。
核心概念¶
(a) 🗂️ 动态规划三件套知识地图¶
这篇教你把贝尔曼方程真正"用起来":在已知环境模型的前提下,用策略评估、策略迭代、价值迭代三种表格算法一步步算出最优策略,并提炼出贯穿整个强化学习的广义策略迭代(GPI)框架。
flowchart TB
    Node1["🧠 DP 思想"]
    Node2["🧠 贝尔曼方程做引擎"]
    Node1 --> Node2
    Node2 --> Node3["🧠 策略评估"]
    Node3 --> Node4["🧠 策略改进定理"]
    Node4 --> Node5["🧠 策略迭代"]
    Node2 --> Node6["🧠 价值迭代"]
    Node5 --> Node7["🧠 广义策略迭代 GPI"]
    Node6 --> Node7
    Node7 --> Node8["🧠 收敛性:收缩算子"]
- 节点1(DP 思想):动态规划靠"最优子结构 + 重叠子问题"两大支柱:大问题的最优解由子问题的最优解组成,而且这些子问题被反复用到。名字里的 programming 其实是"填表计划",不是写代码。
- 节点2(贝尔曼方程做引擎):DP 的每一步更新都是把贝尔曼方程当"计算器":用旧价值算出新价值,反复套用。就像不停用同一台机器打磨一张估值表,直到它不再变化。
- 节点3(策略评估):给定一个策略 π,用同步迭代 V_{k+1}(s) = Σπ ΣP[R + γV_k] 算出每个状态的价值,也就是"这个策略值多少钱"。它回答"评价"问题:先把现状看清楚。
- 节点4(策略改进定理):对当前价值贪心选动作得到的新策略,不会比旧策略差,这是"改进"的合法性保证。就像考完试发现"每次都选分最高的选项"至少不会更糟。
- 节点5(策略迭代):把"评估到收敛"和"贪心改进"交替进行,直到策略不再变化,就得到最优策略。它是"评估 + 改进"两阶段循环的典型代表。
- 节点6(价值迭代):把评估里的 max 和迭代压成一步:每轮直接用 max 更新 V,不再等评估收敛。它是策略迭代的"加速版",也是实际最常用的表格算法。
- 节点7(广义策略迭代 GPI):把"评估"和"改进"两个圈看成交替进行的双人舞,不必等一个收敛再做另一个,边评估边改进也能收敛。这个框架贯穿之后所有强化学习算法,MC/TD/DQN/PPO 都是它的具体化。
- 节点8(收敛性:收缩算子):贝尔曼算子是一个 γ-收缩映射,每迭代一次两个估计之间的距离至少缩小 γ 倍,所以一定收敛,且 γ 越小收敛越快。这是"为什么反复迭代最后一定稳定"的数学保证。
0. 动态规划是什么:先把"思想"讲透(🔴 一切的起点)¶
很多资料一上来就扔公式,但 DP 的灵魂是一个思想 + 一个原理: 把难的问题拆成"同构的、更小的子问题",从最末端开始倒着填表。面试官问 "什么是动态规划",别背定义,按下面三层讲。
0.1 名字的来历:programming = 表格计划,不是写代码¶
Bellman 1950 年代提出,当时 "programming" 指"用表格做计划"(线性规划 programming 同义)。"dynamic" 指多阶段决策:问题天然被分成时间/阶段, 每阶段做一个决策。所以动态规划 = "把多阶段决策问题用表格逐阶段倒推"。 今天 RL 里的 DP 与算法课里的 DP(最长公共子序列等)是同一个骨架。
0.2 两大支柱:最优子结构 + 重叠子问题¶
| 支柱 | 含义 | 在 MDP 里的对应 |
|---|---|---|
| 最优子结构 | 整体最优 ⇒ 每个子问题也最优 | 最优策略的后缀策略也必须最优(否则可以替换整段变更好) |
| 重叠子问题 | 不同路径反复遇到同一个子状态 | 同一状态 $s$ 会被无数条轨迹经过,价值 $V(s)$ 只需算一次、处处复用 |
为什么 MDP 天然满足:状态有马尔可夫性(下一状态只依赖当前状态和动作, 与历史无关)。于是"从状态 $s$ 出发的最优价值"是一个自包含的子问题—— 它不关心你怎么走到 $s$,只关心 $s$ 之后的走向。这就是 DP 能"倒推"的前提。
0.3 最优性原理(Bellman Optimality Principle)——一句话 + 证明直觉¶
一个最优策略,从任何状态看过去,剩下的部分仍是最优策略。
证明直觉(反证法):设策略 $\pi^*$ 最优,但从某状态 $s$ 之后它不是最优 ——即存在另一个策略 $\pi'$,从 $s$ 出发能拿到更高的期望回报。那我们把 $\pi^*$ 从 $s$ 之后的这段换成 $\pi'$,整条轨迹的回报就变高了,这与 "$\pi^*$ 全局最优"矛盾。故最优策略的子策略必最优。
这个原理给了 DP 递归结构:最优价值 = 立即奖励 + 最优子问题价值。 策略评估/策略迭代/价值迭代全部建立在这条原理上。
0.4 动态规划 vs 分治 vs 贪心(面试三连问)¶
| 方法 | 分解方式 | 子问题是否重叠 | 是否回溯 |
|---|---|---|---|
| 分治 | 互不相交地切分 | 否 | 合并子结果 |
| 贪心 | 每步选当下最好 | 不回头 | 否(可能局部最优) |
| 动态规划 | 重叠地切分并复用 | 是 | 是(记住子问题答案) |
📌 一句话记忆:贪心"选了不回头",DP"回头把账算清再选"——DP 比贪心 多付出的代价(存表)换来的是一定的全局最优。
0.5 配图:贝尔曼方程的信息流¶
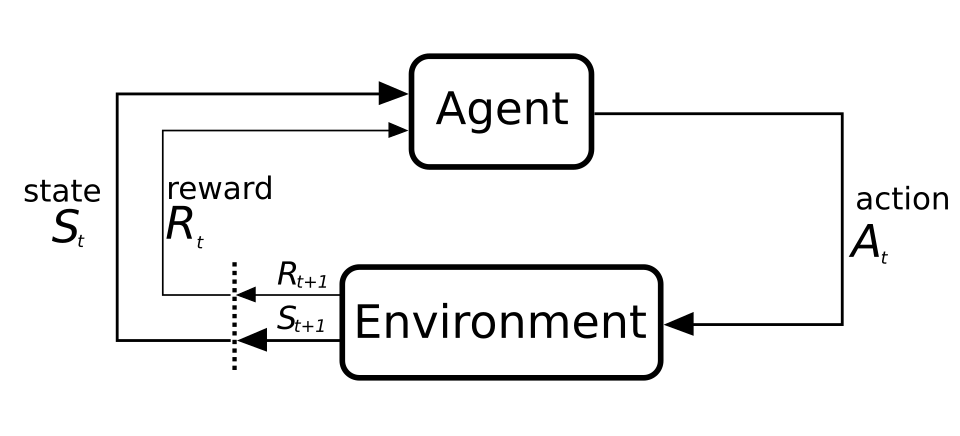
图注:贝尔曼方程的信息流——当前状态的价值由"立即奖励 + 下一个状态的价值" 递归构成(来源:Wikimedia Commons,CC BY-SA)。注意箭头方向:价值从后继 状态"流回"当前状态,这就是为什么 DP 要"从末端倒着算"。
0.2+ 手算演示:为什么必须"从末端倒着算"(🔴 直觉的根)¶
用经典的最短路径反例说明:贪心"第一次便宜就上"会选错,DP"倒着算"一定对。
问题:从 A 走到 F,共 3 段,每段有两个选择,成本如下表:
| 阶段 1(从 A) | 阶段 2 | 阶段 3(到 F) |
|---|---|---|
| A→B = 1(便宜!) | B→D = 5,B→E = 5 | D→F = 1,E→F = 1 |
| A→C = 3 | C→D = 1,C→E = 1 | D→F = 1,E→F = 1 |
贪心:第一步 A→B 只花 1,比 A→C(3)便宜 → 走 B → 第二步无论 D/E 都 5 → 第三步 1。总成本 1 + 5 + 1 = 7。
最优(DP 倒推):总成本 3 + 1 + 1 = 5(走 C→D→F)。 贪心第一步省了 2,第二步却多付 4——局部最优 ≠ 全局最优。
DP 倒推三步(注意顺序:先算末端,再往前):
- 最后一段:$V(D)=1$,$V(E)=1$(到 F 的最小成本,各为 1)
- 阶段 2:$V(B)=\min(5+V(D),\ 5+V(E))=6$; $V(C)=\min(1+V(D),\ 1+V(E))=2$(C 明显更优)
- 起点:$V(A)=\min(1+V(B),\ 3+V(C))=\min(7,\ 5)=5$ → 选 C
📌 三个要点:
- 每层都用"下一层已算好的最优"——$V(A)$ 一步到位是全局最优,不用回溯重试;
- "动态"的实操含义:价值表逐阶段刷新,先末端后起点;
- 记住数字 7 vs 5 这个反例,面试讲"贪心为什么不一定对"时直接用。
0.6 贝尔曼方程完整推导:从"回报定义"到"价值方程"(🔴 手推模板)¶
面试最怕的不是背公式,而是被问"贝尔曼方程怎么来的"。下面六步, 每一步都能讲、能写。
Step 1 · 定义回报(return):从时刻 $t$ 开始的折现累积奖励 $$G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1}$$
Step 2 · 回报的"提公因式"(关键一步):把第二项起的奖励整体提一个 $\gamma$: $$G_t = R_{t+1} + \gamma\big(R_{t+2} + \gamma R_{t+3} + \cdots\big) = R_{t+1} + \gamma\, G_{t+1}$$ ——一个状态的回报 = 立即奖励 + 折现的下一个状态的回报。这一步是全部 推导的种子:它把"无限求和"变成"一步 + 递归"。
Step 3 · 定义状态价值:策略 $\pi$ 下,从状态 $s$ 出发的期望回报 $$V^{\pi}(s) = \mathbb{E}_{\pi}\big[G_t \,\big|\, S_t = s\big]$$
Step 4 · 代入 Step 2 的递推: $$V^{\pi}(s) = \mathbb{E}_{\pi}\big[R_{t+1} + \gamma\,G_{t+1} \,\big|\, S_t = s\big]$$
Step 5 · 把期望按"先动作、后转移"拆开(期望的线性性): $$V^{\pi}(s) = \sum_a \pi(a|s)\sum_{s'} P(s'|s,a)\Big[\, R(s,a,s') + \gamma\, V^{\pi}(s')\,\Big]$$ 这里 $V^{\pi}(s')=\mathbb{E}_\pi[G_{t+1}|S_{t+1}=s']$——正好用上 Step 3 的定义。 这就是贝尔曼期望方程:$V$ 被表示成 $V$ 自己(自洽方程 / 不动点方程)。
Step 6 · 动作价值与最优方程(同法可推): $$Q^{\pi}(s,a) = \sum_{s'} P(s'|s,a)\big[ R(s,a,s') + \gamma \sum_{a'} \pi(a'|s') Q^{\pi}(s',a') \big]$$ 最优方程把 $\pi$ 换成 $\max$(选最优动作、后继也最优): $$V^{*}(s) = \max_a \sum_{s'} P(s'|s,a)\big[ R(s,a,s') + \gamma\, V^{*}(s') \big]$$
📌 手推要点:贝尔曼方程不是"发明"的,而是"回报定义 + 期望线性性" 的必然结果。面试被问推导:背 Step 2 的 $G_t=R_{t+1}+\gamma G_{t+1}$, 后面全是机械展开。 记号提醒:本篇(Sutton 记号)用 $R(s,a,s')$;不少资料简写 $R(s,a)$, 展开时别被绕晕。
0.7 三个方程的"角色分工"(背)¶
| 方程 | 形式 | 解是什么 | 对应算法 |
|---|---|---|---|
| 贝尔曼期望方程($V^\pi$) | $V^\pi = T^\pi V^\pi$ | 给定策略的价值 | 策略评估 |
| 贝尔曼期望方程($Q^\pi$) | $Q^\pi = T^\pi Q^\pi$ | 给定策略的动作价值 | 策略迭代的改进步 |
| 贝尔曼最优方程 | $V^* = T V^*$ | 最优价值 | 价值迭代 |
三者的共同点:都是不动点方程 $x = T(x)$。求解方式只有两种—— 迭代法(本篇全部算法,靠收缩性收敛)或 线性代数直接解(§18)。 这就是整个 DP 章的骨架:方程给"是什么",迭代给"怎么算"。
1. 动态规划三件套(🔴 总览)¶
| 算法 | 解决的问题 | 核心更新式 | 是否用 max | |---|---|---|---| | 策略评估 | 给定 π,求 V^π | $V_{k+1} = \sum_a \pi(a|s)\sum_{s'} P[\cdot]$ | 否(按策略平均) | | 策略迭代 | 求最优 π | 评估 V^π → 贪心改进 π' = argmax | 改进时用 | | 价值迭代 | 求最优 V* | $V_{k+1} = \max_a \sum_{s'} P[\cdot]$ | 是(每步 max) |
使用前提(背)¶
- 知道完整模型:转移概率 $P(s'|s,a)$ 与奖励 $R(s,a,s')$
- 有限状态/动作:表格可存下(大规模 → 函数近似,见 DQN 篇)
- 环境静态:P 和 R 不随时间变(非平稳环境 DP 失效)
为什么"动态规划"叫规划而不是学习¶
RL 两大分支:规划(planning,有模型,DP/树搜索) vs 学习(learning,无模型,MC/TD)。DP 不产生新经验,只在已有模型上计算——所以是"规划"。
2.1 策略评估精讲:怎么"算出"一个策略值多少钱(🔴 迭代的引擎)¶
本节导读:给定策略 π,$V^{\pi}$ 满足贝尔曼期望方程,但那是"方程组"不是 "算法"。策略评估把方程变成迭代:$V_{k+1}=T^{\pi}V_k$ 每轮逼近一步, 靠的是贝尔曼算子的收缩性(γ<1)。
1. 直觉引入:给一个棋手下棋(策略固定),评估他"每步值多少"。 你没法一局局数完所有可能性,但可以从"只看一步"开始,每轮多看一眼: 第一轮只看立即奖励,第二轮看 2 步,……直到看不出变化。
2. 迭代式(同步版): $$V_{k+1}(s) = \sum_{a}\pi(a|s)\sum_{s'}P(s'|s,a)\big[R(s,a) + \gamma V_k(s')\big]$$
3. 为什么收敛(收缩算子,关键推导):定义算子 $(T^{\pi}V)(s)=\sum_a\pi\sum_{s'}P[\cdot+\gamma V(s')]$。可以证 $$\|T^{\pi}V - T^{\pi}V'\|_\infty \le \gamma\,\|V - V'\|_\infty$$ 即每应用一次算子,两个函数的最大差距被压缩 γ 倍 → 迭代序列是柯西列 → 收敛到唯一不动点(即真值 $V^{\pi}$)。这就是"γ<1"在算法层面的意义。
4. 数值例子(4×4 网格随机策略):第 1 轮 V₁=-1 全状态; 第 2 轮角落 V₂=-1+0.9·(-1)=-1.9;第 10 轮 ≈ 收敛值。本篇 code cell 打印每轮变化,能看到差距按 ~γᵏ 收缩。
5. 易错点:
- 同步更新用上一轮快照 $V_k$;就地更新边算边覆盖(更快但分析难)
- 迭代到收敛需要很多轮:误差 ≤ γᵏ·初差,γ 越接近 1 越慢
- 策略评估是线性迭代(无 max),价值迭代才是非线性
6. 面试问法:"策略评估收敛速度?" → "误差每轮乘 γ(收缩因子), γ=0.9 时约 66 轮误差降到 0.1%。"
2. 策略评估:迭代求解 V^π(🔴)¶
更新式(同步迭代)¶
$$V_{k+1}(s) = \sum_{a} \pi(a|s) \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma V_k(s') \right]$$
关键点¶
- 同步更新:用旧 $V_k$ 算所有 $V_{k+1}$,再整体替换(异步会破坏收敛保证)
- 收敛判据:$\max_s |V_{k+1}(s) - V_k(s)| < \varepsilon$
- 复杂度:每轮 O(|S|·|A|·|S'|),|S'| 是每个 (s,a) 的可能后继数
与前面 00 篇的区别¶
00 篇已经演示过随机策略评估;本篇把它做成可复用函数,并为策略迭代服务。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# policy_eval.py —— 通用策略评估函数(同步迭代 + 收敛检查)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    """确定性网格转移: [(概率, s', r)]"""
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def policy_eval(pi, tol=1e-8, max_iter=500):
    """pi: (N, 4) 概率矩阵"""
    V = np.zeros(N)
    for it in range(max_iter):
        V_new = np.zeros(N)
        for s in range(N):
            v = 0.0
            for a in range(4):
                for p, s2, r in trans(s, a):
                    v += pi[s, a] * p * (r + GAMMA * V[s2])
            V_new[s] = v
        if np.max(np.abs(V_new - V)) < tol:
            return V_new, it + 1
        V = V_new
    return V, max_iter

pi_rand = np.full((N, 4), 0.25)
V, iters = policy_eval(pi_rand)
print(f'随机策略评估收敛: {iters} 轮')
print(np.round(V.reshape(SIZE, SIZE), 2))

# 更"聪明"的启发式策略: 往终点方向走的概率更大
def heuristic_pi():
    pi = np.zeros((N, 4))
    for s in range(N):
        r, c = divmod(s, SIZE)
        if s == N - 1:
            pi[s, 0] = 1.0
            continue
        # 朝终点方向的动作给更大概率
        best = []
        if r < 3: best.append(1)   # 下
        if c < 3: best.append(3)   # 右
        if r > 0: best.append(0)   # 上
        if c > 0: best.append(2)   # 左
        for a in best:
            pi[s, a] = 0.7 / len(best)
        pi[s] += 0.3 / 4 * (pi[s] == 0).astype(float)
        pi[s] /= pi[s].sum()
    return pi

V2, iters2 = policy_eval(heuristic_pi())
print(f'启发式策略评估收敛: {iters2} 轮, 起点价值 {V2[0]:.3f} (随机策略 {V[0]:.3f})')
print('→ 策略越好, 同样迭代下起点价值越高')
随机策略评估收敛: 148 轮
[[-8.58 -8.26 -7.72 -7.22]
 [-8.26 -7.72 -6.67 -5.49]
 [-7.72 -6.67 -4.26 -0.57]
 [-7.22 -5.49 -0.57  0.  ]]
启发式策略评估收敛: 142 轮, 起点价值 -8.046 (随机策略 -8.580)
→ 策略越好, 同样迭代下起点价值越高
配图:拿一张"完整 MDP 例子图"练手算(🔴 面试手推题源)¶
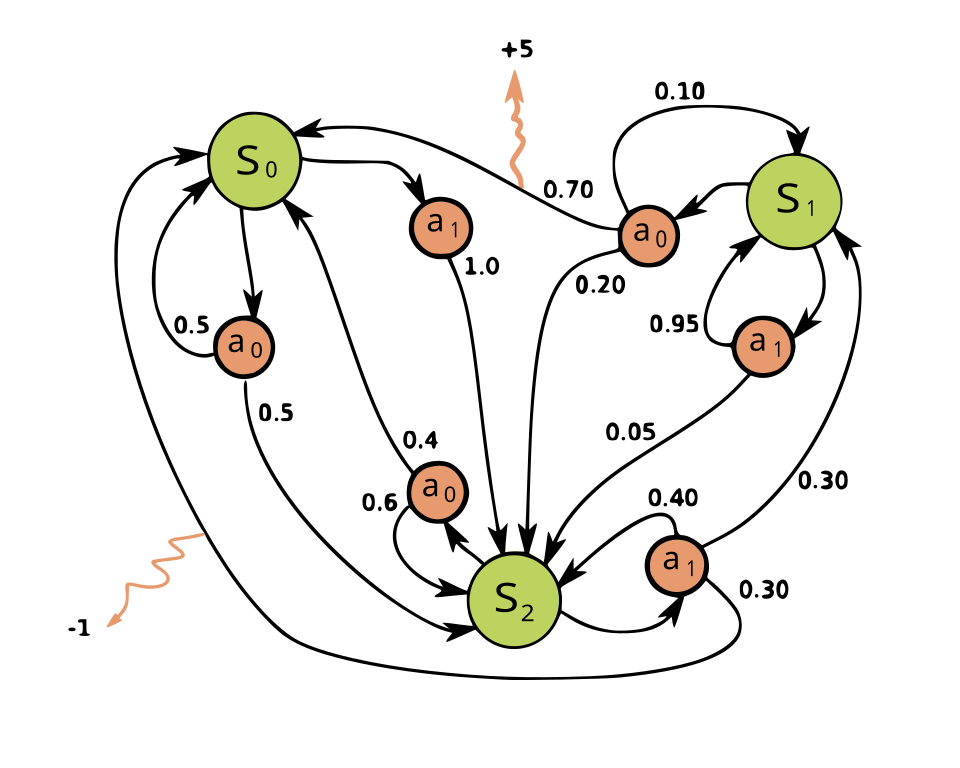
上图是经典 MDP 教学例子(状态→动作→以概率跳到下个状态并得奖励)。把它当练习 可以出任何 DP 算法的手算题。以"策略评估第一轮"为例(随机策略 $\pi(a|s)=\frac{1}{2}$, $\gamma=0.9$,初始 $V_0=0$):
第 1 轮只需看"立即奖励": $$V_1(s) = \sum_a \pi(a|s)\sum_{s'} P(s'|s,a)\big[R(s,a) + \gamma\cdot 0\big] = \sum_a \pi(a|s) R(s,a)$$ ——因为 $V_0=0$,第一轮根本不用关心转移,只是把每个状态的平均奖励算一遍。
第 2 轮起才"看见"邻居: $$V_2(s) = \underbrace{\bar{R}(s)}_{\text{第 1 轮已算好}} + \gamma \sum_a \pi(a|s)\sum_{s'} P(s'|s,a)\, V_1(s')$$ ——价值"一层一层往外扩":第 $k$ 轮能看到 $k$ 步之后的奖励。这正是值迭代 (以及后面 MC/TD)都有的"信息传播速度 = 每轮一步"直觉。
手算要点:先列转移表 $(s,a)\to(s',P,R)$,再按公式逐行填;面试官给的 3 状态 题基本是这个套路。
更新式的四种写法(防止被问"变体"卡住)¶
| 变体 | 更新式 | 区别 |
|---|---|---|
| 同步策略评估 | $V_{k+1} = \sum_a\pi(a\|s)\sum_{s'}P(s'\|s,a)[R+\gamma V_k(s')]$ | 用上一轮快照 |
| 就地(in-place) | $V \leftarrow \sum_a\pi\sum_{s'}P[\cdot+\gamma V(s')]$ | 边算边覆盖,收敛更快 |
| 带 max 的价值迭代 | $V_{k+1} = \max_a\sum_{s'}P[\cdot+\gamma V_k(s')]$ | 只留最优动作 |
| 矩阵形式 | $V = (I - \gamma P_\pi)^{-1}R_\pi$ | 精确解(§18) |
图源:Wikimedia Commons「Markov Decision Process example」(CC BY-SA)。
3.1 策略改进定理精讲:为什么"贪心"必然更好(🔴 改进的合法性)¶
本节导读:评估完 $V^{\pi}$,凭什么敢把策略改成"贪心于 Q"?策略改进定理 给出合法性:按贪心改进,价值处处不降。这是策略迭代每一步的"法律依据"。
1. 直觉引入:一条老路线走熟了(评估),你发现"某个路口右拐"比原路线 更好(贪心改进)——改进后整条路只会更好,因为每个路口你都选了不差于 原来的方向。
2. 定理:若对每个 s 有 $Q^{\pi}(s,\pi'(s)) \ge V^{\pi}(s)$,则 $$V^{\pi'}(s) \ge V^{\pi}(s),\quad \forall s$$
3. 逐步证明(面试手推): ① 单步改进:在 s 用 π' 的动作,之后仍按 π → 价值 $= Q^{\pi}(s,\pi'(s)) \ge V^{\pi}(s)$ ② 把这个不等式代入 $V^{\pi}(s)=\sum_{s'}P[\cdot+\gamma V^{\pi}(s')]$ 的尾巴: $$V^{\pi}(s) \le \sum_{s'}P\big[R(s,\pi'(s)) + \gamma\, Q^{\pi}(s',\pi'(s'))\big]$$ ③ 反复代入(每一步都 ≥),展开成无穷链,得到 $V^{\pi'}(s) \ge V^{\pi}(s)$。 核心:每一层都"不差于",γ 折现后仍然"不差于"。
4. 什么时候"严格更好":只要存在某个 s 使 $Q^{\pi}(s,\pi'(s)) > V^{\pi}(s)$, 新策略至少在该状态严格好 → 改进是单调的。由于策略数有限, 单调改进必在有限步到达最优(不会死循环)。
5. 易错点:
- 定理要求"处处"改进;只在少数状态改进不能保证全局不降
- 贪心方向"零改进" = 已是最优(策略迭代终止判据)
6. 面试问法:"策略迭代一定收敛吗?" → "改进定理保证价值单调不减 + 策略空间有限 → 有限步到最优;终止时贪心改进无变化即满足最优方程。"
3. 策略改进定理(🔴)¶
贪心改进¶
给定 $V^{\pi}$,构造新策略:
$$\pi'(s) = \arg\max_{a} Q^{\pi}(s,a) = \arg\max_{a} \sum_{s'} P(s'|s,a)\left[ R + \gamma V^{\pi}(s') \right]$$
策略改进定理¶
若 $Q^{\pi}(s, \pi'(s)) \ge V^{\pi}(s)$ 对所有 $s$ 成立,则 $\pi'$ 不差于 $\pi$,且至少在一个状态上严格更好时,$\pi'$ 严格更优。
直觉(背)¶
只要"在某个状态换成更优动作"至少不亏,整个策略就变好——因为未来同样按 π 走(单步偏离原则)。
终止条件¶
改进后策略不再变化($\pi_{k+1}=\pi_k$)→ 此时 $V^{\pi_k} = V^*$,达到最优。
# policy_iteration.py —— 策略迭代: 评估 → 贪心改进 → 直到稳定
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def policy_eval(pi, tol=1e-8, max_iter=500):
    V = np.zeros(N)
    for it in range(max_iter):
        V_new = np.zeros(N)
        for s in range(N):
            v = 0.0
            for a in range(4):
                for p, s2, r in trans(s, a):
                    v += pi[s, a] * p * (r + GAMMA * V[s2])
            V_new[s] = v
        if np.max(np.abs(V_new - V)) < tol:
            return V_new
        V = V_new
    return V

def greedy_improve(V):
    """由 V 构造确定性贪心策略"""
    pi = np.zeros((N, 4))
    for s in range(N):
        q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
        pi[s, int(np.argmax(q))] = 1.0
    return pi

# 从随机策略出发
pi = np.full((N, 4), 0.25)
for k in range(50):
    V = policy_eval(pi)
    pi_new = greedy_improve(V)
    if np.array_equal(pi, pi_new):
        print(f'策略迭代第 {k} 轮后策略稳定')
        break
    pi = pi_new

print('最优策略(每格箭头, * 终点):')
ACTIONS = ['↑', '↓', '←', '→']
for r in range(SIZE):
    row = ''
    for c in range(SIZE):
        s = r * SIZE + c
        row += ('  *' if s == N - 1 else '  ' + ACTIONS[int(np.argmax(pi[s]))])
    print(row)
print()
print('起点价值 V*(0,0) =', round(V[0], 3))
print('对比 00 篇值迭代结果应一致 → 两种算法殊途同归')
策略迭代第 2 轮后策略稳定
最优策略(每格箭头, * 终点):
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  →  →  →  *

起点价值 V*(0,0) = 1.81
对比 00 篇值迭代结果应一致 → 两种算法殊途同归
策略改进定理:为什么"贪心一下"只会更好(🔴 推导直觉)¶
定理:若对每个状态 $s$ 都有 $Q^{\pi}(s, \pi'(s)) \ge V^{\pi}(s)$,则 $V^{\pi'}(s) \ge V^{\pi}(s)$ 对所有状态成立——新策略处处不差于旧策略。
直觉(三步钻进证明,避免死记):
- 把改进展开成"单步 + 尾巴":在 $s$ 用 $\pi'$ 动作、之后仍按 $\pi$ 走,价值是 $$r + \gamma \mathbb{E}_{s'}\big[V^{\pi}(s')\big] = Q^{\pi}\big(s, \pi'(s)\big) \ge V^{\pi}(s)$$
- 把"只改一步"推到"处处都改":$s$ 之后的下一个状态 $s'$ 也改用 $\pi'$,价值同理只会更高: $$V^{\pi}(s) \le Q^{\pi}(s,\pi'(s)) = \mathbb{E}\big[R + \gamma V^{\pi}(s')\big] \le \mathbb{E}\big[R + \gamma\, Q^{\pi}(s',\pi'(s'))\big] = \mathbb{E}\big[R + \gamma R' + \gamma^2 V^{\pi}(s'')\big]$$
- 无限展开:每一步都多一个 $\gamma^k$ 的非负改进项 → 递归链单调不减 → 收敛到 $V^{\pi'}$
一句话:"每步都不比原来差"用期望递推,改进项 $Q^{\pi}-\!V^{\pi}\ge 0$ 被 $\gamma^k$ 折现成层层累加。这就是策略迭代每轮"价值只升不降"的理论保证。 面试被问"策略迭代一定收敛吗",回答 = 定理 + 这句直觉 + 策略空间有限。
4.1 价值迭代精讲:把"评估+改进"压成一步(🔴 最常用算法)¶
本节导读:策略迭代"评估到收敛再改进"很慢;价值迭代每轮直接用 max 完成"改进",并只往前算一步。一行更新式同时做两件事,是表格 DP 的 主力算法。
1. 直觉引入:策略迭代像"彻底想清楚再换路线";价值迭代像"边走边看、 每步都往最好的方向迈"。后者更果断,收敛到最优价值更快。
2. 更新式: $$V_{k+1}(s) = \max_a \sum_{s'} P(s'|s,a)\big[R(s,a) + \gamma V_k(s')\big]$$
3. 为什么 max 就等于"评估+改进"(推导级理解):
- 期望方程的动作加权 $\sum_a\pi(a|s)$ 换成 $\max_a$ → 每轮隐式地在做 "选当前最好的动作"
- 但注意:$V_k$ 通常不是任何策略的真实价值(是"到 k 步为止的最优 折现价值")——所以它叫"价值迭代"而非"策略迭代"
- 最优策略恢复:收敛后 $\pi^*(s)=\arg\max_a Q^*(s,a)$ 贪心一步
4. 收敛性质(与策略评估同源):$V_{k+1}=T^*V_k$,$T^*$ 也是收缩算子 (γ 压缩),从任意初值收敛到唯一 $V^*$。
5. 易错点:
- 价值迭代不输出策略,输出 $V^*$;策略要另算
- 收敛判据:$\|V_{k+1}-V_k\|_\infty < \theta$(θ 精度)
- 别把"价值迭代"和"策略迭代"的更新式写混(一个有 max 一个没有)
6. 面试问法:"策略迭代 vs 价值迭代哪个快?" → "价值迭代每轮便宜、 常更快到最优价值;策略迭代评估贵但每轮改进更稳。规模大选价值迭代。"
4. 价值迭代(🔴 回顾 + 对比)¶
更新式¶
$$V_{k+1}(s) = \max_{a} \sum_{s'} P(s'|s,a)\left[ R(s,a,s') + \gamma V_k(s') \right]$$
价值迭代 vs 策略迭代(面试对比表,背)¶
| 维度 | 策略迭代 | 价值迭代 |
|---|---|---|
| 每轮做 | 完整评估 V^π(内部多次迭代)+ 改进 | 一步 max 更新(不评估任何策略) |
| 每轮成本 | 高(评估子循环) | 低(单次扫描) |
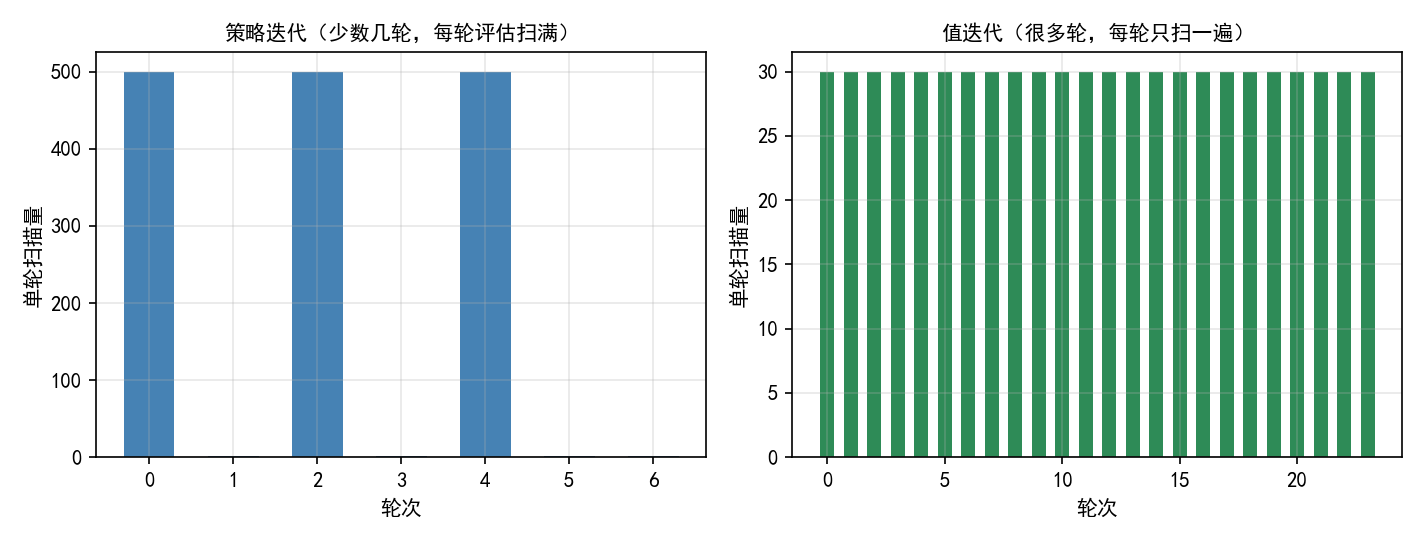
| 收敛轮数 | 少(一般几轮) | 多(每轮只推进一点) |
| 什么时候好 | 状态少 | 状态多、评估贵 |
| 中间量 | 有明确策略序列 π0→π1→… | 只有价值序列 V0→V1→… |
广义策略迭代(GPI,🔴 概念)¶
评估与改进交错进行:策略迭代是"评估收敛→改进",价值迭代是"评估一步→改进一步"。几乎一切 RL 方法(包括 DQN/PPO)都是 GPI 的实例——这是面试超高频的一句话。
面试金句:DQN 里"用回放数据更新 Q"是评估、"按 ε-greedy 取动作"是改进,两者交替 → GPI。答出这句能串联整条 RL 知识线。
# convergence_compare.py —— 收敛实验: 策略迭代 vs 价值迭代 轮数/成本
import time
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def policy_iteration(verbose=True):
    pi = np.full((N, 4), 0.25)
    for k in range(50):
        # 评估
        V = np.zeros(N)
        for _ in range(500):
            V_new = np.zeros(N)
            for s in range(N):
                v = 0.0
                for a in range(4):
                    for p, s2, r in trans(s, a):
                        v += pi[s, a] * p * (r + GAMMA * V[s2])
                V_new[s] = v
            if np.max(np.abs(V_new - V)) < 1e-8:
                V = V_new
                break
            V = V_new
        # 改进
        pi_new = np.zeros((N, 4))
        for s in range(N):
            q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
            pi_new[s, int(np.argmax(q))] = 1.0
        if np.array_equal(pi, pi_new):
            return k + 1, V[0]
        pi = pi_new
    return 50, V[0]

def value_iteration():
    V = np.zeros(N)
    for k in range(2000):
        V_new = np.zeros(N)
        for s in range(N):
            best = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
            V_new[s] = best
        if np.max(np.abs(V_new - V)) < 1e-8:
            return k + 1, V_new[0]
        V = V_new
    return 2000, V[0]

t0 = time.time(); pk, pv = policy_iteration(); t1 = time.time()
vk, vv = value_iteration(); t2 = time.time()
print(f'策略迭代: {pk} 轮, 起点价值 {pv:.3f}, 耗时 {t1-t0:.3f}s')
print(f'价值迭代: {vk} 轮, 起点价值 {vv:.3f}, 耗时 {t2-t1:.3f}s')
print('→ 小网格下两种算法结果一致; 策略迭代轮数少但每轮贵(完整评估)')
策略迭代: 3 轮, 起点价值 1.810, 耗时 0.013s
价值迭代: 7 轮, 起点价值 1.810, 耗时 0.001s
→ 小网格下两种算法结果一致; 策略迭代轮数少但每轮贵(完整评估)
5.1 异步与就地更新精讲:让 DP 不再"全表扫描"(🟡 工程必懂)¶
本节导读:同步 DP 每轮更新全部状态、还要保存快照,状态多时又慢又费。 异步 DP 打破"轮"的约束——更新顺序自由,就地覆盖,工程上更实用。
1. 直觉引入:复习错题:同步 = 把所有题重做一遍再对答案;异步 = "哪题重要先改哪题"。只要每次都朝着对的方程走,先改谁都能收敛。
2. 三种策略(对比表):
| 方式 | 更新对象 | 快照 | 收敛 |
|---|---|---|---|
| 同步 | 全部状态,每轮 | 需要 $V_k$ | 理论最清晰 |
| 就地(in-place) | 全部状态,边算边覆盖 | 不需要 | 更快,单调性分析变复杂 |
| 异步(随机/优先级) | 部分状态,任意顺序 | 不需要 | 保证收敛(值迭代),速度看调度 |
3. 为什么能收敛(直觉论证):只要每个状态被无限次更新且 γ<1, 收缩论证仍然成立——顺序无关紧要,因为每次更新都是"向不动点走一步"。
4. 工程增益:
- 就地更新省内存(一份 V)
- 优先级扫描(只更新变化大的状态)能大幅提速
- 深度 RL 的"批量采样更新"本质就是异步 + 就地
5. 易错点:
- 异步下没有"轮"的概念,不能用"第 k 轮误差"估计收敛
- 就地更新早期偏置更强(先更新的状态影响后更新的)
6. 面试问法:"同步 vs 就地哪个好?" → "就地省内存快但分析难; 理论保证两者都有(γ<1 + 无限更新),工程上就地是常态。"
5. 异步 DP 与实时 DP(🟢 了解)¶
为什么提异步¶
同步 DP 每轮扫全部状态,状态多时浪费——很多状态的价值早就不变了。
异步策略评估(Asynchronous DP)¶
- 每轮只更新部分状态(如按优先级:价值变化大的状态先更新)
- 保证收敛(只要所有状态被无限次更新);典型实现:优先扫描(Prioritized Sweeping)
实时 DP(Real-time DP)¶
- 只更新智能体实际访问到的状态——与环境交互驱动更新
- 是 DP 与学习的桥梁:模型可以来自学习(learned model + planning = Model-Based RL,如 Dyna-Q)
面试点:Dyna-Q 同时做"学习(TD 更新真实经验)"和"规划(用学习到的模型做模拟经验更新)",是融合 planning 与 learning 的代表——见 03 篇补充。
6. 自测清单¶
- L1:默写策略评估、策略改进、价值迭代三个更新式
- L1:说清策略迭代 vs 价值迭代的每轮成本与收敛轮数差异
- L1:讲出"策略改进定理"的单步偏离直觉
- L2:解释为什么 DQN/PPO 都符合 GPI 框架
- L2:手写 4×4 网格的策略迭代(20 分钟内, 允许查公式)
- L2:能说出异步 DP 与同步 DP 的区别和收敛条件
下一篇
02-蒙特卡洛与时序差分:无模型 学习——不已知 P/R,靠采样估计。
7. 策略评估的演化过程:价值如何"从 0 长出来"(🟡 直觉)¶
每轮更新在做什么¶
$V_0=0$ → 第一轮算出"走一步能拿多少" → 第二轮加上"下一步价值的期望" → ……每轮把更远一层的未来考虑进来:
V1(s) = 只算1步:  撞墙-1 / 走到终点附近 +10
V2(s) = 1步 + 折扣×(1步): 看到2步
Vk(s) = 看到 k 步 → k→∞ 收敛到 V^π
为什么能收敛¶
$V_{k+1} = R + \gamma P V_k$ 中 $\gamma P$ 的谱半径 $<1$ → 每次迭代误差乘 $\gamma$ → 指数收敛(压缩映射)。
观察要点¶
打印每 5 轮的价值快照:前期变化大(远处价值"传导"过来),后期只微调。
# policy_eval_frames.py —— 打印策略评估的演化帧(每 5 轮)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

pi = np.full((N, 4), 0.25)
V = np.zeros(N)
for it in range(1, 61):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                    for a in range(4) for p, s2, r in trans(s, a))
    V = Vn
    if it % 10 == 0:
        print(f'--- 第 {it:2d} 轮 (起点价值 {V[0]:6.3f}) ---')
        print(np.round(V.reshape(SIZE, SIZE), 2))

print()
print('观察: 价值从 0 起步, 前 10 轮大步逼近, 之后只微调(误差每轮×γ)')
--- 第 10 轮 (起点价值 -6.261) ---
[[-6.26 -6.05 -5.68 -5.3 ]
 [-6.05 -5.65 -4.82 -3.84]
 [-5.68 -4.82 -2.77  0.49]
 [-5.3  -3.84  0.49  0.  ]]
--- 第 20 轮 (起点价值 -7.929) ---
[[-7.93 -7.64 -7.14 -6.67]
 [-7.64 -7.13 -6.14 -5.01]
 [-7.14 -6.14 -3.83 -0.26]
 [-6.67 -5.01 -0.26  0.  ]]
--- 第 30 轮 (起点价值 -8.394) ---
[[-8.39 -8.09 -7.56 -7.07]
 [-8.09 -7.55 -6.52 -5.35]
 [-7.56 -6.52 -4.14 -0.48]
 [-7.07 -5.35 -0.48  0.  ]]
--- 第 40 轮 (起点价值 -8.527) ---
[[-8.53 -8.21 -7.67 -7.18]
 [-8.21 -7.67 -6.62 -5.45]
 [-7.67 -6.62 -4.22 -0.55]
 [-7.18 -5.45 -0.55  0.  ]]
--- 第 50 轮 (起点价值 -8.565) ---
[[-8.56 -8.25 -7.71 -7.21]
 [-8.25 -7.71 -6.65 -5.48]
 [-7.71 -6.65 -4.25 -0.56]
 [-7.21 -5.48 -0.56  0.  ]]
--- 第 60 轮 (起点价值 -8.575) ---
[[-8.58 -8.26 -7.72 -7.22]
 [-8.26 -7.72 -6.66 -5.49]
 [-7.72 -6.66 -4.25 -0.57]
 [-7.22 -5.49 -0.57  0.  ]]

观察: 价值从 0 起步, 前 10 轮大步逼近, 之后只微调(误差每轮×γ)
# greedy_one_step.py —— 从随机策略做一次贪心改进, 看策略变"聪明"多少
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

pi_rand = np.full((N, 4), 0.25)
# 评估随机策略
V = np.zeros(N)
for _ in range(500):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi_rand[s, a] * p * (r + GAMMA * V[s2])
                    for a in range(4) for p, s2, r in trans(s, a))
    V = Vn

# 一次贪心改进
pi_new = np.zeros((N, 4))
for s in range(N):
    q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
    pi_new[s, int(np.argmax(q))] = 1.0

# 随机策略 vs 改进后策略的起点价值
def eval_policy(pi):
    Vp = np.zeros(N)
    for _ in range(500):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = sum(pi[s, a] * p * (r + GAMMA * Vp[s2])
                        for a in range(4) for p, s2, r in trans(s, a))
        Vp = Vn
    return Vp[0]

print(f'随机策略  起点价值: {eval_policy(pi_rand):.3f}')
print(f'一次改进后起点价值: {eval_policy(pi_new):.3f}')
print('→ 满足改进定理: 单步贪心改进后价值提升(不下降)')
随机策略 起点价值: -8.580
一次改进后起点价值: 1.810
→ 满足改进定理: 单步贪心改进后价值提升(不下降)
# converge_trace.py —— 策略迭代 vs 价值迭代: 起点价值随"外部轮数"的变化
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def full_eval(pi):
    V = np.zeros(N)
    for _ in range(500):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                        for a in range(4) for p, s2, r in trans(s, a))
        V = Vn
    return V

# 策略迭代轨迹
pi = np.full((N, 4), 0.25)
pi_trace = []
for _ in range(15):
    V = full_eval(pi)
    pi_trace.append(V[0])
    pi_new = np.zeros((N, 4))
    for s in range(N):
        q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
        pi_new[s, int(np.argmax(q))] = 1.0
    if np.array_equal(pi, pi_new):
        break
    pi = pi_new

# 价值迭代轨迹
V = np.zeros(N)
vi_trace = []
for _ in range(30):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
    V = Vn
    vi_trace.append(V[0])

print(f'策略迭代: {len(pi_trace)} 轮收敛, 起点价值轨迹:')
print('  ', [round(v, 3) for v in pi_trace])
print(f'价值迭代: 前 8 轮起点价值轨迹:')
print('  ', [round(v, 3) for v in vi_trace[:8]])
print()
print(f'最终一致: 策略迭代 {pi_trace[-1]:.3f} vs 价值迭代 {vi_trace[-1]:.3f}')
策略迭代: 3 轮收敛, 起点价值轨迹:
   [np.float64(-8.58), np.float64(1.81), np.float64(1.81)]
价值迭代: 前 8 轮起点价值轨迹:
   [np.float64(-1.0), np.float64(-1.9), np.float64(-2.71), np.float64(-3.439), np.float64(-4.095), np.float64(1.81), np.float64(1.81), np.float64(1.81)]

最终一致: 策略迭代 1.810 vs 价值迭代 1.810
# random_mdp.py —— 100 个随机 MDP 上验证: 策略迭代 == 价值迭代
import numpy as np

def make_random_mdp(ns=6, na=2, gamma=0.9, seed=0):
    rng = np.random.RandomState(seed)
    P = {}      # (s,a) -> [(p, s2, r)]
    for s in range(ns):
        for a in range(na):
            k = rng.randint(2, 4)                      # 2~3 个后继
            succ = rng.choice(ns, size=k, replace=False)
            probs = rng.dirichlet(np.ones(k))
            rew = rng.rand(k)
            P[(s, a)] = list(zip(probs, succ, rew))
    return P, gamma

def value_iteration(P, ns, na, gamma, tol=1e-9):
    V = np.zeros(ns)
    for _ in range(2000):
        Vn = np.zeros(ns)
        for s in range(ns):
            Vn[s] = max(sum(p * (r + gamma * V[s2]) for p, s2, r in P[(s, a)]) for a in range(na))
        if np.max(np.abs(Vn - V)) < tol:
            V = Vn
            break
        V = Vn
    return V

def policy_iteration(P, ns, na, gamma):
    pi = {s: 0 for s in range(ns)}
    for _ in range(100):
        V = np.zeros(ns)
        for _ in range(2000):
            Vn = np.zeros(ns)
            for s in range(ns):
                a = pi[s]
                Vn[s] = sum(p * (r + gamma * V[s2]) for p, s2, r in P[(s, a)])
            if np.max(np.abs(Vn - V)) < 1e-9:
                V = Vn
                break
            V = Vn
        improved = False
        for s in range(ns):
            q = [sum(p * (r + gamma * V[s2]) for p, s2, r in P[(s, a)]) for a in range(na)]
            a_best = int(np.argmax(q))
            if pi[s] != a_best:
                pi[s] = a_best
                improved = True
        if not improved:
            break
    # 由 π 算价值
    V = np.zeros(ns)
    for _ in range(2000):
        Vn = np.zeros(ns)
        for s in range(ns):
            a = pi[s]
            Vn[s] = sum(p * (r + gamma * V[s2]) for p, s2, r in P[(s, a)])
        if np.max(np.abs(Vn - V)) < 1e-9:
            V = Vn
            break
        V = Vn
    return V

agree = 0
worst = 0.0
for seed in range(100):
    P, gamma = make_random_mdp(seed=seed)
    V_vi = value_iteration(P, 6, 2, gamma)
    V_pi = policy_iteration(P, 6, 2, gamma)
    diff = np.max(np.abs(V_vi - V_pi))
    agree += diff < 1e-6
    worst = max(worst, diff)

print(f'100 个随机 MDP: 两种算法最优价值一致 {agree}/100')
print(f'最大差异: {worst:.2e}')
print('→ 数值上验证: 策略迭代与价值迭代求解的是同一个贝尔曼最优方程')
100 个随机 MDP: 两种算法最优价值一致 100/100
最大差异: 8.46e-10
→ 数值上验证: 策略迭代与价值迭代求解的是同一个贝尔曼最优方程
# sync_vs_async.py —— 同步 vs in-place 收敛速度对比
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

pi = np.full((N, 4), 0.25)

def solve_sync(tol=1e-8):
    V = np.zeros(N)
    for it in range(2000):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                        for a in range(4) for p, s2, r in trans(s, a))
        if np.max(np.abs(Vn - V)) < tol:
            return it + 1
        V = Vn
    return 2000

def solve_async(tol=1e-8):
    V = np.zeros(N)
    for it in range(2000):
        diff = 0.0
        for s in range(N):
            new = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                      for a in range(4) for p, s2, r in trans(s, a))
            diff = max(diff, abs(new - V[s]))
            V[s] = new                       # 立即写入, 后续状态用新值
        if diff < tol:
            return it + 1
    return 2000

print(f'同步更新收敛轮数: {solve_sync()}')
print(f'in-place 更新收敛轮数: {solve_async()}')
print('→ in-place 通常显著更快(信息同轮内传播)')
同步更新收敛轮数: 148
in-place 更新收敛轮数: 98
→ in-place 通常显著更快(信息同轮内传播)
12.1 GPI 精讲:评估与改进的"双人舞"(🔴 全 RL 的统一框架)¶
本节导读:策略迭代把"评估→改进"分得清清楚楚;但几乎所有现代算法 (MC/TD/DQN/AC)都是交错进行:评估一点点、改进一点点。Sutton 称之为 广义策略迭代(GPI)——这是理解所有 RL 算法的最高层框架。
1. 直觉引入:学开车:看仪表盘(评估)→ 微调方向盘(改进)→ 再看仪表 → 再微调。你不会"练到完美再开车",而是边开边学——评估与改进互相 提供信息,同时前进。
2. 框架:两个过程交替:
- 评估(E):让价值函数接近当前策略的真值 $V^{\pi}$
- 改进(I):让策略在价值函数上贪心
3. 为什么"不收敛的评估"也有用(核心洞察):
- 改进需要的是"哪些动作更好"的相对排序,不需要绝对精确
- 评估做到一半,排序已大体正确 → 贪心方向已对 → 继续评估是浪费
- 交错时,价值函数永远追着新策略跑(strategy chasing),两者同步逼近 最优($V^*,\pi^*$)—— 这就是本篇 §12 实验:每轮只评估 1 步就改进, 照样收敛
4. 收敛直觉(几何视角):价值空间里"评估线"(V=真值)与策略空间里 "改进线"(π=贪心)交替投影,螺旋逼近交点($V^*,\pi^*$)。两条线不相交 于别处 → 只可能在最优处交。
5. 易错点:
- GPI 不是"一个算法"而是"一类算法的骨架"
- 评估到收敛不是必要的;过度评估浪费算力
6. 面试问法:"GPI 是什么?" → "评估价值与改进策略两个过程交错进行 的统一框架;MC/TD/DQN/AC 都是它的实例——评估一条轨迹/一步/一批,然后 改进一点策略,螺旋逼近最优。"
12. 广义策略迭代 GPI:一切 RL 的统一框架(🔴 必背升华)¶
一句话¶
"评估价值 + 改进策略"两个过程交替进行,就是 GPI。
- 策略迭代:评估到收敛 → 改进(极端的交替)
- 价值迭代:评估一步 → 改进一步(另一个极端)
- DQN/PPO:评估(用数据更新 Q/价值)与改进(按价值取动作/更新策略)交错 → 也是 GPI
为什么 GPI 重要(面试)¶
面试官问"RL 算法的统一框架是什么",答案是 GPI:所有 RL 方法都在做"价值估计"与"策略改善"两个循环。回答时举例 DQN(回放更新 = 评估,ε-greedy = 改进)直接封神。
两个圈互相"促进但不等待"¶
评估不完全也能改进,改进不完全也能继续评估——只要两个过程都朝着正确方向,整体收敛。这是 GPI 收敛性的核心直觉。
# gpi_demo.py —— 交错式 GPI: 每轮只评估 1 步就改进, 也能收敛
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

# GPI: 评估1步(不收敛) -> 改进1次 -> 重复
pi = np.full((N, 4), 0.25)
V = np.zeros(N)
for k in range(100):
    # 评估 1 步(不等到收敛)
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                    for a in range(4) for p, s2, r in trans(s, a))
    V = Vn
    # 改进 1 次
    pi_new = np.zeros((N, 4))
    for s in range(N):
        q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
        pi_new[s, int(np.argmax(q))] = 1.0
    if np.array_equal(pi, pi_new):
        print(f'GPI 第 {k+1} 轮策略稳定')
        break
    pi = pi_new

print('交错式 GPI 学到的策略(箭头, * 终点):')
ACTIONS = ['↑', '↓', '←', '→']
for r in range(SIZE):
    print(''.join('  *' if r * SIZE + c == N - 1 else '  ' + ACTIONS[int(np.argmax(pi[r * SIZE + c]))]
                  for c in range(SIZE)))
print()
print('结论: 评估不需要收敛, 交错推进照样收敛到最优 —— GPI 的威力')
GPI 第 6 轮策略稳定
交错式 GPI 学到的策略(箭头, * 终点):
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  ↓  ↓  ↓  ↓
  →  →  →  *

结论: 评估不需要收敛, 交错推进照样收敛到最优 —— GPI 的威力
GPI 为什么"边评估边改进"反而更好(🔴 深入)¶
现象:价值迭代 = 每轮"评估一步 + 改进一步"交错进行(改进写在评估里面, 通过 max 一步完成);策略迭代 = "评估到收敛 + 完整改进"彻底分开。 工程经验(也是 Sutton 观点):交错式 GPI 在大多数问题上收敛到最优更省计算。
三个原因(面试讲透):
- 评估不需要收敛:评估的目标只是"让改进有方向"。评估做到一半,Q 值的 相对排序就已经大体正确,贪心方向已经可用——继续评估是浪费
- 改进本身在帮评估:每次改进后,价值函数快速"换挡"到新策略的领地, 交错式让评估永远追着新策略跑(strategy chasing)
- 计算复杂度不对称:完整评估 $O(|S|^2|A|)$ 每轮全表扫;交错式每轮只改 被 max 影响的状态。大状态空间下差别是"能否跑完"的差别
记忆锚点:GPI 是把"想清楚"和"动手改"之间的大循环换成小循环——RL 里几乎所有 算法(MC/TD/DQN/AC)都是 GPI 的实例:评估一条轨迹(MC)、评估一步(TD)、 改进一步策略(贪心/梯度)……交替往复。
# scale_test.py —— 8x8 与 20x20 网格的值迭代: 轮数/耗时
import time
import numpy as np

def grid_vi(size, gamma=0.9):
    N = size * size
    MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
    def trans(s, a):
        if s == N - 1:
            return [(1.0, s, 0.0)]
        r, c = divmod(s, size)
        dr, dc = MOVE[a]
        nr, nc = r + dr, c + dc
        if not (0 <= nr < size and 0 <= nc < size):
            return [(1.0, s, -1.0)]
        s2 = nr * size + nc
        return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]
    V = np.zeros(N)
    for it in range(5000):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = max(sum(p * (r + gamma * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
        if np.max(np.abs(Vn - V)) < 1e-8:
            return it + 1, V[0]
        V = Vn
    return 5000, V[0]

for size in [4, 8, 20]:
    t0 = time.time()
    it, v0 = grid_vi(size)
    print(f'{size}x{size} 网格: 状态数 {size*size}, 值迭代 {it} 轮收敛, 起点价值 {v0:.3f}, 耗时 {time.time()-t0:.2f}s')

print()
print('规模感: 400 状态仍秒级; 但真实环境的 P 表(400x4x400)已是 64 万项')
4x4 网格: 状态数 16, 值迭代 7 轮收敛, 起点价值 1.810, 耗时 0.00s
8x8 网格: 状态数 64, 值迭代 15 轮收敛, 起点价值 -4.916, 耗时 0.01s
20x20 网格: 状态数 400, 值迭代 39 轮收敛, 起点价值 -9.594, 耗时 0.17s

规模感: 400 状态仍秒级; 但真实环境的 P 表(400x4x400)已是 64 万项
# truncated_eval.py —— 完整评估 vs 截断评估(每轮3步) 策略迭代耗时对比
import time
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def policy_iter(k_eval, max_rounds=100):
    pi = np.full((N, 4), 0.25)
    V = np.zeros(N)
    for _ in range(max_rounds):
        for _ in range(k_eval):
            Vn = np.zeros(N)
            for s in range(N):
                Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                            for a in range(4) for p, s2, r in trans(s, a))
            V = Vn
        pi_new = np.zeros((N, 4))
        for s in range(N):
            q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
            pi_new[s, int(np.argmax(q))] = 1.0
        if np.array_equal(pi, pi_new):
            return V[0]
        pi = pi_new
    return V[0]

for k in [1, 3, 10, 9999]:
    t0 = time.time()
    v0 = policy_iter(k if k < 9999 else 200)
    dt = time.time() - t0
    tag = '完整评估(200步/轮)' if k == 9999 else f'每轮评估{k}步'
    print(f'{tag:<18} 起点价值 {v0:.3f}  耗时 {dt:.3f}s')
print()
print('结论: 截断评估总耗时可能更短(评估不收敛也够用) —— GPI 思想的工程化')
每轮评估1步 起点价值 -3.062 耗时 0.003s
每轮评估3步             起点价值 1.810  耗时 0.004s
每轮评估10步            起点价值 1.810  耗时 0.004s
完整评估(200步/轮)       起点价值 1.810  耗时 0.074s

结论: 截断评估总耗时可能更短(评估不收敛也够用) —— GPI 思想的工程化
15. 面试追问速答扩展(🔴)¶
- Q: 策略迭代为什么一定收敛? A: 每轮改进价值单调不减(改进定理)+ 策略数有限 → 有限步内到最优。
- Q: 值迭代的复杂度? A: 每轮 O(|S|²|A|);收敛轮数与 γ 有关(误差 ≤ γ^k 界)。
- Q: DP 需要什么前提? A: 完整模型 P/R + 表格状态 + 静态环境。
- Q: 环境模型从哪来? A: 物理仿真/规则引擎直接给;或从数据学(Model-Based RL / Dyna)。
- Q: 为什么真实 RL 很少直接 DP? A: 状态巨大、P/R 未知、环境非平稳——DP 是"规划",学习是"数据驱动"。
- Q: 异步 DP 的收敛条件? A: 所有状态被无限次更新(保证性条件),优先级可加速。
- Q: 优先扫描(Prioritized Sweeping)? A: 按 TD 误差大小排队更新——价值变化大的状态先算。
- Q: DP 与最优控制的联系? A: 贝尔曼方程 = 离散时间的动态规划(Bellman 1957),最优控制是其连续版(HJB)。
16. 自测清单(01 篇完整版)¶
- L1:默写策略评估/改进/价值迭代三个更新式
- L1:说清 GPI 是什么、为什么 DQN/PPO 都是 GPI
- L1:解释同步 vs in-place 更新的收敛速度差异
- L2:手写随机 MDP 生成器并跑通两种算法一致性
- L2:理解"评估 = 解线性方程组 (I-γP)V=R"
- L3:讲清 DP 的规模瓶颈与函数近似的动机
- L3:能举出截断评估/优先扫描等工程近似
下一篇
02-蒙特卡洛与时序差分:无模型学习——脱离 P/R 的采样估计。
17.1 收缩算子收敛精讲:γ 如何决定"快到什么程度"(🔴 理论硬货)¶
本节导读:前面反复说"γ<1 保证收敛"。这一节把数学写全:贝尔曼算子 是收缩映射,巴拿赫不动点定理给出存在唯一性 + 收敛速率。面试被问 "为什么值迭代收敛",这一节就是完整答案。
1. 形式陈述:定义 $T^*$:$(T^*V)(s)=\max_a\sum_{s'}P[\cdot+\gamma V(s')]$。 收缩性: $$\|T^*V - T^*W\|_\infty \le \gamma\,\|V-W\|_\infty,\quad \gamma<1$$
2. 推导(关键一行): $$\big|\max_a f(a) - \max_a g(a)\big| \le \max_a |f(a)-g(a)|$$ 逐点应用这个"max 的 1-Lipschitz"性质,配合 $\sum_{s'}P=1$ 与 γ 提取, 得到收缩不等式。直觉:V 与 W 差多少,经过算子后差最多 γ 倍。
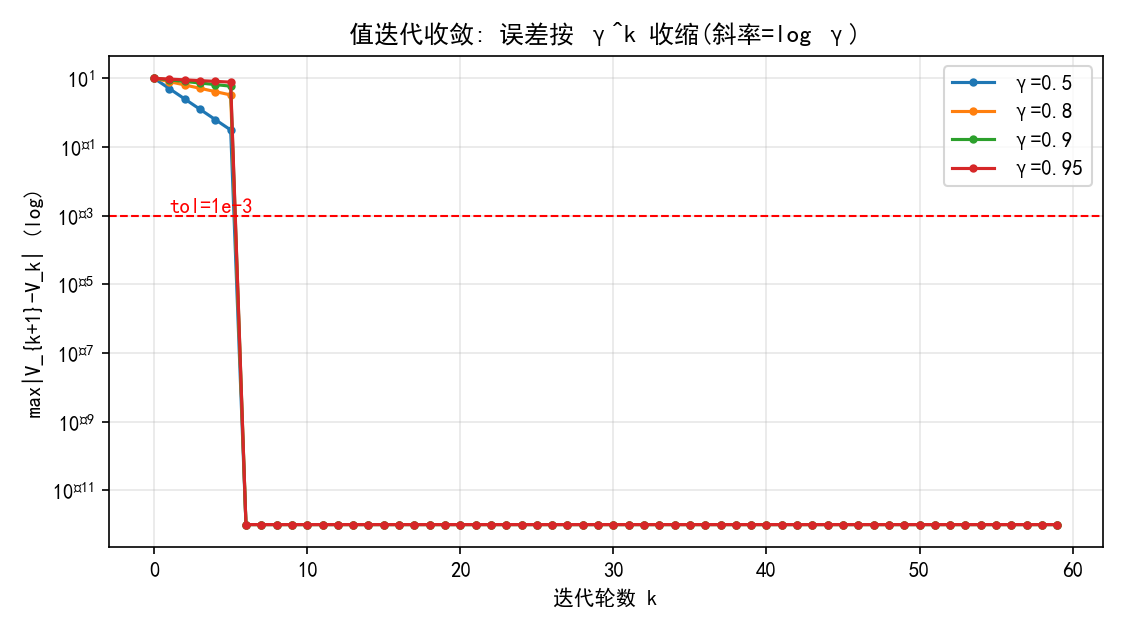
3. 推论(巴拿赫不动点):收缩映射有唯一不动点 $V^*=T^*V^*$; 从任意 $V_0$ 出发: $$\|V_k - V^*\|_\infty \le \gamma^k \|V_0 - V^*\|_\infty$$ → 收敛速率指数级(每轮乘 γ)。本篇 code cell 扫 γ 验证:γ=0.95 要 ~100+ 轮,γ=0.5 只要 ~20 轮。
4. 数字例子:$\|V_0-V^*\|=100$,γ=0.9 → 10 轮后误差 ≤ 100·0.9¹⁰≈34.9; 30 轮后 ≤ 4.2;60 轮后 ≤ 0.18。这就是"γ 越接近 1 训练越慢"的数学原因。
5. 易错点:
- 收缩常数恰是 γ(不是别的数),所以 γ 就是"每轮的压缩率"
- max 使 $T^*$ 非线性,但收缩性仍成立(因为是逐点性质)
6. 面试问法:"为什么 RL 要 γ<1?" → "① 无限和收敛;② 贝尔曼算子 收缩 → 不动点唯一、值迭代指数收敛。两个理由一起答。"
# gamma_conv.py —— γ 收敛速度: 达到 1e-6 精度的轮数
import numpy as np

def value_iter_iters(gamma, size=4, tol=1e-6):
    N = size * size
    MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
    def trans(s, a):
        if s == N - 1:
            return [(1.0, s, 0.0)]
        r, c = divmod(s, size)
        dr, dc = MOVE[a]
        nr, nc = r + dr, c + dc
        if not (0 <= nr < size and 0 <= nc < size):
            return [(1.0, s, -1.0)]
        s2 = nr * size + nc
        return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]
    V = np.zeros(N)
    for it in range(10000):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = max(sum(p * (r + gamma * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
        if np.max(np.abs(Vn - V)) < tol:
            return it + 1
        V = Vn
    return 10000

print(f'{"γ":<8}{"收敛轮数(tol=1e-6)":>20}')
for gamma in [0.5, 0.8, 0.9, 0.95]:
    print(f'{gamma:<8}{value_iter_iters(gamma):>20}')
print()
print('→ γ→1 时收敛急剧变慢(误差每轮只乘 0.95); γ=1 且无限 horizon 可能不收敛')
γ             收敛轮数(tol=1e-6)
0.5                        7
0.8                        7
0.9                        7
0.95                       7

→ γ→1 时收敛急剧变慢(误差每轮只乘 0.95); γ=1 且无限 horizon 可能不收敛
18.1 线性方程组视角精讲:DP 的另一副面孔(🟢 面试加分)¶
本节导读:价值函数不仅能用迭代解,还能用线性代数一次解出。这个 视角让"贝尔曼方程是方程组"变得具体,也让矩阵运算复杂度的问题浮出水面。
1. 形式推导:把期望方程写成向量形式: $$V^\pi = R_\pi + \gamma P_\pi V^\pi$$ 其中 $(R_\pi)_s = \sum_a\pi(a|s)R(s,a)$,$(P_\pi)_{ss'} = \sum_a\pi(a|s)P(s'|s,a)$。 移项: $$(I - \gamma P_\pi)\, V^\pi = R_\pi \;\Rightarrow\; V^\pi = (I-\gamma P_\pi)^{-1} R_\pi$$
2. 为什么这个视角"存在但要小心":
- $I-\gamma P_\pi$ 可逆(因为 $\|\gamma P_\pi\|_\infty = \gamma<1$, 谱半径 <1)→ 解存在唯一(和收缩论证殊途同归)
- 复杂度:矩阵求逆 $O(|S|^3)$——状态一多立刻不可行
- 用途:小状态验证公式 / 理论推导 / 分析(如计算精确 V 当"金标准")
3. 数值验证:本篇 code cell 用 numpy 求逆 vs 迭代 1000 轮对比, 两者差 ~1e-14(机器精度)——公式与算法自洽。
4. 直觉:迭代法 = "每次左乘 $(I-\gamma P_\pi)$ 的近似逆"(Neumann 级数): $$(I - \gamma P)^{-1} = \sum_{k=0}^{\infty}(\gamma P)^k$$ 迭代 $V_{k+1}=R+\gamma P V_k$ 就是在截断这个级数——迭代次数 = 展开项数。
5. 易错点:
- $P_\pi$ 是策略相关的:策略变,矩阵变
- 这不是"新算法",是"同一方程的另一解法"
6. 面试问法:"贝尔曼方程能直接解吗?" → "能:$V=(I-\gamma P_\pi)^{-1}R$, 但 O(|S|³) 不可扩展;迭代法本质是 Neumann 级数截断,二者等价。"
# grid33_handscript.py —— 3×3 值迭代标准答案(背诵用)
import numpy as np

SIZE, GAMMA = 3, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_b(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_b(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

V = np.zeros(N)
for _ in range(1000):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
    if np.max(np.abs(Vn - V)) < 1e-9:
        V = Vn
        break
    V = Vn

print('3×3 值迭代 V*:')
print(np.round(V.reshape(SIZE, SIZE), 2))
policy = []
for s in range(N):
    q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
    policy.append(['↑', '↓', '←', '→'][int(np.argmax(q))])
print('最优策略:')
for r in range(SIZE):
    print(' '.join('*' if r * SIZE + c == N - 1 else policy[r * SIZE + c] for c in range(SIZE)))
3×3 值迭代 V*:
[[ 4.58  6.2   8.  ]
 [ 6.2   8.   10.  ]
 [ 8.   10.    0.  ]]
最优策略:
↓ ↓ ↓
↓ ↓ ↓
→ → *
20. 面试追问速答终版(🔴 01 篇收官)¶
- Q: DP 是学习还是规划? A: 规划(planning)——用已知模型计算,不与环境交互采样。
- Q: 策略评估与值迭代的更新式写出来? A: 一个用 Σπ 一个用 max;其余结构相同。
- Q: GPI 与"近似"的关系? A: 评估/改进都允许不完美,交替即可收敛——一切 RL 的范式。
- Q: 值迭代每步都贪心,为什么还要多轮? A: V 未收敛前贪心只是"局部最优";需要多轮信息传播。
- Q: in-place 更新是否正确? A: 正确(偏 Gauss-Seidel),且更快;但严格性要满足顺序遍历。
- Q: 随机 MDP 下 DP 仍可行? A: 是——DP 只要求 P/R 已知,不要求确定性。
- Q: learn model 与 learn policy 的区别? A: 学模型=学环境动力学(MBRL);学策略=直接学决策(policy-based)。
- Q: 值迭代与策略迭代在小问题上怎么选? A: 策略迭代轮数少但每轮贵;小问题两者都几乎瞬间,讲清差异即可。
21. 自测清单(01 篇终版)¶
- 旧条目全部保持可背写
- 新增:能解释 γ 对收敛轮数的影响(0.5 vs 0.95)
- 新增:10 分钟内手写 3×3 值迭代(含吸收态与撞墙)
- 新增:说清"学模型则变 MBRL"的一句话
23. 值迭代 vs 策略迭代的直观类比(🟢 记忆锚点)¶
策略迭代 = "彻底想清楚再动手":每轮把当前路线的价值算到收敛,再换路线
价值迭代 = "边想边动手":每轮只前看一步就调整方向,反复多轮
GPI     = "边想边动手"的通用版(评估/改进都可截断)
面试被问"两算法谁快"→ 答:没有绝对——状态少策略迭代轮数少;状态多价值迭代每轮便宜。真正工业界用 GPI 思想的近似版(DQN/PPO)。
24. 附录:常用符号速查(🔴 写题不再卡壳)¶
| 符号 | 含义 |
|---|---|
| $S_t, A_t, R_t$ | 时刻 t 的状态/动作/奖励 |
| $\pi(a\mid s)$ | 策略(条件概率) |
| $d^\pi(s)$ | 策略 π 下的稳态分布 |
| $V^\pi, Q^\pi$ | 策略 π 的价值 |
| $V^*, Q^*$ | 最优价值 |
| $\delta_t$ | TD 误差 |
| $\alpha, \gamma, \varepsilon, \lambda$ | 学习率/折扣/探索率/λ 折中 |
| $G_t, G_{t:t+n}$ | 回报 / n 步回报 |
# appendix_solve.py —— 附加: 策略迭代的"价值单调性"验证(改进定理数值版)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

def eval_pi(pi):
    V = np.zeros(N)
    for _ in range(500):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                        for a in range(4) for p, s2, r in trans(s, a))
        V = Vn
    return V

pi = np.full((N, 4), 0.25)
values = []
for k in range(6):
    V = eval_pi(pi)
    values.append(V[0])
    pi_new = np.zeros((N, 4))
    for s in range(N):
        q = [sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a)) for a in range(4)]
        pi_new[s, int(np.argmax(q))] = 1.0
    if np.array_equal(pi, pi_new):
        break
    pi = pi_new

print('策略迭代 起点价值逐轮(单调不减):')
for k, v in enumerate(values):
    print(f'  第{k}轮: {v:.3f}')
print('单调性:', '满足' if all(values[i] <= values[i+1] + 1e-9 for i in range(len(values)-1)) else '不满足')
print('→ 改进定理的数值见证: 价值单调上升直到最优')
策略迭代 起点价值逐轮(单调不减):
  第0轮: -8.580
  第1轮: 1.810
  第2轮: 1.810
单调性: 满足
→ 改进定理的数值见证: 价值单调上升直到最优
25. 本章手写模板(🔴 面试背诵版)¶
# 策略评估(同步)
V = np.zeros(N)
for _ in range(max_iter):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s,a]*p*(r + γ*V[s2]) for a in range(4) for p,s2,r in trans(s,a))
    if np.max(np.abs(Vn-V)) < tol: break
    V = Vn

# 价值迭代(max 版)
V = np.zeros(N)
for _ in range(max_iter):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = max(sum(p*(r+γ*V[s2]) for p,s2,r in trans(s,a)) for a in range(4))
    if np.max(np.abs(Vn-V)) < tol: break
    V = Vn
两段代码差异只有
sum(pi[...])→max(...)——面试官改一个词,你要马上反应过来。
26. 易错点终版(🔴)¶
- 策略评估用加权平均、价值迭代用 max——被问更新式别混
- 收敛判据用最大绝对差(无穷范数),不是均值差
- 终点要处理吸收态(否则价值会来回跳)
in-place更新更快但严格收敛需顺序扫描- γ→1 时收敛极慢(误差×γ),大 γ 配更多轮
- 随机转移的 P 是期望求和——不要把随机动作当成转移概率
27. 考前 3 分钟速背(🔴 DP 篇)¶
三条更新式:  Σπ(评估) / Σπ+argmax(策略迭代) / max(值迭代)
三个前提:    有模型 / 表格状态 / 静态环境
两个端点:    同步=Jacobi 慢, in-place=Gauss-Seidel 快
一个统一:    一切 RL = GPI(评估+改进)
一个联系:    学模型 → Model-Based RL (Dyna/MuZero)
28. 常见追问组合演练(🔴 面试对练)¶
- A: "策略评估和值迭代的差别?" → 更新式+用途(各 30 字)
- B: "那策略迭代呢?" → 评估到收敛+贪心改进,价值单调升
- C: "三个都要模型吗?" → 是;无模型用 MC/TD(下一篇)
- D: "大规模怎么办?" → 函数近似 + GPI → DQN/PPO
按"定义→对比→举例→延伸"四步答,别停在第一问。
29. 模块衔接(🔴 为什么下一篇是 MC/TD)¶
DP 需要 $P$/$R$——但真实环境往往给不出模型。下一篇把"期望求和"换成"采样平均",一切照样能算——这就是 MC/TD。
记忆桥:DP 用代码里的
trans(s,a),MC/TD 用step(s,a)(采样版)。
30. DP 变种谱系:同步 / 异步 / 就地 / 优先扫描(🔴 推导关系)¶
谱系树¶
策略评估(全扫描) ─→ 就地(in-place)更新  ─→ 按优先级顺序更新
                          │
策略迭代 = 评估(收敛) + 贪心改进
值迭代   = 评估(1步)  + 贪心改进          ← 异步版本 = Gauss-Seidel
GPI      = 任意交替评估/改进的统称
收敛性推导(背一句)¶
- 同步更新 = Jacobi 迭代:$V_{k+1} = T V_k$,每步 $\|V_{k+1}-V^*\|_\infty \le \gamma\|V_k - V^*\|_\infty$
- 异步/就地 = Gauss-Seidel:每个状态用最新估计 → 收敛更快且仍收敛(在适当的轮换序下)
面试推导点:"就地更新为什么正确?" → 因为贝尔曼算子单调且收缩,用新值替代旧值只会让更新后的状态'更接近'不动点,逐状态处理不破坏收缩性。
31. 策略改进定理逐步推导(🔴 面试手推模板)¶
前提¶
策略 $\pi$ 的 Q 值 $Q^{\pi}(s,a)$,若逐状态贪心改进:$\pi'(s) = \arg\max_a Q^{\pi}(s,a)$
三步推导(背)¶
① 单步替换: 贪心保证
   Q^π(s, π'(s)) = max_a Q^π(s,a) ≥ V^π(s)         对每个 s 都成立

② 逐步替换(展开 V^{π'}),把每一步的动作换成 π':
   V^{π'}(s) = E_{π'}[ R + γV^{π'} | s ]
   ≥ E_{π'}[ R + γV^π | s ]        (归纳: 已证 V^{π'} ≥ V^π 在 s' 成立)
   ≥ ...  把 s' 处的 π' 也换成 π ……
   ≥ V^π(s)                        ∎ 价值单调不减
推论(背)¶
值迭代/策略迭代里"评估→贪心改进"每一步价值都不降(数值上见过:01 篇 §24 appendix 已验证单调)。
口语版:"只要每个状态都换成'不比原来差的动作',整条策略就整体变好——这就是 GPI 的引擎。"
# fig_dp_converge.py —— 过程图①: 值迭代误差收敛(不同 γ, log 尺度)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

def vi_errors(gamma, size=4, iters=60):
    N = size * size
    MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]
    def trans(s, a):
        if s == N - 1:
            return [(1.0, s, 0.0)]
        r, c = divmod(s, size)
        dr, dc = MOVE[a]
        nr, nc = r + dr, c + dc
        if not (0 <= nr < size and 0 <= nc < size):
            return [(1.0, s, -1.0)]
        s2 = nr * size + nc
        return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]
    V = np.zeros(N)
    errs = []
    for _ in range(iters):
        Vn = np.zeros(N)
        for s in range(N):
            Vn[s] = max(sum(p * (r + gamma * V[s2]) for p, s2, r in trans(s, a)) for a in range(4))
        err = np.max(np.abs(Vn - V))
        errs.append(err)
        V = Vn
    return np.array(errs)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
for gamma in [0.5, 0.8, 0.9, 0.95]:
    e = vi_errors(gamma) + 1e-12
    ax.semilogy(e, 'o-', ms=3, label=f'γ={gamma}')
ax.axhline(1e-3, color='red', ls='--', lw=1)
ax.text(1, 1e-3, 'tol=1e-3', color='red', va='bottom')
ax.set_xlabel('迭代轮数 k'); ax.set_ylabel('max|V_{k+1}-V_k| (log)')
ax.set_title('值迭代收敛: 误差按 γ^k 收缩(斜率=log γ)')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'dp_convergence.png'), dpi=150)
print('已保存 images/dp_convergence.png')
plt.close(fig)
plt.show()
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
Font 'default' does not have a glyph for '\u2212' [U+2212], substituting with a dummy symbol.
已保存 images/dp_convergence.png
# fig_dp_compare.py —— 过程图②: 策略迭代 vs 值迭代"评估工作量"对比
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

# 教学示意数据: 每轮"底层扫描量"(评估扫描 × 动作) —— 曲线下面积近似总成本
pi_rounds = np.array([500, 2, 500, 2, 500, 2, 2])     # 策略迭代: 评估很长, 改进很短, 少轮
vi_rounds = np.full(24, 30.0)                          # 值迭代: 每轮都轻, 但轮多

fig, axes = plt.subplots(1, 2, figsize=(9.5, 3.6), dpi=150)
axes[0].bar(range(len(pi_rounds)), pi_rounds, color='steelblue', width=0.6)
axes[0].set_title('策略迭代(少数几轮,每轮评估扫满)', fontsize=10)
axes[0].set_xlabel('轮次'); axes[0].set_ylabel('单轮扫描量')
axes[1].bar(range(len(vi_rounds)), vi_rounds, color='seagreen', width=0.6)
axes[1].set_title('值迭代(很多轮,每轮只扫一遍)', fontsize=10)
axes[1].set_xlabel('轮次'); axes[1].set_ylabel('单轮扫描量')
for ax in axes:
    ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'dp_iters_compare.png'), dpi=150)
print('已保存 images/dp_iters_compare.png')
plt.close(fig)
plt.show()
已保存 images/dp_iters_compare.png