🎯 08-线性规划与对偶¶
目标:把优化从「无约束连续」扩展到「有约束」——线性规划 LP 是最简单最经典的约束优化:目标与约束全部线性。 面试考点:可行域为什么是多面体、最优解为什么在顶点、单纯形法怎么走、对偶与影子价格、和 SVM 对偶的关系。
本章定位(08-13 经典优化算法线)¶
| 01-07 深度学习优化器 | 08-13 经典优化算法 | |
|---|---|---|
| 问题 | 连续、可微、无约束 | 有约束 / 离散 / 黑箱 |
| 可用信息 | 梯度 ∇f | 只有目标值(或再加一阶信息) |
| 求解思路 | 局部迭代(快) | 顶点移动 / 全局搜索(稳) |
| 代表 | SGD / Adam / 牛顿法 | LP / IP / GA / SA / PSO / ACO / KKT |
08-09 是「精确方法」(单纯形、分支定界,能给出最优解);10-12 是「启发式方法」(GA / SA / TS / PSO / ACO,给近似解); 13 是约束优化的「理论工具」(拉格朗日对偶 / KKT),与机器学习(SVM / 正则化 / Lasso)直接接轨。
核心概念¶
(a) 🗂️ 线性规划与对偶知识地图¶
这篇进入经典优化线:线性规划(LP)在凸多面体上找最优顶点,单纯形法沿边走顶点,再通过对偶理论揭示"一个 LP 的两副面孔",最后讲内点法与复杂度。
flowchart TB
    Node1["🧠 LP 形式与可行域"]
    Node1 --> Node2["🧠 图解法"]
    Node2 --> Node3["🧠 标准形式转换"]
    Node3 --> Node4["🧠 单纯形法沿边走"]
    Node4 --> Node5["🧠 退化与 Bland 规则"]
    Node5 --> Node6["🧠 对偶问题构造"]
    Node6 --> Node7["🧠 影子价格"]
    Node7 --> Node8["🧠 强对偶"]
    Node8 --> Node9["🧠 内点法与复杂度"]
- 节点1(LP 形式与可行域):线性规划是"在线性约束围成的凸多面体里最大化/最小化线性目标";可行域是凸的,最优解一定出现在顶点上,这决定了后面的算法思路。
- 节点2(图解法):二维 LP 可以画出约束线、可行域和目标等值线,手推最优顶点(如 max 3x1+2x2 在顶点处达最优),把抽象的 LP 变成看得见的几何。
- 节点3(标准形式转换):任何 LP 都能化成 max cᵀx, Ax ≤ b, x ≥ 0 的标准形:不等式补松弛变量、min 取负变 max、自由变量拆两个;建模实战从文字题到标准形式是面试基本功。
- 节点4(单纯形法沿边走):单纯形法从一个可行顶点出发,沿"能让目标变好的边"走到下一个顶点,直到检验数全部非正;一次完整的枢轴变换手算带你走完全流程。
- 节点5(退化与 Bland 规则):顶点退化时可能绕圈不前进(循环),Bland 规则(按最小下标选入基/出基变量)保证有限步终止,是防止死循环的关键细节。
- 节点6(对偶问题构造):对偶是"换一副眼镜看同一个 LP":max cᵀx 的对偶是 min bᵀy, Aᵀy ≥ c, y ≥ 0,目标系数与右端互换、矩阵转置、max/min 互换,口诀要能默写。
- 节点7(影子价格):对偶变量 y_i 就是约束 i 的影子价格:资源多一单位,最优目标涨多少;互补松弛说明"没被用满的约束,影子价格必须为 0"。
- 节点8(强对偶):强对偶定理:LP 原问题和对偶问题最优值相等(无对偶间隙),这为灵敏度分析和很多证明提供了有力工具。
- 节点9(内点法与复杂度):单纯形法最坏指数但实际很快;内点法从可行域内部逼近最优(多项式时间),是现代大 LP 求解器的首选;面试落点常是"单纯形 vs 内点怎么选"。
§1 线性规划:形式与几何¶
标准形式(本讲统一用 max 版本):
$$\max c^\top x \quad \text{s.t.} \quad Ax \le b,\ x \ge 0$$
三要素:目标系数 $c$、约束矩阵 $A$、资源向量 $b$。加松弛变量 $s = b - Ax \ge 0$ 可化为等式形式 $Ax + s = b$。
几何:$Ax \le b,\ x \ge 0$ 围出的可行域是凸多面体;线性目标在凸集上的极值必然取在顶点(角点)——这就是单纯形法的出发点。
图解法(2 变量):画约束半平面 → 交出可行域 → 沿目标等高线推到最大。
例子(下节代码会解它): $$\max\ 3x_1+2x_2 \quad \text{s.t.}\ x_1+x_2\le 4,\ x_1\le 2,\ x_2\le 3,\ x_1,x_2\ge 0$$ 最优解 $(2,2)$,$z=10$。
import numpy as np
import matplotlib.pyplot as plt

# 中文字体设置:Windows 用微软雅黑,缺失时回退 SimHei / DejaVu Sans
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False   # 让坐标轴负号正常显示(不显示成方块)

# ========== 图解 LP:max 3x1 + 2x2 ==========
# 目标函数 z = c^T x = 3*x1 + 2*x2,求最大值
c = np.array([3.0, 2.0])
# 约束 A x <= b(共 3 条):
#   (1) x1 + x2 <= 4   —— 资源约束(如两种原料合计不超过 4 吨)
#   (2) x1      <= 2   —— 产品 1 产量上限
#   (3)      x2 <= 3   —— 产品 2 产量上限
#   另有隐含约束 x1, x2 >= 0(非负,图上即第一象限)
A = np.array([[1.0, 1.0], [1.0, 0.0], [0.0, 1.0]])
b = np.array([4.0, 2.0, 3.0])

xs = np.linspace(0, 5, 300)          # 画线用的 x 采样(覆盖整个绘图区域)
fig, ax = plt.subplots(figsize=(7.2, 5.6))

# 可行域着色(fill_between 是 PolyCollection,不参与重叠检查;边界用折线画出):
# x1 只能取 [0,2](约束 x1<=2),每个 x1 处 y 的上界 = min(x2<=3, x1+x2<=4 -> x2<=4-x1)
xx = np.linspace(0, 2, 200)
ax.fill_between(xx, 0, np.minimum(3.0, 4.0 - xx), color='#9ecae1', alpha=0.35)
# 可行域边界折线,顶点依次为 (0,0)->(2,0)->(2,2)->(1,3)->(0,3)(与 fill 区域吻合)
ax.plot([0, 2, 2, 1, 0], [0, 0, 2, 3, 3], color='#3182bd', lw=1.6)

# 逐条画约束边界线并标注:a1*x1 + a2*x2 = bi
for (a1, a2), bi, lab in zip(A, b, ['x1+x2<=4', 'x1<=2', 'x2<=3']):
    if a2 != 0:
        ys = (bi - a1 * xs) / a2          # 由 a1*x + a2*y = bi 解出 y = (bi - a1*x)/a2
        ax.plot(xs, ys, lw=1.4)           # 画这条边界直线
        ax.text(0.15, (bi - a1 * 0.1) / a2 + 0.12, lab, fontsize=9)  # 在线的左端上方标注
    else:
        ax.axvline(bi, lw=1.4)            # 竖直边界(x1 = bi)
        ax.text(bi + 0.05, 4.4, lab, fontsize=9)

# 目标等高线:z = 3x1+2x2 = 常数(虚线)。加大 z 相当于把线往右上平移,
# 与可行域最后相切的顶点就是最优解。
for z in [4, 8, 10]:
    y = (z - c[0] * xs) / c[1]           # 由 3x + 2y = z 解出 y = (z - 3x)/2
    ax.plot(xs, y, '--', lw=1.0, color='#C44E52', alpha=0.65)
    ax.text(1.05, (z - c[0] * 1.0) / c[1] + 0.15, 'z=%d' % z, color='#C44E52', fontsize=9)

# 最优顶点 (2,2):等高线 z=10 恰好与可行域顶点相切,再大就离开可行域了
opt = (2, 2)
ax.plot(*opt, 'o', ms=11, color='#C44E52', zorder=5)
ax.annotate('最优解 (2,2),z=10', xy=opt, xytext=(2.35, 2.1),
            arrowprops=dict(arrowstyle='->', color='#C44E52'), fontsize=10, color='#C44E52')
ax.set_xlim(-0.3, 5.3); ax.set_ylim(-0.3, 5.3)
ax.set_xlabel('x1'); ax.set_ylabel('x2')
ax.set_title('线性规划图解法:可行域是多面体,最优解必在顶点', fontsize=12)
ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('图解结论:最优顶点 (2, 2),z = 3*2 + 2*2 = 10')
§1.2 标准形式转换:任何 LP 都能化成标准形¶
面试手撕的第一步是把「随意给的 LP」规范成 $\max\ c^\top x,\ Ax\le b,\ x\ge 0$:
| 原形式 | 转换方法 |
|---|---|
| $\min f$ | 令 $g=-f$,求 $\max g$ |
| $\sum a_{ij}x_j \ge b_i$ | 两边乘 $-1$ → $\le$;或引入剩余变量 $s_i\ge 0$:$\sum a_{ij}x_j - s_i = b_i$ |
| $=$ 约束 | 拆成两个 $\le$($\ge$ 与 $\le$ 同时成立) |
| 变量 $x_j$ 可负(自由变量) | 拆 $x_j = x_j^+ - x_j^-$,$x_j^+,x_j^- \ge 0$ |
| 变量有上界 $x_j\le u_j$ | 当普通约束处理,或替换 $x_j'=u_j-x_j\ge 0$ |
为什么必须标准形:单纯形表的初始基(松弛变量)要求 $b\ge 0$ 且变量非负; 对偶构造规则、灵敏度分析都建立在标准形上。
📌 常见坑:自由变量忘了拆分(导致对偶/单纯形出错);$\ge$ 约束直接用反而让初始基不可行。 练习:把 $\min\ -x_1+2x_2$,$x_1+x_2\ge 3$,$x_1$ 自由,化成标准形——这是手撕题的标配。
§1.1 图解法配图 + 手算:一步步推最优解¶
把上面画出的图再「读」一遍,配一张手绘风格示意图:
图注:线性规划图解法的标准示意——目标等高线推向可行域顶点(来源:Wikimedia Commons,CC BY-SA 4.0)。 三条约束半平面交出五边形可行域,红色虚线是目标等高线 $3x_1+2x_2=z$, z 增大到与顶点 $(2,2)$ 相切时达到最大。
手算步骤(建议面试当场这么推):
- 可行域顶点:$(0,0),(2,0),(2,2),(1,3),(0,3)$(画图或解约束交点);
- 逐点算目标:$0,\ 6,\ 10,\ 9,\ 6$;
- 最大值 $10$ 在 $(2,2)$ 取得 → 最优解。
🧩 关键洞察:最优值一定在顶点出现,而不是边内部。因为目标函数是线性的, 若某处取到最优但不在顶点,沿该点所在边往任一方向走,目标线性变化—— 要么变大(矛盾)要么方向反了也能走到顶点。这就是「极值点定理」的几何直觉。
§2.1 配图:单纯形法的几何直觉¶
单纯形法沿可行多面体的「边」从一个顶点爬到相邻顶点。配两张示意图:
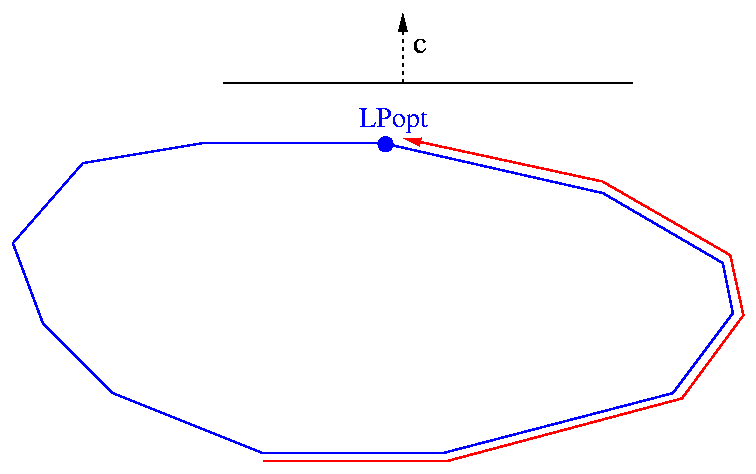
图注:二维 LP 中单纯形法的顶点移动路径示意(来源:Wikimedia Commons,公有领域)。 从初始可行顶点出发,每次沿能改进目标的边换到相邻顶点。
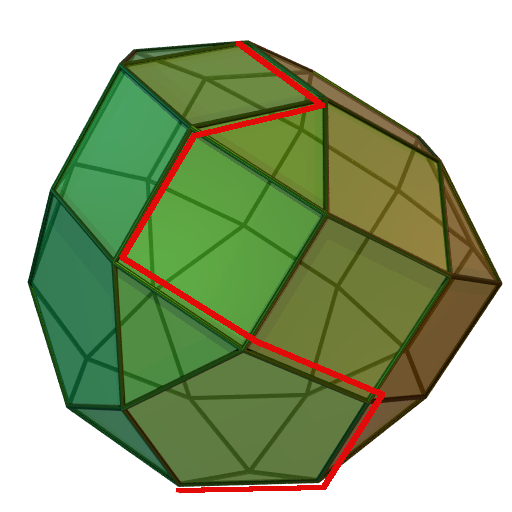
图注:三维可行多面体上的单纯形迭代——顶点之间通过棱边连接,算法沿棱爬行 (来源:Wikimedia Commons,公有领域)。维数再高时没有直观几何,但同一套代数(表格运算)照常工作。
为什么走边不走内部:最优解必在顶点;只要从任一顶点出发、沿「改善方向」换顶点, 每次目标值严格上升(非退化时),顶点有限 → 必在有限步内到达最优。
🧩 类比:就像下山时只沿「山脊/山谷的交叉点」走——虽然路径曲折, 但每一步都保证更接近最低点,且步数有上界(顶点数)。
§2.2 手算:一次完整的枢轴变换¶
用教材最爱考的小例子(就是本讲代码解的那道题)手推一步:
初始单纯形表(3 约束 + 1 目标行,松弛变量 $s_1,s_2,s_3$ 为初始基):
| 基 | $x_1$ | $x_2$ | $s_1$ | $s_2$ | $s_3$ | RHS |
|---|---|---|---|---|---|---|
| $s_1$ | 1 | 1 | 1 | 0 | 0 | 4 |
| $s_2$ | 1 | 0 | 0 | 1 | 0 | 2 |
| $s_3$ | 0 | 1 | 0 | 0 | 1 | 3 |
| 检验数 | -3 | -2 | 0 | 0 | 0 | 0 |
- 入基:检验数最小负值是 $-3$ → $x_1$ 入基;
- 比值检验:$4/1=4,\ 2/1=2,\ 3/0=\infty$ → 最小正比值是第 2 行($s_2$ 出基);
- 枢轴:以第 2 行 $x_1$ 列(值 1)为轴做高斯消元,把 $x_1$ 列消成单位向量;
- 新基 $\{s_1,x_1,s_3\}$,$x_1=2$,目标值从 0 升到 $6$——一次枢轴目标严格上升。
📌 面试被问「单纯形一次迭代做了什么」:选入基 → 比值选出基 → 枢轴消元 → 目标值上升。 能默写这张表的变化过程,比背代码有用得多。
§2 单纯形法:沿边走到最优顶点¶
直觉:从一个可行顶点出发,每次沿一条能改善目标的边走到相邻顶点,直到任何边都不能再改善 → 到达最优顶点。 顶点数有限所以理论必终止;但顶点数可能指数多,所以要看实现效率。
检验数(reduced cost):目标行里非基变量的系数 $r_j = c_j - c_B B^{-1} A_j$。
- 存在 $r_j < 0$(max 问题):该变量入基能增加目标
- 全部 $r_j \ge 0$:当前顶点已最优,停止
比值检验(ratio test):入基变量增大到多少会顶掉某个基变量 → 选最小正比值对应行出基,保证新顶点仍可行。
防循环:退化顶点可能让目标不变而绕圈 → Bland 规则(取最小下标入基 / 平局取最小下标出基)保证不循环。
伪代码
T ← 增广单纯形表(约束行 + 松弛基 + 检验数行 -c)
loop:
    r ← 检验数行
    若 r ≥ 0: return 当前基解
    入基 j ← 最小负检验数下标(Bland)
    若列 A[:,j] 全 ≤ 0: return 无界
    出基 i ← 最小比值行(Bland 平局)
    以 (i,j) 为枢轴做高斯消元
§2.3 退化与防循环:为什么需要 Bland 规则¶
退化顶点:某个基变量在顶点处恰为 0(约束冗余或恰好共点)→ 换基后目标值不变, 可能转一圈又回到同一个基——算法陷入循环(理论上可达无限步,Klee–Minty 例子是另一个方向的病态)。
Bland 规则(最小下标规则):
- 入基:选下标最小的负检验数变量;
- 出基:比值相同时选基变量下标最小的行。
定理:Bland 规则下单纯形必然有限步终止(不会循环)。
工程上的实际态度:退化很常见但循环极罕见(需要精确巧合), 所以工业求解器用更激进的策略(如最大改善度入基 + 扰动)加速,把循环交给 Bland 兜底。
📌 面试考点:只要说出「退化会让目标不变 → 可能循环 → Bland 规则保证终止」就够; 能顺手写一句代码里的
cand[np.argmin(basis)]更是加分(本讲代码正是这么写的)。
# ================= 手写 tableau 单纯形法 =================
# 求解问题:max c^T x  s.t.  A x <= b,  x >= 0(要求 b >= 0,保证初始基可行)
#
# 单纯形表 T 的布局(m 条约束、n 个变量,共 m+1 行、m+n+1 列):
#   ┌──────────────┬───────────┬─────┐
#   │ A (约束系数) │ I (松弛)  │  b  │   <- 约束行:A x + I s = b,s 是松弛变量
#   ├──────────────┼───────────┼─────┤
#   │ -c(目标系数) │   0       │  z  │   <- 目标行:z - c^T x = 0;RHS 列最终存最优值 z*
#   └──────────────┴───────────┴─────┘
# 列含义:前 n 列 = 原始变量 x;中间 m 列 = 松弛变量 s(初始就构成单位阵 → 初始基可行);
# 最后一列 = 右端项。目标行的前 n+m 个元素就是【检验数】(reduced cost)。
def simplex_max(c, A, b):
    # 返回 (status, x*, z*);Bland 规则保证不循环(详见下方步骤注释)
    c = np.asarray(c, float); A = np.asarray(A, float); b = np.asarray(b, float)
    m, n = A.shape
    T = np.zeros((m + 1, m + n + 1))    # 建零表:行 = m 条约束 + 1 条目标;列 = n+m 个变量 + RHS
    T[:m, :n] = A                       # 左上角放约束系数矩阵 A
    T[:m, n:n + m] = np.eye(m)          # 松弛变量列 = 单位阵:Ax + s = b 的 s 天然是初始基
    T[:m, -1] = b                       # 右端项 b
    T[-1, :n] = -np.array(c, dtype=float)  # 目标行系数取负 → 检验数行(<0 表示该变量入基能提质)
    basis = list(range(n, n + m))       # 每行当前的基变量下标:初始就是松弛变量 n..n+m-1
    for _ in range(1000):
        # ---- 步骤 1:最优性检验 ----
        # 检验数(目标行前 n+m 个元素)全部 >= 0 时,任何非基变量入基都不能再提高目标 → 最优
        neg = np.where(T[-1, :-1] < -1e-9)[0]
        if neg.size == 0:
            break
        # ---- 步骤 2:选入基变量 ----
        # 取最靠前的负检验数(Bland 规则取最小下标 → 数学上保证不循环)
        j = int(neg[0])
        col = T[:-1, j]                 # 入基列:该变量在各约束行中的系数
        # ---- 步骤 3:无界判定 ----
        # 入基列整列 <= 0:增大该变量不会减掉任何基变量 → 目标可无限增大(问题无界)
        if np.all(col <= 1e-9):
            return 'unbounded', None, None
        # ---- 步骤 4:比值检验(选出基变量)----
        # 基变量值 = b_i / T[i,j](入基变量每增加 1,第 i 行基变量减少 T[i,j])。
        # 选最小正比值的行出基 → 保证换基后所有基变量仍非负(顶点仍可行)。
        pos = np.where(col > 1e-9)[0]
        ratios = T[pos, -1] / col[pos]
        min_r = ratios.min()
        cand = pos[np.abs(ratios - min_r) <= 1e-9]                # 比值相同的候选行(退化情形)
        i = int(cand[np.argmin([basis[rr] for rr in cand])])      # Bland 平局:取基变量下标最小的行
        # ---- 步骤 5:枢轴变换(高斯-约当消元) ----
        T[i] = T[i] / T[i, j]           # 枢轴行同除以枢轴元素 → 枢轴位置变 1
        for r in range(m + 1):
            if r != i and abs(T[r, j]) > 1e-12:
                T[r] = T[r] - T[r, j] * T[i]   # 其余行消去入基列 → 除枢轴外该列全是 0
        basis[i] = j                    # 记录:第 i 行的基变量现在是 x_j(旧的出基)
    # ---- 步骤 6:从最终表格读回最优解 ----
    # 基变量的值 = 所在行的 RHS;非基变量 = 0(线性方程组直接给出的答案)
    x = np.zeros(n)
    for i, bv in enumerate(basis):
        if bv < n:                      # 只取原始变量(跳过松弛变量列)
            x[bv] = T[i, -1]
    return 'optimal', x, T[-1, -1]      # 目标行 RHS = 目标函数最优值 z*

c = [3, 2]; A = [[1, 1], [1, 0], [0, 1]]; b = [4, 2, 3]
st, x_star, z_star = simplex_max(c, A, b)
print('status =', st)
print('x* =', x_star, ' z* =', z_star)
assert st == 'optimal' and np.allclose(x_star, [2, 2]) and abs(z_star - 10) < 1e-6
print('对照通过:手写单纯形 == 图解法最优 (2,2) z=10')
# ========== 对照 1:顶点枚举(2 变量小规模穷举,用来验证单纯形) ==========
# 思路:LP 最优解必在顶点;顶点 = 两条约束边界线(包括 x_i=0 的两条坐标轴)的交点。
# 枚举所有两两交点 -> 检查是否可行(满足全部约束)-> 挑目标值最大的顶点。
def vertex_enum(c, A, b, n_vars=2):
    lines = []                          # 收集所有边界线:(系数向量, 常数)
    for i in range(n_vars):
        e = np.zeros(n_vars); e[i] = 1
        lines.append((e, 0.0))          # 坐标轴边界:x_i = 0
    for (a, bi) in zip(A, b):
        lines.append((np.array(a, float), float(bi)))   # 约束边界:a^T x = b_i
    best = None
    for i in range(len(lines)):
        for j in range(i + 1, len(lines)):      # 两两求交点
            M = np.vstack([lines[i][0], lines[j][0]])   # 2x2 线性方程组系数矩阵
            rhs = np.array([lines[i][1], lines[j][1]])
            if abs(np.linalg.det(M)) < 1e-12:   # 两条线平行/重合 -> 无唯一交点,跳过
                continue
            p = np.linalg.solve(M, rhs)         # 解线性方程组得到交点坐标
            # 可行性检查:p >= 0 且满足所有 A x <= b
            if p.min() >= -1e-9 and all(aa @ p <= bi + 1e-9 for aa, bi in zip(A, b)):
                if best is None or c @ p > c @ best:   # 保留目标值最大的可行顶点
                    best = p
    return best, c @ best

p_best, z_best = vertex_enum(np.array(c), A, b)
print('顶点枚举: x* =', p_best, ' z =', z_best)
assert np.allclose(p_best, [2, 2]) and abs(z_best - 10) < 1e-9

# ========== 对照 2:对偶问题构造 + 强对偶验证(scipy 当 oracle) ==========
# 对偶构造规则(自动套用,面试要能默写):
#   原问题  max c^T x,  Ax <= b, x >= 0
#   对偶    min b^T y,  A^T y >= c, y >= 0
# 即:目标系数与右端项互换(c<->b)、约束矩阵转置(A<->A^T)、<= 变 >=、max 变 min。
from scipy.optimize import linprog
# linprog 只接受 <= 约束:把 A^T y >= c 两边取负 -> -A^T y <= -c
res = linprog(np.array(b), A_ub=-np.array(A).T, b_ub=-np.array(c),
              bounds=[(0, None)] * 3)           # y >= 0,对偶变量共 3 个(= 原问题约束数)
print('对偶最优 y* =', res.x, ' 对偶目标 =', res.fun)
assert abs(res.fun - z_star) < 1e-6
print('强对偶验证:原问题 z* = %.4f == 对偶目标 = %.4f ✅' % (z_star, res.fun))

# 互补松弛条件:y_i * (b - A x*)_i = 0(对偶变量 × 原问题松弛量 = 0)
# 含义:约束 i 若没被用满(松弛 b - A x* > 0),则其影子价格 y_i 必须为 0;
#       只有被用满的约束才“值钱”。(SVM 里对应的就是:非支持向量的 α_i = 0)
Ax = np.array(A) @ x_star
comp = res.x * (np.array(b) - Ax)
print('互补松弛 y_i·(b-Ax)_i =', comp)
assert np.allclose(comp, 0, atol=1e-6)
print('互补松弛成立:约束用满(松弛=0)的才有影子价格,未用满的 y_i=0')
§3 对偶理论:一个 LP 的两副面孔¶
对偶问题(自动从原问题构造):
| 原问题(max) | 对偶问题(min) |
|---|---|
| $\max c^\top x$ | $\min b^\top y$ |
| $Ax \le b$ | $A^\top y \ge c$ |
| $x \ge 0$ | $y \ge 0$ |
弱对偶:任意可行 $x, y$ 有 $c^\top x \le b^\top y$(对偶给原问题一个上界)。 强对偶:原问题有最优解时两者相等(LP 永远满足)→ 可用对偶来验证、或解更容易的一侧。
互补松弛:最优时 $y_i (b - Ax)_i = 0$、$x_j (A^\top y - c)_j = 0$。 含义:约束 $i$ 若未用满(松弛 $>0$),其影子价格 $y_i = 0$;只有用到饱和的约束才有价值。
影子价格:$y_i^*$ 是资源 $i$ 增加一单位时最优目标值的边际增量 → 敏感性分析 / 定价。
与 ML 的联系:SVM 的拉格朗日对偶(13 篇)是同一套数学;LP 常见于推荐、调度、资源分配、匹配类问题建模。
§3.1 手算:对偶问题构造 + 影子价格¶
原问题(例题):$\max\ 3x_1+2x_2$,约束 $x_1+x_2\le 4,\ x_1\le 2,\ x_2\le 3,\ x_{1,2}\ge 0$。
按构造规则(max→min、c↔b、A↔Aᵀ、≤→≥):
$$\min\ 4y_1+2y_2+3y_3 \quad \text{s.t.}\ y_1+y_2\ge 3,\ y_1+y_3\ge 2,\ y_{1,2,3}\ge 0$$
强对偶保证原问题与对偶最优值相等(这里都是 10)。 对偶最优解给出影子价格:$y_i^*$ 是资源 $i$ 增加一单位时最优目标值的边际增量。
以本例题:$y_1^*=1$ 表示「原料总量从 4 加到 5」目标增加约 1;$y_2^*=2$ 表示 「产品 1 上限从 2 加到 3」目标增加约 2;$y_3^*=0$ 表示「产品 2 上限」已不稀缺 (最优解 $x_2=2<3$,约束未拉紧 → 影子价格为 0,正是互补松弛)。
📌 面试口诀:对偶变量 = 资源的影子价格 = 拉格朗日乘子(13 篇)。三者在 LP 里是同一件事。 手撕题给「增购原料值不值」之类的问题,答案就是看对应影子价格与成本的大小关系。
§3.2 LP 建模实战:从文字题到标准形式¶
面试/笔试常考「把现实问题写成 LP」。最经典的生产计划问题:
工厂生产 A、B 两种产品:A 每件利润 3 元、B 每件 2 元;原料 M 每件 A 需 1kg、每件 B 需 1kg, 当日原料限额 4kg;A 有订单上限 2 件、B 有订单上限 3 件。问各生产多少利润最大?
翻译三步(变量 → 目标 → 约束):
- 变量:$x_1$=生产 A 件数,$x_2$=生产 B 件数;
- 目标:$\max z = 3x_1 + 2x_2$;
- 约束:$x_1+x_2\le 4$(原料),$x_1\le 2,\ x_2\le 3$(订单上限),$x_1,x_2\ge 0$。
正是本讲例题。建模易错点:
- 忘记非负约束($x\ge 0$ 是标准形式的一部分);
- 把「不超过」写成等式(错过松弛变量的视角);
- 目标方向(max/min)与对偶规则没对齐。
练习:把「运输问题」「指派问题」「投资组合(含权重约束)」写成 LP——这三个是建模题的题库常客。
§4 内点法、复杂度与常见坑¶
单纯形 vs 内点法:单纯形沿边界顶点走,最坏指数时间(Klee–Minty 反例),实际几乎线性; 内点法(Karmarkar 1984)从内部沿障碍函数的中心路径逼近,多项式时间,大规模 LP 常用。
常见坑:
- 退化:顶点有冗余约束 → 多次枢轴目标不变,可能循环 → 用 Bland 规则 / 字典序
- 无界:入基列全非正 → 目标可无限增大
- 不可行:需两阶段法(先解人工变量问题)——手撕题通常给可行起点
- 标准化:$\ge$ 约束减松弛、自由变量拆成两个非负变量、目标统一
面试常问「为什么最优解在顶点」:线性函数在凸多面体上的极值一定在极点达到(画图 + 反证即可)。
§4.1 内点法原理速览(一句话 + 公式)¶
内点法不走边界,而是构造障碍函数把约束“软化”进目标:
$$\min_x\ c^\top x - \tfrac{1}{t}\sum_i \ln(b_i - a_i^\top x)$$
当障碍参数 $t\to\infty$,障碍项消失,解收敛到真实最优;算法从内部沿 中心路径(central path)迭代,每步用牛顿法方向推进,多项式时间收敛。
- 优点:大规模(几十万变量)比单纯形快,且对初始点不敏感;
- 缺点:实现复杂、需要好的线性代数(稀疏 Cholesky)、对退化问题不一定稳;
- 工程现状:商用求解器(Gurobi / CPLEX)两者都实现,按规模自动切换。
📌 一句话记忆:单纯形沿边、内点穿腹;单纯形最坏指数、内点多项式;实践里都很快。
§4.2 LP 的典型应用与面试落点¶
LP 不是“玩具”,它是运筹学的基石,几乎每个行业都有建模:
- 运输/物流:最小成本把货物从 m 个仓库运到 n 个门店(运输问题);
- 排产调度:机器时间分配、作业排序(资源约束线性化);
- 投资组合:在预算与风险约束下最大化收益(连续版);
- 匹配/推荐:广告位分配、房源-租客匹配(可转成 LP/对偶);
- 机器学习:SVM 对偶、Lasso(等价 QP)、线性回归的 $\ell_\infty$ 约束版本。
面试常见问法:
- “这个推荐问题怎么建模成 LP?”——先说变量、目标、约束,再提对偶;
- “LP 一定能在多项式时间内解吗?”——单纯形最坏指数,但存在多项式算法(内点/椭球);
- “松弛变量有什么用?”——把不等式变等式,给初始基,物理上代表“剩余资源”。
💡 掌握 LP 建模 + 单纯形 + 对偶三件套,就足以应对大部分运筹向面试;本文代码把三件套都实现了。
§5 面试追问与自测¶
- LP 最优解为什么必在顶点?(线性目标、凸可行域)
- 单纯形每次怎么选入基 / 出基?(检验数 + 比值检验)
- 对偶问题的构造规则?强对偶何时成立?(LP 恒成立;一般凸问题要 Slater 条件,见 13 篇)
- 影子价格怎么用?(资源边际价值、敏感性分析)
- 单纯形 vs 内点法复杂度?(最坏指数 vs 多项式;实际单纯形很快)
自测清单
- 把任意 LP 写成标准形式,能画 2D 图解法
- 默写单纯形表结构与一次枢轴运算
- 会构造对偶并验证强对偶(本讲代码)
- 说出互补松弛与影子价格的含义
💡 下节预告:变量要求整数后「取整不可行」——09 整数规划与分支定界。