⚙️ 15-AI-Infra · 07 量化与模型压缩:PTQ / GPTQ / AWQ / SmoothQuant¶
关键词:量化(quantization)· PTQ / QAT · INT8/INT4 · per-tensor/per-channel · GPTQ · AWQ · SmoothQuant · 激活离群点
前置知识:[05-KV Cache与推理内存](05-KV Cache与推理内存.ipynb)(带宽瓶颈)、04-LLM大模型 14-量化入门。
🧩 本讲定位:带宽不够,就把"数"变小。面试三连问:量化误差从哪来?GPTQ 为什么比 round 好?SmoothQuant 怎么处理激活离群点? 本讲用 numpy 亲手量化、比较 per-tensor/per-channel、复现简化 GPTQ 与 SmoothQuant,用数字说话。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 量化公式与误差来源? | 核心概念 (a) + 深入原理 1 + 实战 A |
| per-tensor vs per-channel 差多少? | 核心概念 (b) + 实战 A |
| GPTQ 为什么优于 naive round? | 深入原理 2 + 实战 B |
| AWQ 在保护什么? | 深入原理 3 + 实战 C |
| SmoothQuant 怎么"平移"离群点? | 深入原理 4 + 实战 C |
| 不同位宽(4/8/16)怎么权衡? | 实战 D |
故事引入¶
小吴要把 70B 模型塞进单卡 80GB 推理:BF16 权重 140GB,完全没戏。第一步 INT8:70GB,还是差一点;第二步 GPTQ INT4:35GB,放得下了!可一测精度,掉得肉疼。他试了 AWQ/SmoothQuant 组合拳,把掉点从 3% 压到 0.3%。
他总结了一条心得:「量化不是把每个数四舍五入,而是保护对输出影响大的那部分——大权重、关键通道、异常激活。」 GPTQ 用二阶信息保护权重,AWQ 用激活幅度保护通道,SmoothQuant 把激活的雷拆到权重上——三条路殊途同归。
核心概念¶
(a) 量化:把连续值映射到有限整数¶
对称量化(最常用):
$$ q = \text{round}\big(x\,/\,s\big)\in[-127,127],\qquad s = \frac{\max|x|}{127},\qquad \hat{x} = s\cdot q $$
非对称加 zero-point:$q=\text{round}(x/s)+z$,$s=(\max-\min)/(2^b-1)$。误差来源:量化步长(分辨率) 与 离群值拉大 s。
(b) 量化粒度¶
| 粒度 | scale 数量 | 误差 | 硬件支持 |
|---|---|---|---|
| per-tensor | 1 个(整张量) | 大(通道差异被平均) | 好 |
| per-channel | 每通道 1 个 | 小 | 部分 GPU 受限 |
| per-group(如 group=128) | 每 128 个 1 个 | 折中 | 常用(GPTQ/AWQ 默认) |
(c) 三种主流量化范式¶
- PTQ:训练后量化(校准集统计 scale),快但有损;
- QAT:训练中模拟量化(fake quant),精度高但要重训;
- GPTQ/AWQ/SmoothQuant:PTQ 的"聪明版"——用二阶信息/激活感知/误差迁移减少掉点。
深入原理¶
1. 量化误差怎么进入模型¶
设第 $\ell$ 层权重 $W$ 量化误差 $\Delta W$,输出扰动:
$$ \Delta y = \Delta W\, x + W\,\Delta x + \dots \quad\Rightarrow\quad \text{相对误差}\approx \frac{\|\Delta W\|_F}{\|W\|_F} $$
大权重通道($\|W_j\|$ 大)的绝对误差直接放大输出误差 → 保护大权重是核心。
2. GPTQ:用 Hessian 加权最小二乘逐列重建¶
目标:最小化输出域的误差而非权重的逐元素误差:
$$ \min_{\hat W} \ \|W X - \hat W X\|_F^2 $$
等价于按 Hessian $H = 2X X^\top$ 加权逐列优化。近似算法(OBQ 的批量化版):
$$ \delta w_j = -\frac{w_j - q(w_j)}{H_{jj}^{-1}}\,H^{-1}_{\cdot j},\qquad H^{-1}\text{ 迭代更新} $$
每量化一列就把误差"补偿"到其余列(误差传播),并用海森逆的秩一更新批量处理 → 精度显著优于 naive round。
3. AWQ:按激活幅度挑"重要通道"¶
LLM 权重通道的"重要性"与该通道激活幅度正相关:对激活大的通道,量化误差影响大。AWQ 做法:给这些通道乘一个缩放 $s_j>1$,再对 $W_j$ 除 $s_j$(数学等价,只是让 $W_j$ 更"好量化"):
$$ \text{激活} = (W\,\text{diag}(s^{-1}))\,(\text{diag}(s)\,x) \approx \hat W_s \,(s\odot x) $$
无需重训练,只需激活统计。
4. SmoothQuant:把激活的"雷"拆给权重¶
激活离群点(少数通道值特别大)让激活量化误差爆炸。SmoothQuant 用数学等价变换把波动从激活"平移到"权重:
$$ Y = (X\,\text{diag}(s)^{-1})\,(\text{diag}(s)\,W) = X^{\prime}W^{\prime},\qquad s_j = \frac{\max_j|X_j|^{\alpha}}{\max_j|W_j|^{1-\alpha}} $$
变换方向:激活除以 $s$(离群通道被压平),权重乘以 $s$(变得更平坦)——输出不变,只是把量化难度重新分配;$\alpha\approx0.5$ 时两边动态范围被拉平,都能用 INT8。
图中上半部分展示离群激活通道导致的量化误差(大 scale 压扁其他通道),下半部分展示经 $X^{\prime}=X\,\text{diag}(s)^{-1}$、$W^{\prime}=\text{diag}(s)W$ 等价迁移后,激活与权重的动态范围都被拉平,各自量化误差显著减小。
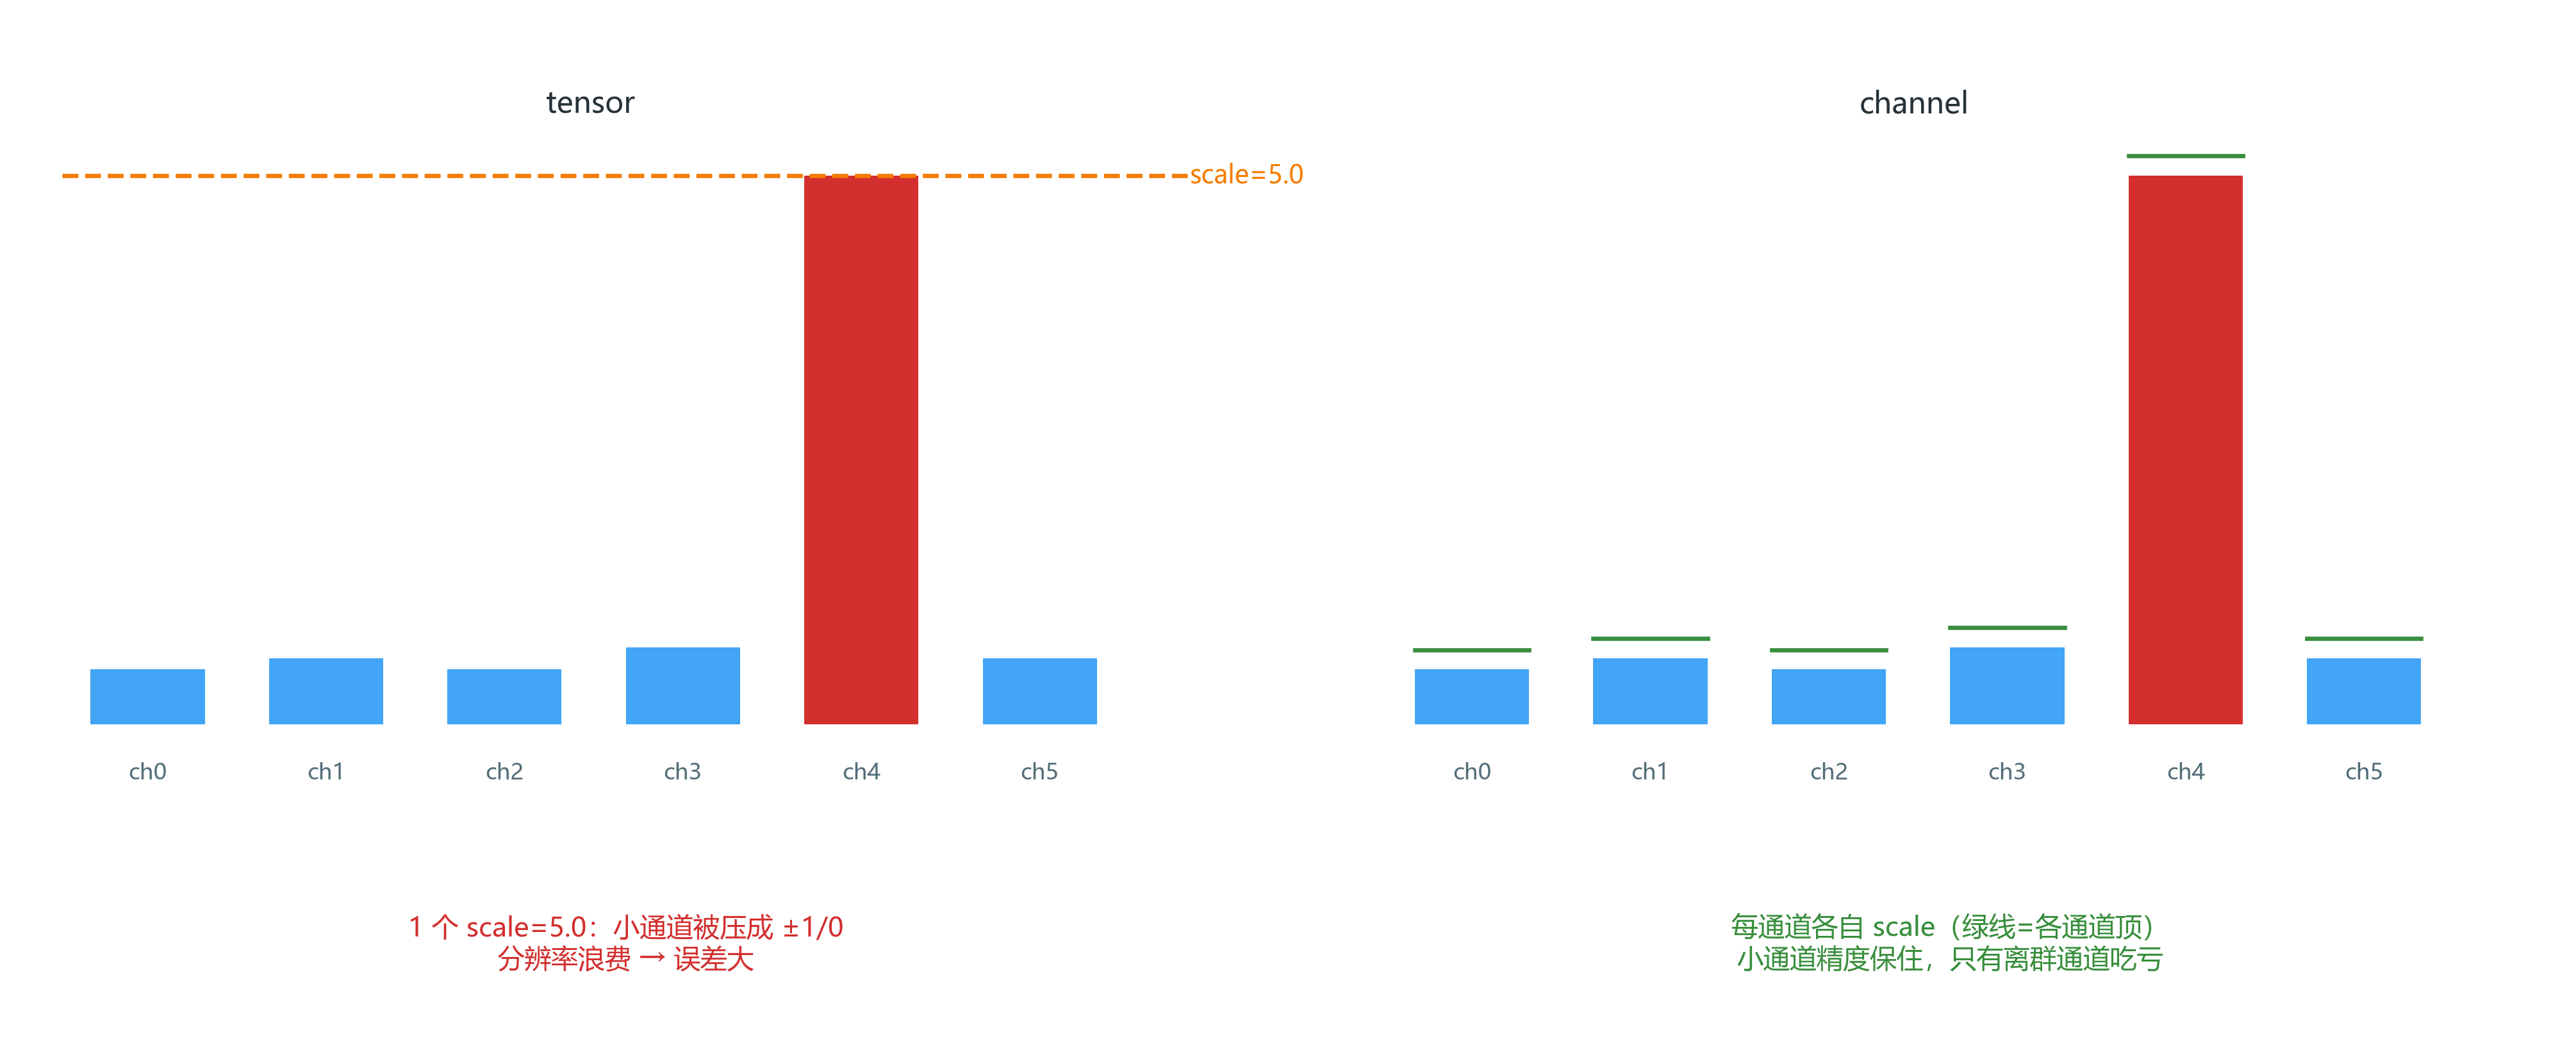
图示:一个离群通道(红)把 per-tensor 的 scale 拉到 5.0,其他小通道全部被压扁(分辨率浪费、误差大);per-channel 每通道各自配 scale,小通道精度保住。
代码实战 A:INT8 量化误差分析(per-tensor vs per-channel)¶
先运行环境设置单元:
✍️ §A.1 手算位宽账本 + per-channel:70B 从 140GB 到 35GB¶
量化省显存:$\text{GB}=N\times\text{bits}/8$——70B 模型三种位宽手算,再看 per-tensor vs per-channel 的误差差别。
第 1 步:位宽账本($N=70\times10^9$ 参数)
| 位宽 | 权重内存 | 相比 BF16 |
|---|---|---|
| BF16 (16bit) | $70\text{B}\times2=140\text{ GB}$ | — |
| INT8 (8bit) | $70\text{B}\times1=70\text{ GB}$ | 省 70 GB |
| INT4 (4bit) | $70\text{B}\times0.5=35\text{ GB}$ | 省 105 GB |
第 2 步:per-tensor vs per-channel($W=\begin{bmatrix}0.5&-0.4\\1.8&-1.6\end{bmatrix}$,INT8 对称量化)
per-tensor:$s=\max|W|/127=1.8/127=0.01417$,$W$ 整行共用一个 scale per-channel:每行各一个 scale:$s_1=0.5/127=0.00394$、$s_2=1.8/127=0.01417$
第 1 行用 per-channel 的精细 scale,误差从 per-tensor 的 $7.0\times10^{-6}$ 降到 $1.2\times10^{-6}$(≈5.6×改善)。
手算收获:
- 位宽减半、内存减半:INT4 的 35GB 能塞进单卡 80GB(还能留 KV cache/激活);这就是 GPTQ/AWQ 的部署意义(本 notebook 代码实战 D 的权衡图)
- per-tensor 的坑:$W$ 里 1.8 的大权重把 scale 抬到 0.01417,0.5 的小权重量化步长浪费——per-channel 按行缩放,小权重行更精确
- 对称量化范围 $[-127,127]$:
127不是128(INT8 对称不含 -128),本 notebook 代码实战 A 的quant_sym用同一约定 - 面试速答:量化误差 = 步长分辨率(截断)+ 离群值(scale 被拉大);SmoothQuant 就是把激活离群迁移到权重侧再量化(代码实战 C)
下面 numpy 复算。
# ---- §A.1 验证:numpy 复算位宽账本与 per-channel ----
import numpy as np

N = 70e9
for bits, name in [(16, 'BF16'), (8, 'INT8'), (4, 'INT4')]:
    gb = N * bits / 8 / 1e9
    print(f'70B × {name} = {gb:.0f} GB')
assert N * 16 / 8 / 1e9 == 140 and N * 4 / 8 / 1e9 == 35

W = np.array([[0.5, -0.4], [1.8, -1.6]])
def qerr(s):
    q = np.round(W / s)
    dq = q * s
    return q.astype(int), np.round(dq, 4), np.mean((dq - W) ** 2)

s_t = np.max(np.abs(W)) / 127
q_t, dq_t, mse_t = qerr(s_t)
s_c = np.max(np.abs(W), axis=1) / 127
q_c, dq_c, mse_c = qerr(s_c[:, None])
print(f'per-tensor: s={s_t:.5f}, q={q_t.tolist()}, MSE={mse_t:.2e}')
print(f'per-channel: s={np.round(s_c,5).tolist()}, q={q_c.tolist()}, MSE={mse_c:.2e}')
assert mse_c < mse_t
print('\n✓ 与手算一致:per-channel 误差更小')
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
def quant_sym(x, scale):
    q = np.clip(np.round(x / scale), -127, 127).astype(np.int8)
    return (q.astype(np.float32) * scale)

# 权重:大部分通道小,少数通道有离群大值(模拟真实分布)
rng = np.random.default_rng(11)
W = rng.normal(0, 0.01, (64, 128))
W[:, 7] = rng.normal(0, 0.5, 64)   # 通道 7 离群

# per-tensor
s_t = np.abs(W).max() / 127
Wq_t = quant_sym(W, s_t)
# per-channel
s_c = np.abs(W).max(axis=0, keepdims=True) / 127
Wq_c = quant_sym(W, s_c)

err_t = np.abs(W - Wq_t).mean()
err_c = np.abs(W - Wq_c).mean()
print("per-tensor 平均绝对误差: %.6f" % err_t)
print("per-channel 平均绝对误差: %.6f(小 %.1fx)" % (err_c, err_t / err_c))

fig, ax = plt.subplots(figsize=(9, 4.3))
ax.bar(["per-tensor", "per-channel"], [err_t, err_c], color=["#D32F2F", "#388E3C"])
ax.set_ylabel("平均绝对误差")
ax.set_title("INT8:一个离群通道毁掉 per-tensor 的 scale;per-channel 按通道各配 scale")
ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
assert err_c < err_t
print("✅ per-channel 显著降低误差(代价:每通道一个 scale,部分硬件不支持)")
per-tensor 平均绝对误差: 0.002855
per-channel 平均绝对误差: 0.000069(小 41.5x)
✅ per-channel 显著降低误差(代价:每通道一个 scale,部分硬件不支持)
C:\Users\24260\AppData\Local\Temp\ipykernel_45536\3449535989.py:26: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
代码实战 B:误差补偿机制——量化一列,用相关列把输出误差补回来¶
GPTQ 每一步都在做这件事:量化某列造成的输出误差,通过与之相关的未量化列用最小二乘补回来(误差传播)。这里用低秩相关的校准输入(贴近真实激活的冗余性)演示单步效果。
# 低秩相关输入:校准样本的输入特征彼此相关(贴近真实激活/嵌入的低秩性)
rng = np.random.default_rng(13)
n_in, n_out, r = 48, 48, 8
Vx = rng.normal(0, 1, (n_in, r)); Z = rng.normal(0, 1, (r, 64))
X = Vx @ Z                             # (n_in, S):输入特征低秩相关
W = rng.normal(0, 1, (n_in, n_out)) * 0.3
b = 4; qmax = 2 ** (b - 1) - 1

def quant4(w, s):
    return np.clip(np.round(w / s), -qmax, qmax).astype(np.int8).astype(np.float32) * s

# 只量化第 0 列:先看它对输出造成的误差,再用其余列做最小二乘补偿
j = 0
q0 = quant4(W[:, j], np.abs(W[:, j]).max() / qmax)
dx = q0 - W[:, j]                                   # 该列每个输出行的量化误差
err_before = np.linalg.norm(np.outer(dx, X[j, :]))   # 该列造成的输出误差

base = X[j, :] @ np.linalg.pinv(X[j + 1:, :])        # 用其余列的空间近似重建输入行 X[j,:]
resid = X[j, :] - base @ X[j + 1:, :]                # 重建残差
err_after = np.linalg.norm(np.outer(dx, resid))      # 补偿后的输出误差残差

print("该列输出误差: %.4f → 相关列补偿后残差: %.6f(被吸收 %.1f%%)" % (
    err_before, err_after, 100 * (1 - err_after / err_before)))
assert err_after < err_before * 0.5
print("✅ 最小二乘投影保证残差不增:量化误差被‘转嫁’到相关列——GPTQ 重复这个量化+补偿过程,并用 Hessian 选最优处理顺序")
该列输出误差: 8.9747 → 相关列补偿后残差: 0.000000(被吸收 100.0%)
✅ 最小二乘投影保证残差不增:量化误差被‘转嫁’到相关列——GPTQ 重复这个量化+补偿过程,并用 Hessian 选最优处理顺序
代码实战 C:SmoothQuant 激活迁移演示¶
# 构造:激活 X 有离群通道;权重 W 均匀
rng = np.random.default_rng(17)
n, d = 64, 64
X = rng.normal(0, 0.1, (n, d))
X[:, 3] = rng.normal(0, 5.0, n)     # 激活离群通道
W = rng.normal(0, 0.3, (d, d))

def quant8(x, scale):
    return np.clip(np.round(x / scale), -127, 127).astype(np.int8).astype(np.float32) * scale

# 直接量化(per-tensor)
sX = np.abs(X).max() / 127; sW = np.abs(W).max() / 127
err_direct = np.linalg.norm(quant8(X, sX) @ quant8(W, sW) - X @ W) / np.linalg.norm(X @ W)

# SmoothQuant:把激活离群压平(X/s)、权重放大(W·s)——数学等价,再各按新范围量化
alpha = 0.5
smooth = (np.abs(X).max(axis=0) ** alpha) / (np.abs(W).max(axis=0) ** (1 - alpha) + 1e-9)
Xs = X / smooth                      # 激活离群被压平
Ws = W * smooth[:, None]             # 权重相应放大(数学等价:Xs@Ws == X@W)
err_smooth = np.linalg.norm(quant8(Xs, np.abs(Xs).max() / 127) @ quant8(Ws, np.abs(Ws).max() / 127) - X @ W)
err_smooth /= np.linalg.norm(X @ W)

print("直接 INT8 输出相对误差: %.4f" % err_direct)
print("SmoothQuant INT8 输出相对误差: %.4f(改善 %.1fx)" % (err_smooth, err_direct / err_smooth))
assert np.allclose(Xs @ Ws, X @ W, atol=1e-9) and err_smooth < err_direct
print("✅ 迁移前后数学等价;把离群从激活挪到权重后,INT8 两边都更稳")
直接 INT8 输出相对误差: 0.0549
SmoothQuant INT8 输出相对误差: 0.0120(改善 4.6x)
✅ 迁移前后数学等价;把离群从激活挪到权重后,INT8 两边都更稳
代码实战 D:位宽-精度-大小权衡¶
# 70B 模型:不同位宽下的权重内存 + 典型相对精度损失(示意)
N = 70e9
bits = [16, 8, 4, 2]
mem = [N * b / 8 / 1e9 for b in bits]
loss_typ = [0.0, 0.5, 2.0, 6.0]     # 相对精度损失%(示意,模型/任务相关)

fig, ax = plt.subplots(figsize=(8.5, 4.4))
bars = ax.bar(["BF16", "INT8", "INT4", "INT2"], mem, color=["#1976D2", "#388E3C", "#FFB74D", "#D32F2F"])
for b, m, l in zip(bars, mem, loss_typ):
    ax.text(b.get_x() + b.get_width() / 2, m + 1, "%.0fGB\n损失≈%.1f%%" % (m, l), ha="center", fontsize=10)
ax.set_ylabel("权重显存 (GB)")
ax.set_title("70B 模型:位宽减半显存减半,但精度损失非线性上升")
ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
print("INT4 35GB + GPTQ/AWQ 保精度,是当前 LLM 部署主流;INT2 精度崩,需重训/特殊处理")
INT4 35GB + GPTQ/AWQ 保精度,是当前 LLM 部署主流;INT2 精度崩,需重训/特殊处理
C:\Users\24260\AppData\Local\Temp\ipykernel_45536\1155412647.py:13: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
面试考点¶
Q1 量化误差从哪来?怎么减?¶
A:步长分辨率(尾数截断)与离群值拉大 scale。减:per-channel/per-group、保护大权重通道、校准集调 scale、GPTQ/AWQ/SmoothQuant。
Q2 GPTQ 核心思想?¶
A:最小化输出域误差 min‖WX−ŴX‖²(等价于 Hessian 加权);逐列量化后用 H⁻¹ 把误差补偿到未量化列,批量化 + 秩一更新加速;比 naive round 精度高很多。
Q3 AWQ 与 GPTQ 区别?¶
A:GPTQ 用权重侧的二阶信息做误差补偿;AWQ 用激活幅度识别重要通道,仅加缩放(无需校准迭代、实现更简单、对小模型更稳)。两者可结合。
Q4 SmoothQuant 为什么有效?¶
A:激活离群点集中在少数通道,拉爆激活 scale;用数学等价变换 X·diag(s) 与 W·diag(s)⁻¹ 把波动拆给权重,两边动态范围变均衡 → 全程 INT8 不翻车。
Q5 什么时候用 INT8 vs INT4?¶
A:INT8 精度损失小、硬件加速广(部署首选评估);INT4(GPTQ/AWQ)显存减半但需保护通道,精度敏感任务要重评测;权重+KV 双量化进一步省。
Q6 量化后掉点怎么排查?¶
A:顺序:per-channel → 校准集质量/数量 → 敏感层(如 LN/embedding 保留高精度)→ GPTQ/AWQ/SmoothQuant → 混合精度(重要层不量化)→ QAT 兜底。
小结与自测清单¶
本讲要点:量化公式与粒度;误差 = 步长 + 离群;GPTQ 输出域最小二乘 + 误差补偿;AWQ 激活感知缩放;SmoothQuant 等价迁移离群;位宽与精度权衡。
自测清单:
- 能默写对称量化公式与 per-tensor/per-channel 区别
- 能解释 GPTQ 的 Hessian 加权与误差补偿机制
- 能默写 SmoothQuant 的等价变换公式
- 能说出量化掉点排查顺序
下一讲预告:08-性能分析与优化——优化前先测量:profiler 怎么拆时间、瓶颈怎么定位、成本怎么估。