📚 10-05 · 预训练模型与微调(BERT / GPT)
目标:吃透「预训练 → 微调」范式——为什么无监督大语料预训练 + 小数据微调有效; 亲手实现 mini-BERT(双向注意力 + MLM) 与 mini-GPT(因果注意力 + 自回归续写), 并做一个微调策略对比实验(大/小学习率、冻结/全量),亲眼看到灾难性遗忘。
🧩 本篇在 8 篇主线中的位置:前一篇
04-Attention与Transformer(注意力机制与 Transformer 结构) → 本篇(预训练范式与两大主流架构 BERT / GPT)→ 后一篇06-文本分类与序列标注(把表示落到真实任务)。
🧩 生活化类比:预训练 = 通识教育(大量阅读,学语言规律);微调 = 岗前培训(少量专业资料,学会具体任务)。 BERT 是「完形填空型学霸」,GPT 是「接话型作家」。
核心概念
(a) 🗂️ 先学语言、再学干活:预训练与微调(BERT / GPT)
标注数据贵、任务又多又小,所以先在免费的海量无标注语料上预训练「通用语言能力」,再用少量标注数据微调「任务能力」。本篇手写 mini-BERT(双向 + MLM)与 mini-GPT(因果 + 自回归),并做微调策略对比,亲眼看到灾难性遗忘。
flowchart TB
    Node1["🔄 预训练 → 微调范式"]
    Node2["🎁 自监督:免费标签"]
    Node3["🤖 BERT:双向编码器"]
    Node4["🕳️ MLM 掩码语言建模"]
    Node5["❌ NSP(被证伪)"]
    Node6["✍️ GPT:自回归生成"]
    Node7["🎲 生成策略"]
    Node8["🧪 微调策略对比"]
    Node9["🚀 Prompt / ICL / RLHF"]
    Node1 --> Node2
    Node2 --> Node3
    Node3 --> Node4
    Node4 --> Node5
    Node1 --> Node6
    Node6 --> Node7
    Node1 --> Node8
    Node8 --> Node9
    Node9 -->|演进| Node3
- 预训练 → 微调范式:两个残酷现实——标注数据极贵(医生、法务人工标注),任务很多但每个任务数据很少。于是先在互联网免费文本上预训练通用能力,再在小标注数据上微调任务能力,迁移学习让小数据也能训大模型。
- 自监督:免费标签:把「我 爱 北京 天安门」里的「北京」挖掉,被挖掉的词自己就是标签——不需要任何人标注,语料里每个词都能当一次「答案」。这种从数据自身构造监督信号的方式叫自监督学习,是预训练的基石。
- BERT:双向编码器:多层 Transformer Encoder,输入 = token embedding + segment embedding + position embedding 三部分相加,加 [CLS]/[SEP] 特殊标记。双向注意力让每个词同时看到左右两侧上下文。
- MLM 掩码语言建模:随机遮住 15% 的 token 用左右上下文猜回来;内部 80% 换 [MASK]、10% 换随机词、10% 保持原样(80/10/10),缓解预训练见 [MASK] 而微调不见的 mismatch。逼出双向表示的关键就在「左右都看」。
- NSP(被证伪):预测 B 是不是 A 的下一句,曾是 BERT 的第二个预训练任务;但 RoBERTa 实验证明去掉 NSP 反而更好——这是「预训练任务要实证检验」的教训。
- GPT:自回归生成:多层 Transformer Decoder,因果掩码(上三角 -inf)保证只能看左边,训练目标是对每个位置预测下一个 token。生成 = 逐 token 采样,靠链式法则把整句概率拆成条件概率连乘。
- 生成策略:贪心每步取 argmax 稳定但易重复;温度 T 调节随机性;beam search 每步保留 top-B 条候选路径;top-k/top-p 截断候选集合防退化、重复惩罚抑制「了 了 了」式循环。
- 微调策略对比:加一个任务头(分类头接在 [CLS] 后),训练 2~5 epoch,学习率必须小(1e-5~5e-5),否则灾难性遗忘——模型把预训练学的通用能力忘光。渐进解冻、数据重放是常用武器。
- Prompt / ICL / RLHF:微调之外的路——Prompt 不改参数只写指令;In-context Learning 在 prompt 里给几个示例;RLHF 用人类反馈对齐模型。这是从「微调时代」走向「提示时代」的演进线。
主线地图:本篇要走的路
预训练(无监督大语料:学通用语言能力) ──► 微调(小标注数据:学任务能力)
        │                                        │
        ├─ BERT:双向编码器 + MLM                ├─ 全量微调 vs 冻结(feature-based)
        │    · 三 embedding 相加                   ├─ 小学习率 1e-5 ~ 5e-5(防灾难性遗忘)
        │    · 15% 掩码 / 80-10-10 规则            └─ 分类头 / 池化
        │    · mini-BERT 手写实验(cloze acc > 0.85)
        │
        └─ GPT:单向解码器 + 因果自回归
             · 因果掩码(下三角,只看左侧)
             · 自回归生成(贪心 / 温度采样)
             · mini-GPT 手写实验(前缀续写)
                        │
            微调之后:Prompt / In-context Learning / RLHF(对齐人类偏好)
                        │
            局限与演进:静态预训练 / 长度限制 / 幻觉
章节顺序:1 范式 → 2 BERT 与 MLM → 3 GPT 与自回归 → 4 微调策略 → 5 Prompt/ICL/RLHF → 6 局限 → 7 数字与易错点 → 8 面试速答 → 9 自测清单。
1. 范式:预训练 → 微调
为什么需要这个范式? 两个残酷的现实:
- 标注数据极贵:一个标注样本要靠人工(医生标注、法务标注……),而互联网上的无标注文本近乎免费(维基百科、新闻、网页、图书)。
- 任务很多但每个任务数据很少:情感分类、NLI、问答、摘要……每个任务都从零开始训练一个模型既不现实也学不动。
于是有了「两步走」:
$$ \text{阶段一(预训练)}:\ \min_{\theta}\ \mathcal{L}_{\text{pretrain}}(\theta) \quad\text{在无标注大语料上} $$
$$ \text{阶段二(微调)}:\ \min_{\theta}\ \mathcal{L}_{\text{task}}(\theta) \quad\text{在少量标注数据上} $$
为什么有效(迁移学习):预训练把"语言规律"(语法、常识、世界知识)固化进参数 $\theta$; 微调时 $\theta$ 已经是一个很好的起点,小数据只需要"拧"少量参数去适配任务。 对比:从随机初始化开始训练,小数据连语法都学不到(欠拟合);从预训练权重开始,等于站在巨人的肩膀上。
一个关键认知:任务相关的头 vs 通用能力——预训练学的是表示(representation), 微调学的是任务映射(分类/抽取/生成)。表示越好,任务越好学。
模型谱系速览:
| 模型 | 架构 | 预训练任务 | 特点 |
|---|---|---|---|
| ELMo | 双向 LSTM | 前向+后向 LM | 早期上下文表示(浅层拼接) |
| BERT | Transformer Encoder | MLM + NSP | 双向,编码器专用(理解) |
| GPT | Transformer Decoder | 自回归 LM | 单向,生成/对话 |
| T5 | Encoder-Decoder | 文本到文本 | 所有任务统一成生成 |
上下文表示 vs 静态词向量:Word2Vec 一个词一个向量(多义词无法区分); BERT 里「苹果」在「苹果公司」和「吃苹果」中向量不同——表示随上下文变化。这一条是预训练最本质的胜利。
本节局限 → 下一节:预训练模型内部长什么样?核心是 Transformer Encoder + 双向注意力——这就是 BERT。
1.1 前传:2018 年的三篇论文接力赛(历史故事)
「预训练」不是 BERT 发明的,但 2018 年一年之内,三篇论文像接力赛一样把它推成主流。
- 2018 年 2 月,ELMo(Peters et al.):用双向 LSTM 语言模型预训练出「上下文相关的词向量」——「苹果」在公司和水果语境里第一次有了不同向量,一词多义被真正解决。但 ELMo 只把向量当附加特征拼进任务模型,模型主体仍是从零训练;
- 2018 年 6 月,GPT(Radford et al.):改用生成式预训练——用 Transformer Decoder 做从左到右的语言模型,预训练后微调整个模型,并率先展示零样本(zero-shot)迁移能力;代价是单向(只能看左侧);
- 2018 年 10 月,BERT(Devlin et al.):把 GPT 的「微调整个模型」与 ELMo 的「双向」合二为一,用 MLM + NSP 预训练 Transformer Encoder,一口气在 11 个 NLP 任务上刷新 SOTA——「预训练 → 微调」自此成为事实标准。
另外有一位常被忽略的「引路人」:2018 年 5 月的 ULMFiT(Howard & Ruder)——第一个把「预训练 → 微调」完整用在文本分类上的方法,证明「先用语言模型预训练、再微调整个模型」在小数据上也能赢。GPT 与 BERT 的「微调整个模型」思路都直接受它启发;可以说 2018 年是「预训练元年」:半年之内范式就从「特征拼接」(ELMo)进化到「全模型微调」(ULMFiT / GPT / BERT)。
为什么这场接力重要:三篇论文恰好踩中三个关键变量——上下文表示(ELMo)、全模型微调(GPT)、双向信息(BERT)。记住这三个变量的排列组合,就记住了 2017–2019 整个范式演进的逻辑;而三者的共性——「先用免费的无监督语料学通用能力」——正是第 1 节的核心。
2. BERT:双向 Transformer Encoder
一句话:BERT = 多层 Transformer Encoder,双向注意力,用 MLM 预训练。
架构数字(L / H / A 口算):L = 层数,H = 隐藏维度,A = 注意力头数。
- BERT-base:
L=12, H=768, A=12→ 每头维度 $d_{head} = H/A = 768/12 = 64$ - BERT-large:
L=24, H=1024, A=16→ 每头 $1024/16 = 64$(头维度恒为 64 是设计惯例)
参数量 110M 怎么来的(口算):每一层 ≈ 注意力(QKV 三个投影 3H² + 输出投影 H² = 4H²)+ FFN(H→4H→H 共 2·H·4H = 8H²)+ 2 个 LayerNorm(2H)≈ 12H²;
$$ P_{\text{layer}} = \underbrace{4H^2}_{\text{QKV+out}} + \underbrace{8H^2}_{\text{FFN}} + \underbrace{2H}_{\text{LN}} \approx 12H^2 $$
$$ P_{\text{BERT-base}} \approx 12 \times 12H^2 + V_{\text{token}}\times H = 12\times12\times768^2 + 30522\times768 \approx 110\text{M} $$
(实验 1a 里会用代码验证这个口算 ≈ 108~110M。)
双向的含义:预测某个位置时可以看到左右两侧所有词——self-attention 不做因果掩码。 对比 GPT 只能看到左侧。这一个结构差异决定了 BERT 擅长理解、GPT 擅长生成。
复杂度:每层 self-attention 是 $O(T^2 H)$(T = 序列长度),BERT 固定 T ≤ 512,
所以复杂度上界是 $O(512^2 H)$——这也是"长文本"成为难点的起点。
本节局限 → 下一节:BERT 的输入到底是什么?凭什么三个 embedding 能直接相加?
2.0 自监督的直觉:预训练的「免费标签」从哪来
预训练能成立,前提是标签不花钱。MLM 的巧妙之处在于:把「我 爱 北京 天安门」中的「北京」挖掉,被挖掉的词自己就是标签——模型不需要任何人标注,语料里每一个词都能当一次「答案」。这种从数据自身构造监督信号的方式叫自监督学习(self-supervised learning),是预训练范式的基石。
为什么要强调这点?因为它决定了预训练语料可以无限大:
- BERT 用了约 33 亿词(BooksCorpus 约 8 亿 + 英文维基约 25 亿),无标注网页随手可得;
- 对比有监督任务:GLUE 全部 9 个任务加起来也才几十万条标注样本——差了 3 个数量级;
- 更大的语料 + 更大的模型 + 更久的训练 = 更强的通用能力,这就是后来 scaling law 的雏形。
一句话直觉:预训练 = 让模型「读万卷书」(免费的自监督大语料),微调 = 再「行万里路」补少量任务专精(贵的人工标注)。成本结构决定了为什么是先预训练再微调,而不是反过来。
一组备查数字:BERT-base 在 16 块 TPU 上训练约 4 天、跑约 40 个 epoch 就能刷新 SOTA——这个「便宜」也是范式迅速普及的原因之一;而 ELMo 时代每个下游任务都要重新训练一个任务模型,BERT 之后「换头不换身」(只换任务头、共享预训练体重)成为主流。
2.1 输入表示:三个 embedding 相加
BERT 输入 = token embedding + segment embedding + position embedding:
$$ \mathbf{x}_i = \mathbf{E}_{tok}[w_i] + \mathbf{E}_{seg}[s_i] + \mathbf{E}_{pos}[i] $$
- token embedding:查词表,词 → 向量(静态起点,Word2Vec 那套);
- segment embedding:区分句子 A/B(第一句全 0,第二句全 1)→ 服务 NSP 任务;
- position embedding:位置 $i$ → 向量(BERT 里是学出来的;Transformer 原文是 sin/cos 固定函数)。
为什么是相加而不是拼接?
- 拼接会把维度变成 $3H$(口算:768 → 2304),注意力矩阵参数量 ×9($QK^\top$ 是 $3H \times 3H$),又慢又费显存;
- 相加保持维度 $H$,让三路信息叠加在同一个向量空间里,靠注意力自己去"分拣"哪路信息重要。
- 直觉:$\mathbf{x}_i$ 的每一维 = 词义分量 + 句段分量 + 位置分量,混合后的表示照样能被后续层解耦使用。
为什么位置用学出来的而不是 sin/cos?
- BERT 预训练语料句子普遍 < 512,学出来的位置表示足够用;
- sin/cos 的优势是外推(长度超出训练范围也能给位置),但 BERT 固定 512 不需要外推;
- 现代 LLM 用 RoPE/ALiBi 做位置编码,兼顾相对位置与外推(名字记住即可)。
输入格式:[CLS] 句子A [SEP] 句子B [SEP]。[CLS] 位置的输出向量常被用作整句表示(分类任务)。
手算例子:「我 爱 北京 天安门」→ token=[我,爱,北京,天安门],segment=[0,0,0,0],position=[0,1,2,3]; 「北京」的输入向量 = E_tok[北京] + E_seg[0] + E_pos[2],768 维,逐元素相加。
2.1 配图:BERT 的三类 embedding
下图展示 BERT 输入的三路来源——token embedding(查词表)、segment embedding(区分句子 A/B)、position embedding(位置):
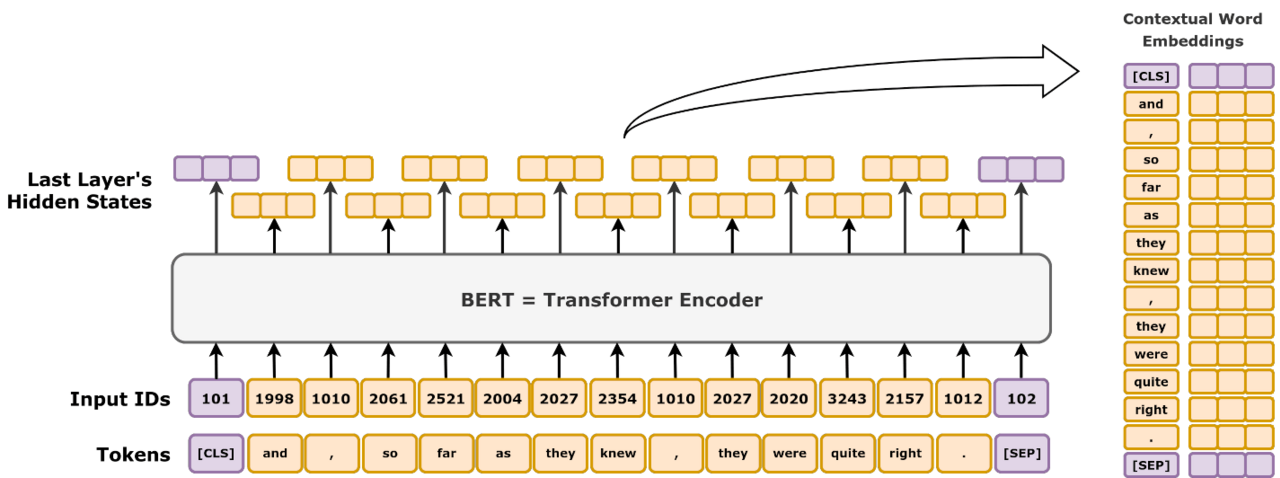
图 1:BERT embeddings——三张独立查表得到的向量逐元素相加,构成每个 token 的输入表示(示意图)。
读图要点:三张表的大小分别是 $V\times H$、$2\times H$、$L\times H$($V$=词表 30522,$L$=最长 512)。相加后仍是 $H$ 维——这正是「相加而不是拼接」的好处(口算:拼接会变 $3H$ 维,注意力投影参数量×9)。后面实验 1a 会把这三张表搬进 numpy/torch 亲手验证。
2.1 配图:三部分如何「相加成输入」
上图的三个向量在同一个位置上逐元素相加,得到下图所示的最终输入,还附带 [CLS] 与 [SEP] 特殊标记的排布:
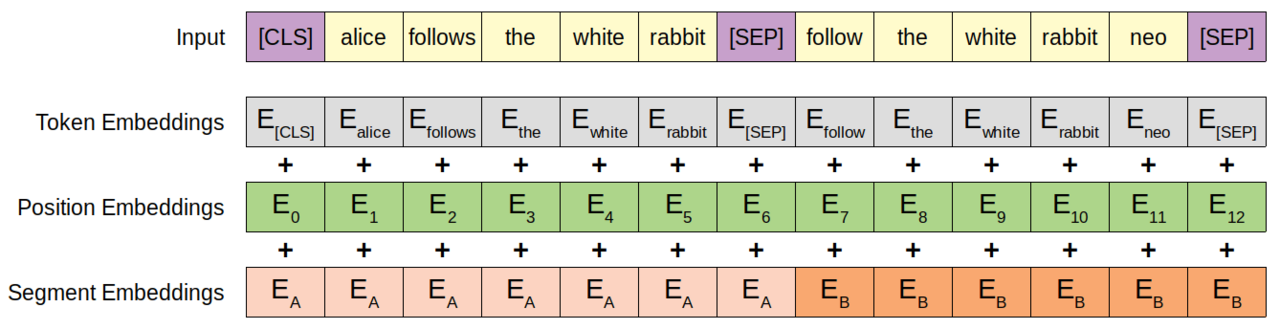
图 2:BERT 输入向量 = token + segment + position 三部分相加(示意图,结构参照 Devlin et al., 2019)。
读图要点:注意 [CLS] 放在句首、[SEP] 放在每句末尾——这两个特殊 token 是 BERT 的「接头暗号」:[CLS] 的输出向量专供分类任务使用,[SEP] 负责切分句界。segment embedding 用全 0 / 全 1 标记「这句属于 A 还是 B」,配合 NSP 使用(见图 4)。把图 1 与图 2 连起来看,就得到了完整的「一句话 → 向量矩阵」过程。
2.2 MLM:掩码语言建模(预训练核心)
任务定义:随机遮住 15% 的 token,用左右两侧上下文预测被遮的词:
$$ \mathcal{L}_{\text{MLM}} = -\sum_{i \in \mathcal{M}} \log P_{\theta}(w_i \mid \mathbf{x}_{\setminus i}) $$
其中 $\mathcal{M}$ 是被掩码的位置集合,$\mathbf{x}_{\setminus i}$ 表示去掉第 $i$ 个词后的整个句子(双向上下文)。
为什么是 15%,不全掩码?
- 期望被掩码个数:$E[\#mask] = 0.15 \times T$(句长 32 → 期望约 4.8 个,口算 0.15×32);
- 如果 100% 掩码:所有输入都是
[MASK],上下文全是占位符 → 模型没有任何真实信息可用,学不动; - 如果掩太多(比如 50%):每句真实上下文太少,梯度信号稀疏、训练慢、表示质量差;
- 15% 是"训练信号够多 + 上下文信息够足"的平衡点(论文做过消融验证)。
15% 内部的 80/10/10 规则(BERT 论文原话):
$$ P(\text{换成 }[MASK]) = 0.8,\qquad P(\text{换成随机词}) = 0.1,\qquad P(\text{保留原词}) = 0.1 $$
- 80% 换成
[MASK]:训练模型"见 MASK 猜词"——主任务; - 10% 换成随机词:防止模型偷懒假设"被改动的词一定是 MASK"(看到错误输入也要能纠错,逼迫模型依赖上下文而不是标记);
- 10% 保留原词:让模型学会"即使没被遮也要预测"。
为什么需要 80/10/10?——预训练/微调不一致(mismatch):微调时输入永远不会出现 [MASK]。
如果预训练只见过 [MASK] 这一种"被遮形态",微调时遇到正常句子会"懵";混入原词与随机词,
让模型学会在任何输入形态下都能预测——这就是 80/10/10 存在的全部理由。
与自回归(GPT)的对比:
| 维度 | BERT MLM | GPT 自回归 |
|---|---|---|
| 预测哪些位置 | 只预测被 mask 的 15% | 预测每个位置的下一个词 |
| 能看到什么 | 左右两侧(双向) | 只有左侧(因果) |
| 目标 | 理解(完形填空) | 生成(续写) |
| 表示特点 | 上下文相关,适合分类/抽取 | 适合生成/对话 |
本节局限:MLM 只做理解,模型不会"开口说话";而 BERT 原配的「下一句预测 NSP」后来被证伪了 → 下一节。
2.2 配图:掩码语言建模的全过程
下图把 MLM 画成了可见的数据流:原句被遮 15% → 模型看到带 [MASK] 的输入 → 输出层在被遮位置预测原词,与真实词算交叉熵:
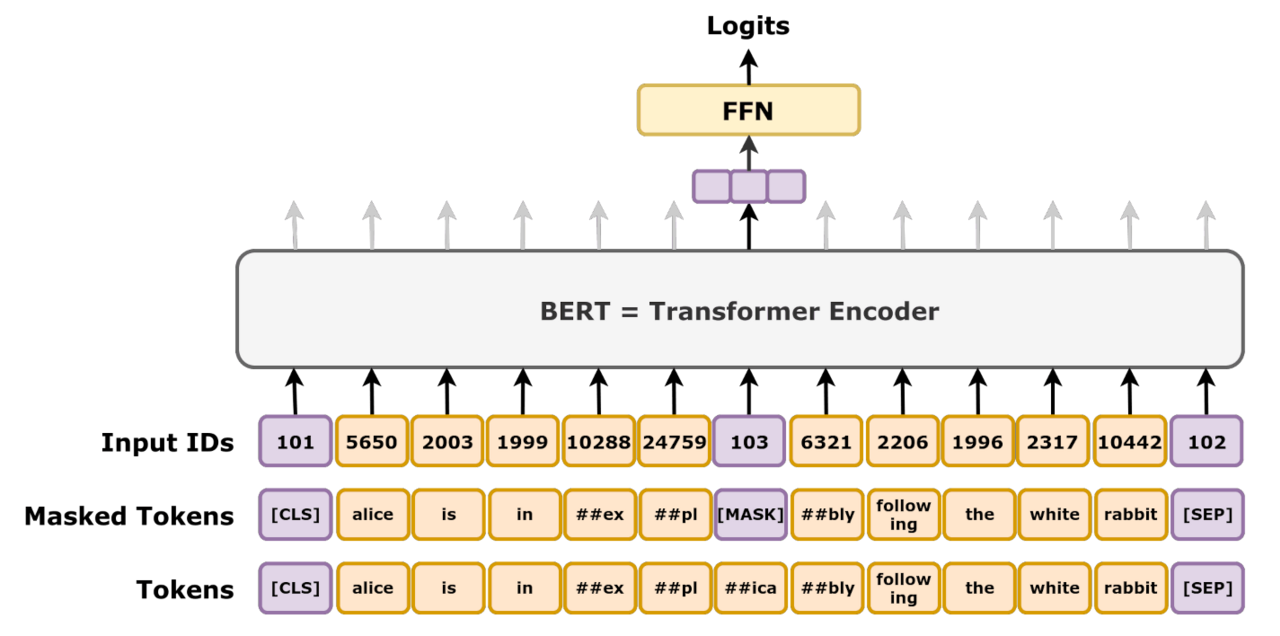
图 3:掩码语言建模(MLM)——挖掉 15% 的 token,用双向上下文把它们填回去(示意图,结构参照 Devlin et al., 2019)。
读图要点:只有被挖掉的位置有监督信号,其余位置不参与 loss——对应公式 $\mathcal{L}=-\sum_{i\in\mathcal{M}}\log P(w_i\mid x_{\setminus i})$ 中的 $\mathcal{M}$。注意输入里 [MASK] 出现在句中任意位置,模型必须同时利用左边和右边的词,这逼迫 Transformer Encoder 形成「双向」的表示——这就是 BERT 与 GPT 最本质的分野。
2.2 细看一例:为什么「猜词」能逼出双向表示
拿「我 爱 [MASK] 天安门」举例:
- 只看左边(GPT 式):已知「我 爱 _」,候选词有无数个(北京、上海、学习、吃饭……),信息不足;
- 只看右边(单向反向 LM):已知「_ 天安门」,能排除「学习、吃饭」,但「北京、上海、广州」仍难分;
- 左右都看:同时得到「我爱 」+「 天安门」两个约束,交集只剩「北京」这类地名——两个方向的信息合起来才能消歧。
这就是 MLM 的关键收益:普通语言模型只能在一个方向上累积条件概率,而掩码任务让每个位置都同时从两个方向拿信息,训练出的表示更「全知」。代价也很明确:
- 预训练和微调输入形态不一致(微调没有
[MASK])→ 80/10/10 规则专门治这个病; - 每个位置平均只被 mask 15%,同一批语料的信息利用率低于自回归(GPT 每个位置都预测)→ 所以 BERT 需要更多训练步数才收敛——这也是后来 ELECTRA 用「替换词检测」提升训练效率的动机。
🎯 面试加分:能说出「MLM 双向但低效、LM 单向但高效」这对矛盾的,比只会背 15% 的人高一个段位。
作为对比,ELMo 的「双向」其实是前向/后向两个各自单向的 LSTM 语言模型,最后把两个方向的特征拼接起来——两个方向从不在同一层内真正交互;BERT 的 mask 任务才第一次让同一层同时使用左右两侧的信息。这也是「双向」三个字从 ELMo 到 BERT 发生质变的关键。
2.3 NSP 与 Segment 任务(简述)
NSP(Next Sentence Prediction):喂两段文本 A、B,判断 B 是否是 A 的下一句(二分类)。
- 训练数据:50% 真下一句(label = IsNext),50% 从语料随机抽的句子(label = NotNext);
- 配合 segment embedding(A=0,B=1)让模型知道哪半是 A、哪半是 B;
- 用
[CLS]位置的输出过二分类头:$P(\text{IsNext}) = \sigma(\mathbf{w}^\top \mathbf{h}_{[CLS]} + b)$。
为什么需要 NSP:让模型学到"句子级连贯性"——QA、NLI 这类任务需要判断句子间关系。
历史教训(重要):RoBERTa 用更大语料 + 更久 MLM 训练,去掉 NSP 效果反而更好; ALBERT 用 SOP(句子顺序预测)替换 NSP。→ 现代主流是「纯 MLM」或「纯 LM」,NSP 基本被弃用。
局限:句子对任务少、信号弱 → 引出思考:也许"只管预测下一个词"的 GPT 式目标更通用、更能缩放?
2.3 配图:下一句预测(NSP)
下图是 NSP 任务的数据流:句子 A 与句子 B 拼成一对(50% 真·下一句 / 50% 随机句),[CLS] 的输出过二分类头判断 B 是不是 A 的下一句:
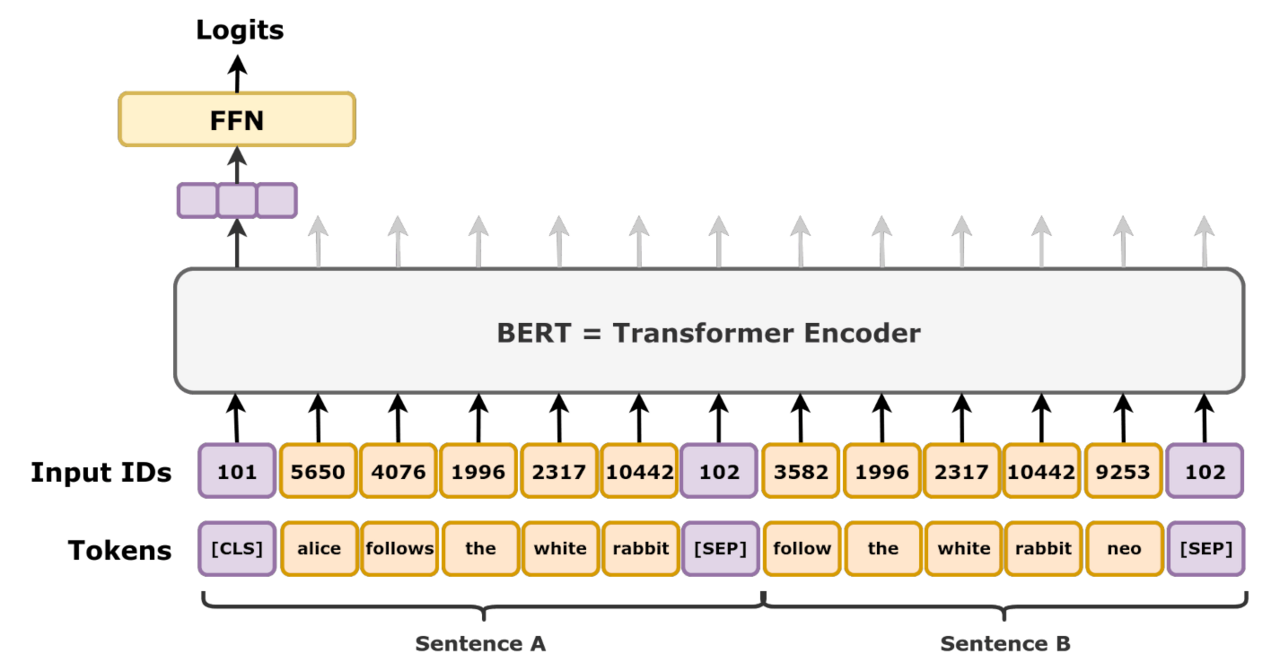
图 4:下一句预测(NSP)——利用 [CLS] 向量做「是否是下一句」的二分类(示意图,结构参照 Devlin et al., 2019)。
读图要点:segment embedding 在这里起作用——模型要知道前一半是 A、后一半是 B,才能学到「A 之后接 B 是否自然」;[CLS] 角色也在此首次亮相(分类任务的统一出口)。注意 NSP 已经基本被历史淘汰(RoBERTa 证明去掉它效果更好)——这张图的价值是理解「句子级任务怎么接到 BERT 上」,这个接法至今仍用在 NLI、句对检索等任务里。
2.4 NSP 为什么被放弃:一场「证伪」的教训
BERT 作者当初加 NSP 的理由很朴素:很多下游任务(QA、NLI)需要判断两句之间的关系,预训练时练一练「句子连贯性」应该有帮助。但后续工作把这件事证伪了:
- RoBERTa 实验(Liu et al., 2019):去掉 NSP、只用 MLM + 更多数据,几乎在所有任务上反超 BERT——说明 NSP 提供的信号不仅没用,甚至可能干扰 MLM;
- 可能的解释:NSP 任务太「简单粗暴」——判断「是不是下一句」常常靠主题词重叠就能蒙对(随机句通常话题不同),模型学到的是表层线索而不是真正的篇章连贯性;
- ALBERT 的补救:把二分类的 NSP 换成 SOP(Sentence Order Prediction)——两段都是真的相邻句子,只判断顺序对不对(A-B 还是 B-A),迫使模型学真正的篇章逻辑。
教训(可以当面试故事讲):预训练任务的设计要「难而有用」——信号太弱或太容易作弊的任务,不但不帮忙,还会挤占 MLM 的容量。这也解释了为什么后来主流全回到「纯语言模型」目标(GPT 路线):predict next token 简单、可缩放、没有作弊空间。
顺带一提,SOP 在 ALBERT 的消融里确实带来了增益,是 NSP 目前最成功的替代方案;另有一路工作(如 ELECTRA)干脆把「预测被替换的 token」当目标——判断类目标比生成类目标更省算力,这是预训练目标设计的一条新思路。
动手实验 1:mini-BERT —— 手写双向注意力 + MLM
下面把 BERT 的核心骨架搬进一个 32 维的小模型:词表只有 13 个词、序列长度 5、 单层单头自注意力(无因果掩码 = 双向)+ FFN + LayerNorm + 词表头。 在 5 句小语料上跑 250 步 MLM,验证:cloze 自填准确率 > 0.85(逐位置 mask 后靠上下文恢复)。
实验拆成四块:
- 实验 1a:验证「三 embedding 相加」numpy 手写 vs torch 对照 + 可视化 + BERT 参数量口算验证;
- 实验 1b:验证 80/10/10 掩码的统计比例 + 「为什么不全掩码」的口算;
- 实验 1c:训练 mini-BERT(保留原版实验,加了更细注释);
- 实验 1d:画训练曲线 + 可视化「上下文相关表示」(同一词在不同句子中向量不同,对比静态词向量)。
3. GPT:单向自回归
一句话:GPT = 多层 Transformer Decoder(去掉 cross-attention),因果掩码,自回归预训练。
训练目标:给定前文预测下一个 token,对每个位置都做预测(不像 MLM 只预测 15%):
$$ \mathcal{L}_{\text{LM}} = -\sum_{t=1}^{T} \log P_{\theta}(x_t \mid x_{<t}) $$
因果掩码:attention 得分矩阵的上三角填 -inf → softmax 后第 $i$ 行只看 $j \le i$ 的列:
位置 →   0     1     2     3
0       ✓    -inf  -inf  -inf
1       ✓     ✓    -inf  -inf
2       ✓     ✓     ✓    -inf
3       ✓     ✓     ✓     ✓
BERT vs GPT 对比表:
| 维度 | BERT | GPT |
|---|---|---|
| 架构 | Encoder(双向注意力) | Decoder(因果注意力) |
| 预训练任务 | MLM(预测 15% 被掩词) | 自回归(预测每个 next token) |
| 能看见 | 左右两侧 | 只有左侧 |
| 擅长 | 理解(分类、抽取、检索) | 生成(续写、对话、代码) |
| 典型代表 | BERT / RoBERTa / ELECTRA | GPT-2 / GPT-3 / LLaMA |
| 微调产物 | 分类头 / 标注头 | 继续自回归 + 指令 |
为什么 GPT 单向还能生成? 生成本来就是"逐个预测下一个词"——每一步只需要左侧信息, 单向结构恰好匹配生成过程;而双向模型(如 BERT)不能直接生成,因为生成时"未来"还没写出来, 你无法把还没写出的词喂进输入。单向不是缺陷,是生成任务的最优形态。
缩放法则(scaling law):模型越大、数据越多 → 能力越强(GPT-3:175B 参数、96 层、batch 3.2M tokens)。 能力随规模平滑涌现,这是 GPT 路线碾压式成功的原因。
3.1 自回归生成:贪心 / 温度采样
生成 = 逐 token 采样,由链式法则把整句概率拆成条件概率连乘:
$$ P(x_1 x_2 \cdots x_T) = \prod_{t=1}^{T} P(x_t \mid x_{<t}) $$
- 贪心(greedy):每步取 argmax → 稳定但容易重复、无多样性;
- 温度采样:把 logits 除以温度 $\tau$ 再做 softmax:
$$ P(x_t) = \frac{\exp(z_t / \tau)}{\sum_{k} \exp(z_k / \tau)} $$
- $\tau \to 0$:分布变尖,趋近贪心;$\tau \to \infty$:分布变平,趋近均匀随机;
- 典型值:对话 $\tau \in [0.7, 1.0]$,创意写作 $\tau \in [1.2, 2.0]$;
- top-k / top-p(nucleus):先砍掉概率最低的 $k$ 个、或累计概率超过 $p$ 的尾巴,再采样 → 防"胡言乱语"。
数字示例:logits = [2.0, 1.0, 0.0], $\tau=1$ → 概率约 [0.66, 0.24, 0.09]; $\tau=0.5$ → [0.78, 0.19, 0.03](更尖,更接近贪心); $\tau=2$ → [0.51, 0.31, 0.19](更平,更随机)。 实验 2c 里会用代码验证这组数字。
3.2 生成策略补充:beam search、退化与重复惩罚
温度与 top-k/top-p 管「随机性」,但生成质量还受两个常见问题困扰:
① 贪心/Beam Search 的「退化」:贪心每一步取最大概率词,但局部最优不等于全局最优,「我今天_」扩写时可能陷入「了 了 了」式的重复循环;beam search(每步保留 top-B 条候选路径)能缓解但不是根治——因为重复句子的概率会因长度而累积占优。所以对话/创意场景基本不用 beam,而是采样。
② 采样也有坑:尾部风险。纯温度采样偶尔会抽到概率极低的怪词(「我今天 麋鹿 天气」),top-p 把累计概率 0.9 之外的尾巴砍掉,正是为了压制这种「长尾胡说」;实践中 top-p 与 temperature 通常配合使用。
③ 重复惩罚(repetition penalty):对已经出现过的词打折:$z_i\leftarrow z_i/p$($p>1$ 时已见词被压低),或按出现次数直接减分——这是「机器味重、爱复读」问题最常见的工程解。
🎯 面试一条线:贪心=确定但单调 → 采样=多样但危险 → top-k/top-p=砍尾巴保安全 → 温度=调节整体尖锐度 → 重复惩罚=最后一道防复读。生成策略不是单选题,是这些旋钮的排列组合。
另一个记忆锚点:主流开源模型的常见默认是 temperature ≈ 0.7~1.0、top_p ≈ 0.9、repetition_penalty ≈ 1.1——面试时能报出这组「工程默认值」,比只背公式更显实战感。
动手实验 2:mini-GPT —— 手写因果注意力 + 自回归生成
延续原版实验:在 6 字符周期串 hello 上训练一个带因果掩码的 mini-GPT(自回归目标),
验证 next-char 准确率 > 0.9,并从 h 开始自回归续写出 hello hello ...。
扩充两块:
- 实验 2a:手写 numpy 因果注意力(上三角填 -1e9)vs
torch对照(<1e-6)+ 掩码可视化; - 实验 2c:温度采样——用新语料(一首五言诗)再训一个 mini-GPT,做「前缀续写」, 对比不同温度的生成风格,并用代码验证 $\tau$ 对分布的影响。
4. 微调策略:全量 vs 冻结、小学习率
微调 = 用任务数据继续训练预训练模型,典型配置:
- 加一个任务头(分类头:Linear(H, num_labels),接在
[CLS]或池化表示之后); - 训练 2~5 epoch(数据小,很快收敛,再久就过拟合/灾难性遗忘);
- 学习率必须小:
1e-5 ~ 5e-5(对比从头训练常用 1e-3 ~ 5e-3,差了两个数量级)。
为什么微调学习率必须小(重点推导):预训练权重 $\theta^*$ 已经处于"好区域"(学好了语法与常识)。 微调 = 在 $\theta^*$ 附近做小步移动。一步 SGD 更新是 $-\eta \nabla \mathcal{L}_{\text{task}}$:
- 若 $\eta$ 大:一步就可能跳出"预训练学到的好区域",把通用能力忘掉——灾难性遗忘(catastrophic forgetting);
- 若 $\eta$ 小:只在任务方向上微调,通用能力基本保留,任务能力逐步增强。
全量微调 vs 冻结:
| 策略 | 更新哪些参数 | 优点 | 缺点 |
|---|---|---|---|
| 全量(fine-tune) | 所有参数 | 效果最好 | 存/传全部梯度,易遗忘 |
| 冻结(feature-based) | 只训分类头 | 快、省、抗遗忘 | 表示固定,上限受限 |
| 折中(LoRA / Adapter) | 少量新增参数 | 兼顾效果与效率 | 要调秩/位置(提名字,不展开) |
分类头细节:BERT 取 [CLS] 输出(或平均池化)$\mathbf{h}$ → Linear → softmax,
目标就是普通交叉熵:
$$ \mathcal{L} = -\sum_{c} y_c \log \hat{y}_c, \qquad \hat{y} = \text{softmax}(W \mathbf{h} + b) $$
实验 3 预告:我们用 mini-BERT 做「句子是否含『北京』」二分类,对比 大学习率(破坏 cloze 能力)vs 小学习率(保住 cloze 能力)vs 冻结(能力完全不变)——把上面的推导变成数字。
4.2 防灾难性遗忘的更多武器(增量内容)
第 4 节说「小学习率能保能力」,工程上还有几件常用武器:
- 渐进解冻(gradual unfreezing):先只训分类头,再逐层往浅层解冻——后层离任务近、先动;底层是通用特征、后动,比一上来全量微调稳得多;
- 数据重放(data replay):微调 batch 里混入少量原预训练语料(或旧任务数据),让模型「边学新任务边复习旧知识」,直接对冲遗忘;
- EWC(弹性权重固化,Kirkpatrick et al., 2017):给对旧能力重要的参数加约束——用 Fisher 信息估计每个参数的重要性 $\Omega_i$,更新时对重要参数加大惩罚:$\mathcal{L}+\lambda\sum_i\Omega_i(\theta_i-\theta_i^*)^2$,让它们「不许乱动」;
- LoRA 的另一种视角:冻结全部预训练权重,只学低秩增量 $W+\Delta W=W+BA$($B\in\mathbb{R}^{d\times r}, A\in\mathbb{R}^{r\times d}$,秩 $r\ll d$)。因为 $\Delta W$ 秩低,它只能沿少数方向微调——在参数空间里「小动」,天然就是防遗忘,同时显存/存储开销大减(可训练参数只有 0.1%~1%)。
🎯 主线串起来:微调的本质 = 在「预训练好区域」附近做有约束的移动;学习率是约束强度,冻结/LoRA/EWC 是约束形态。实验 3 会亲手量化「大学习率如何破坏能力」。
工程细节补充:微调几乎总是用 AdamW + 小 warmup(前几百步学习率线性爬升后再衰减),并保守设置 weight decay——这是为了防止训练初期的大梯度直接破坏预训练表示;配合早停(2~5 epoch 后 loss 不再降就停),就是一套教科书式的微调配方,面试常被连问。
4.1 从微调到 Prompt / In-context Learning / RLHF
Prompt(提示):不换任何参数,把任务写成自然语言指令,让模型直接生成答案:
"把这句话翻译成英文:我爱北京"。模型能力来自预训练,任务形态由 prompt 决定。
In-context Learning(ICL,上下文学习):在 prompt 里给几个「输入→输出」示例,模型现场学会新任务:
示例1: 苹果 -> 水果
示例2: 老虎 -> 动物
请分类:鲸鱼 -> ?
零样本(0-shot)/ 少样本(few-shot)能力随模型规模增大而涌现(GPT-3 起成为主流用法)。
RLHF:让生成对齐人类偏好(GPT-3.5/4 的关键一步),三步流程图:
① SFT(监督微调)          ② RM(奖励模型)          ③ PPO(强化学习)
收集人工写的高质量答案   ─►  训练打分器:预测        ─►  用 RM 打分当奖励,
微调预训练模型             "人类更喜欢哪个回答"          优化策略模型(含 KL 约束)
- SFT:用人工标注的「指令 → 回答」继续微调 → 模型学会"听指令";
- RM:同一 prompt 给多个回答,人类排序打分 → 训练奖励模型 $r_\phi(x, y)$ 模拟人类偏好;
- PPO:把策略模型的生成送进 RM 打分,用策略梯度更新策略,同时加 KL 惩罚防止偏离 SFT 模型太远。
面试主线:预训练学通用语言 → 微调/指令学任务 → RLHF 学偏好。
5. 局限与演进
- 静态预训练:BERT/GPT 学完就固定,模型不会因"读到你昨天发的朋友圈"而更新;新知识要靠重训 / 微调 / 检索增强(RAG,提名字)。
- 长度限制:BERT 固定 512;早期 GPT 1024;现代 LLM 用 RoPE/ALiBi 外推到 8K~1M+,但注意力复杂度 $O(T^2)$ 仍是硬瓶颈(稀疏注意力 / FlashAttention 缓解)。
- 幻觉(hallucination):自回归生成会"一本正经地胡说八道"——生成模型没有"我不知道"机制;缓解手段:检索、事实校验、RLHF。
- 计算成本:预训练动辄百万级 GPU 时;微调/推理仍需大量显存 → 量化、蒸馏、LoRA 应运而生。
- 演进方向:RoBERTa(去 NSP)、ALBERT(参数共享)、ELECTRA(替换词检测)、T5(文本到文本统一)、GPT-4 / Claude / 开源 LLaMA 系列。
6. 数字敏感度与易错点(背诵)
数字记忆卡
- BERT-base:12 层、768 维、12 头、110M 参数;每头 64 维(768/12 口算)
- BERT-large:24 层、1024 维、16 头、340M
- MLM:mask 15%,内部 80/10/10;微调典型 2~5 epoch,学习率 1e-5~5e-5
- GPT-3:175B、96 层、batch 3.2M tokens;GPT-2:1.5B
- 上下文窗口:BERT 512;现代 LLM 8K ~ 1M+
面试官爱问的坑
- BERT 为什么双向,GPT 为什么单向? —— 结构即任务:理解要"看全",生成只能"看左";
- 80/10/10 为什么? —— 微调时没有 [MASK],预训练必须让模型适应"任意输入形态"(MASK/随机词/原词);
- 为什么不全掩码? —— 全掩码时上下文无信息,学不动;15% 是训练信号与上下文的平衡;
- 为什么 GPT 单向还能生成? —— 生成本来就是逐词预测,单向恰好匹配生成过程;
- 微调学习率为什么小? —— 大学习率一步跳出预训练好区域 → 灾难性遗忘;
- BERT 参数量口算 —— 12 层 × 12H² + 词表 × H ≈ 110M,别答"不知道"。
7. 面试速答(30 秒背诵版)
- 范式:预训练(无标注大语料学通用能力)+ 微调(少量标注学任务);迁移学习让小数据也能训大模型。
- BERT:Encoder 双向;MLM(15% 掩码,80/10/10)+ NSP(已被证伪);三 embedding 相加。
- GPT:Decoder 单向;自回归 next-token;因果掩码(上三角 -inf)。
- 上下文表示:一词多义靠上下文区分,Word2Vec 做不到;
[CLS]常做句表示。 - 微调技巧:小学习率 1e-5~5e-5、2~5 epoch、加分类头、防灾难性遗忘;冻结/LoRA 省资源。
- 对齐:RLHF = SFT → RM → PPO,让生成符合人类偏好。
- 生成技巧:贪心稳定但重复;温度 τ 控制随机性;top-k / top-p 防胡说。
8. 自测清单
- 说出 ELMo / BERT / GPT / T5 的架构与预训练任务
- 口算 BERT-base 参数量 ≈ 110M(12 层 × 12H² + 词表 × H)
- 默写 MLM 的 15% 与 80/10/10 规则,并解释"为什么不全掩码"
- 手写 mini-BERT MLM 训练(cloze 准确率 > 0.85)
- 画出生成时的因果掩码(下三角)并手写 mini-GPT 续写
- 说清 BERT 与 GPT 的结构差异如何决定任务分工(双向/单向、理解/生成)
- 说出微调三个实践要点(学习率 1e-5~5e-5 / 2-5 epoch / 防遗忘)
- 用温度公式口算:τ=2 时 logits=[2,1,0] 的概率变化趋势(更平)
- 解释 RLHF 在预训练-微调链条中的位置(SFT → RM → PPO)
- 说出预训练模型的三个局限(静态 / 长度 / 幻觉)
下一篇预告
💡 下一篇
06-文本分类与序列标注:把表示落到真实任务——用预训练/传统方法做分类与 NER, 学混淆矩阵、F1、BIO 标签。预训练模型学会了"语言",下一篇教它"干活"。
# ---------- 实验准备:环境、随机种子、中文字体 ----------
import math
import numpy as np
import torch
import torch.nn as nn
import matplotlib.pyplot as plt

torch.manual_seed(0)
np.random.seed(0)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print('torch', torch.__version__, '| device =', device)

plt.show()
# ---------- 实验 1a:BERT 三 embedding 相加 —— numpy 手写 vs torch 对照 ----------
V, D, T = 6, 4, 5
tok_ids = np.array([[1, 2, 3, 0, 0]])      # 4 个词 + 1 个 [PAD]
seg_ids = np.array([[0, 0, 0, 0, 0]])      # 句子 A 全 0
pos_ids = np.arange(T)                     # 位置 0..4

rng = np.random.default_rng(0)
E_tok = rng.standard_normal((V, D)) * 0.1
E_seg = rng.standard_normal((2, D)) * 0.1
E_pos = rng.standard_normal((T, D)) * 0.1

# numpy 手写:输入 = token + segment + position(逐元素相加)
x_np = E_tok[tok_ids] + E_seg[seg_ids] + E_pos[pos_ids][None]     # (1, T, D)

# torch 对照:把同样的权重拷进 nn.Embedding
emb_tok = nn.Embedding(V, D); emb_seg = nn.Embedding(2, D); emb_pos = nn.Embedding(T, D)
with torch.no_grad():
    emb_tok.weight.copy_(torch.tensor(E_tok))
    emb_seg.weight.copy_(torch.tensor(E_seg))
    emb_pos.weight.copy_(torch.tensor(E_pos))
x_pt = emb_tok(torch.tensor(tok_ids)) + emb_seg(torch.tensor(seg_ids)) + emb_pos(torch.tensor(pos_ids))[None]

assert np.allclose(x_np, x_pt.detach().numpy(), atol=1e-6)
print('手写 vs torch 一致 ✓  输入向量维度 = %d(拼接的话会是 3×%d=%d)' % (x_np.shape[-1], D, 3 * D))

# 可视化:三路贡献 + 求和(热力图)
fig, axes = plt.subplots(1, 4, figsize=(14, 3))
titles = ['token 部分', 'segment 部分', 'position 部分', '三者相加 = 输入']
parts = [E_tok[tok_ids][0], E_seg[seg_ids][0], E_pos[pos_ids], x_np[0]]
for ax, part, ti in zip(axes, parts, titles):
    im = ax.imshow(part, aspect='auto', cmap='RdBu_r', vmin=-0.5, vmax=0.5)
    ax.set_title(ti); ax.set_yticks(range(T)); ax.set_xticks(range(D))
    ax.set_ylabel('位置'); ax.set_xlabel('维度')
plt.tight_layout(); plt.show()

# BERT-base 参数量口算验证(≈110M):12 层 ×(4H² + 2·H·FFN + 2H) + 词表×H
V_tok, d_m, L_m, FFN = 30522, 768, 12, 3072
emb = (V_tok + 2 + 512) * d_m
per_layer = 4 * d_m * d_m + 2 * d_m * FFN + 2 * d_m     # QKV+out / FFN 两层 / 2 个 LN
total = emb + L_m * per_layer
print('口算参数量 ≈ %.1f M(BERT-base 官方 ≈ 110M)' % (total / 1e6))
# ---------- 实验 1b:MLM 15% 掩码与 80/10/10 —— 统计验证 ----------
rng = np.random.default_rng(1)
n_sents, T_s = 5000, 32

# 第一步:每个位置独立以 15% 概率被选中
masked = rng.random((n_sents, T_s)) < 0.15
n_masked = int(masked.sum())
print('选中位置数 = %d,理论期望 = 0.15 × %d × %d = %.0f' % (n_masked, n_sents, T_s, 0.15 * n_sents * T_s))

# 第二步:选中的位置内部按 80/10/10 分配(0=[MASK] 1=随机词 2=保留)
r = rng.random(n_masked)
kind = np.where(r < 0.8, 0, np.where(r < 0.9, 1, 2))
cnt = np.bincount(kind, minlength=3)
print('实际比例 [MASK/随机/保留] = %.1f%% / %.1f%% / %.1f%%' % tuple(100 * cnt / cnt.sum()))

# 第三步:为什么不全掩码 —— 每句期望掩码个数 + 全掩码的退化
no_mask = (~masked).all(axis=1)
print('没有任何掩码的句子:%d 句(%.1f%%)→ 短句更常见,需要"至少掩 1 个"修正' % (no_mask.sum(), 100 * no_mask.mean()))
print('全掩码退化演示:句长 %d 全部变成 [MASK] 时,上下文 = 全占位符 → 无信息可学' % T_s)

# 可视化:80/10/10 比例 + 每句掩码个数分布
plt.figure(figsize=(9, 3.5))
plt.subplot(1, 2, 1)
plt.bar(['[MASK] 80%', '随机词 10%', '保留 10%'], 100 * cnt / cnt.sum(), color=['#4C72B0', '#DD8452', '#55A868'])
plt.title('15% 选中位置内部的 80/10/10 分配'); plt.ylabel('占比 %')
plt.subplot(1, 2, 2)
plt.hist(masked.sum(axis=1), bins=range(0, 12), align='left', rwidth=0.8)
plt.axvline(0.15 * T_s, color='r', ls='--', label='期望 4.8 个')
plt.title('每句被掩码位置数分布'); plt.xlabel('掩码个数'); plt.ylabel('句数'); plt.legend()
plt.tight_layout(); plt.show()
# ---------- 实验 1c:mini-BERT —— 手写掩码语言模型(MLM)(原版实验保留并加注释) ----------
import numpy as np
import torch
import torch.nn as nn

torch.manual_seed(0)
# 5 句小语料(词表只有 13 个词)
sents = ['我 爱 北京 天安门', '北京 是 首都', '天安门 在 北京',
         '我 爱 学习 自然语言', '自然语言 很 有趣']
toks = [s.split() for s in sents]
vocab = ['[MASK]', '[PAD]'] + sorted({w for s in toks for w in s})
w2i = {w: i for i, w in enumerate(vocab)}; i2w = {i: w for w, i in w2i.items()}
V, L = len(vocab), 5
MASK_ID = w2i['[MASK]']; PAD_ID = w2i['[PAD]']
rng = np.random.default_rng(0)

def batch_of(n=6, mask_prob=0.15):
    """随机抽句子 → 以 15% 概率掩码;-100 表示该位置不参与交叉熵(教学简化版只换 [MASK],
    真正的 BERT 用 80/10/10,实验 1b 已验证统计比例)。"""
    xs, labels = [], []
    for _ in range(n):
        k = rng.integers(0, len(toks))
        seq = toks[k][:L]
        x = [w2i[w] for w in seq] + [PAD_ID] * (L - len(seq))
        lab = [-100] * L                       # -100 不参与 CE
        for p in range(len(seq)):
            if rng.random() < mask_prob:
                lab[p] = x[p]
                x[p] = MASK_ID
        if all(l == -100 for l in lab):        # 至少 mask 一个
            p = rng.integers(0, len(seq)); lab[p] = x[p]; x[p] = MASK_ID
        xs.append(x); labels.append(lab)
    return torch.tensor(xs), torch.tensor(labels)

class MiniBERT(nn.Module):
    """单层单头自注意力(无因果掩码 = 双向)+ FFN + LayerNorm + 词表头。"""
    def __init__(self, vocab, d=32, seq=5):
        super().__init__()
        self.emb = nn.Embedding(vocab, d)
        self.pos = nn.Parameter(torch.randn(1, seq, d) * 0.05)
        self.Wq = nn.Linear(d, d); self.Wk = nn.Linear(d, d); self.Wv = nn.Linear(d, d)
        self.ffn = nn.Sequential(nn.Linear(d, 64), nn.ReLU(), nn.Linear(64, d))
        self.ln1 = nn.LayerNorm(d); self.ln2 = nn.LayerNorm(d)
        self.head = nn.Linear(d, vocab)
    def forward(self, x):
        e = self.emb(x) + self.pos
        Q, K, V = self.Wq(e), self.Wk(e), self.Wv(e)
        sc = Q @ K.transpose(-1, -2) / np.sqrt(e.shape[-1])
        p = torch.softmax(sc, dim=-1)          # 双向:BERT 可以看到左右两侧
        a = self.ln1(e + p @ V)
        a = self.ln2(a + self.ffn(a))
        return self.head(a)                    # (B, L, V) 每个位置预测词

model = MiniBERT(V)
opt = torch.optim.Adam(model.parameters(), lr=5e-3)
ls = []
for ep in range(250):
    xb, yb = batch_of()
    logits = model(xb)
    loss = nn.functional.cross_entropy(logits.permute(0, 2, 1), yb, ignore_index=-100)
    opt.zero_grad(); loss.backward(); opt.step()
    ls.append(loss.item())
    if ep % 80 == 0:
        print('ep %3d mlm loss %.3f' % (ep, loss.item()))

# 评估:逐位置 cloze(一次 mask 一个词,看能否靠上下文填回)——与训练分布一致
def eval_mlm():
    hits = tot = 0
    for s in toks:
        for j in range(len(s)):
            x = [w2i[w] for w in s[:L]] + [PAD_ID] * (L - len(s))
            x[j] = MASK_ID
            with torch.no_grad():
                pred = model(torch.tensor([x]))[0, j].argmax().item()
            hits += (pred == w2i[s[j]]); tot += 1
    return hits / tot

acc = eval_mlm()
print('MLM 自填准确率(mask 全部真词后靠上下文恢复): %.3f' % acc)
assert acc > 0.85
# 演示:mask「北京」猜「首 都」
xb = torch.tensor([[w2i[w] for w in ['天安门', '在', '[MASK]']] + [PAD_ID, PAD_ID]])
with torch.no_grad():
    pred = model(xb)[0, 2].argmax().item()
print('「天安门 在 [MASK]」 -> 模型填:', i2w[pred])
assert pred == w2i['北京']
# ---------- 实验 1d:训练曲线 + 上下文相关表示(可视化) ----------
plt.figure(figsize=(6, 3.5))
plt.plot(ls)
plt.xlabel('epoch'); plt.ylabel('MLM loss'); plt.title('mini-BERT MLM 训练曲线')
plt.grid(alpha=0.3); plt.show()

# 用 hook 抓取倒数第二层表示(head 之前,即编码器输出)
acts = {}
def grab(m, i, o):
    acts['h'] = o
handle = model.ln2.register_forward_hook(grab)

def repr_of(words):
    x = torch.tensor([[w2i[w] for w in words] + [PAD_ID] * (L - len(words))])
    with torch.no_grad():
        model(x)
    return acts['h'][0, :len(words)].numpy()   # (len, d)

def cos(a, b):
    return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b) + 1e-9))

bj_s1 = repr_of(['我', '爱', '北京', '天安门'])[2]   # 「北京」在句 1(第 3 位)
bj_s2 = repr_of(['北京', '是', '首都'])[0]            # 「北京」在句 2(第 1 位)
ai_s1 = repr_of(['我', '爱', '北京', '天安门'])[1]    # 「爱」在句 1
handle.remove()

sim_same = cos(bj_s1, bj_s2)     # 同词、不同上下文
sim_diff = cos(bj_s1, ai_s1)     # 不同词、同句

# 对照:静态词向量(不经过上下文,直接查 embedding 表)
e_bj = model.emb.weight[w2i['北京']].detach().numpy()
e_ai = model.emb.weight[w2i['爱']].detach().numpy()
sim_static = cos(e_bj, e_ai)

print('上下文表示:cos(北京|句1, 北京|句2) = %.3f    cos(北京|句1, 爱|句1) = %.3f' % (sim_same, sim_diff))
print('静态词向量:cos(北京, 爱) = %.3f(不区分上下文)' % sim_static)

plt.figure(figsize=(6, 3.5))
plt.bar(['同词不同上下文', '不同词同句', '静态向量(北京,爱)'], [sim_same, sim_diff, sim_static],
        color=['#55A868', '#DD8452', '#4C72B0'])
plt.title('「北京」的表示:上下文相关 vs 静态'); plt.ylabel('cosine 相似度')
plt.show()
# ---------- 实验 2a:因果掩码 —— 手写 numpy 因果注意力 vs torch 对照 ----------
d2, T2a = 8, 5
rng = np.random.default_rng(0)
Q = rng.standard_normal((1, T2a, d2)); K = rng.standard_normal((1, T2a, d2)); Vals = rng.standard_normal((1, T2a, d2))

# 手写缩放点积注意力 + 因果掩码(上三角不含对角线填 -1e9 → softmax 后为 0)
sc = Q @ K.transpose(0, 2, 1) / math.sqrt(d2)
causal_mask = np.triu(np.ones((T2a, T2a)), 1).astype(bool)          # 上三角(不含对角线) = 被遮住
sc_masked = np.where(causal_mask[None], -1e9, sc)
e = np.exp(sc_masked - sc_masked.max(axis=-1, keepdims=True))
P_manual = e / e.sum(axis=-1, keepdims=True)
out_manual = P_manual @ Vals

# torch 对照
sc_t = torch.tensor(sc)
mask_t = torch.triu(torch.ones(T2a, T2a, dtype=torch.bool), diagonal=1)
P_t = torch.softmax(sc_t.masked_fill(mask_t, float('-inf')), dim=-1)
out_pt = P_t @ torch.tensor(Vals)
err = float(np.abs(out_manual - out_pt.numpy()).max())
assert err < 1e-6, err
print('手写因果注意力 vs torch 最大误差 = %.2e ✓' % err)
print('第 4 行(query 位置 3)注意力权重只落在 0..3 列:', np.round(P_manual[0, 3], 3))

plt.figure(figsize=(8.5, 3.5))
plt.subplot(1, 2, 1)
plt.imshow(~causal_mask, cmap='gray_r'); plt.title('因果掩码(深色=可见,浅色=遮住)')
plt.xlabel('key 位置'); plt.ylabel('query 位置'); plt.colorbar()
plt.subplot(1, 2, 2)
plt.imshow(P_manual[0], cmap='Blues'); plt.title('注意力权重:第 i 行只看 ≤ i 列')
plt.xlabel('key 位置'); plt.ylabel('query 位置'); plt.colorbar()
plt.tight_layout(); plt.show()
# ---------- 实验 2b:mini-GPT —— 手写因果注意力 + 自回归生成(原版实验保留) ----------
text = 'hello '                                   # 6 字符周期串
chars = sorted(set(text)); c2i = {c: i for i, c in enumerate(chars)}; i2c = {i: c for c, i in c2i.items()}
V2, T2 = len(chars), 6

class MiniGPT(nn.Module):
    """与 MiniBERT 结构相同,唯一区别:forward 里加因果掩码(上三角 -inf)。"""
    def __init__(self, vocab, d=32, seq=6):
        super().__init__()
        self.emb = nn.Embedding(vocab, d)
        self.pos = nn.Parameter(torch.randn(1, seq, d) * 0.05)
        self.Wq = nn.Linear(d, d); self.Wk = nn.Linear(d, d); self.Wv = nn.Linear(d, d)
        self.ffn = nn.Sequential(nn.Linear(d, 64), nn.ReLU(), nn.Linear(64, d))
        self.ln1 = nn.LayerNorm(d); self.ln2 = nn.LayerNorm(d)
        self.head = nn.Linear(d, vocab)
    def forward(self, x, mask):
        e = self.emb(x) + self.pos
        Q, K, V = self.Wq(e), self.Wk(e), self.Wv(e)
        sc = Q @ K.transpose(-1, -2) / np.sqrt(e.shape[-1])
        sc = sc.masked_fill(mask, float('-inf'))   # 因果掩码:只看左侧
        p = torch.softmax(sc, dim=-1)
        a = self.ln1(e + p @ V)
        a = self.ln2(a + self.ffn(a))
        return self.head(a)

causal = torch.triu(torch.ones(T2, T2, dtype=torch.bool), diagonal=1)[None]
def gpt_batch(n=64):
    xs, ys = [], []
    for _ in range(n):
        s = rng.integers(0, len(text))
        x = [c2i[text[(s + k) % len(text)]] for k in range(T2)]
        y = [c2i[text[(s + k + 1) % len(text)]] for k in range(T2)]
        xs.append(x); ys.append(y)
    return torch.tensor(xs), torch.tensor(ys)

model2 = MiniGPT(V2)
opt2 = torch.optim.Adam(model2.parameters(), lr=5e-3)
for ep in range(150):
    xb, yb = gpt_batch()
    logits = model2(xb, causal)
    loss = nn.functional.cross_entropy(logits.permute(0, 2, 1), yb)
    opt2.zero_grad(); loss.backward(); opt2.step()
    if ep % 50 == 0:
        print('ep %3d lm loss %.3f' % (ep, loss.item()))

with torch.no_grad():
    xb, yb = gpt_batch(300)
    acc2 = (model2(xb, causal).argmax(-1) == yb).float().mean().item()
print('next-char 准确率: %.3f' % acc2)
assert acc2 > 0.9

# 自回归生成:从 'h' 开始,用自己预测的字符续写(左侧补齐到窗口长度)
with torch.no_grad():
    x = torch.tensor([[c2i['h']]])
    gen = ['h']
    for _ in range(11):
        if x.shape[1] < T2:
            xp = torch.cat([torch.full((1, T2 - x.shape[1]), c2i['h']), x], dim=1)
        else:
            xp = x[:, -T2:]
        m = torch.triu(torch.ones(xp.shape[1], xp.shape[1], dtype=torch.bool), diagonal=1)[None]
        nxt = model2(xp, m)[0, -1].argmax().item()
        gen.append(i2c[nxt])
        x = torch.cat([x, torch.tensor([[nxt]])], dim=1)
print('mini-GPT 生成:', ''.join(gen))
assert ''.join(gen).startswith('hello')
# ---------- 实验 2c:温度采样 —— 新语料 mini-GPT 前缀续写 ----------
# 新语料:五言诗(去掉标点空格),训练一个能"背诗续写"的 mini-GPT
poem = '春眠不觉晓处处闻啼鸟夜来风雨声花落知多少'
chars3 = sorted(set(poem)); c32i = {c: i for i, c in enumerate(chars3)}; i32c = {i: c for c, i in c32i.items()}
V3, T3 = len(chars3), 12

rng3 = np.random.default_rng(0)
def poem_batch(n=64):
    xs, ys = [], []
    for _ in range(n):
        s = rng3.integers(0, len(poem) - T3)      # 随机起点,窗口长 T3
        win = poem[s:s + T3]
        xs.append([c32i[c] for c in win])
        ys.append([c32i[poem[s + k + 1]] for k in range(T3)])
    return torch.tensor(xs), torch.tensor(ys)

causal3 = torch.triu(torch.ones(T3, T3, dtype=torch.bool), diagonal=1)[None]
model3 = MiniGPT(V3, d=32, seq=T3)
opt3 = torch.optim.Adam(model3.parameters(), lr=5e-3)
for ep in range(250):
    xb, yb = poem_batch()
    loss = nn.functional.cross_entropy(model3(xb, causal3).permute(0, 2, 1), yb)
    opt3.zero_grad(); loss.backward(); opt3.step()
    if ep % 100 == 0:
        print('ep %3d lm loss %.3f' % (ep, loss.item()))

with torch.no_grad():
    xb, yb = poem_batch(300)
    acc3 = (model3(xb, causal3).argmax(-1) == yb).float().mean().item()
print('next-char 准确率: %.3f' % acc3)

# 温度对分布的影响:数字示例验证(markdown 里的口算)
logits_ex = torch.tensor([2.0, 1.0, 0.0])
for tau in [0.5, 1.0, 2.0]:
    p = torch.softmax(logits_ex / tau, dim=-1)
    print('tau=%.1f  logits=[2,1,0] -> 概率 %s' % (tau, np.round(p.numpy(), 3)))

def generate(model, c2i_, i2c_, prefix, max_len=12, tau=1.0):
    """自回归续写:窗口不足 T3 时用前缀首字符左侧补齐(教学简化)。"""
    gen = [c2i_[c] for c in prefix]
    pad_c = c2i_[prefix[0]]
    for _ in range(max_len):
        win = gen[-T3:]
        if len(win) < T3:
            win = [pad_c] * (T3 - len(win)) + win
        x = torch.tensor([win], dtype=torch.long)
        m = torch.triu(torch.ones(T3, T3, dtype=torch.bool), diagonal=1)[None]
        logits = model(x, m)[0, -1] / tau
        probs = torch.softmax(logits, dim=-1)
        gen.append(int(torch.multinomial(probs, 1).item()))
    return ''.join(i2c_[g] for g in gen)

with torch.no_grad():
    for tau in [0.1, 0.8, 1.5]:
        out = generate(model3, c32i, i32c, '春眠不', 12, tau)
        print('tau=%.1f  前缀「春眠不」→ %s' % (tau, out))
        assert out.startswith('春眠不')
print('温度越低越接近贪心(稳定重复),温度越高越多样(可能跑偏)——这就是 τ 的作用')
# ---------- 实验 3:微调 —— 大/小学习率、冻结/全量,观察灾难性遗忘 ----------
import copy
init_state = copy.deepcopy(model.state_dict())          # 预训练权重(实验 1c 训好的 mini-BERT)

# 任务:句子是否含「北京」(二分类),5 句小训练集
clf_toks = [s.split() for s in sents]
y = [1 if '北京' in s else 0 for s in sents]            # [1,1,1,0,0]

def eval_cloze(m):
    """参数化版本:cloze 自填准确率(评估预训练能力是否被保留)。"""
    hits = tot = 0
    for s in toks:
        for j in range(len(s)):
            x = [w2i[w] for w in s[:L]] + [PAD_ID] * (L - len(s))
            x[j] = MASK_ID
            with torch.no_grad():
                pred = m(torch.tensor([x]))[0, j].argmax().item()
            hits += (pred == w2i[s[j]]); tot += 1
    return hits / tot

def hidden_pool(m, xb):
    """复刻 forward 但返回平均池化表示(用于接分类头,且能回传梯度)。"""
    e = m.emb(xb) + m.pos
    Q, K, V = m.Wq(e), m.Wk(e), m.Wv(e)
    sc = Q @ K.transpose(-1, -2) / math.sqrt(e.shape[-1])
    p = torch.softmax(sc, dim=-1)
    a = m.ln1(e + p @ V)
    a = m.ln2(a + m.ffn(a))
    return a.mean(dim=1)                                 # (B, d)

def make_batch():
    xs = [[w2i[w] for w in s] + [PAD_ID] * (L - len(s)) for s in clf_toks]
    return torch.tensor(xs), torch.tensor(y)

def finetune(mode, lr, steps=80):
    m = MiniBERT(V); m.load_state_dict(init_state)       # 从预训练权重开始
    head = nn.Linear(32, 2)                              # 分类头
    if mode == 'freeze':
        for p in m.parameters():
            p.requires_grad_(False)                      # 冻结编码器,只训头
    params = list(head.parameters()) + [p for p in m.parameters() if p.requires_grad]
    opt = torch.optim.Adam(params, lr=lr)
    for _ in range(steps):
        xb, yb = make_batch()
        out = head(hidden_pool(m, xb))
        loss = nn.functional.cross_entropy(out, yb)
        opt.zero_grad(); loss.backward(); opt.step()
    with torch.no_grad():
        xb, yb = make_batch()
        acc_cls = (head(hidden_pool(m, xb)).argmax(-1) == yb).float().mean().item()
    return acc_cls, eval_cloze(m)

rows = []
for mode, lr in [('full', 5e-3), ('full', 5e-5), ('freeze', 5e-3)]:
    acc_cls, acc_mlm = finetune(mode, lr)
    rows.append((mode, lr, acc_cls, acc_mlm))
    print('%-6s lr=%.0e  分类 acc=%.2f   MLM cloze acc=%.3f' % (mode, lr, acc_cls, acc_mlm))

# 关键结论:大学习率破坏预训练能力(cloze 掉),小学习率保住
big = rows[0][3]; small = rows[1][3]
assert big < small, '大学习率应导致更多灾难性遗忘'
print('结论:大学习率(5e-3)把 cloze 从 ~1.00 打到 %.2f;小学习率(5e-5)保持 %.2f' % (big, small))
print('冻结微调 cloze 完全不变(%.3f):编码器没动 → 这就是 feature-based 策略' % rows[2][3])