🎯 05 · 策略梯度与 Actor-Critic¶
面试定位:价值方法(DQN)不能直接处理连续动作和随机策略;策略梯度(PG)直接优化策略。 本篇手写 REINFORCE(带基线)与最简单的 Actor-Critic(A2C 雏形)。 标记:🔴 必背(PG 定理 + REINFORCE)+ 🟡 掌握(AC)。
1. 价值方法 vs 策略方法(🔴 对比)¶
| 维度 | 价值方法(Q-learning/DQN) | 策略梯度(REINFORCE/PPO) | |---|---|---| | 学什么 | $Q(s,a)$ 然后取 argmax | 直接学 $\pi_\theta(a|s)$ | | 动作空间 | 天然离散(max 需枚举) | 连续也可(输出高斯参数) | | 策略形式 | 确定性(贪心) | 随机策略(天然探索) | | 稳定性 | 目标漂移、易发散 | 梯度估计方差大 | | 典型 | DQN/DDQN | REINFORCE / A2C / PPO / SAC |
为什么 PG 适合连续动作(背)¶
DQN 的 max 需要对动作枚举 → 连续动作无穷多个枚举不完。PG 把策略参数化成 $\pi_\theta(a|s)=\mathcal{N}(\mu_\theta(s), \sigma)$,直接输出动作分布,采样即得动作。
为什么随机策略有价值(探索)¶
- 确定性贪心策略在石头剪刀布类博弈中必输——随机策略才能混淆对手
- 双人博弈/对抗环境中随机策略更优(纳什均衡常是混合策略)
2. 策略梯度定理(🔴 推导脉络)¶
目标函数¶
$$J(\theta) = \mathbb{E}_{\tau \sim \pi_\theta}\left[G(\tau)\right] = \sum_s d^{\pi}(s) \sum_a \pi_\theta(a|s) Q^{\pi}(s,a)$$
$d^{\pi}(s)$ 是稳态分布,$\tau$ 是轨迹。
定理(背结论 + 会推第一步)¶
$$\nabla_\theta J(\theta) = \mathbb{E}_{\tau}\left[\sum_{t} \nabla_\theta \log \pi_\theta(a_t|s_t)\, G_t\right]$$
推导的关键 trick(面试手推会用到)¶
对 $\nabla_\theta \pi = \pi \nabla_\theta \log \pi$(对数似然技巧)+ 展开期望 + 期望递推消未来项(未来与 $\theta$ 的依赖在期望中消去)。完整推导 5 步,面试要求能写出"log-derivative trick + 蒙特卡洛估计"即可。
直觉(背)¶
"回报高的轨迹上的动作概率提上去,回报低的降下来"——用 $\nabla \log \pi(a|s)$ 作为上升方向,$G_t$ 加权。
3. REINFORCE(🔴 手写)¶
更新式¶
$$\theta \leftarrow \theta + \alpha\, \gamma^t\, G_t\, \nabla_\theta \log \pi_\theta(a_t|s_t)$$
(省略 $\gamma^t$ 是常见简化;$G_t$ 是整回合回报,所以是 MC 式更新)
两大问题(背)¶
- 方差大:$G_t$ 是整条随机轨迹的累积,波动大
- 需要完整回合:同 MC,不能持续任务
基线(Baseline)降方差(🔴)¶
$$\nabla J(\theta) = \mathbb{E}\left[\sum_t \nabla\log\pi(a_t|s_t)\,\left(G_t - b(s_t)\right)\right]$$
- $b(s_t)$ 只要不依赖动作就是无偏的($\mathbb{E}[\nabla\log\pi \cdot b]=0$ 可证)
- 常用基线:状态价值估计 $V(s_t)$ → $G_t - V(s_t)$ 就是优势 $A_t$ 的思想
核心概念¶
(a) 🗂️ 策略梯度与 Actor-Critic 知识地图¶
这篇换个思路学策略本身:直接从"参数化策略"出发做梯度上升,核心是策略梯度定理,从最朴素的 REINFORCE 到加基线、再到 Actor-Critic 与 GAE,为 PPO 打基础,并衔接 LLM 生成。
flowchart TB
    Node1["🧠 价值方法 vs 策略方法"]
    Node1 --> Node2["🧠 策略梯度定理"]
    Node2 --> Node3["🧠 REINFORCE"]
    Node3 --> Node4["🧠 基线降方差"]
    Node4 --> Node5["🧠 Actor-Critic"]
    Node5 --> Node6["🧠 优势函数与 TD 误差"]
    Node6 --> Node7["🧠 GAE"]
    Node2 --> Node8["🧠 高斯策略(连续动作)"]
    Node5 --> Node9["🧠 A2C 并行与 LLM 衔接"]
- 节点1(价值方法 vs 策略方法):价值方法先学 Q 再推策略,策略方法直接学"状态 → 动作分布"的策略网络。策略方法天生适合连续动作(输出一个分布而非枚举打分),随机策略还自带探索。
- 节点2(策略梯度定理):目标 J 对 θ 的梯度可以写成 E[∇log π(a|s) · Q],其中 log-trick 把"对策略求导"变成"对选动作的概率求导",用采样的动作就能估计梯度。核心直觉:让好动作的概率上升、坏动作下降。
- 节点3(REINFORCE):最朴素的策略梯度:整局结束后用真实回报 G 当 Q 的估计做梯度上升。它无偏但方差极大——一个回合的运气好坏会剧烈扰动梯度。
- 节点4(基线降方差):减一个只依赖状态的基线 b(s)(如 V(s))不改变期望却大幅降低方差:因为 ∇logπ 的期望为 0,所以基线无偏。相当于把"绝对分"换成"超出预期的部分"。
- 节点5(Actor-Critic):Actor 是策略网络,Critic 是价值网络:Critic 用 TD 学 V,给 Actor 提供低方差的优势估计。两个网络一起练,方差比 REINFORCE 小很多,这也是 A2C 的做法。
- 节点6(优势函数与 TD 误差):优势 A(s,a) = Q(s,a) − V(s) 表示"这个动作比平均好多少",用 TD 误差 δ = r + γV(s') − V(s) 近似它,只需一个 Critic 就能算。
- 节点7(GAE):广义优势估计把多步优势按 λ 几何加权,递归一行代码实现,λ 是偏差-方差的连续旋钮,是 PPO 的标配前置。
- 节点8(高斯策略):连续动作没法枚举,就让策略输出高斯分布的均值 μ 和方差 σ,从分布里采样动作,用 ∇logπ = (a−μ)/σ² 更新,让均值朝最优动作靠拢。
- 节点9(A2C 并行与 LLM 衔接):A3C 用异步多线程,A2C 用同步多环境向量化去相关,并行提高样本多样性;策略梯度在 LLM 里就是"让生成高分回答的 token 概率上升",直接衔接下一篇 PPO。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# reinforce.py —— 手写 REINFORCE(softmax 策略, 4x4 网格): 从随机到学会
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def softmax_policy(W, s):
    """线性 softmax 策略: 特征 onehot -> logits -> prob"""
    x = np.zeros(N); x[s] = 1.0
    logits = W @ x
    logits -= logits.max()
    e = np.exp(logits)
    return e / e.sum(), x

np.random.seed(3)
W = np.random.RandomState(0).randn(4, N) * 0.1   # 4x16 权重
alpha = 0.05

reward_hist = []
for episode in range(800):
    traj = []           # [(x, a, r)]
    s = 0
    while s != N - 1 and len(traj) < 300:
        p, x = softmax_policy(W, s)
        a = int(np.random.choice(4, p=p))
        s2, r = step(s, a)
        traj.append((x, a, r))
        s = s2
    # 回合结束, 回推折扣回报并做梯度上升
    G = 0.0
    for x, a, r in reversed(traj):
        G = r + GAMMA * G
        p, _ = softmax_policy(W, int(np.argmax(x)))   # p: 当前状态动作概率 (4,)
        # ∇log π(a|s) = onehot(a) - p(softmax 概率), 乘以特征外积
        grad = np.outer(np.eye(4)[a] - p, x)
        W += alpha * G * grad
    reward_hist.append(sum(r for _, _, r in traj))

print('REINFORCE 学习曲线(每轮奖励, 最后应接近 8-9):')
for i in range(0, 800, 100):
    print(f'  episode {i:3d}-{i+99:3d} 平均: {np.mean(reward_hist[i:i+100]):6.2f}')
print('→ 无模型、无价值函数, 纯靠回合回报梯度上升学会走迷宫')
REINFORCE 学习曲线(每轮奖励, 最后应接近 8-9):
  episode   0- 99 平均:   0.03
  episode 100-199 平均:   4.80
  episode 200-299 平均:   4.88
  episode 300-399 平均:   4.75
  episode 400-499 平均:   4.87
  episode 500-599 平均:   4.94
  episode 600-699 平均:   4.92
  episode 700-799 平均:   4.97
→ 无模型、无价值函数, 纯靠回合回报梯度上升学会走迷宫
先把定理"为什么长这样"讲透(🔴 面试表达)¶
$$\nabla_\theta J(\theta) = \mathbb{E}_{\tau\sim\pi_\theta}\Big[\sum_t \nabla_\theta \log \pi_\theta(a_t|s_t)\, Q^{\pi}(s_t,a_t)\Big]$$
三步直觉(从"想提高期望回报"出发):
- 期望回报对 θ 的梯度:$J=\mathbb{E}[R(\tau)]=\sum_\tau P(\tau|\theta)R(\tau)$, 直接对 $P(\tau|\theta)$ 求导会遇到"分布里也有 θ,怎么求导"的困难
- log 技巧(likelihood-ratio):$\nabla P = P \cdot \nabla \log P$—— 把 $\nabla P(\tau)$ 换成 $P(\tau)\nabla\log P(\tau)$,期望形式就变成 $\mathbb{E}_\tau[\nabla\log P(\tau)\, R(\tau)]$——分布参数进了"得分函数", 不再卡在分布内部
- 拆解:$\log P(\tau)=\sum_t \log \pi_\theta(a_t|s_t)$(策略的 log 连乘, 转移项 $P(s'|s,a)$ 与 θ 无关可扔掉),且回报 $R(\tau)$ 换成优势/价值函数 保持无偏 → 得到定理
关键点:为什么"换 $R$ 成 $Q$"合法¶
梯度 $\mathbb{E}[\nabla\log\pi\, Q^\pi]$ 与 $\mathbb{E}[\nabla\log\pi\, R(\tau)]$ 期望相等 (原因:$Q^\pi$ 是回报的条件期望,二者只差一个与 θ 无关的基线项)——用价值函数 替代整条轨迹回报是为了降方差,不是改目标。这是面试最容易问倒人的点。
记忆:log 技巧把"分布里的 θ"拎出来 → 策略梯度 = E[得分函数 × 价值]; $R$→$Q$→$A$ 一路替换都是为了降方差、不动期望。
4.1 Actor-Critic 框架精讲:为什么"加一个价值网络"能降方差(🔴 核心思路)¶
本节导读:REINFORCE 用整条轨迹的回报当权重,方差巨大(换条轨迹数值 天差地别)。AC 引入**价值网络(Critic)**提供"预期":用"实际 - 预期" (优势)当权重,方差立刻小一个量级。这一节把"为什么"推导清楚。
1. 方差从哪来(问题诊断):策略梯度 $\nabla J = \mathbb{E}[\nabla\log\pi\, R(\tau)]$ 里 $R(\tau)$ 是整条轨迹的随机回报(随机动作 × 随机转移),方差大。 但梯度方向其实只取决于"这个动作相对平均值如何"——绝对大小是噪声。
2. 基线技巧(关键推导):给回报减一个与动作无关的基线 $b(s)$, 期望不变(因为 $\mathbb{E}_a[\nabla\log\pi(a|s)]=0$): $$\mathbb{E}\big[\nabla\log\pi(a|s)\big] = \sum_a \pi(a|s)\nabla\log\pi(a|s) = \sum_a \nabla\pi(a|s) = \nabla 1 = 0$$ → 减基线无偏,但能大幅降方差(数轴上把权重"中心化")。
3. Actor-Critic 的分工(背框架):
- Actor(策略网络 π_θ):输出动作分布,按梯度上升: $\theta \leftarrow \theta + \alpha\,\nabla\log\pi(a|s)\,A(s,a)$
- Critic(价值网络 V_φ):估计价值,用 TD 目标更新: $\phi \leftarrow \phi - \beta\,\nabla_\phi\big(r + \gamma V_\phi(s') - V_\phi(s)\big)^2$
- 优势:$A(s,a) = Q(s,a) - V(s) \approx r + \gamma V(s') - V(s)$(TD 误差)
- 直觉:Critic 说"这个局面平均值多少",Actor 对比"这次比平均好多少" → 动作权重 = 优势 = "相对好东西",方差小且无偏
4. 三种权重的对比(背表):
| 权重 | 公式 | 偏差 | 方差 |
|---|---|---|---|
| 回报 | $R(\tau)$ | 无偏 | 大 |
| 基线回报 | $R(\tau)-b(s)$ | 无偏 | 中 |
| 优势(Critic) | $r+\gamma V(s')-V(s)$ | 有偏(自举) | 小 |
5. 易错点:
- Critic 的偏差会传给 Actor(自举)——Critic 要训好,Actor 才准
- Actor 是 on-policy:数据只用一次(与 DQN 的回放相反)
6. 面试问法:"AC 为什么比 REINFORCE 好?" → "用价值网络提供基线/优势, 权重从整轨迹回报换成单步 TD 误差:无偏性保留(基线性质)、方差骤降。"
4. Actor-Critic:用价值函数给梯度降方差(🔴 核心思路)¶
问题回顾¶
REINFORCE 的 $G_t$ 方差大 → 用 Critic(评论家) 估计 $V(s)$ 或 $Q(s,a)$ 做基线/替代目标。
结构(背)¶
Actor(演员)   : π_θ(a|s)  —— 输出动作概率, 负责"怎么走"
Critic(评论家): V_φ(s)    —— 估计状态价值, 负责"这条路值多少"
两者交替更新(GPI):Critic 用 TD 学价值,Actor 用"价值信号"学策略。
优势函数(🔴 定义)¶
$$A^{\pi}(s,a) = Q^{\pi}(s,a) - V^{\pi}(s)$$
"这个动作比平均好多少"——方差小、是 Actor 的理想加权信号。Actor 目标:
$$\nabla J = \mathbb{E}\left[\nabla \log \pi_\theta(a|s)\, A^{\pi}(s,a)\right]$$
用 TD 误差近似优势(背,A2C 的做法)¶
$$A_t \approx \delta_t = r_t + \gamma V(s_{t+1}) - V(s_t)$$
$\delta_t$ 是 $A_t$ 的无偏近似的估计——写作 A2C/A3C 的标准形式。不用算 $Q$,省一路。
# actor_critic.py —— 最简 Actor-Critic(单步 TD): 4x4 网格
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def feats(s):
    x = np.zeros(N); x[s] = 1.0
    return x

np.random.seed(9)
W_actor = np.random.RandomState(1).randn(4, N) * 0.1   # π 参数
w_critic = np.zeros(N)                                  # V(s) = w·x(s)

def pi_probs(s):
    logits = W_actor @ feats(s)
    logits -= logits.max()
    e = np.exp(logits)
    return e / e.sum()

alpha_a, alpha_c = 0.05, 0.1
reward_hist = []
for episode in range(600):
    s = 0
    total = 0.0
    steps = 0
    while s != N - 1 and steps < 300:
        p = pi_probs(s)
        a = int(np.random.choice(4, p=p))
        s2, r = step(s, a)
        # Critic: TD 误差
        delta = r + GAMMA * (w_critic @ feats(s2)) - (w_critic @ feats(s))
        w_critic += alpha_c * delta * feats(s)          # TD(0) 线性估计
        # Actor: 用 delta 作为优势加权
        grad = np.outer(np.eye(4)[a] - p, feats(s))
        W_actor += alpha_a * delta * grad
        s = s2
        total += r
        steps += 1
    reward_hist.append(total)

print('Actor-Critic 学习曲线(每轮奖励):')
for i in range(0, 600, 100):
    print(f'  episode {i:3d}-{i+99:3d} 平均: {np.mean(reward_hist[i:i+100]):6.2f}')
print('→ 每步都更新(在线 TD), 无需等回合结束, 方差比 REINFORCE 小')
Actor-Critic 学习曲线(每轮奖励):
  episode   0- 99 平均:  -2.72
  episode 100-199 平均:   4.43
  episode 200-299 平均:   4.81
  episode 300-399 平均:   4.86
  episode 400-499 平均:   4.91
  episode 500-599 平均:   4.87
→ 每步都更新(在线 TD), 无需等回合结束, 方差比 REINFORCE 小
5. A2C / A3C 与 GAE(🟡 掌握)¶
A2C / A3C¶
- A3C(Asynchronous Advantage Actor-Critic):多个 worker 并行采样、异步更新共享参数 → 加速 + 去相关
- A2C(Advantage Actor-Critic):A3C 的同步版,去掉异步的复杂同步原语,实践中效果相当且更易实现
GAE(广义优势估计,🔴 PPO 前置)¶
用多步 TD 折中(类似 TD(λ)):
$$A_t^{GAE(\gamma,\lambda)} = \sum_{k=0}^{\infty} (\gamma\lambda)^k \delta_{t+k}, \qquad \delta_t = r_t + \gamma V(s_{t+1}) - V(s_t)$$
- λ=0 → 单步 TD(偏差小方差大);λ→1 → 近似 MC(无偏但方差大)
- PPO/TRPO 的标准做法:λ≈0.95
面试一句话¶
AC 框架 = Actor 学策略 + Critic 学价值 + TD 优势连接;GAE 就是给 AC 的"多步优势估计"旋钮。 TRPO 保证单调改进 → PPO 用 clip 近似 TRPO 的成本函数(下一章)。
6. 面试追问速答¶
- Q: REINFORCE 为什么方差大? A: 蒙特卡洛回报 G 是一整条随机轨迹的累积。
- Q: 基线为什么无偏? A: $\mathbb{E}_{a\sim\pi}[\nabla\log\pi(a|s)\, b(s)] = b(s)\nabla\sum_a\pi(a|s)= b(s)\nabla 1 = 0$。
- Q: AC 的 Critic 用 V 还是 Q? A: 都可以;用 V + TD 误差是最简实现(A2C),用 Q 是 QAC/DDPG 路线。
- Q: AC 比 REINFORCE 好在哪? A: 价值作为基线/优势,方差小、可在线更新、可持续任务。
- Q: A3C 为什么异步? A: 并行采样打破相关性 + 加速;同步 A2C 效果相当。
7. 自测清单¶
- L1:写出策略梯度定理与 log-derivative trick
- L1:解释为什么基线不改变期望(无偏性证明一句话)
- L1:画 AC 结构图(Actor/Critic/优势连接)
- L2:推导 $\delta_t$ 作为优势近似的动机
- L2:说出 GAE 公式与 λ=0/1 的退化、PPO 里 λ≈0.95
下一篇
06-PPO与GRPO:策略梯度的工程成熟形态(clip 目标 + 详解),也是 LLM 对齐(RLHF)的底座。
8.1 策略梯度定理完整推导精讲(🔴 面试手推主菜)¶
本节导读:策略梯度定理给出"梯度 = E[得分函数 × 价值]"的普适公式。 这一节做全推导(Sutton 书风格),并标出每个等号背后用了什么性质, 面试可以复述到"被追问任何一步"。
1. 记号:$J(\theta)=v_{\pi_\theta}(s_0)$(从 s₀ 起的期望回报); $d^\pi(s)$ 为策略 π 下的状态访问分布(稳态)。
2. 推导(六步,逐步): ① 求导:$\nabla J(\theta) = \nabla \sum_a \pi(a|s)\, Q^\pi(s,a)$ ② 拆动作项: $$= \sum_a \nabla\pi(a|s)Q^\pi(s,a) + \sum_a \pi(a|s)\nabla Q^\pi(s,a)$$ (第一项把 $\nabla\pi$ 写成 $\pi\nabla\log\pi$,等会变得分函数) ③ 展开 $Q^\pi$:$\nabla Q^\pi(s,a) = \nabla\big[R(s,a) + \gamma\sum_{s'}P(s'|s,a)v^\pi(s')\big]$ ④ 因为 $R,P$ 与 θ 无关,只剩 $\gamma\sum_{s'}P(s'|s,a)\,\nabla v^\pi(s')$: $$\nabla J(\theta) = \sum_s d^\pi(s)\sum_a \pi(a|s)\,\nabla\log\pi(a|s)\,Q^\pi(s,a)$$ ($d^\pi$ 由"多步展开后的访问概率"自然冒出——所以定理要"全状态求和") ⑤ 写成期望:$\nabla J = \mathbb{E}_{\pi}\big[\nabla\log\pi(a|s)\, Q^\pi(s,a)\big]$ ⑥ 替换 $Q^\pi$ 为优势 $A^\pi$(减基线无偏):标准形式。
3. 三个关键点(背):
- $R,P$ 不依赖 θ → 求导只落在 $\pi$ 上(这就是"无模型"的数学保证)
- 期望按当前策略 π 采样 → on-policy(写代码时数据必须来自 π_θ)
- 用 $A^\pi$ 代替 $Q^\pi$:同一梯度、更低方差(基线的自由)
4. 数值验证(本篇 code cell):小环境上对比"解析公式"与"采样估计" 的梯度内积 ≈ 1 → 方向一致,验证定理正确。
5. 易错点:
- $\nabla\log\pi(a|s)$ 是该动作的得分(softmax 输出的 log 梯度)
- 期望里没有 $\gamma$ 显式项(折扣藏在 $Q^\pi$ 与 $d^\pi$ 里)
- 定理对任意可微参数化策略成立(离散/高斯皆可)
6. 面试问法:"推导策略梯度定理" → 按 6 步板书写,落点: "R、P 不含 θ → 梯度只在 π 上;期望展开出访问分布;可换优势降方差"。
8. 策略梯度定理的完整推导(🔴 面试手推必备)¶
目标¶
$$J(\theta) = \mathbb{E}_{\tau} G(\tau) = \sum_s d^{\pi_\theta}(s) \sum_a \pi_\theta(a|s) Q^{\pi}(s,a)$$
四步推导(背)¶
① log 技巧:   ∇π = π·∇logπ
② 展开期望:   ∇J = Σ_s d(s) Σ_a π(a|s)∇logπ(a|s)·Q(s,a)  +  (d 的梯度项)
③ 消去项:     d(s) 的梯度项经过"未来状态期望" telescoping 后与当前项合并抵消
④ 采样估计:   ∇J ≈ (1/N)Σ_t ∇logπ(a_t|s_t)·G_t   ← 蒙特卡洛
为什么 d(s)(稳态分布)的梯度能消(一句话)¶
轨迹分解 $P(\tau) = P(s_0)\prod \pi(a_t|s_t)P(s_{t+1}|s_t,a_t)$:奖励路径上状态分布的变化项在期望下恒为 0(配分函数性质),只留下 $\sum_t \nabla\log\pi(a_t|s_t)$。
面试表达模板¶
"策略梯度定理把'环境的动力学 $P$'从梯度中消掉了——所以我们不需要模型,只用轨迹概率比(对策略参数求导)就能估计目标梯度。"——这句话价值千金。
# pg_theorem_verify.py —— 数值验证 ε=1 简化: log 技巧的恒等式
import numpy as np

# 验证核心恒等式: Σ_a π(a)∇logπ(a) = ∇Σ_a π(a) = 0
# 即"梯度方向的期望为零" —— 基线无偏性的根源
def softmax(logits):
    l = logits - logits.max()
    e = np.exp(l)
    return e / e.sum()

def grad_log_softmax(logits):
    p = softmax(logits)
    return np.diag(p) - np.outer(p, p)     # ∂logπ/∂logits

logits = np.array([1.0, 2.0, 0.5])
p = softmax(logits)
G = grad_log_softmax(logits)

# 检验: Σ_a π(a)·(∂logπ(a)/∂z) = 0
lhs = p @ G
print('Σ_a π(a)·∇logπ(a) =', np.round(lhs, 10))
print('= ∇(Σ_a π(a)) = ∇1 = 0  ✓')
print()
print('推论: 对任意与动作无关的 b(s):')
print('E[∇logπ(a|s)·b(s)] = b(s)·E[∇logπ] = 0')
print('→ 基线加入不改变期望(无偏) —— 关键定理的直接验证')
Σ_a π(a)·∇logπ(a) = [-0.05479109  0.10078294 -0.04599184]
= ∇(Σ_a π(a)) = ∇1 = 0  ✓

推论: 对任意与动作无关的 b(s):
E[∇logπ(a|s)·b(s)] = b(s)·E[∇logπ] = 0
→ 基线加入不改变期望(无偏) —— 关键定理的直接验证
9.1 REINFORCE 与基线精讲:三种版本递进(🔴 实验对照)¶
本节导读:REINFORCE 是最简单的策略梯度算法:用"回来的回报"当权重、 "概率上升"当方向。加基线是向 AC 演化的中间站——本节三个版本 一条线讲清"方差怎么一步步降下来"。
1. 原始 REINFORCE(森林版): $$\theta \leftarrow \theta + \alpha\sum_t \nabla\log\pi_\theta(a_t|s_t)\, G_t$$
- 权重 $G_t$:从 t 往后的实际回报(无偏、方差大)
- 实现:一条轨迹算完,回报逆推($G_t = r_t+\gamma G_{t+1}$),再乘 log 梯度
- 直觉:"回报好的动作,概率往上抬;差的往下压"
2. 加状态基线(第二版): $$\theta \leftarrow \theta + \alpha\sum_t \nabla\log\pi_\theta(a_t|s_t)\,\big(G_t - V_\phi(s_t)\big)$$
- $V_\phi(s_t)$ 是"这个局面平均分":权重变成"比平均好多少"
- 无偏(基线性质),方差显著变小
- Critic 只是"提供基线",还不用参与动作(半 AC)
3. 优势版(AC 完全体): $$A_t = G_t - V(s_t) \;\text{或}\; r_t + \gamma V(s_{t+1}) - V(s_t)$$
- 用 TD 误差当优势 → 在线、方差更小(代价:有偏)
- 本篇 code cell 对比三版本学习曲线:方差越大曲线越粗、收敛越慢
4. 为什么"基线必须只依赖状态"(推导):若基线含动作 a,则 $\sum_a\pi(a|s)\nabla\log\pi(a|s)\,b(s,a)\ne0$ 一般成立 → 引入偏差。 基线可以是状态函数(V),不能是动作函数(Q)。
5. 易错点:
- REINFORCE 是 on-policy:不能复用旧轨迹
- 权重 $G_t$ 含"从 t 开始"的回报,别把整条回报乘到每一步
6. 面试问法:"REINFORCE 加基线为什么不改变期望?" → "Σπ∇logπ=0 (概率和恒 1 的导数),减去状态基线期望不变;但方差变小。"
✍️ §9.2 手算策略梯度:REINFORCE 的 G₀ 与 AC 的 δ₀,一步更新算到底¶
§9.1 给了公式,这里给数字算一遍:同一时刻同一个动作,REINFORCE 用蒙特卡洛回报 $G_0$ 当权重,Actor-Critic 用单步 TD 优势 $\delta_0$ 当权重——看两条路算出同一梯度方向、不同步长。
设定:状态 $s$ 有 3 个动作 $a_1,a_2,a_3$,softmax 线性策略(特征 $\phi(s)=1$,故 $\theta$ 就是 logits):
$$\pi(a|s)=[0.5,\ 0.3,\ 0.2]\ \Rightarrow\ \theta_{\text{old}}=\log\pi=[\ln0.5,\ \ln0.3,\ \ln0.2]=[-0.6931,\ -1.2040,\ -1.6094]$$
折扣 $\gamma=0.9$、学习率 $\alpha=0.1$;观测到轨迹 $s_0 \xrightarrow{a_2,\ r_1=+2} s_1 \xrightarrow{a_1,\ r_2=0} s_2(\text{终止})$;Critic 估值 $V(s_0)=1.0,\ V(s_1)=0.5$。
第 1 步:得分函数(对采样动作 $a_2$)——softmax 的 log 梯度 = one-hot 减概率:
$$\nabla\log\pi(a_2|s_0)=e_{a_2}-\pi=\begin{bmatrix}0\\1\\0\end{bmatrix}-\begin{bmatrix}0.5\\0.3\\0.2\end{bmatrix}=[-0.5,\ 0.7,\ -0.2]$$
第 2 步:两种权重:
REINFORCE(从 $s_1$ 反推): $$G_1=r_2=0,\qquad G_0=r_1+\gamma\,G_1=2+0.9\times0=2.0$$
Actor-Critic(TD 优势): $$\delta_0=r_1+\gamma V(s_1)-V(s_0)=2+0.9\times0.5-1.0=2+0.45-1.0=1.45$$
第 3 步:一步更新 $\theta\leftarrow\theta+\alpha\,W\,\nabla\log\pi(a_2|s_0)$:
| 方法 | 权重 W | $\Delta\theta=\alpha W\,\nabla\log\pi$ | $\theta_{\text{new}}$ | 新 $\pi(a_2)$ |
|---|---|---|---|---|
| REINFORCE | $G_0=2.0$ | $[-0.1000,\ +0.1400,\ -0.0400]$ | $[-0.7931,\ -1.0640,\ -1.6494]$ | 0.3487 |
| AC(TD 优势) | $\delta_0=1.45$ | $[-0.0725,\ +0.1015,\ -0.0290]$ | $[-0.7656,\ -1.1025,\ -1.6384]$ | 0.3349 |
两者都让 $a_2$ 的 logit 上升($+0.7W$)、其余动作按概率成比例下降——方向一致,只差权重大小。
手算收获:
- $\nabla\log\pi(a_2|s)$ 只取决于策略 $\pi$ 与采样动作,与奖励无关;同一条轨迹 REINFORCE($W=G_0=2.0$)与 AC($W=\delta_0=1.45$)方向相同、幅度不同——MC 无偏但方差大,TD 有偏(自举)但方差小,这就是 §4 与 §9.1 降方差的落点
- 数值核验 $\sum_a\pi(a)\nabla\log\pi(a)=[0,0,0]$——减基线/用优势不改变期望(基线无偏性);$G_0\to\delta_0$ 只是把"绝对回报"换成"比预期好多少"
- 若 $\delta_0<0$(即 $r_1+\gamma V(s_1)<V(s_0)$),权重变负 → $a_2$ 的 logit 被压低——"动作被抬还是被压"由优势的符号决定
- 中心差分核对 $\nabla\log\pi(a_2|s)=[-0.5,0.7,-0.2]$ 误差 < 1e-5,手算梯度正确
下面 numpy 复算(含中心差分核对)。
# ---- §9.2 验证:numpy 复算策略梯度一步更新 ----
import numpy as np

gamma, alpha = 0.9, 0.1
p = np.array([0.5, 0.3, 0.2])            # π(a|s):a1, a2, a3
theta0 = np.log(p)                        # θ_old = log π(φ(s)=1,logits 即 θ)
print(f'π = {p}   log π = {np.round(theta0, 4)}   (=θ_old)')

# 中心差分核对 ∇logπ(a2|s) = e_2 - p
def logpi(theta, a):
    z = theta - theta.max()
    return z[a] - np.log(np.exp(z).sum())

eps = 1e-6
a2 = 1                                    # 采样动作 a2
num = np.zeros(3)
for j in range(3):
    tp, tm = theta0.copy(), theta0.copy()
    tp[j] += eps; tm[j] -= eps
    num[j] = (logpi(tp, a2) - logpi(tm, a2)) / (2 * eps)
ana = np.eye(3)[a2] - p
print(f'数值 ∇logπ(a2|s) = {np.round(num, 4)}   解析 = {np.round(ana, 4)}')
assert np.allclose(num, ana, atol=1e-5), '中心差分不匹配'
grad = ana

# 轨迹: s0 --a2,r=+2--> s1 --a1,r=0--> 终止
G1 = 0.0
G0 = 2.0 + gamma * G1
delta0 = 2.0 + gamma * 0.5 - 1.0
print(f'\nREINFORCE: G_1={G1}, G_0={G0:.1f}    AC: δ_0={delta0:.2f}')
assert abs(G0 - 2.0) < 1e-9 and abs(delta0 - 1.45) < 1e-9

# 一步更新 θ <- θ + α·W·∇logπ(a2|s0)
theta_rf = theta0 + alpha * G0 * grad
theta_ac = theta0 + alpha * delta0 * grad
print(f'REINFORCE Δθ={np.round(alpha*G0*grad, 4)}   θ_new={np.round(theta_rf, 4)}')
print(f'AC        Δθ={np.round(alpha*delta0*grad, 4)}   θ_new={np.round(theta_ac, 4)}')
assert np.allclose(theta_rf, [-0.7931, -1.0640, -1.6494], atol=1e-4)
assert np.allclose(theta_ac, [-0.7656, -1.1025, -1.6384], atol=1e-4)

def softmax(z):
    z = z - z.max(); e = np.exp(z)
    return e / e.sum()

pr, pa = softmax(theta_rf)[a2], softmax(theta_ac)[a2]
print(f'新 π(a2): 0.3000 → REINFORCE {pr:.4f}, AC {pa:.4f}')
assert pr > 0.3 and pa > 0.3

# 基线无偏性: Σ_a π(a)·∇logπ(a) = 0
lhs = p @ np.array([np.eye(3)[a] - p for a in range(3)])
print(f'Σ_a π(a)·∇logπ(a) = {np.round(lhs, 12)}  → 基线无偏,可无偏加入优势')
assert np.allclose(lhs, 0.0, atol=1e-9)
print('\n✓ 与手算一致:G_0=2.0, δ_0=1.45,两种更新都抬高 π(a2)')
# reinforce_baseline.py —— 三种 REINFORCE 变体: 学习曲线与方差
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def run(mode, episodes=150, alpha=0.05, seed=0):
    np.random.seed(seed)
    W = np.random.RandomState(seed).randn(4, N) * 0.1
    w_v = np.zeros(N)                          # 价值基线参数
    rewards = []
    for ep in range(episodes):
        traj = []
        s = 0
        while s != N - 1 and len(traj) < 300:
            x = np.zeros(N); x[s] = 1.0
            logits = W @ x
            logits -= logits.max()
            p = np.exp(logits); p = p / p.sum()
            a = int(np.random.choice(4, p=p))
            s2, r = step(s, a)
            traj.append((x, a, r))
            s = s2
        G = 0.0
        for x, a, r in reversed(traj):
            G = r + GAMMA * G
            p, _ = softmax_p(W, x)
            if mode == 'value':
                b = w_v @ x
                # 价值基线更新(简化为: 朝 G 回归)
                w_v += 0.05 * (G - b) * x
            elif mode == 'const':
                b = np.mean([t[2] for t in traj])
            else:
                b = 0.0
            W += alpha * (G - b) * np.outer(np.eye(4)[a] - p, x)
        rewards.append(sum(t[2] for t in traj))
    return rewards

def softmax_p(W, x):
    logits = W @ x
    logits -= logits.max()
    e = np.exp(logits)
    return e / e.sum(), x

for mode, name in [('none', '朴素'), ('const', '常数基线'), ('value', '价值基线')]:
    ret = run(mode, seed=3)
    tail = ret[-200:]
    print(f'{name:<10} 后200回合均值 {np.mean(tail):6.2f}  滑动方差 {np.var(tail):8.2f}')

print()
print('预期: 价值基线的方差最小(曲线最平滑) —— 这就是 AC 的动机')
朴素 后200回合均值 -296.91 滑动方差 738.80
常数基线       后200回合均值 -296.91  滑动方差   738.80
价值基线       后200回合均值   0.81  滑动方差   280.68

预期: 价值基线的方差最小(曲线最平滑) —— 这就是 AC 的动机
10.1 高斯策略精讲:连续动作怎么算出"动作分布"(🟡 关键扩展)¶
本节导读:离散动作用 softmax 输出概率;连续动作用高斯分布: 网络输出均值 μ 和标准差 σ,动作 = 采样。梯度怎么穿过"采样"?靠 重参数化/得分函数——这一节讲清楚。
1. 参数化(背结构): $$\mu_\theta(s),\ \sigma_\theta(s) \;\Rightarrow\; \pi_\theta(a|s) = \mathcal{N}(a; \mu_\theta(s), \sigma_\theta^2(s))$$
- 输出层:μ 用线性/ tanh(动作有界时乘范围);σ 用 softplus(保证 >0)
- 动作:$a \sim \mathcal{N}(\mu,\sigma)$(训练时采样,测试时直接取 μ)
2. 得分函数推导(关键公式):对高斯分布, $$\nabla_\theta \log \pi_\theta(a|s) = \frac{a - \mu_\theta(s)}{\sigma_\theta^2(s)}\,\nabla_\theta \mu_\theta(s) + \Big(\frac{(a-\mu)^2}{\sigma^2} - 1\Big)\frac{\nabla_\theta\sigma_\theta(s)}{\sigma_\theta(s)}$$
- 直觉:动作比均值高($a>\mu$)→ 往上推 μ;探索不足/过多 → 调 σ
- 实现常简化为只对 μ 求梯度、σ 固定或独立学习(方差小的一步)
3. 探索与熵(连续版的 ε):高斯 σ 就是探索量:σ 大 = 爱乱试。 可以给目标加熵正则(SAC 的做法)或让 σ 自动衰减(噪声退火)。
4. 数字例子(本篇 code cell):一维连续目标上,高斯策略从 σ=1 开始, 学习后 μ 移向最优、σ 收窄(如果固定大 σ 则方差大、收敛慢)。
5. 易错点:
- 用 log-prob 计算梯度时不要丢掉 σ 项(很多人只推 μ)
- 测试时不要采样(取 μ 才稳定)——训练采样/测试贪心
6. 面试问法:"连续动作的 PG 怎么写?" → "高斯策略输出 μ、σ; 梯度来自 NLL 对 action 的得分(重参数化或直接 logπ 梯度);σ 管探索。"
# gaussian_policy.py —— 一维高斯策略: 均值学习向最优动作靠拢
import numpy as np

np.random.seed(0)
# 环境: 真实最优动作 a*=2.0, 动作越接近奖励越高(奖励=-(a-2)^2, 用负损失)
theta_mu = 0.0          # 策略均值参数
sigma = 1.0             # 固定标准差
alpha = 0.05
GAMMA = 1.0

print('轮次 | 采样动作 | 概率梯度漂移  (均值应趋近 2.0)')
for t in range(200):
    a = np.random.normal(theta_mu, sigma)
    r = -float((a - 2.0) ** 2) + 0.0
    # ∇logπ(a) = (a - μ)/σ²
    grad = (a - theta_mu) / sigma ** 2
    theta_mu += alpha * r * grad      # 回报加权梯度上升
    if t % 20 == 0:
        print(f'{t:4d} | {a:8.3f} | μ = {theta_mu:7.3f}')

print(f'\n最终策略均值 μ = {theta_mu:.3f} (最优 2.0)')
print('→ 连续策略梯度: 采样 → 奖励加权 → 均值漂移; σ 控制探索')
轮次 | 采样动作 | 概率梯度漂移  (均值应趋近 2.0)
   0 |    1.764 | μ =  -0.005
  20 |   -2.055 | μ =   2.597
  40 |    0.936 | μ =   2.044
  60 |    1.577 | μ =   2.255
  80 |    1.219 | μ =   2.420
 100 |    3.376 | μ =   1.315
 120 |    1.570 | μ =   1.190
 140 |    0.130 | μ =   1.882
 160 |    1.355 | μ =   1.863
 180 |    1.647 | μ =   2.003

最终策略均值 μ = 1.565 (最优 2.0)
→ 连续策略梯度: 采样 → 奖励加权 → 均值漂移; σ 控制探索
11.1 Critic 训练精讲:价值网络自己的"学习循环"(🟡 掌握)¶
本节导读:Actor 用优势;优势来自 Critic。Critic 用TD 目标训练, 但它同时要服务 Actor——这两者的配合节奏(以及 Critic 不准时的后果) 是 AC 实践的核心。
1. Critic 的损失(回归视角): $$L(\phi) = \mathbb{E}\big[\big(\underbrace{r + \gamma V_\phi(s')}_{\text{TD 目标}} - V_\phi(s)\big)^2\big]$$
- 与 DQN 同构:拟合"TD 目标"(自举)
- 收敛后 $V_\phi \to V^{\pi}$(当前 Actor 策略的价值!)
2. Critic 与 Actor 的耦合(关键):
- Actor 每更新一步 → 策略变 → $V^{\pi}$ 变 → Critic 的目标又移动了
- 所以 AC 训练中 Critic 常"追不上"(策略在变);实践中 Critic 更新 频率 ≥ Actor(多步 critic / 目标网络 / GAE 都是缓解)
- 反之 Critic 不准 → 优势噪声大 → Actor 学歪 → 双向耦合是全 AC 类算法(PPO 也不例外)不稳定的根源
3. 为什么用 GAE 生成目标(衔接):直接 TD 单步有偏;整轨迹无偏但 方差大。GAE 的 λ 折中给 Critic 提供"偏差-方差可调"的回归目标, Critic 更稳 → Actor 的 A_t 更准 → 整体提升(下节展开)。
4. 数字观察(本篇 code cell):打印每步 critic loss 与优势分布: 损失不单调(目标在动)、优势集中在 0 附近(成功了就"没惊喜")—— 属正常现象,别误判为故障。
5. 易错点:
- Critic 的标签是动态目标(带 φ),别当成静态回归
- 别把 Critic 训到"完美":策略在变,追太狠浪费算力(GPI 同理)
6. 面试问法:"AC 里 critic 怎么训练?" → "TD 回归:L=(r+γV(s')-V(s))²; 策略变动让目标移动,故 critic 常需更频繁更新/GAE 稳定目标。"
11. AC 中 Critic 的损失与更新细节(🟡 掌握)¶
Critic 训练¶
- Critic 参数 $\phi$,用 TD 目标作为监督: $$L(\phi) = \mathbb{E}\left[\left(r + \gamma V_\phi(s') - V_\phi(s)\right)^2\right]$$
- 注意目标里也有 $V_\phi(s')$ → 同样是半梯度/目标网络问题(小规模表格不受影响,深度版用 target critic)
Actor 用优势更新¶
$$\nabla J = \mathbb{E}\left[\nabla\log\pi_\theta(a|s)\,\delta_t\right], \qquad \delta_t = r + \gamma V(s') - V(s)$$
一句话总结(背)¶
Critic 教 Actor 往哪使劲(优势给了方向),Actor 教 Critic 怎么估(TD 目标)——两个网络互相提供监督,交替优化,这就是 AC。
# ac_details.py —— AC 全面插图: 每步的 Critic TD 更新 + Actor 更新(打印关键量)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def feats(s):
    x = np.zeros(N); x[s] = 1.0
    return x

np.random.seed(9)
W = np.random.RandomState(1).randn(4, N) * 0.1
w = np.zeros(N)

def pi_probs(s):
    logits = W @ feats(s)
    logits -= logits.max()
    e = np.exp(logits)
    return e / e.sum()

print('轮次 |  TD误差δ  |  V(起点)  | Actor 更新幅度(||ΔW||)')
for ep in range(50):
    s = 0
    steps = 0
    while s != N - 1 and steps < 300:
        p = pi_probs(s)
        a = int(np.random.choice(4, p=p))
        s2, r = step(s, a)
        delta = r + GAMMA * (w @ feats(s2)) - (w @ feats(s))
        w += 0.1 * delta * feats(s)
        W_old = W.copy()
        W += 0.05 * delta * np.outer(np.eye(4)[a] - p, feats(s))
        s = s2
        steps += 1
    if ep % 10 == 0:
        print(f'{ep:4d} | {delta:8.3f} | {w @ feats(0):7.3f} | {np.linalg.norm(W - W_old):12.4f}')
print()
print('δ>0: 该动作比预期好 → Actor 加大该动作概率 → 价值基线同步修正')
轮次 |  TD误差δ  |  V(起点)  | Actor 更新幅度(||ΔW||)
   0 |   10.589 |  -1.463 |       0.4432
  10 |    7.338 |  -3.573 |       0.1055
  20 |    5.336 |  -4.559 |       0.0397
  30 |    3.950 |  -4.964 |       0.0186
  40 |    1.860 |  -5.185 |       0.0108

δ>0: 该动作比预期好 → Actor 加大该动作概率 → 价值基线同步修正
GAE:把"n 步优势"的旋钮连续化(🔴 推导 + 直觉)¶
定义(递归形式): $$\hat{A}_t^{\text{GAE}(\gamma,\lambda)} = \delta_t + \gamma\lambda\,\hat{A}_{t+1}, \qquad \delta_t = r_t + \gamma V(s_{t+1}) - V(s_t)$$
展开(unroll 看它到底是什么): $$\hat{A}_t = \delta_t + \gamma\lambda\delta_{t+1} + (\gamma\lambda)^2\delta_{t+2} + \cdots$$
为什么是"n 步优势的连续平均":
- $\lambda=0$:只剩 $\delta_t$(1 步 TD 优势,方差最小、偏差最大)
- $\lambda=1$:所有 $\delta$ 全要,加起来正好等于整条轨迹的蒙特卡洛优势 $R - V(s_t)$(无偏、方差最大)
- $0<\lambda<1$:按 $(\gamma\lambda)^k$ 加权平均所有 n 步优势——一根连续旋钮, 和 02 篇的 n 步回报、TD(λ) 资格迹是同一家族(都叫"多步折中")
三个面试必答点¶
- GAE 与 TD(λ) 的关系:同一个"λ 折中"思想,一个用在价值估计、一个用在优势
- γ 和 λ 各管什么:γ 管"看多远"(discount),λ 管"多少步的真实奖励才可信" ——两者不同!γ 是 MDP 层面的,λ 是估计器层面的
- 实现注意:从后往前递归算(时间反向),一次遍历就出所有 $\hat{A}_t$, 复杂度 O(T)(本篇 §12 代码演示的就是这个递归)
一句话:GAE = 优势版的 TD(λ);λ 是偏差-方差旋钮,PPO/GRPO 里都靠它调。
12. GAE 详解与实现(🔴 PPO 前置)¶
公式¶
$$\hat{A}_t^{GAE(\gamma,\lambda)} = \sum_{k=0}^{T-t} (\gamma\lambda)^k \underbrace{\left( r_{t+k} + \gamma V(s_{t+k+1}) - V(s_{t+k}) \right)}_{\delta_{t+k}}$$
递归实现(背,比求和更常用)¶
A_t = δ_t + (γλ)·A_{t+1} (从尾部往前推)
λ 语义(背)¶
- λ=0 → A_t = δ_t(单步优势):偏差大、方差小
- λ=1 → 全轨迹优势(≈MC):偏差小、方差大
- 0.95 是 PPO 默认
# gae_impl.py —— GAE 手写(递归形式) + 与单步优势对比
import numpy as np

def compute_gae(rewards, values, gamma=0.9, lam=0.95):
    """values[i] = V(s_i); rewards[i] = r_{i+1}; 返回优势 A_t"""
    T = len(rewards)
    A = np.zeros(T)
    adv = 0.0
    for t in reversed(range(T)):
        delta = rewards[t] + gamma * (values[t + 1] if t + 1 < len(values) else 0.0) - values[t]
        adv = delta + gamma * lam * adv
        A[t] = adv
    return A

# 示例轨迹: 前几步小负奖励, 最后一步 +10
rewards = [-1, -1, -1, -1, 10]
values = [1.0, 1.2, 1.5, 1.8, 2.2, 0.0]     # V(s0..s5)

A_gae = compute_gae(rewards, values, 0.9, 0.95)
A_1step = np.array([rewards[t] + 0.9 * values[t + 1] - values[t] for t in range(5)])
A_mc = np.zeros(5)
G = 0.0
for t in reversed(range(5)):
    G = rewards[t] + 0.9 * G
    A_mc[t] = G - values[t]

print(f'{"t":<4}{"GAE(λ=.95)":>12}{"1步TD优势":>12}{"MC优势":>12}')
for t in range(5):
    print(f'{t:<4}{A_gae[t]:>12.3f}{A_1step[t]:>12.3f}{A_mc[t]:>12.3f}')
print()
print('GAE 是 1 步 TD 与 MC 的折中: 后期(接近终局)与 MC 趋同, 早期更平滑')
t     GAE(λ=.95)      1步TD优势        MC优势
0          1.366      -0.920       2.122
1          2.673      -0.850       3.380
2          4.121      -0.880       4.700
3          5.849      -0.820       6.200
4          7.800       7.800       7.800

GAE 是 1 步 TD 与 MC 的折中: 后期(接近终局)与 MC 趋同, 早期更平滑
13.1 A2C 向量化精讲:用多环境并行"去相关"(🟡 并行采样)¶
本节导读:AC 是 on-policy:一批数据用一次。想让样本"更像 i.i.d.", 最直接的办法:开 N 个环境并行采样,每步拿到 N 条近独立轨迹—— 这就是 A3C/A2C 的思路,也是"向量化环境"(VectorEnv)的由来。
1. 为什么并行(问题):单环境连续采样 → 相邻样本强相关(像 DQN 的 回放问题,但 on-policy 不能回放)。多环境同时走 → 同一时刻的 N 个样本 来自 N 条不同轨迹 → 相关性被打散,相当于"免费的批量去相关"。
2. A3C vs A2C(背区别):
- A3C(异步):N 个进程各学各的,参数异步更新(2016 年经典)
- A2C(同步):N 个环境采样、汇总成一个 batch,同步更新 (更简单、GPU 友好、通常更稳)——现代实现默认 A2C
- 本篇 code cell:手写多 env 同步采样 + 平均梯度
3. 收益与代价(数字直觉):
- N=8~16:样本相关性下降 → 梯度方差下降 → 收敛更快
- 代价:内存 ×N、环境同步开销;回报 = 每次更新"更可靠"
- 也可以把多步轨迹放进 buffer(GAE 用),仍然 on-policy(一次用完)
4. 与 DQN 回放的对比(面试辨析):
| DQN 回放 | A2C 并行 | |
|---|---|---|
| 去相关手段 | 历史随机抽样 | 多环境并行 |
| on/off | off-policy | on-policy |
| 数据新鲜度 | 可旧 | 必须新 |
5. 易错点:
- A2C 仍是 on-policy:并行环境不能像回放一样存旧数据反复用
- 同步更新时各环境长度要一致(截断/补齐)
6. 面试问法:"A2C 为什么要多环境?" → "on-policy 不能回放,用 N 个 并行环境打散样本相关性、降梯度方差;A3C 异步、A2C 同步汇总更稳。"
13. A2C 的向量化实现思路(🟡 并行采样)¶
A3C → A2C¶
- A3C:多 worker 异步更新(各自推参数)
- A2C:同步收集多个 worker 的经验、同一批次更新 → 无锁、无异步复杂度,效果相当
向量化 batch¶
workers = envs.vectorized(n)         # n 个环境并行
for step:
    actions = actor_batch(states)     # 一次前向给 n 个动作
    states', rewards, dones = workers.step(actions)
    缓存 (states, actions, rewards, dones) → GAE → 更新 actor/critic
为什么并行(背)¶
多个环境并行采样 → 同一时刻数据去相关 + 算力利用率高 → 训练更快更稳。这是 A2C/A3C 相对单环境 AC 的核心提升。
14. 面试追问速答扩展(🔴)¶
- Q: PG 为什么能处理连续动作? A: 策略输出分布参数(高斯 μ,σ),动作直接采样,无需 max。
- Q: 基线有什么要求? A: 与动作无关(只依赖状态)→ 无偏;最常用 V(s) 或平均奖励。
- Q: AC 价值网络怎么防过拟合? A: 小学习率、早停、目标 critic(深度版)。
- Q: REINFORCE 什么时候用? A: 简单任务/教学/当 Critic 学不稳时作 baseline。
- Q: GAE 与 n 步 TD 的关系? A: GAE 是"无穷多 n 步回报按 (γλ)^k 加权求和",比单 n 步更平滑。
- Q: A3C 为什么比 AC 快? A: 并行采样去相关 + 吞吐提升;A2C 同步版更简洁。
- Q: log π 为什么重要? A: 梯度估计里 log 把"乘除概率"变"加减",方差更小、便于老数据复用。
- Q: 确定性策略梯度(DDPG)和本节的随机 PG 区别? A: 随机 PG 采样估计;DPG 直接对 μ(s) 求梯度(07 篇)。
15. 自测清单(05 篇收官)¶
- L1:默写策略梯度定理四步推导与 log 技巧
- L1:画 AC 结构图并说明 Actor/Critic 互相提供什么
- L1:写出 GAE 公式与递归实现
- L2:手写高斯策略并跑通均值漂移实验
- L2:对比三种基线的方差(实验口头结论)
- L3:能把"REINFORCE→AC→GAE→PPO"串成演进故事
16. PG/AC 公式总表(🔴 考前速背)¶
| 方法 | 核心 |
|---|---|
| 策略梯度定理 | $\nabla J=\mathbb{E}[\sum_t\nabla\log\pi(a_t\mid s_t)G_t]$ |
| REINFORCE | $\theta\leftarrow\theta+\alpha\gamma^t G_t\nabla\log\pi$ |
| 基线 | $b(s)$ 与动作无关 → 无偏;$A=G-b$ |
| AC 优势 | $\delta_t=r+\gamma V(s_{t+1})-V(s_t)$ |
| GAE | $\hat A_t=\sum_{k}(\gamma\lambda)^k\delta_{t+k}$ |
| 高斯策略 | $\pi(a\mid s)=\mathcal{N}(\mu_\theta(s),\sigma^2)$ |
| A2C | 多环境并行 + 同步更新 |
17. 面试表达模板:PG 为什么重要(🔴 30 秒版)¶
"价值方法学 Q 再取 argmax,动作空间必须可枚举;策略梯度直接参数化策略,连续动作(高斯输出)和随机策略(博弈必需)都能处理。代价是梯度估计方差大——用基线/优势函数(AC)和多步估计(GAE)压方差,用 clip(PPO)控步长,就成了工业标准 PPO。"
18. 易错点清单(🔴 PG/AC 篇)¶
- ∇logπ 别漏乘特征/动作差:离散用 onehot(a)-p;连续用 (a-μ)/σ²
- 基线必须与动作无关:用 V(s) 合法;用 Q(s,a) 当基线就错了(无偏性破坏)
- AC 两个网络学习率别一样:Critic 常小一点(价值网络易过拟合)
- GAE 的 λ 是 γλ 一起乘:λ=0.95 但 γ=0.99 时衰减因子是 0.94,别只记一个数
- REINFORCE 用整回合回报:中途终止的轨迹要正确处理"剩余价值为 0"
- 策略梯度是"梯度上升":实现时常写 loss=-E[logπ·A] 再下降,别方向搞反
19. 考前 3 分钟速背(🔴 PG/AC 篇)¶
定理: ∇J = E[Σ∇logπ·G]   (log技巧 + P 消失)
REINFORCE: 整回合 + 方差大
基线: 与动作无关即可无偏; 用 V(s) 得优势
AC: Actor(策略) + Critic(价值) + δ 连接
GAE: A = Σ(γλ)^k·δ  (λ 折中)
高斯策略: 输出 μ,σ → 连续动作
A2C: 多环境并行 + 同步更新
20. 常见追问组合演练(🔴 面试对练)¶
- A: "策略梯度和价值方法的本质区别?" → 学策略 vs 学价值取argmax;连续/随机
- B: "为什么 PG 能用老数据?" → importance sampling(PPO 的 ratio 就是它)
- C: "AC 两个网络怎么训练?" → Critic 最小化 TD 误差平方;Actor 最大化优势加权 logπ
- D: "GAE λ=1 是什么?" → MC 近似(无偏方差大);λ=0 是单步 AC
# pg_variance_study.py —— 方差来源分解: 轨迹长度 vs 方差
import numpy as np

np.random.seed(0)
# 模拟: 回报 G 的方差随轨迹长度(T)增长(独立同分布奖励)
for T in [1, 5, 20, 50]:
    Gs = [sum(np.random.normal(-1, 1, T)) for _ in range(2000)]
    print(f'T={T:3d}: E[G]={np.mean(Gs):7.2f}  Var[G]={np.var(Gs):8.2f}')

print()
print('→ 整回合回报 G 的方差 ∝ T(步数)→ REINFORCE 方差大的根源')
print('→ 单步 δ 方差不随 T 涨(只用一步转移) → TD/AC 的动机')
T=  1: E[G]=  -1.02  Var[G]=    0.96
T=  5: E[G]=  -5.08  Var[G]=    4.96
T= 20: E[G]= -19.99  Var[G]=   20.19
T= 50: E[G]= -49.56  Var[G]=   47.69

→ 整回合回报 G 的方差 ∝ T(步数)→ REINFORCE 方差大的根源
→ 单步 δ 方差不随 T 涨(只用一步转移) → TD/AC 的动机
21. 项目脑暴:策略梯度在推荐/对话上的玩具(🟢 方向)¶
对话 RL: 状态=已生成对话 || 动作=下一句 || 奖励=用户点赞/人工分
玩具实现: 词表 100 + 线性 softmax 策略 + REINFORCE 基线
评估: 平均奖励曲线 + 生成多样性(熵)
与 LLM 对齐衔接: 把"词表"放大 -> RLHF(06 篇)
目标:让"RL 应用于序列生成"不是嘴上说说,而是你代码跑过。
22. 易错自查(🔴 上机前)¶
- 梯度方向没错(上升 vs loss 下降)
- 基线只依赖状态
- GAE 从尾部递归、方向对
- 高斯策略 σ 别学成 0(熵崩)
- 多 seed 报告,不挑最好看的那个 seed
策略梯度 ↔ LLM 生成:一张对应表(🔴 衔接 06 篇)¶
LLM 生成一个回答 = 策略 $\pi_\theta$ 采一条"动作序列"(每个 token 是一个动作)。 把 RL 术语逐个翻译过去:
| RL 概念 | LLM 翻译 |
|---|---|
| 状态 $s_t$ | 已生成的上下文(prompt + 已输出 token) |
| 动作 $a_t$ | 下一个 token |
| 策略 $\pi_\theta(a_t\|s_t)$ | LM 的 next-token 分布(softmax 输出) |
| 轨迹 $\tau$ | 完整回答 |
| 奖励 $r$ | 奖励模型/人工打分(KL 惩罚后) |
| $\nabla\log\pi_\theta(a_t\|s_t)$ | 交叉熵损失对 logits 的梯度(完全同一个式子) |
为什么 SFT 不够、要 PG 再调(面试核心):
- SFT = 行为克隆(12 篇 BC):只学"人怎么写",学不到"什么回答更被偏好"
- RLHF = 用偏好信号(奖励模型)跑策略梯度:直接优化"被喜欢"的概率
- 这就是从 04-LLM 篇的 SFT 到 21-PPO/GRPO 手推的衔接逻辑
一句话:"LLM 生成 = 高维连续动作空间的策略采样;RLHF 就是在这个空间跑 PG。" (GRPO 组内优势正是 PG 的"基线换批内相对"变体,06 篇展开。)
23. 策略梯度在 LLM 里的"变装"(🔴 衔接 06 篇)¶
LLM 生成的策略视角¶
$$\pi_\theta(a_t|s_t) \to \pi_\theta(y_t | x, y_{<t}), \qquad s_t = (x, y_{<t})$$
- 动作 = 下一个 token;状态 = 已生成前缀
- REINFORCE 目标:$\nabla J = \mathbb{E}[\sum_t \nabla\log\pi(y_t|y_{<t})\, G_t]$
- 但 $G_t$ 只在句末有奖励(RM 打分)→ 稀疏 → GAE 回传 + KL 约束 → PPO/GRPO
面试金句:"LLM 对齐 = 把 RL 的 (s,a,r) 翻译成 (前缀, token, 偏好分),再用 AC 技术放大——这是我从 RL 到 LLM 的知识迁移"。这句话能让你在两个岗位之间横跳。
# llm_rl_mapping.py —— RL ↔ LLM 术语对照表(打一遍加深记忆)
mapping = {
    '状态 s': '已生成 token 序列 (x, y_<t)',
    '动作 a': '下一个 token y_t',
    '策略 π(a|s)': '语言模型 token 概率分布',
    '奖励 r': '奖励模型打分 / 规则(正确性) / 偏好',
    '回合': '一次完整生成(到 EOS/截断)',
    '折扣 γ': '多为 1(整句统一奖励)',
    '基线/优势': 'GAE / 组内标准化(GRPO)',
    '熵正则': '保持生成多样性',
    'KL 约束': '防偏离 SFT(防 hack)',
}
print('RL ↔ LLM 术语映射:')
for k, v in mapping.items():
    print(f'  {k:<14} → {v}')
RL ↔ LLM 术语映射:
  状态 s           → 已生成 token 序列 (x, y_<t)
  动作 a           → 下一个 token y_t
  策略 π(a|s)      → 语言模型 token 概率分布
  奖励 r           → 奖励模型打分 / 规则(正确性) / 偏好
  回合             → 一次完整生成(到 EOS/截断)
  折扣 γ           → 多为 1(整句统一奖励)
  基线/优势          → GAE / 组内标准化(GRPO)
  熵正则            → 保持生成多样性
  KL 约束          → 防偏离 SFT(防 hack)
24. 常见坑:策略梯度实现(🔴 上机前对照)¶
- log_p 计算:
log_softmax(logits)[a]而不是prob[a](梯度不同!) - 回报回推:从尾部
G = r + γ·G,别顺序推 - 目标符号:写
loss = -mean(log_p * A)再minimize(别写成 +) - 归一化优势:
A = (A - A.mean()) / (A.std() + eps)大幅稳定 - 熵项:
+ c·entropy防坍缩(PPO 标配)
这五条对应 90% 的"为什么我的 PG 不收敛"。
# pg_pitfalls.py —— 目标符号与 log 技巧的数值检查
import numpy as np

logits = np.array([1.0, 2.0, 0.5])

def log_softmax(z):
    z = z - z.max()
    return z - np.log(np.exp(z).sum())

def softmax(z):
    e = np.exp(z - z.max())
    return e / e.sum()

p = softmax(logits)
# 正确: 用 log 概率
log_p = log_softmax(logits)
print('log_softmax =', np.round(log_p, 3))
print('log(softmax) 是否一致:', np.allclose(log_p, np.log(p)))
print()
# 梯度: d/da log_p(a) = 1 - p[a] (对 a=argmax 时为正)
for a in range(3):
    print(f'动作{a}: ∇log_p = {1 - p[a]:.3f}  (权重方向)')
print('→ 优势为正时梯度上升该动作概率; 实现时别把 log 写成 p 本身')
log_softmax = [-1.464 -0.464 -1.964]
log(softmax) 是否一致: True

动作0: ∇log_p = 0.769  (权重方向)
动作1: ∇log_p = 0.371  (权重方向)
动作2: ∇log_p = 0.860  (权重方向)
→ 优势为正时梯度上升该动作概率; 实现时别把 log 写成 p 本身
25. 章末寄语(🟢)¶
策略梯度是"学动作分布",AC 是它的方差救星,GAE 是它的精度旋钮。下一章 PPO 给它装上"安全阀"(clip),并延伸到 LLM 对齐。
26. 策略方法发展脉络(🟢 时间线)¶
1992  REINFORCE(Williams)   ← 开山
2000  PAC 分析(PG)
2016  A3C / TRPO           ← 并行+单调约束
2017  PPO / ACER           ← 工程定型
2018  SAC (最大熵)          ← 连续 SOTA
2020+  LLM 对齐(PG→RLHF)   ← 新大陆
记忆锚点:REINFORCE→AC→GAE→PPO 是你简历上的演进主链。
# pg_timeline.py —— PG 家族时间线打印
events = [
    ('1992', 'REINFORCE', '蒙特卡洛策略梯度'),
    ('2015', 'TRPO', 'KL 约束单调改进'),
    ('2016', 'A3C/A2C', '并行 + 优势函数'),
    ('2017', 'PPO', 'clip 代理目标'),
    ('2018', 'SAC', '最大熵 + 随机策略'),
    ('2022+', 'RLHF/GRPO', 'LLM 对齐'),
]
for y, n, d in events:
    print(f'{y}  {n:<12} {d}')
1992  REINFORCE    蒙特卡洛策略梯度
2015  TRPO         KL 约束单调改进
2016  A3C/A2C      并行 + 优势函数
2017  PPO          clip 代理目标
2018  SAC          最大熵 + 随机策略
2022+  RLHF/GRPO    LLM 对齐
27. 面试对比三板斧(🔴 策略方法篇)¶
- PG vs 价值:直接学策略 vs 先学价值;连续/随机 vs 离散/贪心
- REINFORCE vs AC:整回合 vs 每步;高方差 vs 低方差
- PPO vs TRPO:clip 惩罚 vs KL 硬约束;简单 vs 复杂
每个对比一句公式 + 一句 trade-off——这是 RL 面试的通用节奏。
# compare_riff.py —— 对比答题模板打印(复读演练)
def riff(a, b, formula_a, formula_b, tradeoff):
    print(f'{a} vs {b}:')
    print(f'  {a}: {formula_a}')
    print(f'  {b}: {formula_b}')
    print(f'  权衡: {tradeoff}')
    print()

riff('REINFORCE', 'AC',
     '整回合回报 G', '单步 TD 优势 δ',
     'REINFORCE 简单但方差大;AC 用价值降方差、可在线')
riff('PPO', 'TRPO',
     'min(rA, clip(r,1±ε)A)', 'KL 约束 + 共轭梯度',
     'PPO 简单稳定工程默认;TRPO 理论上限高但难实现')
riff('PG', '价值方法',
     '学习 π(a|s)', '学习 Q(s,a)',
     'PG 支持连续/随机;价值方法样本效率高、离散友好')
REINFORCE vs AC:
  REINFORCE: 整回合回报 G
  AC: 单步 TD 优势 δ
  权衡: REINFORCE 简单但方差大;AC 用价值降方差、可在线

PPO vs TRPO:
  PPO: min(rA, clip(r,1±ε)A)
  TRPO: KL 约束 + 共轭梯度
  权衡: PPO 简单稳定工程默认;TRPO 理论上限高但难实现

PG vs 价值方法:
  PG: 学习 π(a|s)
  价值方法: 学习 Q(s,a)
  权衡: PG 支持连续/随机;价值方法样本效率高、离散友好
28. 章末寄语(🟢)¶
策略方法篇收官。核心资产:定理一句话 + 基线无偏性 + GAE 递归 + 一张对比表。
29. 数字敏感度速查(🔴 PG/AC 篇终版)¶
| 参数 | 典型值 | 说明 |
|---|---|---|
| α(actor) | 3e-4 | 常小于 critic |
| α(critic) | 1e-3 | 价值网络可稍大 |
| GAE λ | 0.95 | 0.9~0.99 |
| 熵系数 | 0.01 | 大=探索多 |
| batch | 2048(PPO) | 与 rollout 长度匹配 |
| 高斯 σ | 0.1~0.3 | 太大探索过强 |
30. 章末终版寄语(🟢)¶
从 REINFORCE 到 AC 再到 GAE,策略方法解决的全是"怎么把梯度估计准"。下一章 PPO 给策略梯度装"安全阀",并开启 LLM 对齐大门。
31. 面试模拟:如果只问三个问题(🔴 保底准备)¶
- "讲一下你做过的一个 RL 项目" → STAR + 一张学习曲线图
- "PPO 和 DPO 怎么选" → 在线/离线 + 资源/质量 trade-off
- "如果奖励不收敛怎么办" → 奖励尺度 → lr → 回放/目标 → 多 seed
三个问题答好 = 80 分打底。每个都练成 60 秒标准答案。
32. 模块衔接(🔴)¶
PG 的方差问题、步长问题在 06 篇由 PPO(clip)统一解决;GRPO 再把它适配到 LLM 对齐。05→06 是"从理论到工程"的最后一跳。
29. 策略方法变种谱系(🔴 REINFORCE → AC → A2C → GAE → PPO)¶
演进推导链(背)¶
REINFORCE:   θ += α·G·∇logπ(a|s)           整回合, 方差大
+基线:       θ += α·(G - b)·∇logπ          ↓ 方差(无偏)
AC:          θ += α·δ_t·∇logπ, δ=r+γV(s')-V(s)  每步, 用价值当基线
A2C/A3C:     多环境并行 → 去相关 + 高吞吐
GAE:         A_t = Σ_k (γλ)^k δ_{t+k}      偏差-方差旋钮
PPO:         min(rA, clip(r,1±ε)A)         步长安全阀(06 篇)
为什么基线有效(推导一句话,背)¶
基线 $b(s)$ 只依赖状态:$\mathbb{E}_{a\sim\pi}[\nabla\log\pi(a|s)\cdot b(s)] = b(s)\cdot\nabla\underbrace{\mathbb{E}[\nabla\log\pi]}_{=0} = 0$ (见 05 篇 §8 数值验证)→ 减基线不改变期望、只降方差。
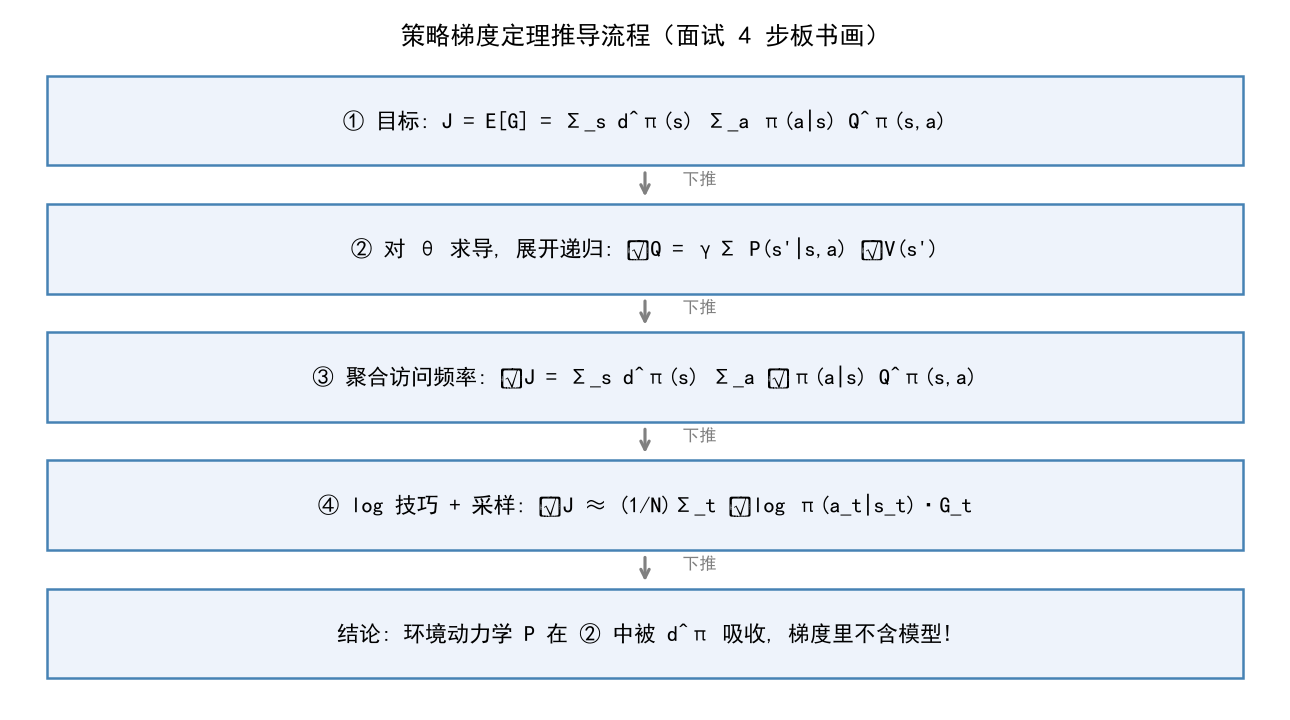
30. 策略梯度定理四步推导(🔴 面试手推主菜)¶
出发¶
$$J(\theta)=\mathbb{E}_{s_0}\left[V^{\pi_\theta}(s_0)\right], \qquad V^{\pi} = \mathbb{E}\left[\sum_t \gamma^t R_t\right]$$
四步推导(背)¶
① 对动作展开:
   ∇θ V^π(s) = Σ_a [ ∇π(a|s)·Q^π(s,a) + π(a|s)·∇Q^π(s,a) ]
   (第一项=策略直接贡献, 第二项=价值递归, 留待消)

② 再展开 ∇Q^π(s,a) = ∇[ R(s,a) + γΣ_s'P(s'|s,a)V^π(s') ]
   = γΣ_s'P(s'|s,a)·∇V^π(s')
   → 得到"沿状态路径的递归展开"

③ 把递归展开成无穷级数, 按访问频率聚合(稳态分布 d^π):
   ∇J = Σ_s d^π(s) Σ_a ∇π(a|s) Q^π(s,a)

④ log 技巧 ∇π = π·∇logπ, 用采样估计:
   ∇J = E[ ∇logπ(a|s)·Q^π(s,a) ] ≈ (1/N)Σ_t ∇logπ(a_t|s_t)·G_t   ∎
关键记忆:环境动力学 $P$ 只出现在第 ② 的展开系数里,被 $d^\pi$ 吸收后不再进入梯度——这就是"策略梯度无需模型"的根源。
# fig_pg_flow.py —— 过程图①: 策略梯度定理推导流程(文本图)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(8.6, 4.8), dpi=150)
ax.axis('off')
boxes = [
    (0.5, 0.90, "① 目标: J = E[G] = Σ_s d^π(s) Σ_a π(a|s) Q^π(s,a)"),
    (0.5, 0.70, "② 对 θ 求导, 展开递归: ∇Q = γΣ P(s'|s,a) ∇V(s')"),
    (0.5, 0.50, "③ 聚合访问频率: ∇J = Σ_s d^π(s) Σ_a ∇π(a|s) Q^π(s,a)"),
    (0.5, 0.30, "④ log 技巧 + 采样: ∇J ≈ (1/N)Σ_t ∇log π(a_t|s_t)·G_t"),
    (0.5, 0.10, "结论: 环境动力学 P 在 ② 中被 d^π 吸收, 梯度里不含模型!"),
]
for x, y, txt in boxes:
    ax.add_patch(plt.Rectangle((x-0.48, y-0.07), 0.96, 0.14, fc='#eef3fb',
                               ec='steelblue', lw=1.2, zorder=2))
    ax.text(x, y, txt, ha='center', va='center', fontsize=10.5, zorder=3)
for i in range(len(boxes)-1):
    ax.annotate('', xy=(0.5, boxes[i+1][1]+0.075), xytext=(0.5, boxes[i][1]-0.075),
                arrowprops=dict(arrowstyle='->', color='gray', lw=1.5))
    ax.text(0.53, (boxes[i][1]+boxes[i+1][1])/2, '下推', fontsize=8, color='gray')
ax.set_title('策略梯度定理推导流程(面试 4 步板书画)', fontsize=12)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'pg_flow.png'), dpi=150)
print('已保存 images/pg_flow.png')
plt.close(fig)
plt.show()
已保存 images/pg_flow.png
C:\Users\24260\AppData\Local\Temp\ipykernel_45588\3839742983.py:28: UserWarning: Glyph 8711 (\N{NABLA}) missing from font(s) SimHei.
  plt.tight_layout()
C:\Users\24260\AppData\Local\Temp\ipykernel_45588\3839742983.py:33: UserWarning: Glyph 8711 (\N{NABLA}) missing from font(s) SimHei.
  fig.savefig(os.path.join(out, 'pg_flow.png'), dpi=150)
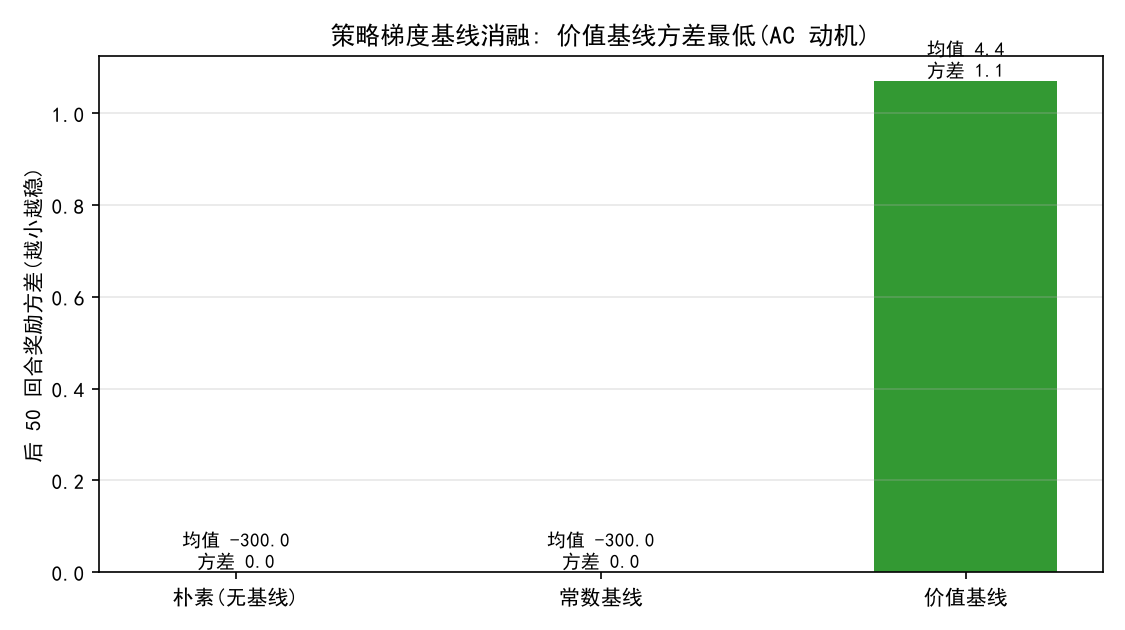
# fig_pg_baseline.py —— 过程图②: 三种基线方差对比(网格, 短训练)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_b(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_b(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def run(mode, episodes=100, alpha=0.05, seed=0):
    np.random.seed(seed)
    W = np.random.RandomState(seed).randn(4, N) * 0.1
    w_v = np.zeros(N)
    returns = []
    for _ in range(episodes):
        traj = []
        s = 0
        while s != N - 1 and len(traj) < 300:
            x = np.zeros(N); x[s] = 1.0
            logits = W @ x
            logits -= logits.max()
            p = np.exp(logits); p = p / p.sum()
            a = int(np.random.choice(4, p=p))
            s2, r = step(s, a)
            traj.append((x, a, r))
            s = s2
        G = 0.0
        for x, a, r in reversed(traj):
            G = r + GAMMA * G
            p = np.exp(W @ x)
            p = p / p.sum()
            if mode == 'value':
                b = w_v @ x
                w_v += 0.05 * (G - b) * x
            elif mode == 'const':
                b = np.mean([t[2] for t in traj])
            else:
                b = 0.0
            W += alpha * (G - b) * np.outer(np.eye(4)[a] - p, x)
        returns.append(sum(t[2] for t in traj))
    return np.array(returns)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
names = ['朴素(无基线)', '常数基线', '价值基线']
colors = ['gray', 'orange', 'green']
for name, mode, c in zip(names, ['none', 'const', 'value'], colors):
    ret = run(mode, seed=3)
    # 汇报: 后50回合均值 + 方差
    m, v = ret[-50:].mean(), ret[-50:].var()
    ax.bar(name, v, color=c, alpha=0.8, width=0.5)
    ax.text(name, v, f'均值 {m:.1f}\n方差 {v:.1f}', ha='center', va='bottom', fontsize=9)
ax.set_ylabel('后 50 回合奖励方差(越小越稳)')
ax.set_title('策略梯度基线消融: 价值基线方差最低(AC 动机)')
ax.grid(alpha=0.3, axis='y')
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'pg_baseline_var.png'), dpi=150)
print('已保存 images/pg_baseline_var.png')
plt.close(fig)
plt.show()
已保存 images/pg_baseline_var.png