📚 10-00 · 文本表示与 TF-IDF
目标:把「一段文字」变成「一组可计算的数字」。学完本篇你能—— ① 手写正向/反向最大匹配分词并处理歧义;② 手写词袋(BOW)与 TF-IDF,且与 sklearn 逐位对照一致; ③ 手写余弦相似度完成 Top-K 检索并用 TruncatedSVD 可视化;④ 讲清 idf 平滑公式的来历与稀疏高维的数字直觉。
📍 主线位置:前一篇《00 之前的数学/编程与机器学习基础》→ 本篇《文本表示与 TF-IDF》→ 后一篇《01 n-gram 与统计语言模型》(从"词向量"走向"句子的概率")。 本篇是 NLP 的"地基":后面 02 词向量、03 RNN、04 Transformer、05 预训练模型,全都建立在「文本如何变成张量」之上。
🧩 生活化类比:词袋 = 把一段话拆成单词再数出现次数,像给文章做「词频指纹」; TF-IDF 更进一步:词频高 + 稀有的词才是这篇文章的特色词("深度学习"比"我们"更能代表这篇文章)。
核心概念
(a) 🗂️ 从「文字」到「数字」:文本表示与 TF-IDF
本篇解决 NLP 的第一性问题——怎么把一段中文文字变成计算机能计算的向量。沿着「分词 → 词袋 → TF-IDF → 余弦相似度 → 检索」这条主线走一遍,你就掌握了信息检索(搜索引擎)的经典地基。
flowchart TB
    Node1["📝 文本预处理:分词 + 规范化"]
    Node2["📦 词袋 BOW"]
    Node3["⚖️ TF-IDF 加权"]
    Node4["📐 余弦相似度"]
    Node5["🔍 Top-K 检索"]
    Node6["📉 TruncatedSVD 可视化"]
    Node7["🧭 BM25 前瞻"]
    Node1 --> Node2
    Node2 -->|三大缺陷| Node3
    Node3 --> Node4
    Node4 --> Node5
    Node5 --> Node6
    Node3 -->|工程改良| Node7
- 文本预处理(分词 + 规范化):中文没有空格边界,先把字符串切成「词」再降噪(小写、去标点、全半角统一、去停用词)。分词有歧义、未登录词(OOV)两大难点,本篇用「正向 + 反向最大匹配」双向消歧。
- 词袋 BOW:把一篇文档变成「每个词出现几次」的计数向量,每个词占一维。它简单直观,但三大缺陷——丢语序(猫追狗=狗追猫)、稀疏高维、无语义(汽车≠车辆)——逼出了 TF-IDF。
- TF-IDF 加权:词频 tf 管「在本文出现得多不多」,逆文档频率 idf 管「能不能区分文档」。两者相乘,让每篇都有的「我们」权重暴跌、文档特有的词权重飙升;idf 还有平滑版本防除零。
- 余弦相似度:把文档向量看成一个「方向」,用夹角余弦衡量两篇文档有多像,只关心方向不关心长度,所以要先做 L2 归一化。
- Top-K 检索:把查询文本走同样的「分词 → TF-IDF」管线变成向量,跟语料里每篇文档算余弦相似度,取分数最高的 K 篇就是检索结果。
- TruncatedSVD 可视化:V 维向量太高没法画,用截断 SVD 把向量降到二维,文档聚类(相关文档聚在一起)一眼可见,也验证了「共现≈语义」的直觉。
- BM25 前瞻:TF-IDF 的工程改良版——tf 部分做饱和处理、加长度归一化,检索排序普遍更好。记住一句话:TF-IDF 是基础,BM25 是嫡系改良。
0. 主线地图
TEXT → ①分词 → ②规范化 → ③词袋BOW → ④TF-IDF → ⑤余弦相似度 → ⑥Top-K检索/SVD可视化 → ⑦BM25前瞻
| 阶段 | 解决什么问题 | 产物 | 复杂度 | |------|--------------|------|--------| | ① 分词(最大匹配) | 中文没有空格边界 | 词序列 | O(L·|S|) | | ② 规范化 | 大小写/全半角/标点/停用词噪声 | 干净词序列 | O(|S|) | | ③ 词袋 BOW | 变长文本 → 定长向量 | V 维稀疏计数向量 | 存储 O(N·V) | | ④ TF-IDF | 词频高 ≠ 重要,惩罚常见词 | 加权稀疏向量 | O(N·V) | | ⑤ 余弦相似度 | 长度无关的相似度量 | 标量分数 | O(V) | | ⑥ 检索 + SVD | 找最相似文档 / 降维可视化 | Top-K / 2D 散点 | O(N·V) | | ⑦ BM25 前瞻 | TF-IDF 的三个工程缺陷 | 下一篇起点 | — |
本篇路线:先造词(分词 + 规范化)→ 再表示(BOW → TF-IDF)→ 再用(相似度 + 检索 + 可视化)→ 最后反思(局限 + 演进)。
0.1 历史背景:从"词频崇拜"到 TF-IDF
在 TF-IDF 出现之前,主流信息检索(IR)是布尔模型:用户输入 深度学习 AND 模型,系统只回答"命中 / 未命中",既不能给文档排序,也无法回答"哪一篇更相关"。第一个改良思路顺理成章——按词频排序:出现次数越多的词,越能代表这篇文章。
这个直觉很快撞上自然语言的一条"铁律"——Zipf 定律:把语料里的词按频次从高到低排名,排名第 r 位的词,其频次约正比于 1/r^α(α 接近 1)。换句话说,词频服从极端的"长尾分布":极少数词(的、了、是、我们……)霸占绝大多数出现次数,绝大多数词只出现一两次。后果是灾难性的:用纯词频代表文档,每篇文档"最重要"的词几乎都是每篇都有的虚词——排序彻底失去判别力。
TF-IDF 正是为解决这一困境而生:tf(词频)回答"在本文档里重要吗",idf(逆文档频率)回答"在整个语料里稀有吗"。一个词只有同时"在本文出现得多、在语料中又稀有",才配得上高权重。这一小步,让检索从"布尔命中"进化成"相关性打分",也为后来的 BM25、Elasticsearch 排序乃至向量检索埋下了种子——"如何给词称重",正是文本表示一切后续工作的起点。
1. 文本预处理管线:为什么先"造词"
计算机不认识中文,只认识数字。任何 NLP 任务(分类、检索、生成)的第一步都是: 把字符串切成一串"词",再把词变成数字。这条管线(pipeline)是后面所有实验的地基:
- 分词(tokenization):中文按词切分,英文按空格/子词切分
- 规范化(normalization):小写、去标点、统一全半角、去除 HTML 标签等噪声
- 去停用词(stopword removal):的/了/是/and/the——高频但无信息量
- 可选:词形还原(stemming/lemmatization,英文,如 running→run)
💡 为什么顺序不能乱?先分词得到"词",规范化才能作用在词/字符上; 若先规范化再分词,"ABC"这种全角输入要先转半角才能被正确切分。
1.1 分词:任务定义与三大难点
英文天然以空格为界;中文没有词边界,这是分词存在的根本原因。
- 难点一:歧义切分。"研究生命科学"可以是「研究/生命/科学」,也可能被切成「研究生/命/科学」——后者语义全错。
- 难点二:未登录词(OOV)。词典里没有的新词("祖安人""云计算"),只能退化为单字。
- 难点三:规范切分 vs 语义切分。"南京市长江大桥"到底是「南京市/长江大桥」还是「南京/市长/江大桥」?人和机器都会犯错。
经典算法谱系:最大匹配(贪心)→ 双向最大匹配(消歧)→ HMM/CRF(统计)→ 预训练分词器(BERT 类)。 本篇手写最大匹配系列(按要求不引入 jieba 依赖),重点体会"贪心 + 局部最优"的直觉。
正向最大匹配算法(每一步都取"当前能匹配到的最长词",匹配不到就按单字输出):
$$\text{算法}:\quad i \leftarrow 0;\quad \text{while}\ i < |s|:\ \text{找最长}\ L\ \text{使}\ s[i:i+L] \in \text{DICT}$$
复杂度:每步最多试探 max_len 次词典查询(Python set 平均 O(1)),整句 O(|S|·max_len),空间 O(|DICT|)。
1.2 双向最大匹配:用"反向"消除歧义
正向最大匹配是贪心:永远先吃最长的开头词。但最长开头词未必是最优切分—— "研究生命科学"里正向优先选了「研究生」,结果把"生命"拆成「命」。怎么办? 反向最大匹配从右往左同样贪心:优先吃最长的结尾词。
- 正向:研究生命科学 → 研究生/命/科学(错,3 个词,其中"命"是单字碎片)
- 反向:研究生命科学 → 研究/生命科学(对,2 个词,无单字碎片)
双向最大匹配(BiMM):分别跑正向与反向,按两条启发式选择:
- 词数更少者胜(本例反向 2 词 < 正向 3 词);
- 词数相同则选单字散落更少者(更少被切成孤零零的单字,说明切分更完整)。
直觉:反向匹配天然照顾"以常见后缀结尾"的正确切分(生命科学是词典词), 而正向被"研究生"这种更长的开头词带偏——两条贪心路线互相纠偏,这就是"双向"的价值。
1.3 文本规范化:降噪四件套
现实文本充满噪声,不规范化会让"同一个词"被当成"不同词",直接膨胀词表 V、加剧稀疏:
- 小写:NLP ≠ nlp,但通常应视为同一词;
- 去标点:",。!?" 对词频统计没有信息量;
- 全半角统一:全角"ABC123"(U+FF21 起)与半角"ABC123"字形相同但码点不同,不转换会制造重复维度;
- 去停用词:的/了/是/the/a 出现频率极高但几乎不携带语义,留在向量里只会稀释真正有判别力的词。
正则表达式是主力工具:[^\w\u4e00-\u9fa5]+ 一类模式负责"保留中文与字母数字、其余全部替换为空格";
全半角转换的原理是全角 ASCII 码点减去 0xFEE0(U+FF01–U+FF5E → U+0021–U+007E),全角空格 U+3000 → 半角空格。
1.4 本节小结与局限
- 复杂度:正向/反向最大匹配都是 O(|S|·max_len)(set 查询平均 O(1)),双向只是跑两遍,常数 2 倍;
- 局限:最大匹配是纯规则贪心——歧义只能缓解不能根除,OOV 只能退化为单字,且完全无法感知语义。 工业界用 jieba(最大匹配 + HMM 未登录词识别 + 词频动态调节)或预训练分词器(BERT WordPiece); 本篇按要求不引入 jieba 依赖,手写版反而更能暴露歧义/未登录词的本质。
面试被问"为什么不用 jieba"可答:手写最大匹配版能讲透歧义与 OOV 原理;生产环境再换成 jieba/分词器。
- 下一节:分词得到词后,如何把整篇文档变成一个定长向量?→ 词袋模型。
2. 词袋模型(Bag of Words):把文档变成向量
2.1 直觉:从 One-hot 到计数
最简单的表示是 One-hot:每个词一维,文档里出现哪个词就把哪一维置 1。 问题:一篇文档有几十个词,One-hot 只能回答"某个词在不在",丢掉了出现次数,也没有"整篇文档一个向量"的概念。
词袋(BOW) 把一篇文档表示成 V 维向量(V = 词表大小),第 i 维 = 第 i 个词在这篇文档里出现的次数:
$$\text{BOW}(d)_i = c(w_i, d), \qquad i = 1, \dots, V$$
数学上:文档 → 计数向量。三个关键性质:
- 维度 = V:中文语料词表轻易上万 → 高维;
- 极稀疏:一篇文档只覆盖几百词 → 绝大多数维度为 0;
- 丢语序:只数次数,不管先后——"猫追狗"与"狗追猫"得到完全相同的向量。
| 表示 | 维度 | 信息 |
|---|---|---|
| One-hot | V | 只有词身份 |
| BOW 计数 | V | 词频 |
| TF-IDF | V | 词频 × 稀有度 |
| 词向量(02 篇) | d ≪ V | 语义相似度 |
2.1 图解词袋:一个词一维、计数即值
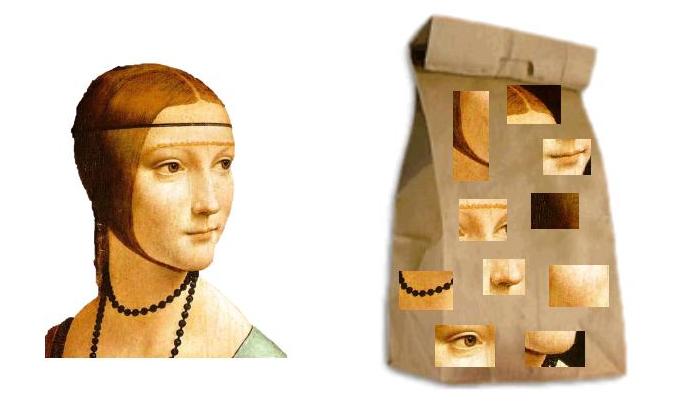
图 1:词袋模型(Bag-of-Words)示意——文档被切词后按词表统计出现次数,得到高维稀疏计数向量。(来源:Wikimedia Commons,公有领域)
这张图把词袋的全部要点压缩成一幅画:左侧是原始文本,中间是切分后的词序列,右侧是"词 → 次数"的统计表。请盯住三个细节:
- 词序被抹平:图中只保留了"哪些词出现、出现几次",词的前后位置完全不参与向量构造——"猫追狗"与"狗追猫"会得到同一根计数条;
- 计数而非二值:一个词出现 3 次,该维就是 3,不是 1——这是词袋区别于 One-hot 的关键,也是"词频"这个信息第一次被显式记录;
- 绝大多数维度为 0:词表上万,一篇文档只命中几十个词,向量"绝大多数格子空着"——这正是下一节稀疏度计算与后面 TF-IDF 加权的直接动机。
2.2 稀疏度与复杂度
V 维向量里非零维数 k 远小于 V。稀疏度定义为:
$$\text{sparsity} = 1 - \frac{\#\text{non-zero 元素}}{V \times N}$$
- 存储上用
scipy.sparse/ sklearn 的稀疏矩阵:只存 (行, 列, 值) 三元组,空间从 O(N·V) 降到 O(总词数); - 计算上:稠密内积 O(V),稀疏实现只需遍历非零元素 O(k)——稀疏向量点积 = 只乘交集。
口算题(面试高频):词表 V = 50000,一篇 500 词的文档 → 稀疏度 = 1 − 500/50000 = 99%。 这就是"为什么需要降维(SVD)/稠密向量(词向量)"的数字证据。
2.2 手算:一篇文档的 BOW 向量到底长什么样
公式容易飘,手算一遍就踏实。取词表 V = {深度学习, 模型, 需要, 大量, 数据}(V=5),文档 d = "深度学习 模型 需要 大量 数据 数据"。
第一步:定词表索引(按字母序排):深度学习→0,大量→1,数据→2,模型→3,需要→4。
第二步:逐词计数:深度学习 1 次、模型 1 次、需要 1 次、大量 1 次、数据 2 次。
第三步:写成向量:
$$\text{BOW}(d) = [1, 1, 2, 1, 1]$$
注意两点:
- 维度顺序由词表决定:换了词表排序,同一个文档的向量各维位置就变了——所以实验 4 里必须用手写的
word2id对齐 sklearn 的vocabulary_,否则"看起来一样"但逐位对不上; - 计数是原始次数:数据出现 2 次 → 该维就是 2。如果语料里还有一篇"数据 1 次"的文档,它们在这一个维度上就能区分开——这是 BOW 相对 One-hot 多出来的"频率区分"能力。
口算复核:向量模长 = sqrt(1²+1²+2²+1²+1²) = sqrt(8) ≈ 2.83;后面做 L2 归一化时,就是用它当分母。
2.3 词袋的三大缺陷 → 为什么需要 TF-IDF
- 丢语序:"猫追狗"与"狗追猫"向量相同,"not good"与"good not"同义——语义相反却零距离;
- 稀疏高维:V 上万、一篇只命中几百维,99% 稀疏,距离度量在空维度上浪费;
- 无语义:"汽车"与"车辆"余弦 ≈ 0(不同维度),同义词不共享维度。
其中缺陷 1、2 要等词向量(02 篇)与上下文表示(05 篇)解决; 缺陷 3 引出一个更紧迫的问题——纯词频会把"的/了/是"这种高频无义词排到最前, 下一篇推导的 TF-IDF 正是为此而生。
3. TF-IDF:词频 × 逆文档频率(重点推导)
3.1 为什么词频不够?——"我们"的困境
一篇体育新闻里,"比赛"出现 20 次、"我们"出现 30 次。纯词频会得出"我们"最重要——荒谬。 直觉:一个词越能"区分"文档,越重要。区分度用两个信息衡量:
- tf(term frequency,词频):在这篇文档里出现得多 → 是本文主题的候选;
- idf(inverse document frequency,逆文档频率):在整个语料里越稀有 → 越有判别力。
$$\text{tf-idf}(t, d) = \text{tf}(t, d) \times \text{idf}(t)$$
"我们"在每篇文档都出现 → df 大 → idf≈0 → 权重≈0; "比赛"只在体育文档出现 → df 小 → idf 大 → 权重高。这就是"为什么 TF-IDF 优于纯词频"的答案。
3.1 图解 TF-IDF:两个因子如何相乘
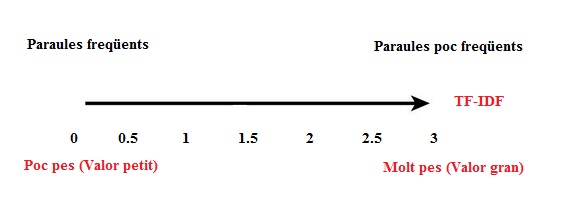
图 2:TF-IDF 加权示意——左半边是词频(tf)信号,右半边是逆文档频率(idf)信号,两者相乘得到词的最终权重。(来源:Wikimedia Commons,公有领域)
这张图把 3.1 节的文字浓缩成可视化的"乘法":左侧是 tf 因子——词在文档里出现越多,这根"频率柱"越高;右侧是 idf 因子——词在语料里越稀有,这根"稀有柱"越高。最终权重 = 两根柱子相乘。
读图时请建立两个直觉:
- 两个因子缺一不可:只有 tf 高("的/了/是")→ idf ≈ 0 → 乘积 ≈ 0;只有 idf 高(语料外冷门词)→ tf = 0 → 乘积仍是 0;
- 权重是"组合判决":真正拿到高分的,是"本文里出现不少 + 全语料里很少见"的词——这正是"文档特色词"的定义。
面试表述:"TF-IDF 是'频率 × 稀有度'的联合判决,回答的是'这篇文档里,哪些词最能代表它、把它与其他文档区分开'。"
3.2 tf 的两种定义
tf 衡量"词在文档里有多常见",常见定义有三种,面试至少要能说出前两种:
| 定义 | 公式 | 特点 |
|---|---|---|
| 原始计数 | $\text{tf}(t,d) = c(t,d)$ | 简单;长文档天然词频高,未做长度补偿 |
| 归一化频率 | $\text{tf}(t,d) = \dfrac{c(t,d)}{\sum_{t'} c(t',d)}$ | 除以文档总词数,消除文档长度影响 |
| 子线性 | $\text{tf}(t,d) = 1 + \log c(t,d)$ | 压缩暴增词频,sklearn 的 sublinear_tf=True |
sklearn 默认用原始计数(sublinear_tf=False),配合末尾的 L2 归一化天然完成长度补偿。
易错点:手写实现必须与 sklearn 默认对齐(原始计数 tf + 平滑 idf + l2 归一化),否则对照数值不一致。
3.3 idf 的推导与平滑(公式从哪来)
df(document frequency) = 语料中包含词 t 的文档数。直觉:df 越大,词越"大众",越没判别力。 最朴素的定义(经典 TF-IDF):
$$\text{idf}(t) = \log\frac{N}{\text{df}(t)}$$
两个致命问题:
- df = N(每篇都有,"我们")→ idf = 0,权重为零——可接受,但退化到"直接删词";
- df = 0(查询里出现语料外的词,OOV)→ 分母为 0,idf = ∞——崩溃。
sklearn 的平滑方案(smooth_idf=True,即本篇要与库对照的版本):
$$\text{idf}(t) = \log\frac{N + 1}{1 + \text{df}(t)} + 1$$
逐项解释(面试要能逐项说清):
- 分子 N+1、分母 1+df:同时 +1 是"加一平滑"(Laplace),保证 df=0 时分母不为零,OOV 词也有有限 idf;
- 整体 +1:保证即使 df=N(每篇都有),idf = log((N+1)/(N+1)) + 1 = 1 > 0,避免"每篇都有的词"权重彻底为 0;
- 对数以 e 为底(sklearn 用
np.log)。
数字手算:N=1000,词"比赛"出现在 9 篇文档 → df=9: $$\text{idf} = \ln\frac{1001}{10} + 1 = \ln 100.1 + 1 \approx 4.61 + 1 = 5.61$$ 若用非平滑版本:$\ln(1000/9) \approx 4.71$——平滑使 idf 整体略高、且永不崩溃。
3.3 公式逐步推导:为什么是 log、为什么加一、加在哪
3.3 节直接给了公式,这里把每一步"为什么"拆开,面试被追问时能讲出完整的推导链。
第 1 步:先定义"稀有度"的朴素度量。词 t 在 N 篇文档里只出现在 df 篇,直觉上"稀有度"可以用比值 N/df 表达:df=1 时比值 = N(最稀有),df=N 时比值 = 1(每篇都有,毫无判别力)。
第 2 步:为什么外面套一个 log? 三个理由,逐条说:
- 压缩动态范围:N=10^6 时,N/df 从 1 到 10^6 跨越 6 个数量级,不取 log 会让稀有词权重爆炸;
- 乘性变加性:检索打分常要对多个词求和(见 4.3 的 BM25),log 能把"几项相乘"变成"几项相加",与概率模型的"独立事件概率相乘"同构;
- 与信息论同源:信息量定义为 $-\log P$,df 越小意味着"看到这个词越意外、信息量越大"——idf 本质上是"这个词在语料里携带的惊讶量"。
第 3 步:为什么是 N+1 与 1+df,而不是 N 与 df? 这是"加一平滑(Laplace smoothing)":防止 df=0 时除零。未平滑版本在 df=0 时 log(N/0) 直接崩溃;加一后分母最小为 1,任何词都拿到有限 idf。
第 4 步:为什么整体再 +1? 保证 df=N(每篇都有)时 idf = log((N+1)/(N+1)) + 1 = 1 > 0——不让"常见词"权重彻底归零。若不加这 1,df=N 的词权重为 0,等价于被删除。
记忆口诀:"分母 +1 防除零,整体 +1 保底牌,log 压量级、化乘为加"——这四句话能一口气答完"idf 公式是怎么来的"。
3.4 L2 归一化与完整算法
TF-IDF 向量拼接后还需归一化,否则长文档的向量模长天然更大,欧氏距离会偏向短文档。 L2(向量模长)归一化:
$$\hat{v}_d = \frac{v_d}{\|v_d\|_2} = \frac{v_d}{\sqrt{\sum_i v_{d,i}^2}}$$
归一化后 $\|\hat{v}_d\|_2 = 1$,余弦相似度退化为点积:$\cos(a,b) = a \cdot b$(实验 8 直接利用这一点,检索变成矩阵乘法)。
完整手写算法(与 sklearn 逐位对齐):
- 统计词表 V,构建 word2id;
- tf:原始计数 $c(t,d)$;
- df:统计每个词出现在几篇文档;
- idf:$\text{idf}(t) = \log\frac{N+1}{1+\text{df}(t)} + 1$;
- 逐元素 $\text{tf-idf} = c(t,d) \times \text{idf}(t)$;
- 每篇文档 L2 归一化。
复杂度:构建 O(N·L̄)(L̄ 平均文档词数),查询/检索 O(V)。 相比词向量(02 篇),TF-IDF 无需训练、可解释性强,是传统检索与文本分类基线的首选特征。
3.4 图解实例:一个具体语料的 TF-IDF 计算全景
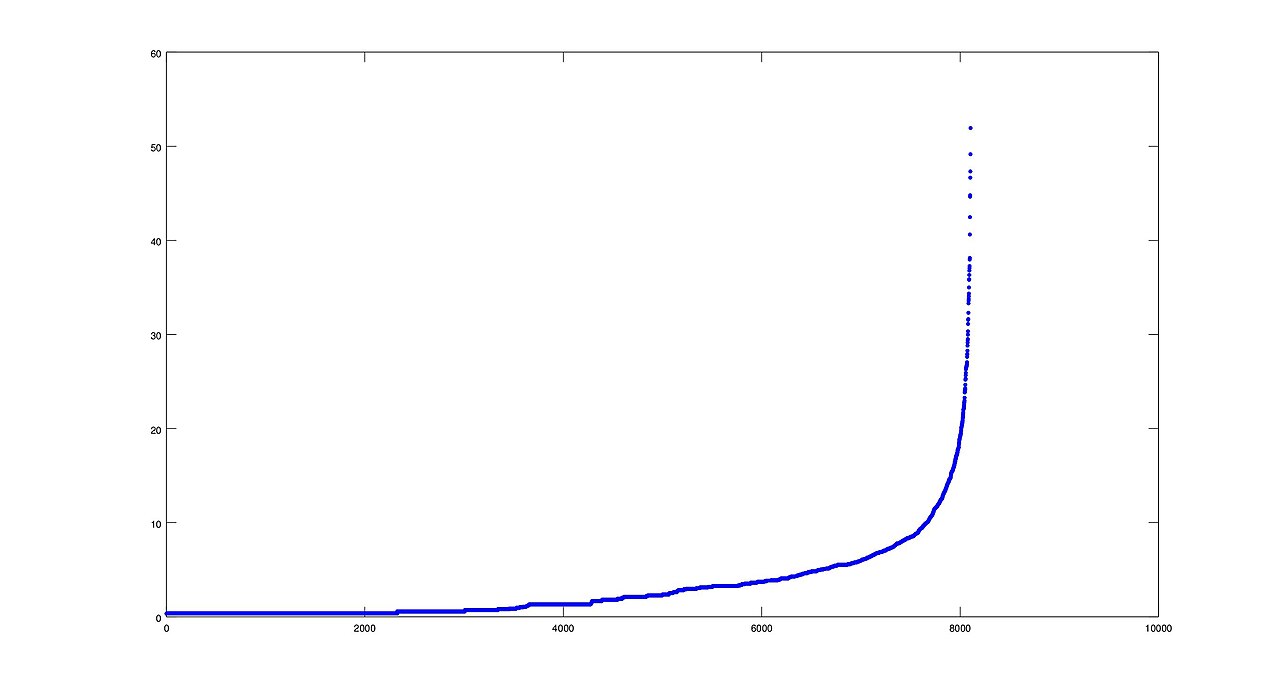
图 3:TF-IDF 计算实例——同一文档集合下,分别展示 tf、df、idf 与最终 tf-idf 权重的对照表,直观呈现"稀有词反超高频词"。来源:Wikimedia Commons,公有领域
上面这张图把 3.3 节的公式在真实数例上"跑"了一遍:对每一篇文档、每一个词的 tf 计数、该词在整个语料的 df、套用平滑 idf 公式得到的 idf 值、以及最终权重,全部列成表格。读图时注意三层对照:
- tf 列 vs idf 列:tf 高的词(常见于某篇)往往 idf 低(因为到处都出现),两者天然"互斥";只有 tf 与 idf 都偏高的词才是赢家;
- idf 列的变化:同一语料里,df=1 的词 idf 最大,df=N 的词 idf 最小——idf 是词在整个语料层面的固定属性,与具体文档无关;
- 最终权重列:按文档逐行比对,你会发现每篇文档权重最高的词,几乎都不是它"出现次数最多"的词,而是"出现得不少 + 语料里少见"的词。
这张图与实验 6 的手写代码一一对应:每行权重 =
Counter(d)[w] * idf[w],再做 L2 归一化。先看图建立"正确数值该长什么样"的直觉,再去看代码,对照误差自然就懂了。
3.4 图解权重对比:罕见词如何"逆袭"高频词
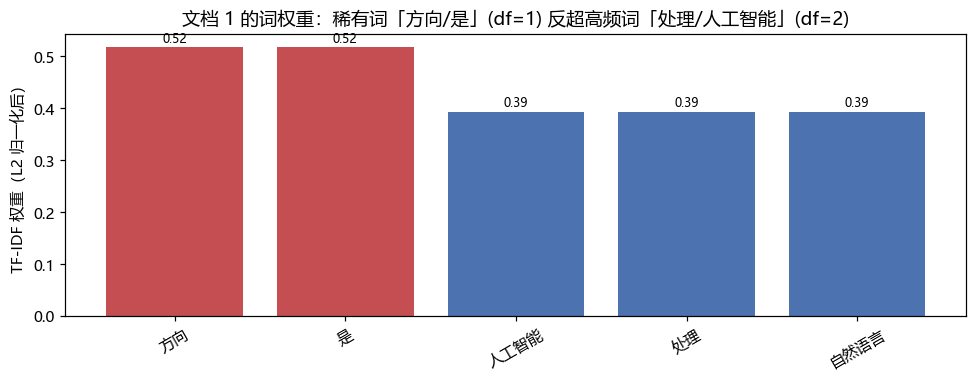
图 5:自绘 TF-IDF 权重对比图(实验 7 生成)——同一篇文档中,df=1 的罕见词「方向/是」权重反超 df=2 的高频词「处理/人工智能」。(图片来源:本教程实验 7 自绘)
这张条形图是"idf 惩罚常见词"的最直观证据:横轴是文档 1 里出现的词,纵轴是 L2 归一化后的 TF-IDF 权重,标红的是权重最高的词。注意到「方向」「是」这两个词在文档 1 中只各出现 1 次,但因为在整个语料里 df=1(只在文档 1 出现),idf 拿到大值,权重冲到最前;而「处理」「人工智能」出现得多,但 df=2,idf 被压低。
这正是 3.3 节公式的"图形化复述"。读图时的三个观察点:
- 柱高与词频不成正比——这是 TF-IDF 与纯词频的根本区别;
- df=1 词的 idf = ln(4/2)+1 ≈ 1.693,df=2 词的 idf = ln(4/3)+1 ≈ 1.288——差异全部来自 idf;
- 权重向量是 L2 归一化后的,所以柱高平方和为 1,可以直接用来做余弦相似度。
这张图在实验 7 里由
plt.bar现场画出并保存到 images 目录;先理解"为什么 df=1 的柱子更高",再运行代码验证,理解闭环就完整了。
3.5 TF-IDF 的局限
- 仍是词袋:丢语序、无语义的问题一个没解决("汽车""车辆"仍零重叠);
- OOV 查询词:语料外新词 idf 只能靠平滑兜底,无法真正表示;
- idf 是全局静态权重:不随查询/任务变化,无法体现"同一词在不同主题下权重不同";
- 长文档稀释:L2 归一化缓解了模长问题,但长文档里主题词占比低,仍然吃亏。
这些局限中最贴近工程现实的一条是 词频不饱和与长度惩罚——检索界的 BM25(见 4.3 前瞻)。
3.5 局限与补救:工业界怎么绕开这些坑
3.5 节列了四条局限,这里补上"每条局限对应什么解法",面试问"TF-IDF 有哪些替代品"时有话可说:
| 局限 | 工业界补救 | 本篇/后续对应 |
|---|---|---|
| 丢语序 | n-gram 保留局部词序 / 词向量建模上下文 | 01 篇 n-gram、02 篇 词向量 |
| 稀疏高维 | SVD/LSA 降维(本实验 9);稠密向量 | 02 篇 Word2Vec |
| 无语义 | 共现统计(GloVe)学到语义相似 | 02 篇 |
| OOV 查询词 | 子词切分(BPE/WordPiece)、预训练词表 | 05 篇 |
| 词频不饱和 / 长度惩罚 | BM25 的饱和函数与长度归一化 | 4.3 前瞻 |
一句话记忆:TF-IDF 是"稀疏、可解释、零训练"的基线;它搞不定的问题,行业沿着"加词序 → 学语义 → 学上下文"三条路线升级,而不是把 TF-IDF 本身改得更复杂。这条"演进地图"在面试里比背公式更值钱。
4. 相似度、检索与可视化
4.1 余弦相似度:只关心"方向"
两个 V 维向量 a、b 的余弦相似度:
$$\cos(a, b) = \frac{a \cdot b}{\|a\|_2 \|b\|_2} = \frac{\sum_i a_i b_i}{\sqrt{\sum_i a_i^2}\sqrt{\sum_i b_i^2}}$$
- 几何意义:两向量夹角余弦,值域 [-1, 1];TF-IDF 非负 → 值域 [0, 1];
- 为什么不用欧氏距离:文档长短不一,模长差异会主导距离;余弦只看方向,天然长度无关;
- L2 归一化后:$\cos(a,b) = a \cdot b$——实验 8 直接利用,检索退化为矩阵乘法(向量数据库/GPU 都这么干)。
4.1 图解检索流程:从查询到 Top-K 的完整链路
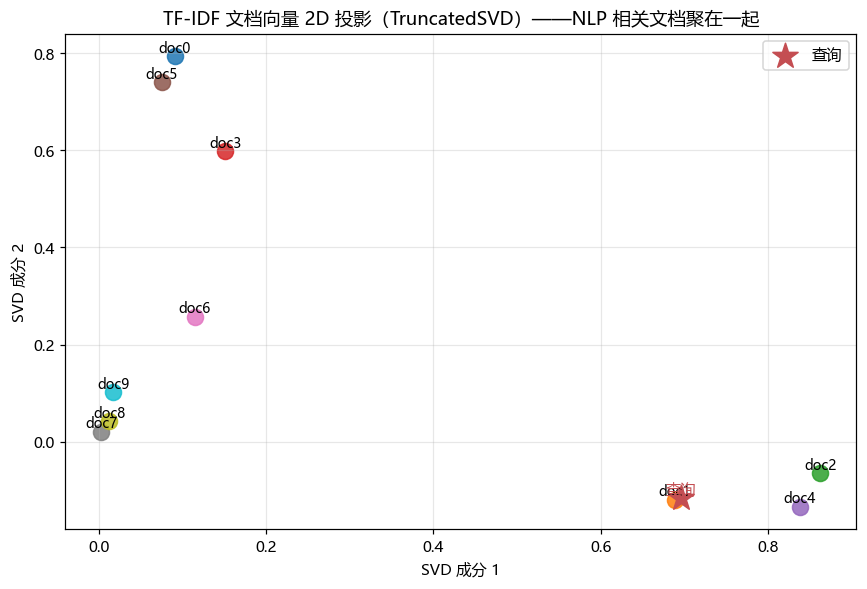
图 4:自绘检索流程示意——查询文本经"分词 → TF-IDF → 余弦相似度"变成检索打分,再经 TruncatedSVD 降维在二维平面展示文档聚类。(图片来源:本教程实验 9 自绘)
这张自绘流程图把 1~4 节的知识串成一条流水线:查询句子 → 与文档库一样做分词/规范化 → 用同一套 TF-IDF 词表转成向量 → 与库中每个文档向量算余弦相似度 → 取 Top-K 返回 → 顺手用 SVD 降到 2D 可视化。
看图的要点:
- 查询和文档走的是同一套管线:查询 "自然语言 处理 人工智能 方向" 必须和训练语料用同一个
TfidfVectorizer(同一个词表、同一套 idf),向量才有可比性——这是实验 8 里tv2.transform([query])而非重新 fit 的原因; - 检索 = 一次矩阵乘法:语料向量排成矩阵 X(N×V),归一化后
X @ q一次得到 N 个余弦分数,排序即 Top-K; - SVD 是"降维看结构":高维向量投到 2D,聚类是否合理一眼可见——NLP 相关文档聚成一簇,正是"共享词 → 相似向量"的证据。
图里右下角的散点图在实验 9 会由代码现场生成保存,先看流程图建立"检索系统长什么样"的整体印象,再看实验 8/9 的代码就心里有数了。
4.3 实验解读与 BM25 前瞻
观察:与查询共享「自然语言/处理/人工智能/方向」的 doc1(其次 doc2/doc4)在 2D 投影中聚在附近、且余弦分数最高—— TF-IDF 空间里"词的共现"近似"语义相近",这就是稀疏检索能工作的全部秘密。
但 TF-IDF 有三个工程缺陷(检索系统里尤其明显):
- 词频不饱和:一篇文档里"处理"出现 1 次与 10 次,权重线性放大,实际应"出现越多、边际收益越低";
- 无长度归一化:L2 只归一化向量,长文档仍会稀释主题词占比;
- idf 无上限保护:极端稀有词权重爆炸,结果被噪声词主导。
BM25(Okapi BM25) 是 TF-IDF 的直接升级,至今是 Elasticsearch 的默认相关性算法:
$$\text{score}(d, q) = \sum_{t \in q} \text{IDF}(t) \cdot \frac{\text{tf}(t, d) \cdot (k_1 + 1)}{\text{tf}(t, d) + k_1 \cdot \left(1 - b + b \cdot \frac{|d|}{\text{avgdl}}\right)}$$
- 词频项带饱和:$k_1$(默认 1.2~2.0)控制增长曲线,词频再高也不会无限放大;
- 长度归一化:$b$(默认 0.75)惩罚超长文档;
- IDF 换成 $\log\left(\frac{N - \text{df} + 0.5}{\text{df} + 0.5} + 1\right)$,同样带平滑。
下一篇《01 n-gram 与统计语言模型》会正面处理"词频 → 概率"这一跃迁:把"词出现次数"变成"句子概率"。
5. 数字敏感度与易错点(面试官爱问的坑)
- idf 公式版本别混:
log(N/df)(朴素)、log(N/(1+df))(防零)、sklearnlog((N+1)/(1+df))+1(平滑 + 保底 1)。面试要能默写一种并说清差别;手写对照必须用 sklearn 版本。 - 归一化是 L2 不是 L1:sklearn
TfidfVectorizer(norm='l2')默认;L1 会变成"词频占比",余弦语义就变了。 - tf-idf 不是概率:不保证和为 1;说"tf-idf 权重"可以,说"tf-idf 概率"是错的。
- 丢语序是缺陷不是特性:"猫追狗"与"狗追猫"向量相同、余弦 = 1;回答"BOW 的优点"时别提语序不变性。
- 口算稀疏度:词表 V=50000、一篇文档 500 词 → 稀疏度 99%;这就是"为什么需要降维/稠密向量"的数字证据。
6. 面试速答(30 秒背诵版)
- 分词难点:歧义 + 未登录词(OOV);最大匹配 / 双向最大匹配 / HMM / 预训练分词器。
- 为什么 TF-IDF 优于纯词频:纯词频把每篇都有的"我们"排第一;TF-IDF 用 df 惩罚常见词,突出文档特有词。
- idf 平滑公式:$\text{idf}(t) = \log\frac{N+1}{1+\text{df}(t)} + 1$;+1 保证 df=N 时权重 ≥ 1,分母 +1 防 df=0 除零。
- BOW:词频向量,V 维稀疏;丢语序、无语义。
- 为什么稀疏:中文词表上万,一篇文档只用几百词 → 稀疏度 ≈ 99%。
- 余弦 vs 欧氏:余弦看方向、长度无关,适合稀疏文本;欧氏距离受模长(文档长度)主导。
- 检索 = 点积:L2 归一化后余弦 = 点积,批量检索就是矩阵乘法。
- 演进主线:词袋 → TF-IDF → BM25(检索界)→ Word2Vec(02 篇)→ 上下文表示(05 篇)。
7. 自测清单
- 手写正向最大匹配分词,能复现"研究生命科学 → 研究生/命/科学"的歧义错误
- 手写反向最大匹配与双向消歧(词数更少 / 单字更少),说出与正向的差异
- 写全规范化管线:小写、去标点、全半角、停用词,各举一个输入/输出例子
- 手写 BOW 并与
CountVectorizer逐位对照一致(注意 token_pattern 允许单字词) - 用"猫追狗/狗追猫"证明 BOW 丢语序,并口算 3 文档 × 14 词表的稀疏度
- 默写 sklearn 平滑 idf 公式,逐项解释分子 +1、分母 +1、整体 +1 各防什么
- 手写 TF-IDF 并与
TfidfVectorizer对照(误差 < 1e-6),说出默认的 tf 定义与 norm - 手写余弦相似度 + Top-K 检索,并解释 L2 归一化后余弦为什么等于点积
- 口算:N=1000、df=9 → 平滑 idf = ln(1001/10)+1 ≈ 5.61;非平滑 ≈ 4.71
- 口算:V=50000、单文档 500 词 → 稀疏度 99%
- 说出 TF-IDF 的至少 3 个局限,以及 BM25 用哪两个机制修补(词频饱和 + 长度归一化)
7.5 延伸阅读与知识图谱
本篇在课程中的位置:00(文本表示与 TF-IDF)→ 01(n-gram 与统计语言模型)→ 02(Word2Vec 与 GloVe)→ 03(RNN 与 LSTM)→ 05(预训练模型)。本篇解决"词怎么变成向量",后面解决"向量里怎么有语义"。
知识图谱(相关概念串联):
纯词频排序 ──► 词袋 BOW ──► TF-IDF ──► BM25(检索)
    │             │            │
    │             └─► 稀疏高维问题 ──► SVD/LSA 降维(实验9)
    │                             └─► 稠密词向量 Word2Vec(02篇)
    └─► 丢语序问题 ──► n-gram(01篇)──► RNN(03篇)──► Transformer(04篇)
延伸阅读建议:
- Salton 的经典论文:《A Vector Space Model for Automatic Indexing》(1975)——向量空间模型的开山之作;
- Spärck Jones 的论文:《A Statistical Interpretation of Term Specificity in Retrieval》(1972)——idf 的思想源头;
- sklearn 文档中
TfidfVectorizer的参数说明(smooth_idf / sublinear_tf / norm)——面试常考"默认值是什么"; - Elasticsearch 官方文档对 BM25 的解释——看 k1、b 两个超参怎么调。
面试进阶三问(用于把"会用"升级为"懂原理"):
- 为什么
sublinear_tf=True(tf 用 1+log c)在长文档上更稳?——词频边际收益递减,log 压缩极端值; - TF-IDF 与"互信息"有什么关系?——都是衡量词与文档相关性的量,但 TF-IDF 是无监督启发式,互信息需要类别标签;
- 为什么现在 RAG 系统还会用 TF-IDF/BM25 做召回的第一阶段?——可解释、零训练、速度快,先用稀疏检索粗筛再精排,是工程上的标准做法。
8. 下一篇预告
本篇把「文档」变成了「向量」;下一篇 01-n-gram 与统计语言模型 把「词序列」变成「概率」——
用链式法则 + 马尔可夫假设给句子打分,并解决 n-gram 的数据稀疏(平滑)问题。词袋的"丢语序"将由 n-gram 部分修复。
# ---------- 实验 1:中文分词——正向最大匹配手写(含歧义示例) ----------
import numpy as np
import matplotlib.pyplot as plt
from collections import Counter
import math, re

np.random.seed(0)                                  # 固定随机种子(全篇可复现)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 词典:特意同时放入「研究生/研究」「生命/科学/生命科学」,制造歧义
DICT = {'自然', '语言', '处理', '自然语言', '学习', '深度', '深度学习', '人工智能',
        '算法', '计算机', '视觉', '分词', '中文', '模型', '训练', '数据',
        '重要', '方向', '需要', '大量', '研究', '研究生', '生命', '科学', '生命科学',
        '应用', '领域', '是', '的'}

def forward_max_match(s, max_len=4):
    '''正向最大匹配:从左到右,每次取最长可匹配词(贪心)。'''
    i, toks = 0, []
    while i < len(s):
        matched = None
        for L in range(min(max_len, len(s) - i), 0, -1):   # 从最长候选开始试
            if s[i:i + L] in DICT:
                matched = s[i:i + L]
                i += L
                break
        if matched is None:            # 未登录词 → 按单字输出
            toks.append(s[i]); i += 1
        else:
            toks.append(matched)
    return toks

for s in ['自然语言处理是人工智能的重要方向', '研究生命科学']:
    print('正向最大匹配 %s -> %s' % (s, '/'.join(forward_max_match(s))))
assert ' '.join(forward_max_match('自然语言处理是人工智能的重要方向')) == '自然语言 处理 是 人工智能 的 重要 方向'
print('要点:正向最大匹配 = 贪心最长词;"研究生命科学"被切成「研究生/命/科学」——歧义错误!')

plt.show()
# ---------- 实验 2:反向最大匹配 + 双向消歧 + 未登录词 ----------
def reverse_max_match(s, max_len=4):
    '''反向最大匹配:从右往左,每次取最长的可匹配结尾词。'''
    i, toks = len(s), []
    while i > 0:
        matched = None
        for L in range(min(max_len, i), 0, -1):
            if s[i - L:i] in DICT:
                matched = s[i - L:i]
                i -= L
                break
        if matched is None:
            toks.append(s[i - 1]); i -= 1
        else:
            toks.append(matched)
    return list(reversed(toks))

def single_char_penalty(toks):
    '''单字散落惩罚:切出的单字越多,切分越可疑。'''
    return sum(1 for t in toks if len(t) == 1)

def bidirectional_max_match(s, max_len=4):
    '''双向最大匹配:词数更少者胜;平局比单字散落。返回 (最佳切分, 胜出方向, 正向结果, 反向结果)。'''
    f, r = forward_max_match(s, max_len), reverse_max_match(s, max_len)
    if len(f) < len(r):
        return f, '正向', f, r
    if len(r) < len(f):
        return r, '反向', f, r
    best = f if single_char_penalty(f) <= single_char_penalty(r) else r
    side = '正向' if single_char_penalty(f) <= single_char_penalty(r) else '反向'
    return best, side, f, r

s = '研究生命科学'
f, r = forward_max_match(s), reverse_max_match(s)
best, side, _, _ = bidirectional_max_match(s)
print('正向(%d词):' % len(f), '/'.join(f))
print('反向(%d词):' % len(r), '/'.join(r))
print('双向选择(%s):' % side, '/'.join(best))
assert '/'.join(best) == '研究/生命科学'

# 未登录词(OOV)演示:'热门' 不在词典 → 退化为单字
s2 = '自然语言处理是人工智能的热门方向'
print('OOV 示例:', '/'.join(forward_max_match(s2)))
assert '热门' not in '/'.join(forward_max_match(s2))
print('要点:双向最大匹配用「词数更少 + 单字更少」消歧;OOV 词只能退化为单字(HMM/预训练分词器可缓解)')
# ---------- 实验 3:规范化管线(小写/去标点/全半角/停用词) ----------
STOPWORDS = {'的', '了', '是', '和', '在', '中', '之', '也', '以及',
             'the', 'a', 'an', 'is', 'are', 'of', 'to', 'in', 'and'}

def to_halfwidth(s):
    '''全角 → 半角:全角 ASCII(U+FF01~FF5E)减 0xFEE0;全角空格 U+3000 → 半角空格。'''
    out = []
    for ch in s:
        cp = ord(ch)
        if cp == 0x3000:
            out.append(' ')
        elif 0xFF01 <= cp <= 0xFF5E:
            out.append(chr(cp - 0xFEE0))
        else:
            out.append(ch)
    return ''.join(out)

def normalize(text):
    '''规范化管线:全半角 → 小写 → 去标点/非中英文数字 → 切词 → 去停用词。'''
    t = to_halfwidth(text)                       # 1) 统一全半角
    t = t.lower()                                # 2) 小写
    t = re.sub(r'[^\w\u4e00-\u9fa5]+', ' ', t)   # 3) 去标点与杂符号(保留中文/字母/数字)
    toks = [w for w in t.split() if w and w not in STOPWORDS]   # 4) 切词 + 去停用词
    return toks

raw = '深度学习 AI 与 NLP!是 人工智能 的 重要 方向,需要 大量 数据。'
print('原始   :', raw)
toks = normalize(raw)
print('规范化 :', ' '.join(toks))
assert toks == ['深度学习', 'ai', '与', 'nlp', '人工智能', '重要', '方向', '需要', '大量', '数据']
assert '是' not in toks and '的' not in toks          # 停用词被过滤
print('全角AI→半角AI、大写→小写、标点→空格、停用词"是/的"被删除 ✓')
# ---------- 实验 4:手写 BOW + sklearn CountVectorizer 对照 ----------
from sklearn.feature_extraction.text import CountVectorizer

docs = ['深度学习 模型 需要 大量 数据',
        '自然语言 处理 是 人工智能 方向',
        '计算机 视觉 与 自然语言 处理 同属 人工智能']
docs_tok = [d.split() for d in docs]

vocab = sorted({w for d in docs_tok for w in d})
word2id = {w: i for i, w in enumerate(vocab)}
bow = np.zeros((len(docs), len(vocab)), dtype=np.int64)
for k, d in enumerate(docs_tok):
    for w in d:
        bow[k, word2id[w]] += 1
print('手写 BOW:\n', bow)

cv = CountVectorizer(token_pattern=r'(?u)\b\w+\b')   # 允许单字词(默认 \w\w+ 会过滤「与/是」)
bow_sk = cv.fit_transform(docs).toarray()
order = [cv.vocabulary_[w] for w in vocab]
print('sklearn BOW:\n', bow_sk[:, order])
assert np.array_equal(bow, bow_sk[:, order])
print('一致 ✓ | 维度 = 词汇表大小 =', len(vocab))
# ---------- 实验 5:丢语序演示(猫追狗 vs 狗追猫)+ 稀疏度计算 ----------
def bow_vector(toks, word2id, V):
    v = np.zeros(V, dtype=np.int64)
    for w in toks:
        if w in word2id:
            v[word2id[w]] += 1
    return v

sents = ['猫 追 狗', '狗 追 猫']
w2id_small = {'猫': 0, '追': 1, '狗': 2}
va, vb = bow_vector(sents[0].split(), w2id_small, 3), bow_vector(sents[1].split(), w2id_small, 3)
print('「%s」 -> %s' % (sents[0], va))
print('「%s」 -> %s' % (sents[1], vb))
assert np.array_equal(va, vb)
cos_ab = float(va @ vb / (np.linalg.norm(va) * np.linalg.norm(vb) + 1e-12))
print('两向量完全相同 → 余弦相似度 =', round(cos_ab, 4))

# 稀疏度:3 篇文档 × V 维矩阵中非零比例
total = bow.size
nnz = np.count_nonzero(bow)
print('BOW 矩阵维度 %d x %d = %d 个元素,非零 %d 个' % (bow.shape[0], bow.shape[1], total, nnz))
print('稀疏度 = %.1f%%' % (100 * (1 - nnz / total)))
assert (1 - nnz / total) > 0.5
print('要点:BOW 把「猫追狗/狗追猫」变成同一个向量——语序信息彻底丢失')
# ---------- 实验 6:手写 TF-IDF + sklearn TfidfVectorizer 对照 ----------
from sklearn.feature_extraction.text import TfidfVectorizer

N = len(docs)
# 步骤 3:df —— 每个词出现在几篇文档
df = {w: sum(1 for d in docs_tok if w in set(d)) for w in vocab}
# 步骤 4:平滑 idf
idf = {w: math.log((N + 1) / (1 + df[w])) + 1 for w in vocab}
# 步骤 5 + 6:tf × idf,然后 L2 归一化
tfidf = np.zeros((N, len(vocab)))
for k, d in enumerate(docs_tok):
    c = Counter(d)
    for w in d:
        tfidf[k, word2id[w]] = c[w] * idf[w]
tfidf = tfidf / (np.sqrt((tfidf ** 2).sum(axis=1, keepdims=True)) + 1e-12)

tv = TfidfVectorizer(token_pattern=r'(?u)\b\w+\b')   # 默认: smooth_idf=True, norm='l2', 原始计数 tf
tfidf_sk = tv.fit_transform(docs).toarray()[:, [tv.vocabulary_[w] for w in vocab]]
print('手写 TF-IDF 第一行:\n', np.round(tfidf[0], 3))
print('sklearn 第一行:\n', np.round(tfidf_sk[0], 3))
err = np.abs(tfidf - tfidf_sk).max()
print('最大误差: %.2e' % err)
assert err < 1e-6

# 每个文档最具代表性的词(tf-idf 最大者)
for k in range(N):
    best = vocab[int(np.argmax(tfidf[k]))]
    print('文档 %d 最具代表性的词: %s (idf=%.3f)' % (k, best, idf[best]))
# ---------- 实验 7:TF-IDF 权重可视化(稀有词反超高频词) ----------
fig, ax = plt.subplots(figsize=(9, 3.6))
k = 1   # 看文档 1「自然语言 处理 是 人工智能 方向」
vals = tfidf[k]
idx = [i for i in np.argsort(-vals) if vals[i] > 0]
names = [vocab[i] for i in idx]; scores = [vals[i] for i in idx]
colors = ['#C44E52' if s == scores[0] else '#4C72B0' for s in scores]
ax.bar(range(len(names)), scores, color=colors)
ax.set_xticks(range(len(names))); ax.set_xticklabels(names, rotation=30)
ax.set_ylabel('TF-IDF 权重(L2 归一化后)')
ax.set_title('文档 1 的词权重:稀有词「方向/是」(df=1) 反超高频词「处理/人工智能」(df=2)')
for i, s in enumerate(scores):
    ax.text(i, s + 0.01, '%.2f' % s, ha='center', fontsize=8)
plt.tight_layout()
try:
    plt.savefig('10-自然语言处理/教学/images/nlp00_tfidf_weights.png', dpi=110, bbox_inches='tight')
except FileNotFoundError:
    print('(跳过保存图片:images 目录不存在)')
plt.show()
# ---------- 实验 8:余弦相似度 + Top-K 检索(手写 vs sklearn 对照) ----------
from sklearn.metrics.pairwise import cosine_similarity

# 扩充语料:10 篇短文档(主题:深度学习 / NLP / 检索 / 推荐 / 聚类)
corpus = [
 '深度学习 模型 需要 大量 数据',
 '自然语言 处理 是 人工智能 方向',
 '计算机 视觉 与 自然语言 处理 同属 人工智能',
 '机器学习 算法 依赖 大量 数据 与 特征工程',
 '人工智能 应用 覆盖 计算机 视觉 自然语言 处理',
 '深度 神经网络 需要 大量 训练 数据',
 '文本 分类 使用 词袋 模型 与 特征 表示',
 '检索 系统 计算 文档 之间 的 余弦 相似度',
 '推荐 系统 使用 矩阵 分解 学习 用户 向量',
 '聚类 算法 把 相似 文档 划分 到 同一 簇']
tv2 = TfidfVectorizer(token_pattern=r'(?u)\b\w+\b')
X = tv2.fit_transform(corpus)          # 10 x V 稀疏 TF-IDF 矩阵

def cosine_hand(a, B):
    '''手写余弦:各自 L2 归一化后,余弦 = 点积(矩阵乘法批量计算)。'''
    a = a / (np.linalg.norm(a) + 1e-12)
    B = B / (np.linalg.norm(B, axis=1, keepdims=True) + 1e-12)
    return B @ a

query = '自然语言 处理 人工智能 方向'
qv = tv2.transform([query]).toarray()[0]
sims_hand = cosine_hand(qv, X.toarray())
sims_sk = cosine_similarity(qv.reshape(1, -1), X)[0]
print('手写 vs sklearn 余弦最大误差: %.2e' % np.abs(sims_hand - sims_sk).max())
assert np.abs(sims_hand - sims_sk).max() < 1e-9

order = np.argsort(-sims_sk)
print('查询「%s」的 Top-3:' % query)
for r in order[:3]:
    print('  Top%d  相似度 %.3f  「%s」' % (list(order[:3]).index(r) + 1, sims_sk[r], corpus[r]))
assert order[0] == 1    # 与查询共享 4 个词的文档 1 应排第一
print('要点:检索 = 查询向量与库向量批量点积;语料越大,稀疏矩阵 + 向量数据库的优势越明显')
# ---------- 实验 9:TruncatedSVD 降维可视化 ----------
from sklearn.decomposition import TruncatedSVD

svd = TruncatedSVD(n_components=2, random_state=0)   # 固定随机种子
pts = svd.fit_transform(X)
print('SVD 前 2 维解释方差比: %.3f' % svd.explained_variance_ratio_.sum())

fig, ax = plt.subplots(figsize=(8, 5.5))
for k in range(len(corpus)):
    ax.scatter(pts[k, 0], pts[k, 1], s=110, alpha=0.85)
    ax.annotate('doc%d' % k, (pts[k, 0], pts[k, 1]), fontsize=9, ha='center', va='bottom')
qp = svd.transform(qv.reshape(1, -1))[0]
ax.scatter(*qp, marker='*', s=300, color='#C44E52', label='查询')
ax.annotate('查询', (qp[0], qp[1]), fontsize=10, color='#C44E52', ha='center', va='bottom')
ax.set_title('TF-IDF 文档向量 2D 投影(TruncatedSVD)——NLP 相关文档聚在一起')
ax.set_xlabel('SVD 成分 1'); ax.set_ylabel('SVD 成分 2')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
try:
    plt.savefig('10-自然语言处理/教学/images/nlp00_retrieval.png', dpi=110, bbox_inches='tight')
except FileNotFoundError:
    print('(跳过保存图片:images 目录不存在)')
plt.show()