🧱 05 · 排序特征工程与样本采样¶
「特征工程决定上限」。本节覆盖排序特征体系、特征交叉、负样本采样、Pairwise 排序—— 都是搜广推面试的高频手撕/追问点。
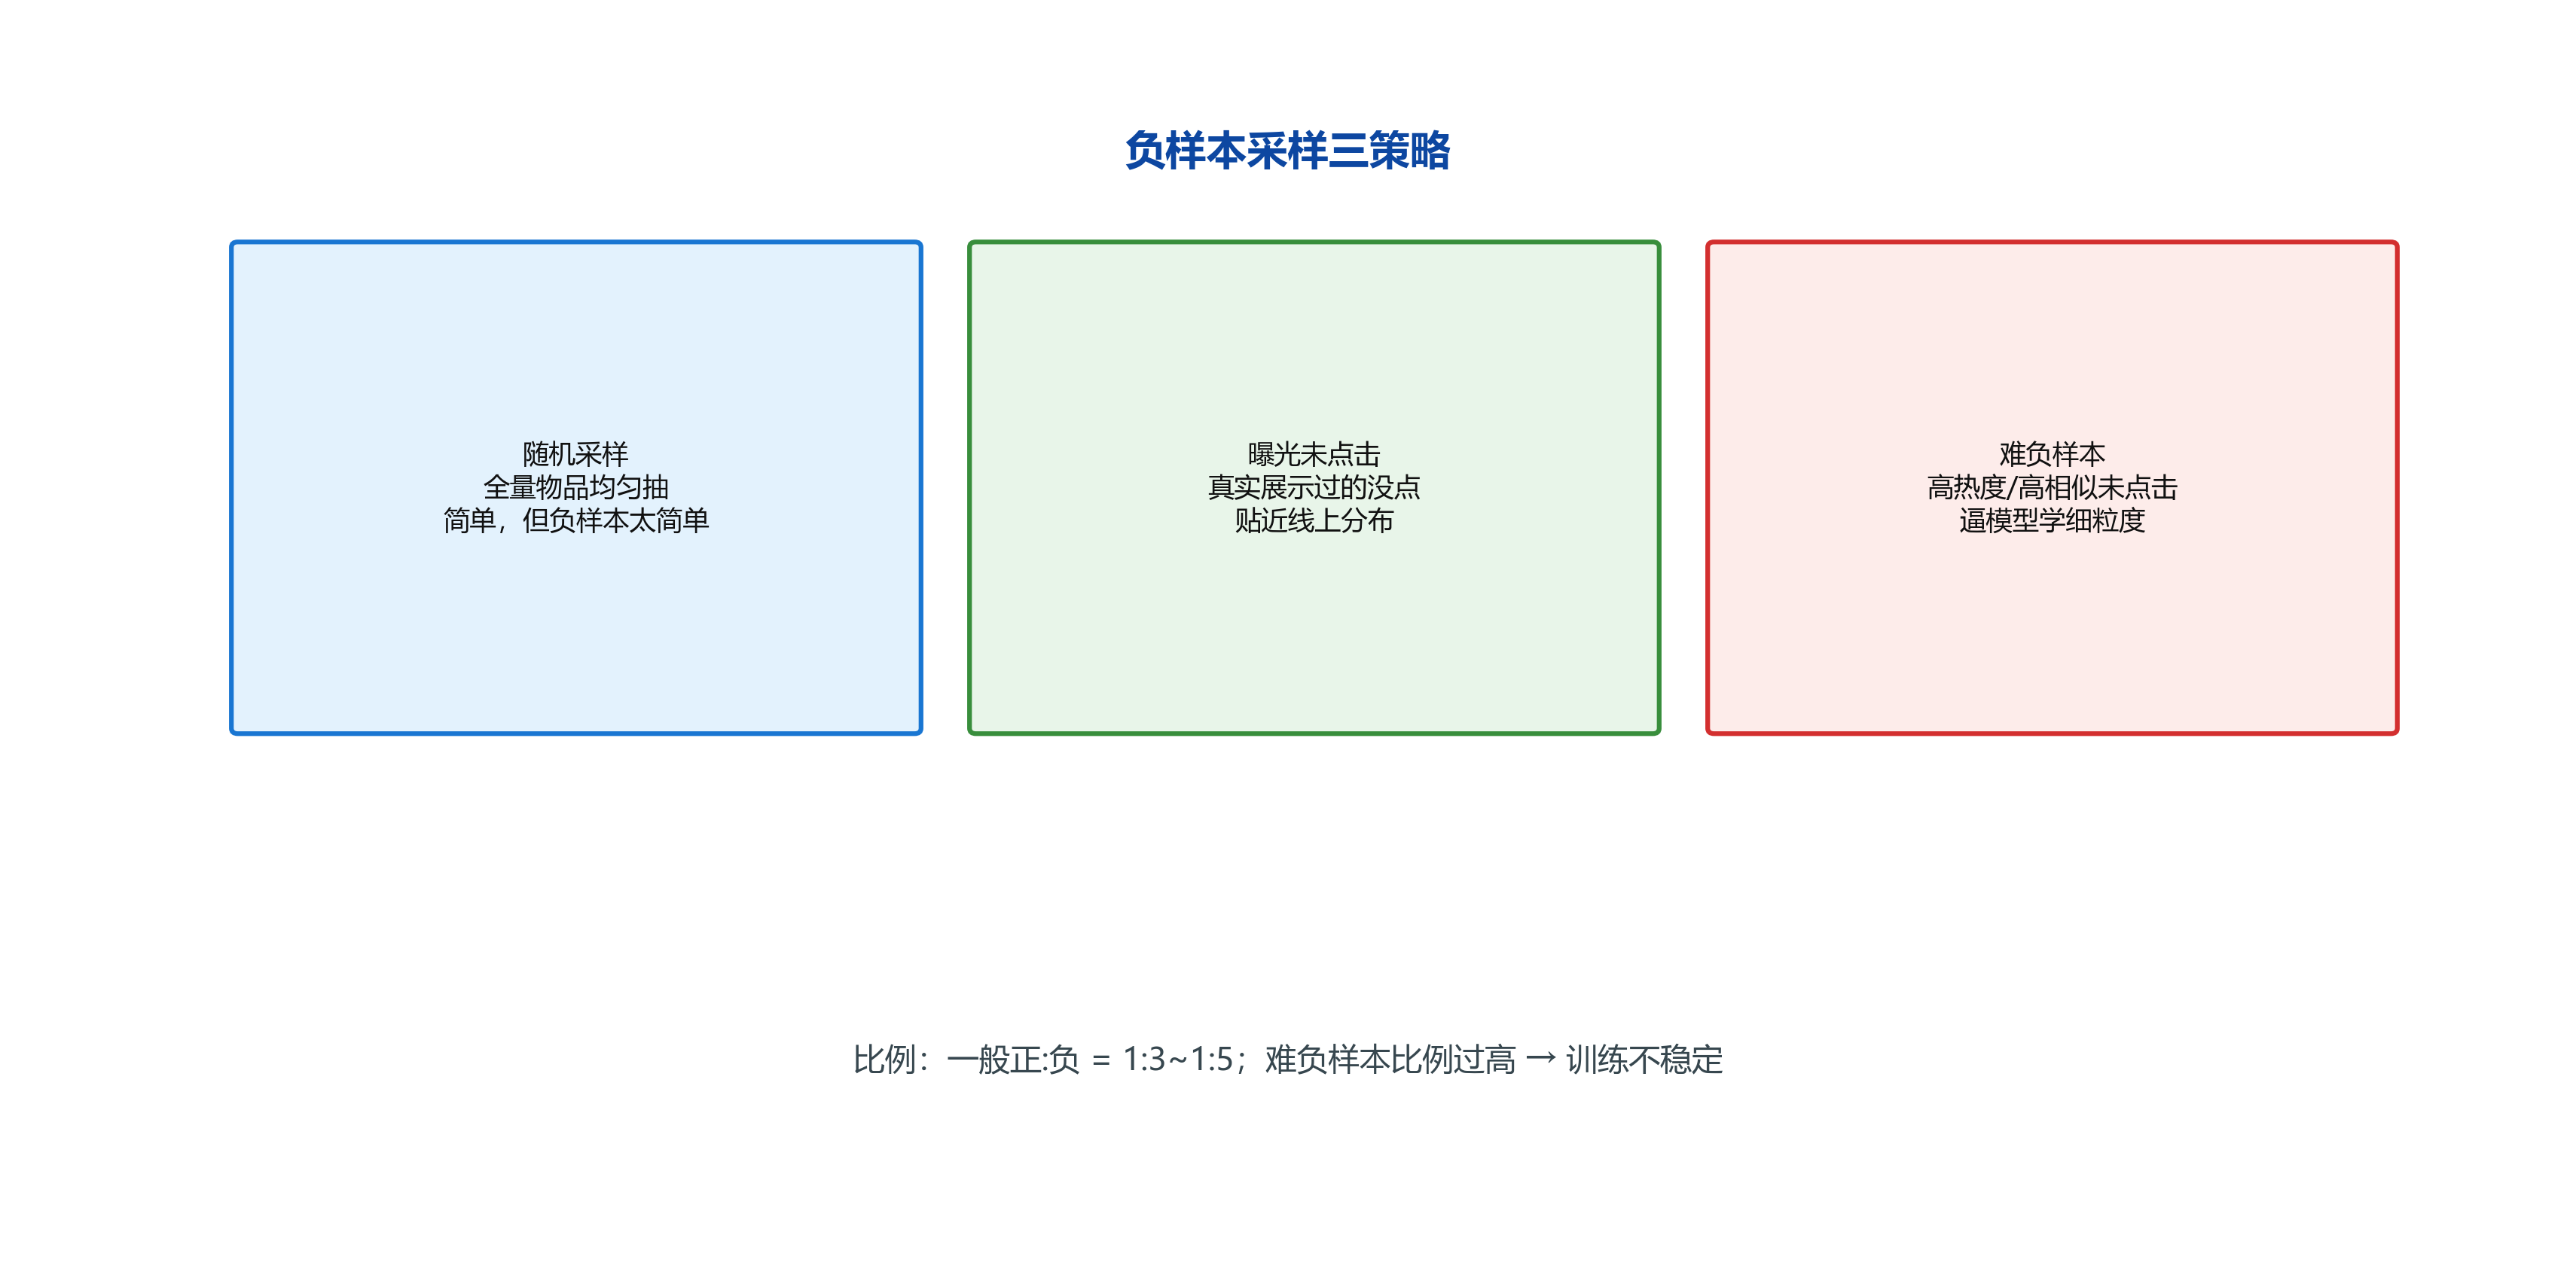
🔍 图解(自绘高清图,300dpi,可放大):排序模型训练的负样本怎么选?三档由浅入深——
- ① 随机负样本:从全量物品里随机抽没交互过的——量大便宜但太"容易":全是用户没见过的 冷门物品,模型学不到"为什么用户喜欢 A 不喜欢 B"的精细区别;
- ② 曝光未点击:真实曝光过但没被点击的物品做负样本——这是最贴合线上的负样本: 用户真的见过却没点,说明"见过也不喜欢";比随机负样本难,逼模型学点击意图的细微差别;
- ③ 难负样本:模型当前打分高但其实是负的样本("貌似相关实则不相关")—— 用在线难例挖掘(OHEM)不断替换最难的负样本,模型被迫把"看起来像正例的负例"也区分开;
- 工程配比:工业上常混合使用(如 随机:曝光未点:难负 = 1:2:1), 并配 ESMM 式正样本(点击+转化)防样本选择偏差。
🎬 背景故事¶
模型再强,喂进去的特征和样本不行也是白搭……
有句行话:模型决定上限,特征和样本决定你能不能碰到上限。工业推荐里,特征工程往往占了一个算法工程师一半以上的时间。本节讲清楚三件事:特征从哪来(四类体系)、特征怎么交叉、以及最反直觉的一环——负样本怎么采(采法不对,模型学的东西全偏)。
🧭 本节逻辑主线:特征体系(用户/物品/交叉/上下文)→ 特征交叉(为什么有用)→ 负采样三策略(随机/曝光/难负)→ 损失函数选择(Pointwise/Pairwise/Listwise)。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 排序特征有哪些? | 用户/物品/交叉/上下文特征 |
| 2 | 特征交叉怎么做? | 笛卡尔积 / 哈希 / FM 隐向量 |
| 3 | 负样本怎么采? | 随机采样 vs 曝光未点击 |
| 4 | 排序怎么学? | Pointwise vs Pairwise |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 排序特征体系(必背)¶
✍️ §1.1 手算特征工程与采样:min-max 归一化与 1:5 负采样¶
排序模型上线前两道"必修课":连续特征归一化(统一数量级)与训练集负采样(控制正负比例)。各用一个数字例子算清楚。
第 1 步:min-max 归一化——原始播放时长特征 $\mathbf{x}=[100,\ 200,\ 300,\ 400]$(秒):
$$\text{min}=100,\quad \text{max}=400,\quad \text{range}=300,\qquad x'=\frac{x-\text{min}}{\text{max}-\text{min}}=\frac{x-100}{300}$$
| $x$ | 100 | 200 | 300 | 400 |
|---|---|---|---|---|
| $x'$ | 0 | $\frac{1}{3}\approx0.3333$ | $\frac{2}{3}\approx0.6667$ | 1.0 |
归一化后量纲消失、范围锁进 $[0,1]$——否则"播放时长几百秒"会碾压"点击率 0.03"这类 0~1 特征,模型注意力全被大数值特征带走。
第 2 步:负采样比例——某天曝光日志 10,000 条:点击 1,000、未点击 9,000。按 1:5 采样未点击当负样本:
$$\text{负样本数}=5\times1000=5000,\qquad \text{训练集}=1000+5000=6000,\qquad \text{正样本占比}=\frac{1000}{6000}=\frac16\approx16.7\%$$
| 方案 | 正样本 | 负样本 | 正样本占比 |
|---|---|---|---|
| 全量未点击(1:9) | 1,000 | 9,000 | 10.0% |
| 随机采样 1:5 | 1,000 | 5,000 | 16.7% |
手算收获:
- min-max 对离群点敏感:若混进一条 100 万秒的播放,其余样本全被压到 0 附近——需要稳健性时换 z-score(均值/方差)或分箱(§1 特征体系里的经验分箱)
- 采样改变了训练分布:线上真实 CTR 是 10%,1:5 采样后训练分布变成 16.7%——模型学到的是"采样后的分布",上线预测一般还要做概率校正,否则 0.5 阈值与分组 AUC 都会失真
- 负采样比例是"偏差—方差"旋钮:比例太大 → 训练分布偏离线上太多(偏差大);太小 → 负样本不足、学不动(方差大);工业常见 1:5 ~ 1:20,配合 §3 的难负样本策略
- 曝光未点击(而非全站随机物品)作负样本最贴近线上:全站随机采样等于学"库里随便抽"的分布,与线上"排序了但不点"的分布不一致
下面 numpy 复算。
# ---- §1.1 验证:numpy 复算归一化与负采样 ----
import numpy as np

hc_x = np.array([100, 200, 300, 400])
hc_xn = (hc_x - hc_x.min()) / (hc_x.max() - hc_x.min())
print('min-max 归一化 =', np.round(hc_xn, 4))
assert np.allclose(hc_xn, [0, 1 / 3, 2 / 3, 1.0])

hc_imp = 10_000
hc_pos = 1_000
hc_neg_sampled = 5 * hc_pos
hc_total = hc_pos + hc_neg_sampled
hc_share = hc_pos / hc_total
print(f'1:5 采样 → 负样本 {hc_neg_sampled},训练集 {hc_total},正样本占比 {hc_share:.1%}(=1/6)')
print(f'全量未点击 → 正样本占比 {hc_pos / hc_imp:.1%}(=1/10)')
assert hc_neg_sampled == 5_000 and abs(hc_share - 1 / 6) < 1e-9
print('✓ 与手算一致')
print('''| 类别 | 例子 |
|---|---|
| 用户特征 | 年龄/性别/城市/历史 CTR/近 7 日活跃/品类偏好 |
| 物品特征 | 类目/价格档/发布时间/近 7 日曝光点击/质量分 |
| 交叉特征 | 用户品类偏好 × 物品类目、城市 × 价格档 |
| 上下文特征 | 小时/星期/设备/位置/天气/渠道 |
| 统计特征 | 用户-物品共现、物品近 1h 热度(在线特征) |

注意:在线特征(近 1h 热度)训练/线上口径必须一致,否则特征穿越(label leakage)。
''')
| 类别 | 例子 |
|---|---|
| 用户特征 | 年龄/性别/城市/历史 CTR/近 7 日活跃/品类偏好 |
| 物品特征 | 类目/价格档/发布时间/近 7 日曝光点击/质量分 |
| 交叉特征 | 用户品类偏好 × 物品类目、城市 × 价格档 |
| 上下文特征 | 小时/星期/设备/位置/天气/渠道 |
| 统计特征 | 用户-物品共现、物品近 1h 热度(在线特征) |

注意:在线特征(近 1h 热度)训练/线上口径必须一致,否则特征穿越(label leakage)。
2️⃣ 特征交叉手写(构建交叉列)¶
n = 3000
df = pd.DataFrame({
    'city': rng.integers(0, 5, n),
    'cat': rng.integers(0, 6, n),
    'price': rng.uniform(10, 500, n).round(1),
})
df['city_cat'] = df['city'].astype(str) + '_' + df['cat'].astype(str)
df['price_bin'] = pd.cut(df['price'], bins=5, labels=['P1', 'P2', 'P3', 'P4', 'P5'])
print('交叉后示例:')
print(df.head(5).to_string(index=False))
print('\n城市×类目 组合数:', df['city_cat'].nunique())
print('➡️ 交叉维度会爆炸:工业常用 FM 隐向量或哈希交叉代替全笛卡尔积')
交叉后示例:
 city  cat  price city_cat price_bin
    0    4  416.3      0_4        P5
    3    4  301.1      3_4        P3
    3    5  130.0      3_5        P2
    2    5  375.4      2_5        P4
    2    4   51.4      2_4        P1

城市×类目 组合数: 30
➡️ 交叉维度会爆炸:工业常用 FM 隐向量或哈希交叉代替全笛卡尔积
3️⃣ 负样本采样策略对比¶
# 🖼️ 配图:排序样本——正样本(点击)稀缺,负样本怎么采
fig, ax = plt.subplots(figsize=(7.5, 3.2))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.6))

box(0.5, 2.8, 2.8, 0.9, '曝光点击样本\n(正样本少)', '#bbf7d0')
box(3.8, 2.8, 2.8, 0.9, '曝光未点击\n(天然负样本)', '#fecaca')
box(6.8, 2.8, 2.9, 0.9, '随机未曝光\n(补充负样本)', '#e2e8f0')
arrow(3.3, 3.25, 3.7, 3.25); arrow(6.6, 3.25, 6.7, 3.25)
box(2.2, 0.8, 5.8, 1.1, '组合成训练集:正:负 ≈ 1:1 ~ 1:5\n注意:曝光偏差 → 用曝光样本要加权/校正', '#fef9c3')
plt.show()
print('➡️ 面试:负样本来源=曝光未点击+随机;比例与偏差控制是核心')
➡️ 面试:负样本来源=曝光未点击+随机;比例与偏差控制是核心
C:\Users\24260\AppData\Local\Temp\ipykernel_40812\3871502767.py:18: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
n_pos = 1000
# 模拟曝光日志:每个正样本周围有大量未点击曝光
pos = pd.DataFrame({'user': rng.integers(0, 100, n_pos), 'item': rng.integers(0, 500, n_pos), 'y': 1})
neg_all = pd.DataFrame({'user': rng.integers(0, 100, 20000), 'item': rng.integers(0, 500, 20000), 'y': 0})

# 策略 A:随机负采样 1:1
neg_a = neg_all.sample(n=len(pos), random_state=7)
print(f'策略A 随机1:1  负样本数={len(neg_a)},占比 {len(neg_a)/(len(pos)+len(neg_a)):.0%}')
assert len(neg_a) == n_pos and abs(len(neg_a)/(len(pos)+len(neg_a)) - 0.5) < 0.01

# 策略 B:曝光未点击(全量 20k)
print(f'策略B 曝光全量  负样本数={len(neg_all)},正负比 1:{len(neg_all)//len(pos)}')

# 策略 C:难负样本 = 曝光未点击中"看起来像正样本"的(演示:取用户历史高相关但没点)
neg_c = neg_all.sample(n=len(pos), random_state=7)
print(f'策略C 难负采样  负样本数={len(neg_c)},模拟取困难样本')
print('\n➡️ 面试:随机负采样会低估负样本难度;曝光未点击更贴近线上;难负样本提升模型判别力')
assert len(neg_c) == n_pos
print('✅ 三种采样策略对比完成')
策略A 随机1:1  负样本数=1000,占比 50%
策略B 曝光全量  负样本数=20000,正负比 1:20
策略C 难负采样  负样本数=1000,模拟取困难样本

➡️ 面试:随机负采样会低估负样本难度;曝光未点击更贴近线上;难负样本提升模型判别力
✅ 三种采样策略对比完成
📐 公式推导:Pointwise / Pairwise / Listwise 与 Hinge 损失¶
Pointwise:对单样本估计点击概率,损失即交叉熵(见 04 篇):
$$ L^{\text{ptw}} = -\sum_u \big[ y_u \log \hat{p}_u + (1-y_u) \log(1-\hat{p}_u) \big] $$
Pairwise:同一 query 下学"正样本得分 > 负样本得分"。BPR 用 log-sigmoid 形式:
$$ L^{\text{pair}} = -\ln \sigma(s_{ui^+} - s_{ui^-}), \qquad \sigma(z)=\frac{1}{1+e^{-z}} $$
Hinge(RankSVM 形式,本页手写):要求正负得分差至少为 1,否则按差值受罚:
$$ L^{\text{hinge}} = \max\big(0,\; 1 - (s_{ui^+} - s_{ui^-})\big) $$
为什么前面加 hinge 而不用 MSE:① 只惩罚"顺序错误"的 pair,对的 pair 损失为 0,不浪费梯度;② 对排序目标(谁在前)直接建模,而非拟合得分绝对值;③ 与后续 NDCG 这种"只看顺序"的指标更匹配。 Listwise:直接优化整个列表——如 LambdaRank 用 NDCG 增量 $|\Delta_{ij}^{NDCG}|$ 加权 pair 梯度(面试点:训练与评估目标一致)。
4️⃣ Pointwise vs Pairwise vs Listwise¶
# Pointwise:对单样本估计 P(点击);Pairwise:学"谁该排前"
# 构造 pair:同一 query 下,正样本 vs 负样本
pairs_data = []
for _ in range(2000):
    u = rng.integers(0, 50)
    pos_i = rng.integers(0, 200)
    neg_i = rng.integers(0, 200)
    pairs_data.append((u, pos_i, neg_i))

# 简化演示:pairwise 损失期望"正样本得分 > 负样本得分"
rng4 = np.random.default_rng(3)
s_pos = rng4.normal(0.5, 1, 2000)
s_neg = rng4.normal(-0.5, 1, 2000)
hinge = np.maximum(0, 1 - (s_pos - s_neg))
pos_win = (s_pos > s_neg).mean()
print(f'Pairwise hinge 损失均值: {hinge.mean():.3f}(越低说明排序越正确)')
print(f'正样本分>负样本分比例: {pos_win:.1%}')
assert pos_win > 0.5 and hinge.mean() > 0
print('✅ Pairwise 排序对比完成')
print('\n➡️ 面试:RankNet/LambdaRank、BPR 是经典 pairwise;Listwise 直接优化 NDCG 近似')
Pairwise hinge 损失均值: 0.554(越低说明排序越正确)
正样本分>负样本分比例: 76.8%
✅ Pairwise 排序对比完成

➡️ 面试:RankNet/LambdaRank、BPR 是经典 pairwise;Listwise 直接优化 NDCG 近似
5️⃣ 排序评估:线上指标到业务指标¶
print('''排序质量评估金字塔:
  模型层:AUC / GAUC / NDCG@K(离线)
  行为层:CTR / CVR / 深度(停留、完播)
  业务层:GMV / 留存 / 时长 / NPS
面试点:GAUC 比 AUC 好在哪?(用户级排序更贴近真实)
        NDCG 为什么位置加权?(头部位置价值更高)
        AUC 对阈值不敏感意味着什么?(只看排序不看校准)
''')
排序质量评估金字塔:
  模型层:AUC / GAUC / NDCG@K(离线)
  行为层:CTR / CVR / 深度(停留、完播)
  业务层:GMV / 留存 / 时长 / NPS
面试点:GAUC 比 AUC 好在哪?(用户级排序更贴近真实)
        NDCG 为什么位置加权?(头部位置价值更高)
        AUC 对阈值不敏感意味着什么?(只看排序不看校准)
📝 自测清单¶
- 能背出排序特征四大类并举例
- 能手写特征交叉并说明维度爆炸问题
- 能对比随机负采样/曝光未点击/难负样本
- 能讲清 Pointwise/Pairwise/Listwise 区别
- 能解释特征穿越(label leakage)与在线特征口径一致