🐝 12-粒子群与蚁群算法¶
目标:掌握两类群体智能算法——粒子群 PSO(连续优化)与蚁群 ACO(组合优化)。 面试考点:PSO 三条更新项的含义、惯性权重、ACO 的转移概率与信息素更新、什么时候选哪类启发式。
§0 群体智能:个体简单,群体涌现¶
- PSO(粒子群):模拟鸟群觅食——每个粒子记「自己见过的最好位置」和「群体最好位置」,靠这两个拉力移动。 连续空间、导数信息可完全不用。
- ACO(蚁群):模拟蚂蚁觅食——蚂蚁沿信息素走,走短路的蚂蚁回程留下更多信息素 → 正反馈强化好路径。 天然适合图上找路径(TSP / 路由 / 调度)。
| PSO | ACO | |
|---|---|---|
| 解空间 | 连续 | 离散(图/排列) |
| 记忆 | 个人+群体的历史最优 | 集体记录在信息素矩阵 |
| 搜索机制 | 速度加权合成 | 概率转移 + 信息素蒸发/沉积 |
| 适用 | 连续优化 / 超参搜索 | TSP / 网络路由 / 装箱 |
核心概念¶
(a) 🗂️ 粒子群与蚁群算法知识地图¶
这篇讲"个体简单、群体涌现"的群体智能:粒子群优化(PSO)让粒子被惯性和 pbest/gbest 拉着飞,蚁群算法(ACO)让蚂蚁靠信息素正反馈找到好路,并以 Rastrigin 和 TSP 验证。
flowchart TB
    Node1["🧠 群体智能涌现"]
    Node1 --> Node2["🧠 PSO 三件套"]
    Node2 --> Node3["🧠 速度更新公式"]
    Node3 --> Node4["🧠 pbest / gbest"]
    Node4 --> Node5["🧠 ACO 信息素"]
    Node5 --> Node6["🧠 启发信息 η"]
    Node6 --> Node7["🧠 蒸发与沉积"]
    Node7 --> Node8["🧠 正反馈回路"]
    Node8 --> Node9["🧠 选型总表"]
- 节点1(群体智能涌现):每个个体只按简单规则行动,群体却涌现出全局搜索能力:鸟群、蚁群、鱼群都是例子,Rastrigin 函数(满是局部谷)是它们的试金石。
- 节点2(PSO 三件套):每个粒子维护位置 x(候选解)、速度 v(移动方向和步长)、个体最优 pbest(自己的记忆),外加群体共享的 gbest(全局最好位置)。
- 节点3(速度更新公式):v ← w·v + c1·r1·(pbest−x) + c2·r2·(gbest−x):惯性项保持原方向,认知项拉向自己的最好,社会项拉向群体的最好,三条力加权合成。
- 节点4(pbest / gbest):惯性权重 w 从 0.9 线性降到 0.4(先全局搜索后局部收敛);pbest 管"个人经验",gbest 管"社会共识",两者平衡决定探索与利用。
- 节点5(ACO 信息素):蚁群算法用边上的信息素 τ(i,j) 当"社会记忆":好边信息素浓,蚂蚁更爱走;这是 ACO 区别于 PSO 的关键——记忆写在"环境"里而不是个体里。
- 节点6(启发信息 η):η(i,j) = 1/d(i,j),距离越近越吸引,是先验贪心;蚂蚁选下一城的概率 P ∝ τ^α·η^β,α 控制跟随信息素,β 控制贪心距离。
- 节点7(蒸发与沉积):每轮结束先蒸发 τ ← (1−ρ)τ 防止无限累积(让系统忘掉旧信息),再沉积 τ += Q/L(环越短的蚂蚁给的越多)——一收一放构成正反馈。
- 节点8(正反馈回路):好路信息素浓 → 更多蚂蚁走 → 信息素更浓,正反馈让群体锁定好解;坏路逐渐被蒸发淘汰,这就是"涌现"的机制。
- 节点9(选型总表):PSO 适合连续实值优化(快、参数少),ACO 适合组合优化(TSP 类),GA 居中;选型总表按问题类型直接查,面试常考"什么时候用哪个启发式"。
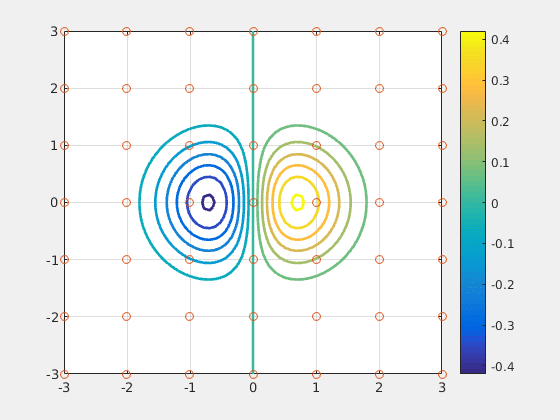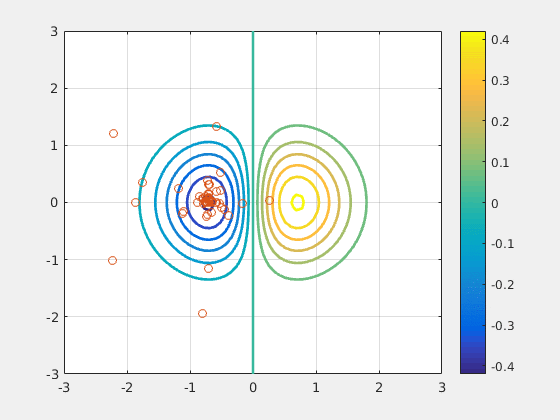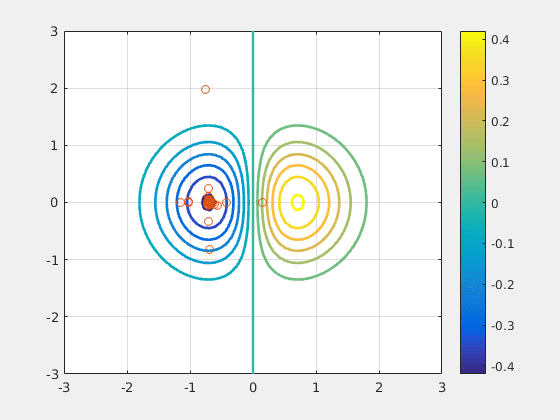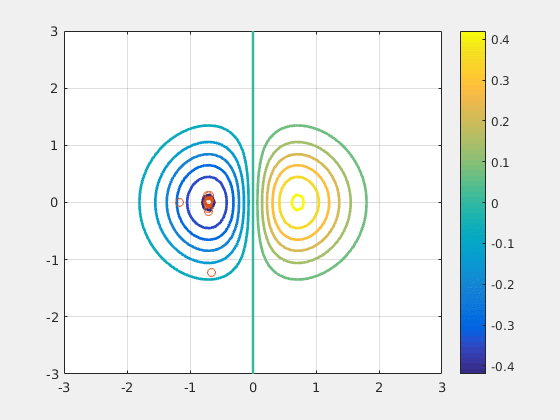
§0.1 配图:粒子群的运动动画¶
先看两个直观动画,建立「粒子集群运动」的画面感:
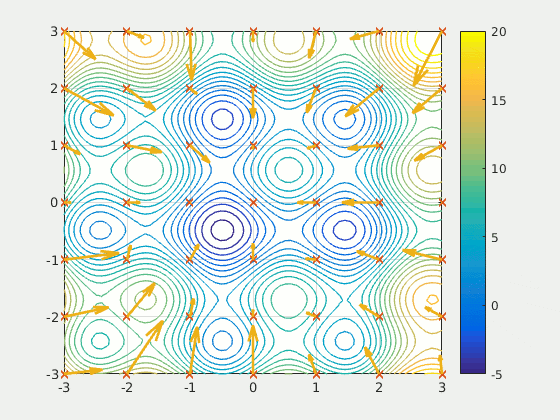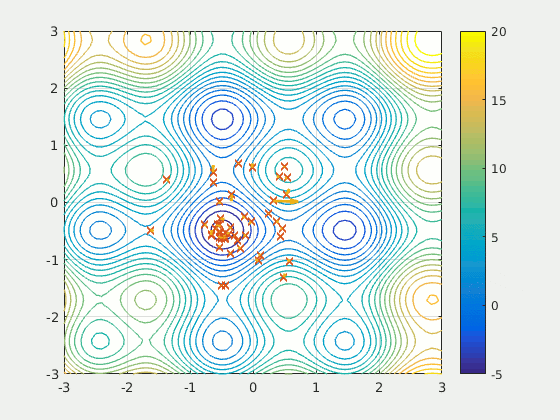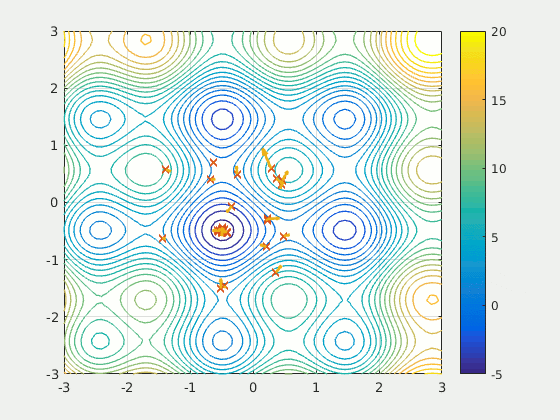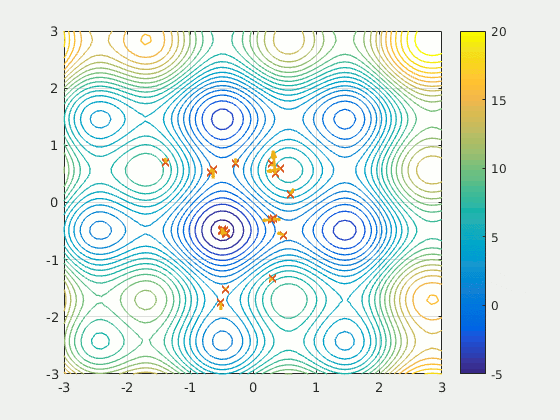
图注:粒子群在二维函数上搜索的箭矢动画——每个箭头的方向 = 惯性+认知+社会三项合力 (来源:Wikimedia Commons,CC BY-SA 4.0)。粒子受 pbest/gbest 牵引聚向极值点。
图注:PSO 在 Rastrigin 型函数上收敛到全局最优的动画——粒子群像鸟群一样 先散开探索再聚拢精化(来源:Wikimedia Commons,CC BY-SA 4.0)。
从动画能读出的三条物理直觉:
- 前期粒子分散(w 大 → 惯性主导 → 探索);
- 中期出现「信息汇聚」——一旦某粒子发现好位置,周围粒子被 gbest 吸引过来;
- 后期全体围绕极值点精细震荡(w 小 → 局部开发)。
🧩 这正是「个体简单、群体涌现」的教科书演示:单个粒子只会朝三个方向加权移动, 但一群粒子通过 gbest 共享信息后,整体像有「大脑」一样收敛。
§0.2 PSO 公式逐项拆解(面试必备)¶
速度更新公式(每个维度独立):
$$v_i^{(t+1)} = w\,v_i^{(t)} + c_1 r_1\big(pbest_i - x_i^{(t)}\big) + c_2 r_2\big(gbest - x_i^{(t)}\big),\qquad x_i^{(t+1)} = x_i^{(t)} + v_i^{(t+1)}$$
| 项 | 名称 | 作用 | 直觉 |
|---|---|---|---|
| $w v$ | 惯性项 | 保持原方向 | 动量:不轻易转向,穿越平坦区域 |
| $c_1 r_1(pbest-x)$ | 认知项 | 拉回自己历史最优 | 「我记住的好位置」 |
| $c_2 r_2(gbest-x)$ | 社会项 | 拉向群体最优 | 「大家发现的好位置」 |
- $c_1,c_2$:加速度常数(通常 1.5~2),决定「个人 vs 群体」谁拉力大;
- $r_1,r_2\in[0,1]$:随机系数 → 让搜索有随机性(多样性),避免全体同步;
- 惯性权重 $w$:0.9→0.4 线性递减是最经典策略——前期探索、后期开发。
📌 面试快速表达:PSO = 「带记忆的动量法」——没有梯度,只有目标值 + 两个记忆指针。 和 SGD 的动量对比:SGD 动量只记得自己的历史方向,PSO 还记得群体历史最优。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# ---------- 测试函数:Rastrigin(2D,全局最优 0 @ (0,0),四周全是局部谷,SA/GA 都容易卡) ----------
def rastrigin(x):
    # f(x) = A·d + Σ (x_i² - A·cos(2π x_i)),A=10
    # 线性项 x_i² 把全局推向原点;余弦项造出一排排周期性的局部谷 → 多峰陷阱
    A = 10.0
    x = np.asarray(x, float)
    return A * len(x) + np.sum(x ** 2 - A * np.cos(2 * np.pi * x))

# ================= 手写粒子群优化(PSO) =================
# 每个粒子 i 维护三样东西:
#   位置 x_i     —— 当前候选解
#   速度 v_i     —— 移动方向和步长
#   个体最优 pbest_i —— 自己历史见过的最好位置(“记忆”)
# 再加上群体共享的 gbest(全局最好位置)。
#
# 速度更新 = 三条力的加权合成:
#   v ← w·v                 (1) 惯性项:保持原速度方向。惯性权重 w 从 0.9 线性降到 0.4
#                                = 前期大范围探索 → 后期局部精细收敛
#      + c1·r1·(pbest - x)  (2) 认知项:拉回自己历史最好位置(自私记忆)
#      + c2·r2·(gbest - x)  (3) 社会项:拉向群体最好位置(信息共享 = 协作牵引)
# 位置更新:x ← x + v(欧拉积分)
def pso(iters=120, n_particles=40, w0=0.9, w1=0.4, c1=1.5, c2=1.5, seed=0):
    r = np.random.default_rng(seed)
    dim = 2
    x = r.uniform(-4.5, 4.5, size=(n_particles, dim))   # 初始位置:搜索范围内均匀随机
    v = r.uniform(-1, 1, size=(n_particles, dim))       # 初始速度:小随机
    pbest = x.copy()                                    # 个体最优初值 = 自己初始位置
    gbest = x[np.argmin([rastrigin(p) for p in x])]     # 群体最优 = 初始里最好的粒子
    hist = []
    for t in range(iters):
        w = w0 + (w1 - w0) * t / iters                  # 惯性线性递减 0.9→0.4(先探索后开发)
        r1 = r.random(size=(n_particles, dim))          # 认知项的随机系数(随机性=多样性)
        r2 = r.random(size=(n_particles, dim))          # 社会项的随机系数
        v = w * v + c1 * r1 * (pbest - x) + c2 * r2 * (gbest - x)   # 三条力合成新速度
        x = x + v                                       # 按速度移动位置
        for i in range(n_particles):                    # 逐粒子更新个体最优
            if rastrigin(x[i]) < rastrigin(pbest[i]):
                pbest[i] = x[i]
        gi = int(np.argmin([rastrigin(p) for p in pbest]))   # 找 pbest 里最好的那个粒子
        if rastrigin(pbest[gi]) < rastrigin(gbest):   # 若它超过全局最优 → 更新 gbest
            gbest = pbest[gi].copy()
        hist.append(rastrigin(gbest))
    return gbest, np.array(hist)

g_best, pso_hist = pso()
print('PSO 找到: x =', np.round(g_best, 4), ' f = %.4f(全局最优 0 @ (0,0))' % rastrigin(g_best))
assert rastrigin(g_best) < 1e-6     # 必须收敛到全局最优(Rastrigin 多峰也不怕)

# ========== 图:地形 + 收敛 ==========
gx = np.linspace(-4.5, 4.5, 220); gy = np.linspace(-4.5, 4.5, 220)
Zg = np.array([[rastrigin([a, b]) for a in gx] for b in gy])   # 网格目标值(画等高线用)
fig, ax = plt.subplots(1, 2, figsize=(11.5, 4.4))
cf = ax[0].contourf(gx, gy, Zg, levels=18, cmap='viridis_r')
fig.colorbar(cf, ax=ax[0], shrink=0.85)
ax[0].plot(g_best[0], g_best[1], '*', ms=15, color='white', label='gbest (%.3f, %.3f)' % tuple(g_best))
ax[0].set_title('Rastrigin 地形(大量局部谷)', fontsize=12)
ax[0].legend(fontsize=9, loc='upper right')
ax[1].plot(pso_hist, lw=1.8, color='#C44E52')
ax[1].set_yscale('log')             # 目标值指数级下降 → 对数轴更直观
ax[1].set_title('PSO 收敛曲线(Rastrigin 2D 最小化 → 0)', fontsize=12)
ax[1].set_xlabel('迭代'); ax[1].set_ylabel('gbest 目标值 (log)')
plt.tight_layout(); plt.show()
§1 PSO 参数与改进¶
标准参数:$c_1=c_2\approx 1.5\sim2$,$w$:0.9→0.4 线性递减;种群 20~50。 经典变体:
- 惯性权重法(本讲):$w$ 大→全局探索,$w$ 小→局部开发;递减模拟「先广后精」
- 收缩因子法(Clerc):$\chi$ 缩放整条速度,形式 $v\leftarrow\chi(v+c_1 r_1(p-x)+c_2 r_2(g-x))$,理论保证收敛
- 全局版 vs 局部版:只用邻域内最优(环拓扑)→ 抗早熟
- 约束处理:罚函数 / 速度+位置边界钳制 / 重新随机
为什么 PSO 快:不需要梯度,只需要目标值;粒子间通过 gbest 隐式共享信息(协作), 比独立多次随机重启的「蛮力」效率高得多(本讲收敛到 0 就是证据)。
§1.1 PSO 手算:一次速度更新的完整过程¶
设一维粒子当前 $x=2.0$,$v=0.5$,$pbest=1.0$,$gbest=0.5$,$w=0.8$,$c_1=c_2=1.5$, 随机系数取 $r_1=0.6,\ r_2=0.4$(只是举例,实际每次随机):
$$v' = 0.8\times 0.5 + 1.5\times 0.6\times(1.0-2.0) + 1.5\times 0.4\times(0.5-2.0)$$ $$= 0.4 + (-0.9) + (-0.9) = -1.4$$ $$x' = 2.0 + (-1.4) = 0.6$$
解读:惯性让粒子还想往前(+0.4),但 pbest 在左边(-0.9)和 gbest 在左边(-0.9) 把它强力拉回——三个力合成后粒子从 2.0 大幅向左移到 0.6,接近 gbest=0.5。
若 $w$ 更大(如 1.2):$v'=0.6-0.9-0.9=-1.2$,仍向左但略慢 → 探索倾向更强。
📌 手算要点:先把三「力」分别算出来再加;注意 pbest-x 与 gbest-x 的符号决定了 拉的方向。面试若让口算,代数字进去三步出结果即可。
§1.2 PSO 调参与变体(实战参数表)¶
| 参数 | 推荐值 | 调大 → | 调小 → |
|---|---|---|---|
| 惯性 $w$ | 0.9→0.4 递减 | 探索强、收敛慢 | 开发强、易早熟 |
| 认知 $c_1$ | 1.5~2 | 粒子更恋旧(个人主义) | 群体主导 |
| 社会 $c_2$ | 1.5~2 | 群体牵引强(从众) | 群体弱协作 |
| 种群数 | 20~50 | 覆盖好、每代慢 | 多样不足 |
| 速度上限 $v_{max}$ | 搜索范围的 10~20% | 大步穿越 | 过小卡死 |
PSO 常见变体:
- 收缩因子法(Clerc):$v'=\chi[v + c_1r_1(p-x)+c_2r_2(g-x)]$,$\chi<1$ 保证收敛;
- 局部版 PSO:每粒子只用邻域拓扑(环/网格)内的 gbest → 抗早熟,多峰更稳;
- 离散 PSO:位置取整/二进制化 → 用于特征选择、调度;
- 混合 PSO:与局部搜索(如 2-opt)混合,先 PSO 探索再 LS 精化——TSP 常见。
PSO 的应用:连续黑箱优化(天线设计、控制器参数整定)、神经网络权重/结构搜索、 超参调优、以及「无梯度」场景(仿真器优化)。
📌 面试对比题「PSO vs GA」:PSO 用 pbest/gbest 两个记忆指针(信息少、收敛快、易早熟); GA 用种群重组(信息多、全局强、慢)。连续空间 PSO 更快,离散排列 GA/ACO 更顺手。
# ================= 手写蚁群算法(ACO)求解 TSP =================
# 两个核心量:
#   信息素 τ(i,j):边 (i,j) 的“社会记忆”,好边信息素浓
#   启发信息 η(i,j) = 1/d(i,j):距离的倒数,近的边天然更吸引(先验贪心)
# 蚂蚁 k 在 i 处选下一城 j 的概率(轮盘赌采样):
#   P(i→j) ∝ τ(i,j)^α · η(i,j)^β
#   α 越大越跟随信息素(正反馈),β 越大越贪心距离(先验)
# 一轮结束后:
#   蒸发:τ ← (1-ρ)τ            —— 防止信息素无限累积,让系统“忘掉”旧信息
#   沉积:τ(i,j) ← τ(i,j) + Q/L —— 走完环长 L 越短的蚂蚁,给走过的边加得越多(正反馈!)
Nc = 14
r4 = np.random.default_rng(4)
cities = r4.random((Nc, 2)) * 10
dist = np.sqrt(((cities[:, None, :] - cities[None, :, :]) ** 2).sum(-1))
np.fill_diagonal(dist, np.inf)      # 自己到自己的距离设无穷:防止蚂蚁原地打转

def tour_len(order):
    return sum(dist[order[i], order[(i + 1) % Nc]] for i in range(Nc))

def aco(ants=50, iters=80, alpha=1.0, beta=5.0, rho=0.5, q=10, seed=0):
    r = np.random.default_rng(seed)
    tau = np.ones((Nc, Nc))         # 信息素初始均匀为 1(无先验偏好)
    np.fill_diagonal(tau, 0)        # 自己到自己不存信息素
    eta = 1.0 / dist                # 启发信息预计算:1/距离(距离为 inf 的位置是 0,蚂蚁不去)
    best_len = np.inf; best_tour = None; hist = []
    for it in range(iters):
        all_tours = []
        for a in range(ants):
            start = int(r.integers(0, Nc))
            un = set(range(Nc)); un.discard(start)
            tour = [start]
            while un:
                i = tour[-1]
                cand = list(un)
                # 转移概率:τ^α · η^β 归一化成概率分布,再按分布轮盘赌抽一城
                p = tau[i, cand] ** alpha * eta[i, cand] ** beta
                p = p / p.sum()
                j = cand[int(r.choice(len(cand), p=p))]
                tour.append(j); un.discard(j)
            all_tours.append((tour, tour_len(tour)))
        tau = tau * (1 - rho)       # ① 蒸发:整张表统一乘 (1-ρ)
        for tour, L in all_tours:   # ② 沉积:每只蚂蚁给自己走的边加 Q/L
            for k in range(Nc):
                i, j = tour[k], tour[(k + 1) % Nc]
                tau[i, j] += q / L  # 环长越短 → 加得越多 → 下一轮更招蚂蚁 → 正反馈
                tau[j, i] += q / L
        bt = min(all_tours, key=lambda t: t[1])     # 记录本次迭代最好蚂蚁
        if bt[1] < best_len:
            best_len = bt[1]; best_tour = bt[0]
        hist.append(best_len)
    return best_tour, best_len, np.array(hist)

aco_tour, aco_len, aco_hist = aco()
print('ACO 最优环长: %.2f' % aco_len)

# ---------- 对照:最近邻贪心基线 ----------
def nearest_neighbor():
    best = np.inf
    for s in range(Nc):                             # 每个城市都当起点试一遍
        un = set(range(Nc)); un.discard(s)
        cur = [s]
        while un:
            nxt = min(un, key=lambda j: dist[cur[-1], j])   # 每次都去最近的未访问城市
            cur.append(nxt); un.discard(nxt)
        best = min(best, tour_len(cur))
    return best

nn_len = nearest_neighbor()
print('最近邻基线: %.2f' % nn_len)
assert aco_len < nn_len          # ACO 必须优于贪心基线(正反馈找到了更短的环)

# ========== 图:路径 + 收敛 ==========
fig, ax = plt.subplots(1, 2, figsize=(11.5, 4.4))
ax[0].plot(cities[:, 0], cities[:, 1], 'o', color='#4C72B0')
o = aco_tour + [aco_tour[0]]              # 闭合环(末尾补回起点)
ax[0].plot(cities[o, 0], cities[o, 1], '-', color='#C44E52', lw=1.5)
ax[0].set_title('ACO 找到的 TSP 路径(环长 %.2f)' % aco_len, fontsize=12)
ax[0].grid(alpha=0.3)
ax[1].plot(aco_hist, lw=1.6, color='#C44E52')
ax[1].set_title('ACO 收敛:信息素正反馈逐步强化好边', fontsize=12)
ax[1].set_xlabel('迭代'); ax[1].set_ylabel('最优环长')
ax[1].grid(alpha=0.3)
plt.tight_layout(); plt.show()
§2.1 ACO 正反馈回路:一轮完整循环¶
ACO 的「涌现」来自一个自增强回路,面试把它讲圆就赢了:
蚂蚁按 τ^α·η^β 概率选路 → 短环蚂蚁回程早、沉积 Q/L 更多
   → 短边信息素更浓 → 下轮更多蚂蚁选短边 → 短环更频繁出现 → 信息素更浓(正反馈)
两个平衡机制防止失控:
- 蒸发 ρ:每轮信息素 ×(1-ρ),让旧信息衰减——否则系统「死记」最初的随机好边;
- α/β 平衡:α 大 → 群体跟随过强(早熟);β 大 → 太贪心(接近最近邻启发式)。
收敛曲线读法(本讲右侧图):前期波动大(蚂蚁在乱试),中后期阶梯下降 (好边信息素累积 → 更多蚂蚁走 → 更短的环),最终稳定。
🧩 类比记忆:ACO = 「蚂蚁的群体梯度下降」——信息素是隐式的搜索方向估计, 蒸发是学习率衰减,Q/L 沉积是正比于改进幅度的「奖励」。
§2 ACO 细节与改进¶
- α、β 的平衡:α 大(跟随群体)→ 收敛快易早熟;β 大(贪心)→ 接近最近邻。
- ρ 蒸发率:ρ 太小信息素残留 → 早熟;ρ 太大忘得快 → 接近随机搜索。常取 0.5 左右。
- 精英蚂蚁 / 排名:只让全局最优的蚂蚁排外沉积更多 → 收敛加速(ACS:给最优边额外加)。
- MMAS(最大最小蚁群):把 τ 限制在 [τ_min, τ_max] 防早熟 —— 工业常用。
- ACO vs GA 在 TSP 上:ACO 用「路径增量」信息(边),GA 用「排列交叉」;ACO 倾向于更快找到好环(正反馈),GA 全局搜索能力强。
§2.2 ACO 的工业应用(不止 TSP)¶
ACO 是「图上正反馈」的通用框架,换图换含义就能用:
- 网络路由:通信网络动态路由——信息素=链路质量,蚂蚁=探测包(AntNet 系列);
- 车辆路径 VRP:带容量/时间窗的配送路径(TSP 的多车扩展);
- 调度排产:作业车间调度(JSP)——序列 + 机器分配在同一张图上;
- 特征选择:特征作为节点,蚂蚁选特征子集,信息素表示特征组合价值。
ACO 的独特优势:增量构造解(蚂蚁一步一步搭路径),天然适合 「约束在构造过程中检查」的问题(如容量约束),这是 GA 需要惩罚函数的地方。
📌 面试对比题「ACO vs GA 谁适合 TSP」:ACO 记录的是边级信息(哪两城近值得走), GA 记录的是个体级信息(整条排列);ACO 收敛快但可能早熟,GA 全局搜索强但慢。 现代做法常用两者混合(ACO 构造初始解 → GA/LS 精化)。
§3 选型总表:什么时候用哪个启发式¶
| 场景 | 推荐 | 理由 |
|---|---|---|
| 连续、黑箱、多峰 | PSO / GA | 不需要梯度,多峰不卡 |
| TSP / 路由 / 调度 | ACO / GA / SA+2-opt | 问题天然是图/排列 |
| 有成熟贪心构造法可用 | ACO / 模拟退火+局部搜索 | 好初始解加速收敛 |
| 时间极紧、要稳定 | 模拟退火 / 禁忌搜索 | 单点内存小、步数可控 |
| 要最优解保证 | 分支定界 / MILP 求解器(08/09 篇) | 启发式只保证“好”,不保证“最优” |
面试套路:先问问题性质(连续/离散?有没有梯度?规模?要最优还是近似?)→ 再锁定算法家族。
§4 面试追问与自测¶
- PSO 三条更新项各代表什么?惯性权重递减为什么好?
- ACO 转移概率为什么用 τ^α·η^β?蒸发率 ρ 太大小分别会怎样?
- PSO vs ACO 适用场景差异?(连续 vs 离散)
- 群体智能为什么“协作”比独立多开枪更高效?(正反馈/信息共享)
- 什么时候不能用启发式?(要求最优保证 → 精确方法)
自测清单
- 手写 PSO 速度/位置更新(含 w 递减 + pbest/gbest 更新)
- 手写 ACO 转移概率 + 蒸发/沉积,跑通 TSP
- 说出信息素正反馈的一轮完整回路(走路→评价→沉积→吸引)
- 默写选型总表
💡 下节预告:约束优化的理论基石——13 拉格朗日对偶与 KKT。