00-数学基础 · 线性代数¶
秋招算法岗 / 机器学习岗数学地基 · 第 2 篇 读完这篇,你能用大白话解释:内积为什么是相似度打分器、Wx+b 在干什么、特征值/SVD 是什么、PCA 和 Transformer 注意力怎么"长在"线性代数上。 全程中文、公式配 LaTeX、代码用 numpy 从零实现,可放心跟着跑。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 一条样本有几百个特征,怎么用一套统一的符号表示和计算? | 向量、矩阵与内积 |
| 神经网络一层 y = Wx + b 到底在数据上做了什么? | 矩阵与线性变换、矩阵乘法视角 |
| Transformer 注意力"这个词和那个词有多像"怎么量化? | 内积、余弦相似度与范数 |
| 数据冗余严重,怎么找到最重要的方向并降维? | 秩、特征值分解、SVD 与 PCA |
| 权重矩阵会"放大"哪个方向?优化与初始化里怎么用? | 特征值与奇异值、谱性质 |
故事引入:一张表格引发的"降维"之旅¶
假设你是班主任,要记住全班 40 位同学:每人记 5 个数字——身高、体重、鞋码、语文成绩、数学成绩。把同学们排成行、科目排成列,就得到一张 40×5 的表格,这就是矩阵。你想"用更少的数字描述全班",于是画散点图,发现身高和鞋码几乎完全相关(高个子鞋码普遍大)——这说明表格里很多信息是重复的(在数学上叫线性相关)。
你开始思考:能不能构造一个新的"综合指标",比如"体型指数 = 0.8×身高 + 0.6×鞋码",让全班在这个指标上的差异最大?这个方向就是数据的主方向,数学上由协方差矩阵的特征向量给出;把它找出来、把数据投影上去、扔掉次要方向——这就是 PCA(主成分分析)。
再把故事搬到语言里:Transformer 想让"猫"这个词去吸收"可爱""动物"这些词的信息。它怎么判断该吸收谁?——把每个词变成一个向量,算任意两个向量的内积:内积大 = 方向接近 = 语义相似,于是"猫"就从最相似的词那里吸收信息。内积、矩阵、特征向量、SVD——这四样东西,就是现代深度学习的"空间语言"。
核心概念¶
(a) 🗂️ 线性代数 · 知识结构树¶
线性代数讲的是"多维空间里怎么描述、怎么变换、怎么拆解"。从向量出发,一步步长成矩阵、特征分解和 SVD,最后都落到 PCA 和 Transformer 上。
flowchart TB
    A["🧠 向量与内积<br/>空间中的箭头与夹角"] --> B["🧠 范数与距离<br/>长度与相似度"]
    A --> C["🧠 矩阵与线性变换<br/>对向量做映射"]
    C --> D["🧠 矩阵乘法视角<br/>行/列/外积三种看法"]
    C --> E["🧠 秩<br/>有效信息维度"]
    E --> F["🧠 逆矩阵<br/>把变换变回去"]
    C --> G["🧠 特征值与特征向量<br/>变换的不变方向"]
    G --> H["🧠 特征值分解<br/>把矩阵拆成三件套"]
    H --> I["🧠 SVD<br/>任意矩阵的万能分解"]
    D --> I
    I --> J["🧠 应用:PCA 与 Transformer<br/>降维与注意力"]
- 向量与内积:向量是"带方向的箭头",内积衡量两个箭头"同向到什么程度";Transformer 注意力打分就是内积。
- 范数与距离:范数是向量的长度,L2/L1 分别对应欧氏距离与"出租车距离";正则化里的 L1/L2 惩罚就是它。
- 矩阵与线性变换:矩阵乘以向量 = 对向量做旋转、缩放、错切;神经网络一层 Wx 就是线性变换(+b 是平移)。
- 矩阵乘法视角:C=AB 可以看成"C 的行是 B 的行的线性组合",也可以看成"C 的列是 A 的列的线性组合",还能拆成外积矩阵的求和——三个视角各有妙用。
- 秩:矩阵里真正独立的"信息条数";秩亏说明信息冗余、不可逆。
- 逆矩阵:把变换"撤销"的操作;只有满秩方阵才有逆,解线性方程组 Ax=b 就是 x=A⁻¹b。
- 特征值与特征向量:对非零向量 v,如果 Av=λv,说明 v 的方向在变换中不变、只被拉伸 λ 倍;它揭示矩阵的"本性"。
- 特征值分解:可对角化矩阵 A = PΛP⁻¹,等于把矩阵拆成"方向 + 拉伸量 + 方向复原"三段。
- SVD:任何矩阵都能写成 A = UΣVᵀ,同时找到"行方向主成分"和"列方向主成分",是 PCA、压缩、推荐系统的共同底座。
- 应用:PCA 与 Transformer:PCA 用 SVD 找最大方差方向来降维;Transformer 用内积打分、用矩阵乘法做信息融合。
深入原理¶
下面 6 个小节,每个都按同一套路讲:先给大白话直觉 → 再给严格公式 → 再走一遍关键推导 → 最后一句"面试怎么问"。线性代数看着符号多,其实每个概念都对应一个非常具体的几何画面。
1. 向量、内积与余弦相似度¶
大白话直觉:向量就是"带方向、有长度的箭头"。内积 $\boldsymbol{a}\cdot\boldsymbol{b}$ 回答一个问题:"$\boldsymbol{b}$ 在 $\boldsymbol{a}$ 的方向上贡献了多少?"两个箭头几乎同向时内积很大,几乎垂直时内积接近 0——所以内积天生就是相似度打分器,Transformer 注意力就是拿它打分。
公式:
$$ \boldsymbol{a} \cdot \boldsymbol{b} = \sum_{i=1}^{n} a_i b_i = \|\boldsymbol{a}\| \, \|\boldsymbol{b}\| \cos\theta $$
关键推导步骤(用余弦定理推出坐标形式):
- 对二维向量 $\boldsymbol{a}=(a_1,a_2)$、$\boldsymbol{b}=(b_1,b_2)$,夹角 $\theta$,由余弦定理:$\|\boldsymbol{a}-\boldsymbol{b}\|^2 = \|\boldsymbol{a}\|^2 + \|\boldsymbol{b}\|^2 - 2\|\boldsymbol{a}\|\|\boldsymbol{b}\|\cos\theta$;
- 把模长平方展开:$\|\boldsymbol{a}-\boldsymbol{b}\|^2 = (a_1-b_1)^2 + (a_2-b_2)^2 = a_1^2 + b_1^2 + a_2^2 + b_2^2 - 2(a_1b_1 + a_2b_2)$;
- 与余弦定理联立、消去模长平方项,得到 $a_1b_1 + a_2b_2 = \|\boldsymbol{a}\|\|\boldsymbol{b}\|\cos\theta$——内积公式成立(高维同理)。
- 余弦相似度 = $\dfrac{\boldsymbol{a}\cdot\boldsymbol{b}}{\|\boldsymbol{a}\|\|\boldsymbol{b}\|}$,只关心方向、不关心长度,Embedding / 文本相似度常用它。
在 ML 中:注意力打分 $s_{ij} = \boldsymbol{q}_i \cdot \boldsymbol{k}_j$(内积),除以 $\sqrt{d}$ 缩放后过 softmax 得到权重——内积越大,融合的信息越多。
面试怎么问:"Transformer 里为什么要点积除以 √d?"——$d$ 维随机向量点积的方差约为 $d$,除以 $\sqrt{d}$ 把方差拉回 $O(1)$,softmax 不饱和、梯度更稳。
2. 矩阵与线性变换、矩阵乘法的三种视角¶
大白话直觉:矩阵乘向量 = 对向量做一次"线性变换":旋转、拉伸、压缩、错切,但原点不动、直线仍是直线。神经网络一层 y = Wx + b:Wx 是线性变换,+b 是平移。而矩阵乘法的关键在于三个视角,换个视角看同一件事,很多公式豁然开朗。
视角一(行视角 / 内积视角):C=AB 的第 i 行、第 j 列 = A 第 i 行与 B 第 j 列做内积:
$$ (AB)_{ij} = \sum_{k} A_{ik} B_{kj} $$
视角二(列视角 / 线性组合视角):C 的第 j 列 = A 作用于 B 的第 j 列:$C_{:,j} = A\,B_{:,j}$——"A 把 B 的每一列都变换了一次"。 视角三(外积求和视角):C 是若干"列 × 行"外积矩阵的叠加:
$$ AB = \sum_{k=1}^{n} \boldsymbol{a}_{:,k}\, \boldsymbol{b}_{k,:} $$
关键推导(外积视角怎么来):把 A 按列分块、B 按行分块:
$$ AB = \begin{bmatrix} \boldsymbol{a}_1 & \cdots & \boldsymbol{a}_n \end{bmatrix} \begin{bmatrix} \boldsymbol{b}_1^\top \\ \vdots \\ \boldsymbol{b}_n^\top \end{bmatrix} = \sum_{k=1}^{n} \boldsymbol{a}_k \boldsymbol{b}_k^\top $$
每个 $\boldsymbol{a}_k \boldsymbol{b}_k^\top$ 都是秩 1 矩阵——这直接解释了为什么 SVD 能把矩阵写成"秩 1 矩阵的加权和"。
面试怎么问:"C=AB 为什么说 B 的每一列都被 A 变换了一次?"——列视角:C 的第 j 列就是 A 乘以 B 的第 j 列向量,神经网络逐列处理 batch 就是这个过程。
3. 范数与距离:L1、L2 与正则化¶
大白话直觉:范数就是"向量有多长"。L2 范数是欧氏距离(两点间直线距离),L1 范数是"出租车距离"(只能横着竖着走)。在机器学习里,正则化项 $\|w\|_1$ 或 $\|w\|_2^2$ 就是在损失里给"太嚣张的权重"加罚金。
公式:
$$ \|\boldsymbol{x}\|_2 = \sqrt{\sum_i x_i^2}, \qquad \|\boldsymbol{x}\|_1 = \sum_i |x_i|, \qquad \|\boldsymbol{x}\|_\infty = \max_i |x_i| $$
关键推导直觉(为什么 L1 产生稀疏、L2 不产生):
- 加罚后的目标:$\min_w \text{Loss}(w) + \lambda \|w\|_p$;
- 从等高线几何看:L1 的等值面是"菱形"(带尖角),最优解常常落在坐标轴上 → 很多 $w_i = 0$(稀疏,等于在做特征选择);
- L2 的等值面是"圆"(处处光滑),最优解几乎不会恰好落在轴上 → 权重整体变小但不为 0(收缩);
- 所以 Lasso(L1)做特征选择,Ridge(L2)做收缩,Elastic Net 两者结合。
面试怎么问:"L1 为什么能产生稀疏解?"——用"菱形等高线的尖角更容易落在坐标轴上"这个几何直觉回答最经典。
4. 秩与逆矩阵¶
大白话直觉:矩阵的秩 = 矩阵里"真正独立的信息条数"。全班 40 人记 5 个指标,如果身高永远等于 2×鞋码,那么身高这一列是"多余的",真实信息是 4 维,秩 = 4。逆矩阵 = "撤销操作":先乘 A 再乘 A⁻¹,等于什么都没做。只有"满秩的方阵"(信息没丢)才可逆。
公式:
$$ A\boldsymbol{x} = \boldsymbol{b} \;\Rightarrow\; \boldsymbol{x} = A^{-1}\boldsymbol{b}, \qquad A^{-1}A = AA^{-1} = I $$
关键推导(2×2 逆矩阵公式):对 $A = \begin{bmatrix}a & b \\ c & d\end{bmatrix}$:
- 先用行列式判断可逆:$\det(A) = ad - bc \neq 0$;
- 逆矩阵为 $A^{-1} = \dfrac{1}{ad-bc}\begin{bmatrix}d & -b \\ -c & a\end{bmatrix}$(伴随矩阵除以行列式);
- 验证:$AA^{-1} = \dfrac{1}{ad-bc}\begin{bmatrix}ad-bc & 0 \\ 0 & ad-bc\end{bmatrix} = I$,确实互为逆。
在 ML 中:线性最小二乘的闭式解 $\hat{\boldsymbol{w}} = (X^\top X)^{-1} X^\top \boldsymbol{y}$;当 $X^\top X$ 不可逆(特征相关或样本不足)时,加 $\lambda I$ 变成岭回归 $(X^\top X + \lambda I)^{-1}$,或者直接使用伪逆 $X^+$。
面试怎么问:"$X^\top X$ 不可逆怎么办?"——三个答案:加正则化(岭回归)、用伪逆、删冗余特征 / 先降维。
5. 特征值与特征向量、特征值分解¶
大白话直觉:一个矩阵像一台"变形机器"。绝大多数向量被它转得七荤八素,但总有那么几个方向,向量被它作用后方向不变、只是被拉长/压缩——这些方向叫特征向量,拉长/压缩的倍数叫特征值。抓住这些方向,就抓住了矩阵的"性格"。
公式:
$$ A\boldsymbol{v} = \lambda \boldsymbol{v}, \quad \boldsymbol{v} \neq \boldsymbol{0}; \qquad A = P \Lambda P^{-1} $$
关键推导步骤(怎么解特征值):
- 把定义式移项:$(A - \lambda I)\boldsymbol{v} = \boldsymbol{0}$,要有非零解,系数矩阵必须奇异:$\det(A - \lambda I) = 0$(特征方程);
- 以 $A = \begin{bmatrix}2 & 1 \\ 1 & 2\end{bmatrix}$ 为例:$\det\begin{bmatrix}2-\lambda & 1 \\ 1 & 2-\lambda\end{bmatrix} = (2-\lambda)^2 - 1 = 0$,解得 $\lambda = 3,\ 1$;
- 回代求特征向量:$\lambda=3$ 时解 $(A-3I)\boldsymbol{v}=\boldsymbol{0}$ 得 $\boldsymbol{v} \propto (1,1)$;$\lambda=1$ 时得 $\boldsymbol{v} \propto (1,-1)$;
- 于是 $A = P\Lambda P^{-1}$:$P = \begin{bmatrix}1 & 1 \\ 1 & -1\end{bmatrix}$,$\Lambda = \text{diag}(3, 1)$——验证 $AP = P\Lambda$ 即可确认。
几何直觉:这台"变形机器"把 $(1,1)$ 方向拉伸 3 倍、把 $(1,-1)$ 方向保持不变——这两个方向就是它的主轴。
面试怎么问:"特征值大小代表什么?"——特征值大的方向是矩阵"放大"最强的方向;对协方差矩阵,特征值就是该方向的方差,最大特征值对应的特征向量 = 数据差异最大的方向,这正是 PCA 的直接依据。
✍️ §5.1 手算特征值分解:A = [[2,1],[1,2]] 的两个方向¶
特征方程 $\det(A-\lambda I)=0$,满足 $Av=\lambda v$ 的 $v$ 是特征向量——手算一个 2×2 矩阵,把"变形机器的主方向"变成数字。
设定:$A=\begin{bmatrix}2&1\\1&2\end{bmatrix}$。
第 1 步:特征方程
$$\det(A-\lambda I)=(2-\lambda)^2-1=0\Rightarrow(2-\lambda)=\pm1\Rightarrow\lambda_1=3,\ \lambda_2=1$$
快速校验:$\text{trace}=4=\lambda_1+\lambda_2$ ✓,$\det=3=\lambda_1\lambda_2$ ✓
第 2 步:特征向量
$\lambda=3$:$(A-3I)v=0\Rightarrow \begin{bmatrix}-1&1\\1&-1\end{bmatrix}v=0\Rightarrow v_1=(1,1)/\sqrt2$
$\lambda=1$:$(A-I)v=0\Rightarrow \begin{bmatrix}1&1\\1&1\end{bmatrix}v=0\Rightarrow v_2=(1,-1)/\sqrt2$
第 3 步:验证 $Av=\lambda v$
$$Av_1=\begin{bmatrix}3&3\end{bmatrix}/\sqrt2=3v_1,\qquad Av_2=\begin{bmatrix}1&-1\end{bmatrix}/\sqrt2=1v_2$$
手算收获:
- $v_1=(1,1)/\sqrt2$ 方向(沿着"对角线")被放大 3 倍,$v_2=(1,-1)/\sqrt2$(反对角)放大 1 倍——特征值 = 该方向上的拉伸倍数
- 特征值分解 $A=V\Lambda V^{-1}$:对角矩阵 $\Lambda$ 是缩放,$V$ 是旋转到主方向——PCA/谱聚类/SVD 全都建立在它上面(本 notebook §6)
- 对称矩阵特征向量正交($(1,1)\perp(1,-1)$),且特征值全实——所以协方差矩阵(对称半正定)一定有良定义的 PCA 分解
- 快速求法:2×2 用 $\lambda^2-\text{trace}\cdot\lambda+\det=0$,面试手撕常考
下面 numpy 复算。
# ---- §5.1 验证:numpy 复算特征值分解 ----
import numpy as np

A = np.array([[2.0, 1.0], [1.0, 2.0]])
lams, vecs = np.linalg.eig(A)
print(f'特征值 = {np.round(lams, 4)}(手算 3 和 1)')
print(f'特征向量 = \n{np.round(vecs, 4)}')
vals, vecs = np.linalg.eigh(A)
print(f'eigh 特征值 = {vals}')
v1, v2 = vecs[:, 0], vecs[:, 1]
assert abs(vals[0] - 1) < 1e-9 and abs(vals[1] - 3) < 1e-9
print(f'Av = λv 校验: {np.round(A @ v1, 4)} vs {np.round(vals[0] * v1, 4)}')
assert np.allclose(A @ v1, vals[0] * v1) and np.allclose(A @ v2, vals[1] * v2)
print('\n✓ 与手算一致:λ=3/λ=1,方向 (1,1)、(1,-1)')
6. SVD、PCA 与 Transformer:万能分解与两大应用¶
大白话直觉:特征值分解要求矩阵是方阵,可现实里的数据矩阵 X 是"样本 × 特征",几乎从来不是方阵。SVD 说:任何矩阵都能拆成三部分 $U \Sigma V^\top$——左奇异向量(样本方向)、奇异值(每个方向的重要程度)、右奇异向量(特征方向)。丢掉太小的奇异值,就是无损度最高的压缩/降维。
公式:
$$ A_{m\times n} = U_{m\times m}\, \Sigma_{m\times n}\, V^\top_{n\times n} $$
关键推导线索:
- SVD 与特征分解的关系:$A^\top A = V \Sigma^\top \Sigma V^\top$——右奇异向量是 $A^\top A$ 的特征向量,奇异值是 $A^\top A$ 特征值的平方根;
- 低秩近似(Eckart–Young 定理):保留前 $k$ 大的奇异值,$A \approx U_k \Sigma_k V_k^\top$,这是所有秩 $k$ 矩阵里与 $A$ 距离(Frobenius 范数)最近的一个;
- PCA = 数据中心化 + SVD:先把 X 每列减均值(中心化),再对 $X = U\Sigma V^\top$ 做 SVD,主方向就是 V 的前 k 列;降维结果 $T = XV_k$;方差保留比例 = 前 k 个奇异值平方和 ÷ 全部奇异值平方和;
- Transformer 注意力:$\text{Attention}(Q,K,V) = \text{softmax}\left(\dfrac{QK^\top}{\sqrt{d}}\right)V$——$QK^\top$ 是"所有 query 与所有 key 的内积矩阵"(相似度打分),softmax 归一化成权重,再对 V 的行做线性组合。整个机制 = 内积打分 + 矩阵乘法列视角。
面试怎么问:"特征值分解和 SVD 的区别?"——特征分解只对可对角化的方阵;SVD 对任意矩阵都成立,是"两边都能找主轴"的广义版本,数值上也更稳定。
代码实战¶
用 numpy 从零验证本章的核心结论,一共 4 个代码 cell:
- 内积与范数:手写内积,验证"内积 = 模长 × 模长 × cosθ";
- 矩阵乘法三种视角:行视角 / 列视角 / 外积视角,结果必须完全一致;
- 特征值分解验证:验证 Av = λv,并用 PΛP⁻¹ 重构 A(出图);
- SVD 重构与 PCA:小矩阵 SVD 重构误差 ~1e-15;二维数据 PCA 找主方向并可视化(出图)。
所有代码只依赖 numpy / matplotlib;PCA 使用固定随机种子,保证可复现。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
import sys, io
# 中文输出前确保 UTF-8 编码(Jupyter 内核的 OutStream 已支持 UTF-8,此处自动降级为 no-op)
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, TypeError):
    pass

import numpy as np

# 1) 手写内积 vs np.dot
a = np.array([1.0, 2.0, 3.0])
b = np.array([4.0, 5.0, 6.0])
dot_manual = sum(ai * bi for ai, bi in zip(a, b))
dot_np = np.dot(a, b)
print(f"a·b 手写 = {dot_manual:.6f},np.dot = {dot_np:.6f},一致 = {np.isclose(dot_manual, dot_np)}")

# 2) 内积 = 模长 × 模长 × cosθ:构造与 x 轴成 60° 的单位向量
e1 = np.array([1.0, 0.0])
e2 = np.array([np.cos(np.pi / 3), np.sin(np.pi / 3)])
cos_theta = np.dot(e1, e2) / (np.linalg.norm(e1) * np.linalg.norm(e2))
print(f"60° 两单位向量:内积 = {np.dot(e1, e2):.6f},cos60° = {np.cos(np.pi / 3):.6f},一致 = {np.isclose(np.dot(e1, e2), np.cos(np.pi / 3))}")

# 3) 三种范数:L2 / L1 / L∞
x = np.array([3.0, -4.0, 0.0])
print(f"‖x‖₂ = {np.linalg.norm(x):.6f}(应为 5)")
print(f"‖x‖₁ = {np.abs(x).sum():.6f}(应为 7)")
print(f"‖x‖∞ = {np.abs(x).max():.6f}(应为 4)")

assert np.isclose(dot_manual, dot_np) and np.isclose(np.dot(e1, e2), np.cos(np.pi / 3))
assert np.isclose(np.linalg.norm(x), 5.0)
print("核对通过:内积 = 模长 × 模长 × cosθ,三种范数计算正确 ✔")
a·b 手写 = 32.000000,np.dot = 32.000000,一致 = True
60° 两单位向量:内积 = 0.500000,cos60° = 0.500000,一致 = True
‖x‖₂ = 5.000000(应为 5)
‖x‖₁ = 7.000000(应为 7)
‖x‖∞ = 4.000000(应为 4)
核对通过:内积 = 模长 × 模长 × cosθ,三种范数计算正确 ✔
import numpy as np

# 1) 矩阵乘法三种视角,结果必须完全一致
A = np.array([[1.0, 2.0], [3.0, 4.0], [5.0, 6.0]])   # 3×2
B = np.array([[1.0, 0.0, 1.0], [0.0, 1.0, 1.0]])      # 2×3
C_np = A @ B                                          # 3×3

# 行视角:C[i][j] = A 第 i 行与 B 第 j 列的内积
C_rows = np.zeros((3, 3))
for i in range(3):
    for j in range(3):
        C_rows[i, j] = np.dot(A[i, :], B[:, j])

# 列视角:C[:, j] = A 作用于 B 的第 j 列
C_cols = np.stack([A @ B[:, j] for j in range(3)], axis=1)

# 外积视角:C = Σ_k A[:, k] ⊗ B[k, :]
C_outer = np.zeros((3, 3))
for k in range(2):
    C_outer += np.outer(A[:, k], B[k, :])

print("C = A @ B =\n", C_np)
print("行视角一致:", np.allclose(C_np, C_rows),
      " 列视角一致:", np.allclose(C_np, C_cols),
      " 外积视角一致:", np.allclose(C_np, C_outer))

# 2) 线性变换演示:旋转矩阵把向量旋转 90°
theta = np.pi / 2
R = np.array([[np.cos(theta), -np.sin(theta)],
              [np.sin(theta),  np.cos(theta)]])
v = np.array([1.0, 0.0])
w = R @ v
print(f"旋转 90°:v=({v[0]}, {v[1]}) -> Rv=({w[0]:.4f}, {w[1]:.4f})(应约等于 (0, 1))")
print(f"线性性验证:R(2v) = {R @ (2 * v)},2(Rv) = {2 * w},相等 = {np.allclose(R @ (2 * v), 2 * (R @ v))}")

assert np.allclose(C_np, C_rows) and np.allclose(C_np, C_cols) and np.allclose(C_np, C_outer)
assert np.allclose(w, [0.0, 1.0], atol=1e-10)
print("核对通过:矩阵乘法三种视角完全等价,旋转是线性变换 ✔")
C = A @ B =
 [[ 1.  2.  3.]
 [ 3.  4.  7.]
 [ 5.  6. 11.]]
行视角一致: True  列视角一致: True  外积视角一致: True
旋转 90°:v=(1.0, 0.0) -> Rv=(0.0000, 1.0000)(应约等于 (0, 1))
线性性验证:R(2v) = [1.2246468e-16 2.0000000e+00],2(Rv) = [1.2246468e-16 2.0000000e+00],相等 = True
核对通过:矩阵乘法三种视角完全等价,旋转是线性变换 ✔
import numpy as np
import matplotlib.pyplot as plt
import os

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

A = np.array([[2.0, 1.0], [1.0, 2.0]])
vals, vecs = np.linalg.eig(A)      # vecs 的每一列是一个特征向量
print("特征值 λ =", vals)
print("特征向量矩阵 P =\n", vecs)

# 1) 验证 A v = λ v(对每一列)
ok = True
for i in range(2):
    v = vecs[:, i]
    err = np.linalg.norm(A @ v - vals[i] * v)
    ok = ok and err < 1e-10
    print(f"第 {i+1} 个特征向量:‖Av - λv‖ = {err:.2e}")

# 2) 验证重构 A = P Λ P⁻¹
P = vecs
Lam = np.diag(vals)
A_recon = P @ Lam @ np.linalg.inv(P)
print(f"重构误差 ‖A - PΛP⁻¹‖ = {np.linalg.norm(A - A_recon):.2e}")

# 3) 对称矩阵的特征向量正交
print(f"两个特征向量内积 = {np.dot(vecs[:, 0], vecs[:, 1]):.2e}(≈0,对称矩阵特征向量正交)")

# 4) 画图:单位圆被 A 拉伸成椭圆,长短轴方向就是特征向量
t = np.linspace(0, 2 * np.pi, 200)
circle = np.stack([np.cos(t), np.sin(t)], axis=1)
ellipse = circle @ A.T
plt.figure(figsize=(6.5, 6))
plt.plot(circle[:, 0], circle[:, 1], 'b-', alpha=0.6, label='单位圆')
plt.plot(ellipse[:, 0], ellipse[:, 1], 'r-', linewidth=2, label='A 作用后(椭圆)')
for i in range(2):
    v = vecs[:, i] / np.linalg.norm(vecs[:, i])
    plt.quiver(0, 0, vals[i] * v[0], vals[i] * v[1], angles='xy', scale_units='xy', scale=1,
               color=['green', 'orange'][i], width=0.02)
plt.legend()
plt.axis('equal')
plt.grid(alpha=0.3)
plt.title('特征向量方向在 A 作用下只被拉伸')
plt.tight_layout()
os.makedirs('images', exist_ok=True)
plt.savefig('images/math01_eig.png', dpi=120)
plt.show()
print("已保存 images/math01_eig.png")

assert ok and np.linalg.norm(A - A_recon) < 1e-10
print("核对通过:Av = λv 成立,特征值分解重构误差 ~0 ✔")
特征值 λ = [3. 1.]
特征向量矩阵 P =
 [[ 0.70710678 -0.70710678]
 [ 0.70710678  0.70710678]]
第 1 个特征向量:‖Av - λv‖ = 0.00e+00
第 2 个特征向量:‖Av - λv‖ = 0.00e+00
重构误差 ‖A - PΛP⁻¹‖ = 0.00e+00
两个特征向量内积 = 0.00e+00(≈0,对称矩阵特征向量正交)
已保存 images/math01_eig.png
核对通过:Av = λv 成立,特征值分解重构误差 ~0 ✔
C:\Users\24260\AppData\Local\Temp\ipykernel_37924\26406768.py:48: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
import numpy as np
import matplotlib.pyplot as plt
import os

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 1) 小矩阵 SVD 重构验证(4×3 非方阵)
M = np.array([[3.0, 1.0, 1.0],
              [-1.0, 3.0, 1.0],
              [1.0, 1.0, 3.0],
              [0.0, 2.0, 0.0]])
U, s, Vt = np.linalg.svd(M, full_matrices=True)
Sigma = np.zeros(M.shape)
Sigma[:s.size, :s.size] = np.diag(s)
M_recon = U @ Sigma @ Vt
print(f"SVD 重构误差 ‖M - UΣVᵀ‖ = {np.linalg.norm(M - M_recon):.2e}(~1e-15)")
print(f"奇异值 s = {np.round(s, 4)},非零个数(= 秩)= {int(np.sum(s > 1e-10))}")

# 2) 低秩近似:只保留前 1 个 / 前 2 个奇异值
M1 = (U[:, :1] * s[:1]) @ Vt[:1, :]
M2 = (U[:, :2] * s[:2]) @ Vt[:2, :]
print(f"秩 1 近似误差 = {np.linalg.norm(M - M1):.4f},秩 2 近似误差 = {np.linalg.norm(M - M2):.4f}")

# 3) PCA:二维数据找主方向(固定随机种子,可复现)
rng = np.random.default_rng(42)
cov = np.array([[3.0, 1.8], [1.8, 1.2]])
X = rng.multivariate_normal([2.0, 3.0], cov, 200)

Xc = X - X.mean(axis=0)                            # 中心化
U, s, Vt = np.linalg.svd(Xc, full_matrices=False)  # Xc = U diag(s) Vt
main_dir = Vt[0]                                   # 第一个右奇异向量 = 主方向
var_ratio = s[0] ** 2 / (s ** 2).sum()
print(f"主方向 v1 = ({main_dir[0]:.4f}, {main_dir[1]:.4f}),解释方差比例 = {var_ratio:.4f}")

T1 = Xc @ Vt[0]                                    # 投影到一维
X_recon = np.outer(T1, Vt[0]) + X.mean(axis=0)     # 重构回二维
print(f"降维到 1 维再重构的误差 ‖X - X_recon‖ = {np.linalg.norm(X - X_recon):.4f}")

# 4) 画图
plt.figure(figsize=(8, 6))
plt.scatter(X[:, 0], X[:, 1], alpha=0.45, s=18, label='原始数据')
plt.scatter(X_recon[:, 0], X_recon[:, 1], alpha=0.45, s=18, marker='^', label='PCA 1 维重构点')
mu = X.mean(axis=0)
scale = 3.0 * np.sqrt(s[0])
for sgn in [1, -1]:
    tip = mu + sgn * scale * main_dir
    plt.annotate('', xy=tip, xytext=mu,
                 arrowprops=dict(arrowstyle='->', color='red', lw=2))
plt.text(mu[0] + 0.15, mu[1] + 1.8, '主方向 v₁', color='red', fontsize=12)
plt.xlim(X[:, 0].min() - 1.5, X[:, 0].max() + 1.5)
plt.ylim(X[:, 1].min() - 1.5, X[:, 1].max() + 1.5)
plt.xlabel('特征 1'); plt.ylabel('特征 2')
plt.title(f'PCA:找数据方差最大的方向(解释 {var_ratio:.2%} 方差)')
plt.legend()
plt.tight_layout()
os.makedirs('images', exist_ok=True)
plt.savefig('images/math01_pca.png', dpi=120)
plt.show()
print("已保存 images/math01_pca.png")

assert np.linalg.norm(M - M_recon) < 1e-10 and var_ratio > 0.7
print("核对通过:SVD 完美重构,PCA 主方向解释大部分方差 ✔")
SVD 重构误差 ‖M - UΣVᵀ‖ = 1.25e-14(~1e-15)
C:\Users\24260\AppData\Local\Temp\ipykernel_37924\1424058281.py:56: UserWarning: Glyph 8321 (\N{SUBSCRIPT ONE}) missing from font(s) Microsoft YaHei.
  plt.tight_layout()
C:\Users\24260\AppData\Local\Temp\ipykernel_37924\1424058281.py:58: UserWarning: Glyph 8321 (\N{SUBSCRIPT ONE}) missing from font(s) Microsoft YaHei.
  plt.savefig('images/math01_pca.png', dpi=120)
奇异值 s = [4.6615 3.3753 1.9692],非零个数(= 秩)= 3
秩 1 近似误差 = 3.9078,秩 2 近似误差 = 1.9692
主方向 v1 = (0.8550, 0.5186),解释方差比例 = 0.9821
降维到 1 维再重构的误差 ‖X - X_recon‖ = 3.8169
已保存 images/math01_pca.png
核对通过:SVD 完美重构,PCA 主方向解释大部分方差 ✔
C:\Users\24260\AppData\Local\Temp\ipykernel_37924\1424058281.py:59: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
代码实战 · 结果图¶
上面两张图分别直观展示了"特征向量"和"PCA"两个概念。
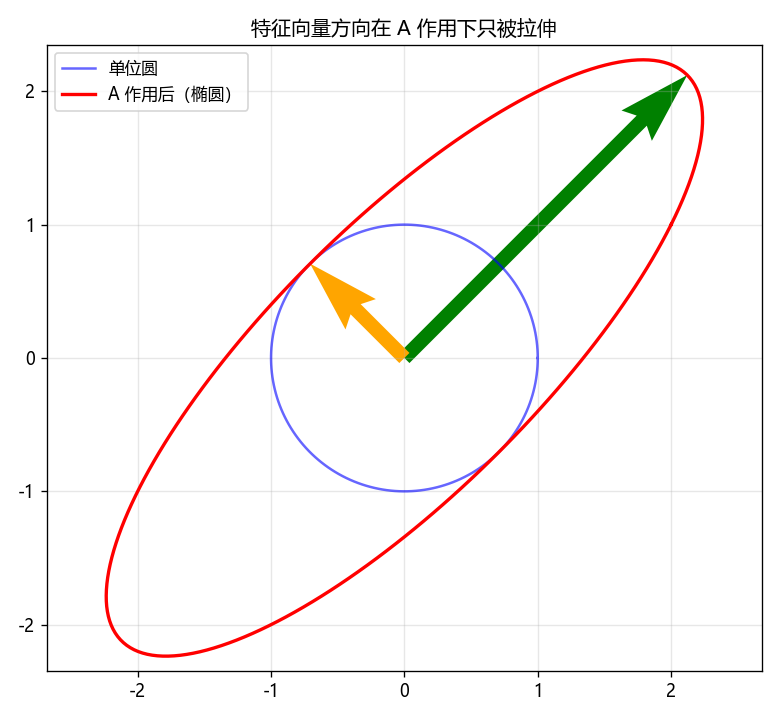
单位圆上的所有点被矩阵 $A=\begin{bmatrix}2 & 1 \\ 1 & 2\end{bmatrix}$ 拉伸成一个椭圆;绿色与橙色箭头是特征向量方向——它们方向不变,只被拉长(对应特征值 3 与 1)。
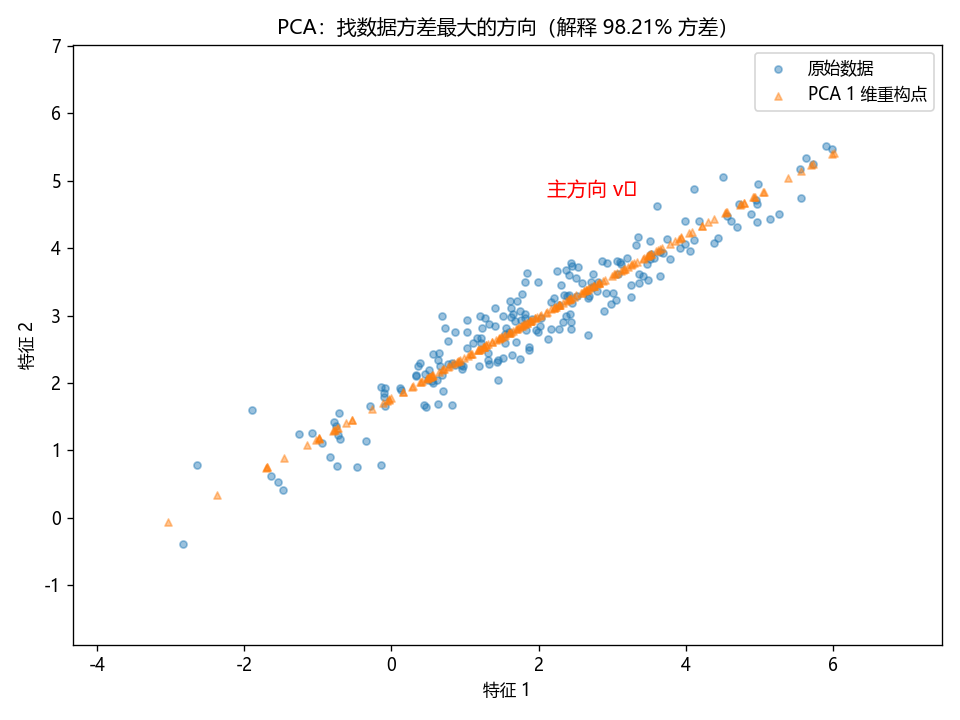
红色箭头是数据方差最大的主方向(第一主成分),三角形是每个点投影到该方向后再重构回二维的位置——它们全都落在同一条线上,说明一维已经抓住了绝大部分信息。
提示:上面代码用的是"先中心化再 SVD"的 PCA 标准流程,和"对协方差矩阵做特征分解"完全等价,只是数值上更稳定。
面试考点¶
Q1:特征值和特征向量的几何意义是什么?¶
参考回答:Av = λv 表示 v 这个方向在矩阵作用下方向不变、只被缩放 λ 倍;特征值大的方向是矩阵"放大"最强的方向。对协方差矩阵,特征值就是该方向的方差。 追问:对称矩阵有什么特殊性质? 30 秒速答:特征值全为实数、特征向量可取正交单位向量组,可正交对角化 A = QΛQᵀ——这正是 PCA 的前提。
Q2:特征值分解和 SVD 有什么区别?什么时候用哪个?¶
参考回答:特征分解要求方阵且可对角化;SVD 对任意矩阵都成立,A = UΣVᵀ。SVD 的奇异值等于 AAᵀ 或 AᵀA 特征值的平方根,数值更稳定;PCA、压缩、推荐都用 SVD。 追问:SVD 的低秩近似为什么好? 30 秒速答:Eckart–Young 定理——保留前 k 大奇异值是所有秩 k 矩阵里最接近原矩阵的,误差 = 被丢弃奇异值平方和的平方根。
Q3:PCA 的完整步骤?¶
参考回答:① 中心化(每列减均值);② 算协方差矩阵 XᵀX/(n-1),或直接对中心化后的 X 做 SVD;③ 取前 k 个特征向量 / 奇异向量作为主方向;④ 投影 T = XV_k 完成降维;⑤ 可选:重构评估信息损失。 追问:为什么要中心化?不中心化会怎样? 30 秒速答:不中心化时第一主成分会被均值方向"带偏"(偏向原点方向而非数据差异方向),无法正确捕获方差。
Q4:为什么 Transformer 用内积算注意力?为什么要除以 √d?¶
参考回答:内积 = 模长 × 模长 × cosθ,天然衡量两个向量"同向程度",q·k 大说明 query 与 key 相似。除以 √d 是因为 q、k 各维独立随机时,内积方差约 d,除以 √d 让 softmax 输入保持 O(1) 量级,避免饱和、梯度消失。 追问:softmax(QKᵀ/√d)V 里 V 是怎么被"融合"的? 30 秒速答:softmax 权重矩阵的每一行是"该 query 对每个 key 的注意力权重",它乘 V 就是对 V 的行做线性组合(矩阵乘法列视角)。
Q5:L1 和 L2 正则化有什么区别?从数学上解释。¶
参考回答:L2 惩罚 ‖w‖₂² 让权重整体收缩但不为零(圆等高线);L1 惩罚 ‖w‖₁ 的等高线是菱形,最优解常落在坐标轴顶点 → 权重稀疏。从梯度看:L2 的梯度是 2λw(按比例缩小),L1 的梯度是 λ·sign(w)(恒定推力,把小的权重推成 0)。 追问:稀疏有什么好处? 30 秒速答:特征选择、模型可解释性、节省存储与推理计算。
Q6:矩阵不可逆(奇异)意味着什么?实际工程怎么处理?¶
参考回答:秩亏 / 有线性相关的行或列,信息冗余,方程 Ax=b 解不唯一或不存在。工程上:加正则化(XᵀX + λI 保证可逆)、用伪逆(由 SVD 计算)、PCA 先降维去相关。 追问:伪逆怎么算? 30 秒速答:对 X = UΣVᵀ,把非零奇异值取倒数得到 Σ⁺,X⁺ = VΣ⁺Uᵀ。
Q7:矩阵乘法的计算量是多少?为什么 GPU 喜欢它?¶
参考回答:C(m×n) = A(m×k)B(k×n) 约 2mnk 次浮点运算,计算密度高、可并行分块。现代 GPU/TPU 把 GEMM 作为核心算子,深度学习绝大部分计算都是矩阵乘法(卷积也能化为 GEMM)。 追问:为什么说注意力的复杂度是 O(n²)? 30 秒速答:QKᵀ 是 n×d 乘 d×n,代价 O(n²d),序列长度 n 增大时平方增长,所以长文本要用稀疏注意力 / 线性注意力。
小结与下一章预告¶
小结¶
- 一套语言:样本 = 矩阵的行,特征 = 矩阵的列,Wx + b = 线性变换 + 平移。
- 三个视角:矩阵乘法有行 / 列 / 外积三种看法,SVD 与注意力都离不开它们。
- 两个分解:特征值分解(方阵对角化)与 SVD(任意矩阵万能分解),PCA 就是"中心化 + SVD"。
- 一个打分器:内积 / 余弦相似度 = Transformer 注意力的"像不像"打分。
- 一个降维工具:PCA = 找最大方差方向 → 投影 → 用奇异值衡量信息保留比例。
下一章预告¶
数学地基还剩最后一块:02-概率论与统计。它会把"不确定性"数学化:随机变量、常见分布、期望、方差、大数定律、中心极限定理、极大似然估计——交叉熵损失、KL 散度、随机梯度下降的理论都在那里等着你。