⚡ 02 · Spark:RDD / 惰性求值 / 血缘 / 内存计算¶
Spark 是离线大数据的事实标准。本节不装 Spark,用 Python 模拟核心机制: RDD 转换(transformation)、惰性求值、血缘(lineage)、action 触发、Shuffle 与宽窄依赖。
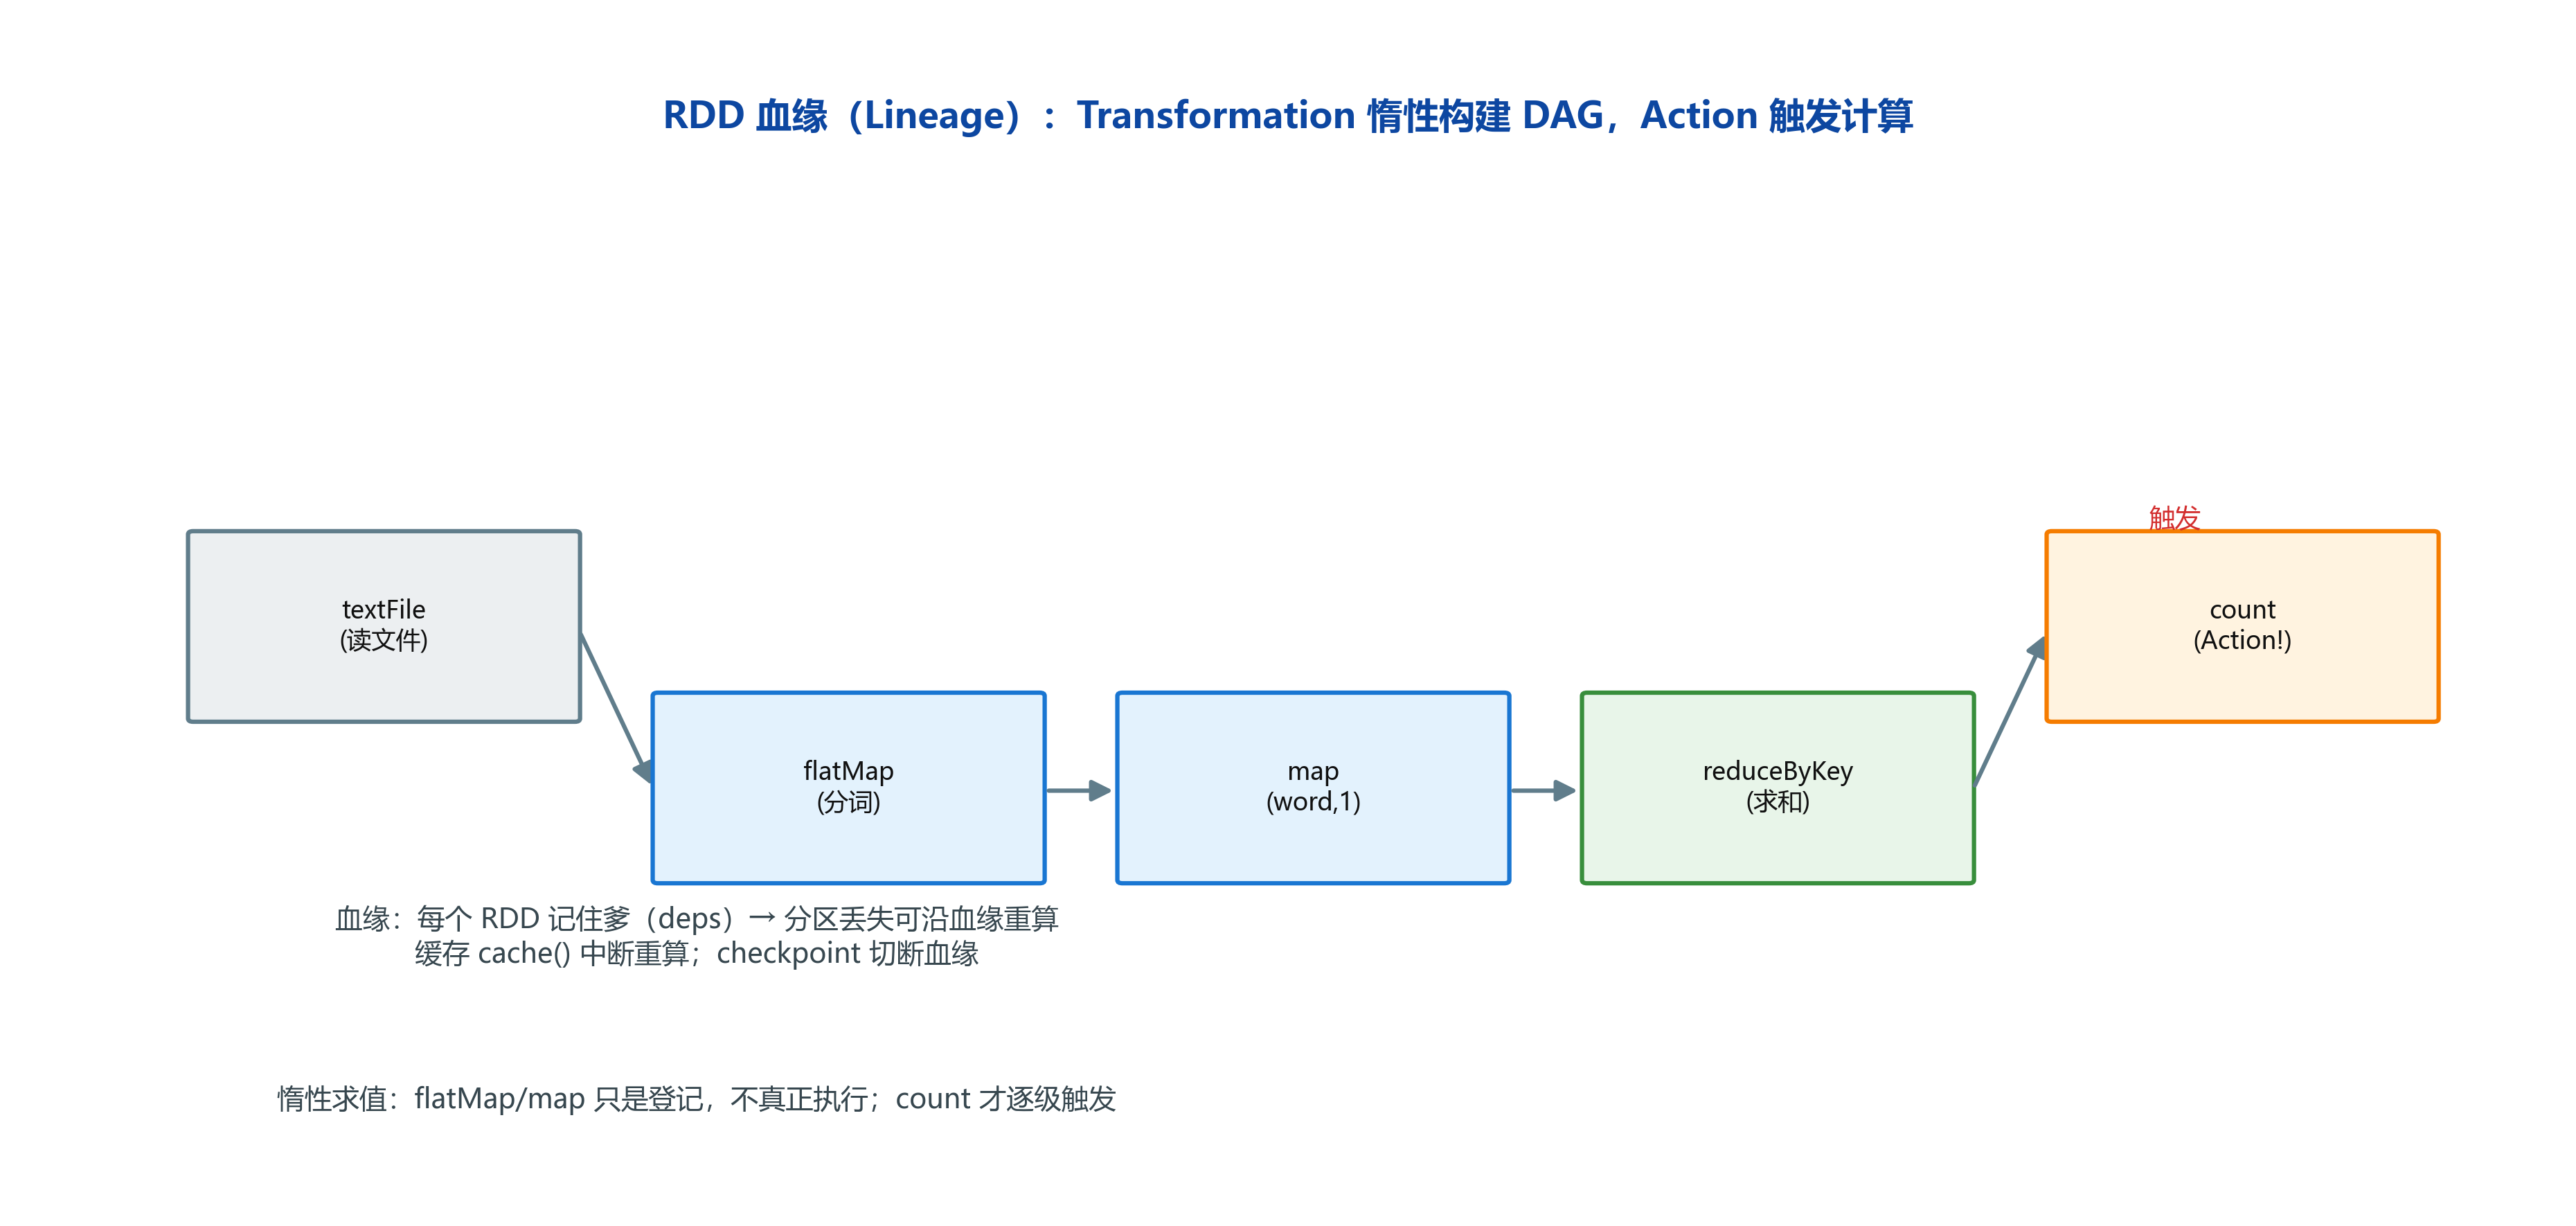
🔍 图解(自绘高清图,300dpi,可放大):RDD 是 Spark 的核心抽象,这张图讲清三个概念——
- 血缘(Lineage,横向):每个 RDD 记住自己是从哪来的(由哪个父 RDD 经过哪个算子产生), 形成一张有向无环图(DAG)——一旦某个分区丢失,按血缘重算即可恢复,无需复制多副本;
- 惰性求值(Transformation):
map/filter/join等转换算子只是"记录操作", 调用时不立即计算,只是延长血缘链——因此可以合并优化(窄依赖流水线、宽依赖只 shuffle 一次);- Action 触发:
collect/count/save等动作算子出现时,Spark 才从头执行整条血缘链, 产出结果——"惰性"保证一次调度就能完成全部转换;- 窄依赖 vs 宽依赖:窄(父分区→唯一子分区,如 map)可单节点流水线; 宽(父分区→多个子分区,如 groupByKey)必须 Shuffle——这是调优的焦点(减少宽依赖/数据倾斜)。
论文出处:Zaharia et al., "Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing", NSDI 2012——RDD 血缘(Lineage)与惰性求值的原始论文定义。
🎬 背景故事¶
MapReduce 每次都要落盘,慢得让人抓狂——Spark 凭什么快 100 倍?……
MapReduce 每跑完一个阶段就要把中间结果写到磁盘,反复读写让离线计算慢得让人抓狂。2014 年 Spark 横空出世,核心武器只有一句话:把中间结果留在内存里。为了让内存计算安全可靠,Spark 发明了 RDD——一个"记住爹娘"(血缘)的弹性数据集。本节用 Python 手搓一个迷你 Spark。
🧭 本节逻辑主线:MR 落盘太慢 → RDD 是什么 → 惰性求值怎么工作 → 血缘如何容错 → 宽窄依赖与 Shuffle → 与 DataFrame 对比。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | RDD 是什么? | 弹性分布式数据集(分区+转换) |
| 2 | 惰性求值怎么工作? | transformation 攒着,action 才执行 |
| 3 | 血缘(lineage)干什么? | 记录来源,故障重算 |
| 4 | 宽窄依赖区别? | 窄=同分区,宽=Shuffle |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ Spark 核心概念(必背)¶
print('''Spark 核心:
  1) RDD:不可变、分区的数据集合(弹性=可重算、可缓存);
  2) Transformation:map/filter/flatMap/groupBy...  惰性(lazy);
  3) Action:collect/count/reduce/take...           立即触发;
  4) DAG:转换构成有向无环图,Action 时提交执行;
  5) 血缘(Lineage):每个 RDD 记录父 RDD 与转换,故障自动重算;
  6) Cache/Checkpoint:缓存中间结果,切断过长血缘。
''')
Spark 核心:
  1) RDD:不可变、分区的数据集合(弹性=可重算、可缓存);
  2) Transformation:map/filter/flatMap/groupBy...  惰性(lazy);
  3) Action:collect/count/reduce/take...           立即触发;
  4) DAG:转换构成有向无环图,Action 时提交执行;
  5) 血缘(Lineage):每个 RDD 记录父 RDD 与转换,故障自动重算;
  6) Cache/Checkpoint:缓存中间结果,切断过长血缘。
2️⃣ 手写迷你 RDD(简化版)¶
class MiniRDD:
    def __init__(self, partitions, deps=None, op=None):
        self.partitions = partitions      # 分区列表(每区一个 list)
        self.deps = deps or []            # 血缘
        self.op = op or 'source'
    def map(self, f):
        # transformation:不执行,只记录闭包
        new_parts = [None] * len(self.partitions)
        return MiniRDD(new_parts, deps=self.deps + [f'source.map({f.__name__ if hasattr(f,"__name__") else "lambda"})'], op='map')
    def filter(self, f):
        return MiniRDD([None] * len(self.partitions), deps=self.deps + ['filter'], op='filter')
    def materialize(self, f=None, g=None):
        # 模拟执行:从源头开始真正计算
        if self.op == 'source':
            return [[x for x in p] for p in self.partitions]
        # 简化:由闭包外部处理
        return None

src = MiniRDD([[1, 2, 3], [4, 5, 6], [7, 8, 9]])   # 3 个分区
rdd2 = src.map(lambda x: x * 2).filter(lambda x: x > 5)
print('map 后血缘:', rdd2.deps)
print('➡️ 上面只是"记录操作",没有真正执行任何计算(惰性)')
map 后血缘: ['source.map(<lambda>)', 'filter']
➡️ 上面只是"记录操作",没有真正执行任何计算(惰性)
3️⃣ 惰性求值演示:action 才触发¶
# 完整迷你执行器:真正跑通 map/filter/count
from functools import reduce

class MiniSpark:
    def __init__(self, partitions):
        self._parts = partitions
        self._plan = []          # (name, fn) 转换序列
        self._executed = 0

    def map(self, f):
        self._plan.append(('map', f)); return self
    def filter(self, f):
        self._plan.append(('filter', f)); return self
    def flatMap(self, f):
        self._plan.append(('flatMap', f)); return self
    def reduceByKey(self, f):
        self._plan.append(('reduceByKey', f)); return self
    def run(self):
        parts = [list(p) for p in self._parts]
        for name, fn in self._plan:
            if name == 'map':
                parts = [[fn(x) for x in p] for p in parts]
            elif name == 'filter':
                parts = [[x for x in p if fn(x)] for p in parts]
            elif name == 'flatMap':
                parts = [[y for x in p for y in fn(x)] for p in parts]
            elif name == 'reduceByKey':
                out = []
                for p in parts:
                    d = {}
                    for k, v in p:
                        d[k] = fn(d[k], v) if k in d else v
                    out.append(list(d.items()))
                parts = out
            self._executed += 1
        return parts

ms = MiniSpark([[1, 2, 3], [4, 5, 6], [7, 8, 9]])
ms.map(lambda x: x * 2).filter(lambda x: x > 5)
print(f'构建计划后:执行次数 = {ms._executed}(尚未计算!)')
res = ms.run()
print(f'action(run) 后:执行次数 = {ms._executed},结果 = {res}')
# map 后 9 个元素,filter >5 保留 7 个
assert ms._executed == 2 and sum(len(p) for p in res) == 7
print('✅ 惰性求值:transformations 不执行,action 才执行')
构建计划后:执行次数 = 0(尚未计算!)
action(run) 后:执行次数 = 2,结果 = [[6], [8, 10, 12], [14, 16, 18]]
✅ 惰性求值:transformations 不执行,action 才执行
4️⃣ 词频(Spark 风格)¶
lines = ['apple banana', 'apple cherry', 'banana cherry apple']
ms2 = MiniSpark([[w for line in lines for w in line.split()]])
ms2.map(lambda w: (w, 1)).reduceByKey(lambda a, b: a + b)
out = ms2.run()
wc = dict(out[0])
print('Spark 风格词频:', wc)
assert wc['apple'] == 3 and wc['cherry'] == 2 and wc['banana'] == 2
print('✅ 词频统计与手写 MapReduce 结果一致')
Spark 风格词频: {'apple': 3, 'banana': 2, 'cherry': 2}
✅ 词频统计与手写 MapReduce 结果一致
📐 公式推导:窄依赖 vs 宽依赖与 Shuffle 传输量¶
窄依赖(如 map、filter):父分区 $P$ 只被子分区 $C$ 之一使用——可以在同 executor 内流水线执行,无网络传输。
宽依赖(如 groupByKey、reduceByKey、join):父分区 $C_i$ 的数据被分发到多个子分区——必须 Shuffle(写本地/远端的中间文件):
$$ \mathrm{Data}_{\mathrm{shuffle}} = \sum_{i=1}^{N_{parent}} |C_i| \times 2 \;\text{(序列化+反序列化往返)} $$
关键公式——join 的复杂度(大表 join 小表 vs 大表 join 大表):
- Broadcast Join(小表 $|A| \ll |B|$):把 $A$ 广播到所有 executor,传输量 $O(|A| \times \mathrm{executors})$,无 shuffle。
- Shuffle Join:两表都按 key 分区到 $R$ 个桶,传输量 $O(|A| + |B|)$,每个 Reduce 处理 $|A|/R + |B|/R$。
推导要点:① reduceByKey 在 Map 端做局部合并再 shuffle,传输量远小于 groupByKey(先整体打散再聚合)——代码中 wc 用两阶段 reduce 正是这点;② 宽依赖越多、shuffle 越多,Spark 优化方向就是"把 O(N) 次 shuffle 压成 O(1)"(如 AQE/Coalesce)。
✍️ §4.1 手算窄依赖 vs 宽依赖:Shuffle 传输量差多少¶
窄依赖:父分区被子分区一一使用(map/filter),无 shuffle;宽依赖:同 key 数据跨分区归并(groupByKey),必须 shuffle——300 条数据手算。
设定:3 个分区共 300 条记录。
窄依赖(map / filter)
$$\text{shuffle 传输}=0\ \text{条}$$——每个分区独立处理,结果仍在原分区(pipeline 化)
宽依赖(groupByKey)
$$\text{shuffle 传输}=300\ \text{条}$$——每一条都要按 key 重新路由到目标分区
手算收获:
- 判断口诀:"父分区只被子分区之一用 = 窄"(map/filter/union);"一个父分区喂多个子分区 = 宽"(groupByKey/reduceByKey)——本 notebook §5 配图
- 宽依赖 = Shuffle 边界:数据跨分区传输 + 刷盘,是 Spark 慢的根源;减少 shuffle = 性能优化第一原则
- 血缘(§6 §7):RDD 记录每步依赖,窄依赖可原地重算、宽依赖要重算上游——cache 常放在宽依赖前
- 面试速答:map/filter/union 窄;join/groupByKey/reduceByKey 宽;窄依赖支持管道化执行,宽依赖需 stage 划分
下面 numpy 复算。
# ---- §4.1 验证:numpy 复算窄宽依赖 shuffle 量 ----
n_part, n_rec = 3, 300
narrow_io = 0                 # map/filter 分区内完成,无网络传输
wide_io = n_rec               # groupByKey 每条记录跨分区路由
print(f'窄依赖 shuffle = {narrow_io} 条,宽依赖 shuffle = {wide_io} 条(全量)')
assert narrow_io == 0 and wide_io == 300
print('\n✓ 与手算一致')
5️⃣ 宽窄依赖与 Shuffle(图示)¶
# 🖼️ 配图:窄依赖 vs 宽依赖——Shuffle 的边界在哪
fig, ax = plt.subplots(figsize=(8, 4.2))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.8)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=8.8)

def arrow(x1, y1, x2, y2, color='#64748b', w=1.5):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=w))

ax.text(2.4, 4.5, '窄依赖(无 Shuffle)', ha='center', fontsize=11, color='#16a34a')
for i, (x, y) in enumerate([(0.5, 2.6), (1.8, 2.6), (3.1, 2.6)]):
    box(x, y, 1.0, 0.8, f'父分区{i+1}', '#e2e8f0')
for i, (x, y) in enumerate([(0.7, 0.7), (1.6, 0.7), (2.5, 0.7), (3.4, 0.7)]):
    box(x, y, 0.8, 0.7, f'子{i+1}', '#bbf7d0')
arrow(1.0, 2.6, 1.1, 1.5); arrow(2.3, 2.6, 2.0, 1.5); arrow(3.6, 2.6, 2.9, 1.5)
arrow(1.0, 2.6, 1.1, 1.5, w=0); ax.text(0.6, 1.4, '每个父分区只服务一个子分区(map/filter)', fontsize=8.2, color='#16a34a')

ax.text(7.6, 4.5, '宽依赖(Shuffle)', ha='center', fontsize=11, color='#dc2626')
for i, (x, y) in enumerate([(6.2, 2.6), (7.6, 2.6), (9.0, 2.6)]):
    box(x, y, 1.0, 0.8, f'父分区{i+1}', '#f1f5f9')
for i, (x, y) in enumerate([(6.2, 0.7), (8.0, 0.7)]):
    box(x, y, 1.2, 0.7, f'子分区{i+1}', '#fecaca')
arrow(6.7, 2.6, 6.7, 1.5, '#dc2626'); arrow(6.7, 2.6, 8.5, 1.5, '#dc2626')
arrow(8.1, 2.6, 6.7, 1.5, '#dc2626'); arrow(8.1, 2.6, 8.5, 1.5, '#dc2626')
arrow(9.5, 2.6, 8.5, 1.5, '#dc2626')
ax.text(6.4, 1.2, '每个父分区拆给多个子分区(groupBy/join)→ 网络传输', fontsize=8.2, color='#dc2626')
plt.show()
print('➡️ 面试:宽依赖 = Shuffle 边界;reduceByKey 比 groupByKey 少传数据(map端预聚合)')
➡️ 面试:宽依赖 = Shuffle 边界;reduceByKey 比 groupByKey 少传数据(map端预聚合)
C:\Users\24260\AppData\Local\Temp\ipykernel_45332\1127521937.py:30: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
print('''窄依赖(Narrow):父分区只被子分区之一使用
  map/filter/flatMap/union -> 无需 Shuffle,可流水线
  宽依赖(Wide)  :父分区被多个子分区使用
  groupByKey/reduceByKey/join -> 需要 Shuffle(数据跨节点传输)

优化面试点:
  1) reduceByKey 优于 groupByKey(map 端预聚合);
  2) Shuffle 是性能瓶颈 -> 控制分区数、避免过多 Shuffle;
  3) 血缘长 -> checkpoint 截断(故障恢复更快)。
''')
# 演示:reduceByKey 的 map 端预聚合
partitions = [[('a', 1), ('b', 1)], [('a', 1), ('a', 1)], [('b', 1), ('c', 1)]]
print('分区内预聚合(combine):')
for i, p in enumerate(partitions):
    d = {}
    for k, v in p:
        d[k] = d.get(k, 0) + v
    print(f'  分区{i}: {p} -> {list(d.items())}')
窄依赖(Narrow):父分区只被子分区之一使用
  map/filter/flatMap/union -> 无需 Shuffle,可流水线
  宽依赖(Wide)  :父分区被多个子分区使用
  groupByKey/reduceByKey/join -> 需要 Shuffle(数据跨节点传输)

优化面试点:
  1) reduceByKey 优于 groupByKey(map 端预聚合);
  2) Shuffle 是性能瓶颈 -> 控制分区数、避免过多 Shuffle;
  3) 血缘长 -> checkpoint 截断(故障恢复更快)。

分区内预聚合(combine):
  分区0: [('a', 1), ('b', 1)] -> [('a', 1), ('b', 1)]
  分区1: [('a', 1), ('a', 1)] -> [('a', 2)]
  分区2: [('b', 1), ('c', 1)] -> [('b', 1), ('c', 1)]
6️⃣ Cache 与血缘(面试速答)¶
print('''1) cache():    把中间 RDD 存内存,避免反复从源头重算;
2) checkpoint: 写到可靠存储,切断血缘(适合血缘超长);
3) 缓存 vs 检查点:缓存可能丢失(依赖血缘可重算),检查点直接切断;
4) 何时用 cache?-> 同一 RDD 被多次 action / 迭代计算;
5) cache 是 lazy 的:真正缓存发生在第一次 action 后。
''')
1) cache():    把中间 RDD 存内存,避免反复从源头重算;
2) checkpoint: 写到可靠存储,切断血缘(适合血缘超长);
3) 缓存 vs 检查点:缓存可能丢失(依赖血缘可重算),检查点直接切断;
4) 何时用 cache?-> 同一 RDD 被多次 action / 迭代计算;
5) cache 是 lazy 的:真正缓存发生在第一次 action 后。
7️⃣ DataFrame vs RDD(面试对比)¶
print('''| 维度 | RDD | DataFrame |
|---|---|---|
| 抽象 | 无结构数据+函数 | 有 schema 的表 |
| 优化 | 靠手写 | Catalyst 优化器自动 |
| 类型安全 | 弱(运行时) | 有(编译期 schema) |
| 易用性 | 低 | 高(SQL 语法) |
| 现状 | 底层引擎 | 生产主力(Spark SQL) |

Spark SQL 三大优势:Catalyst 优化、Tungsten 内存管理、DataSource API。
''')
| 维度 | RDD | DataFrame |
|---|---|---|
| 抽象 | 无结构数据+函数 | 有 schema 的表 |
| 优化 | 靠手写 | Catalyst 优化器自动 |
| 类型安全 | 弱(运行时) | 有(编译期 schema) |
| 易用性 | 低 | 高(SQL 语法) |
| 现状 | 底层引擎 | 生产主力(Spark SQL) |

Spark SQL 三大优势:Catalyst 优化、Tungsten 内存管理、DataSource API。
📝 自测清单¶
- 能解释 RDD/Transformation/Action/DAG 四概念
- 能演示惰性求值(action 触发)
- 能讲清宽窄依赖与 Shuffle
- 能解释血缘与 cache/checkpoint 的区别
- 能对比 RDD 与 DataFrame