🗨️ 02 · 视觉语言模型:BLIP / Qwen-VL / LLaVA¶
从「CLIP 会算相似度」到「模型会看图说话」,中间是视觉语言模型(VLM)。 本节讲清两条主流路线——Q-Former 对齐(BLIP-2) 与 投影层+指令微调(LLaVA)。
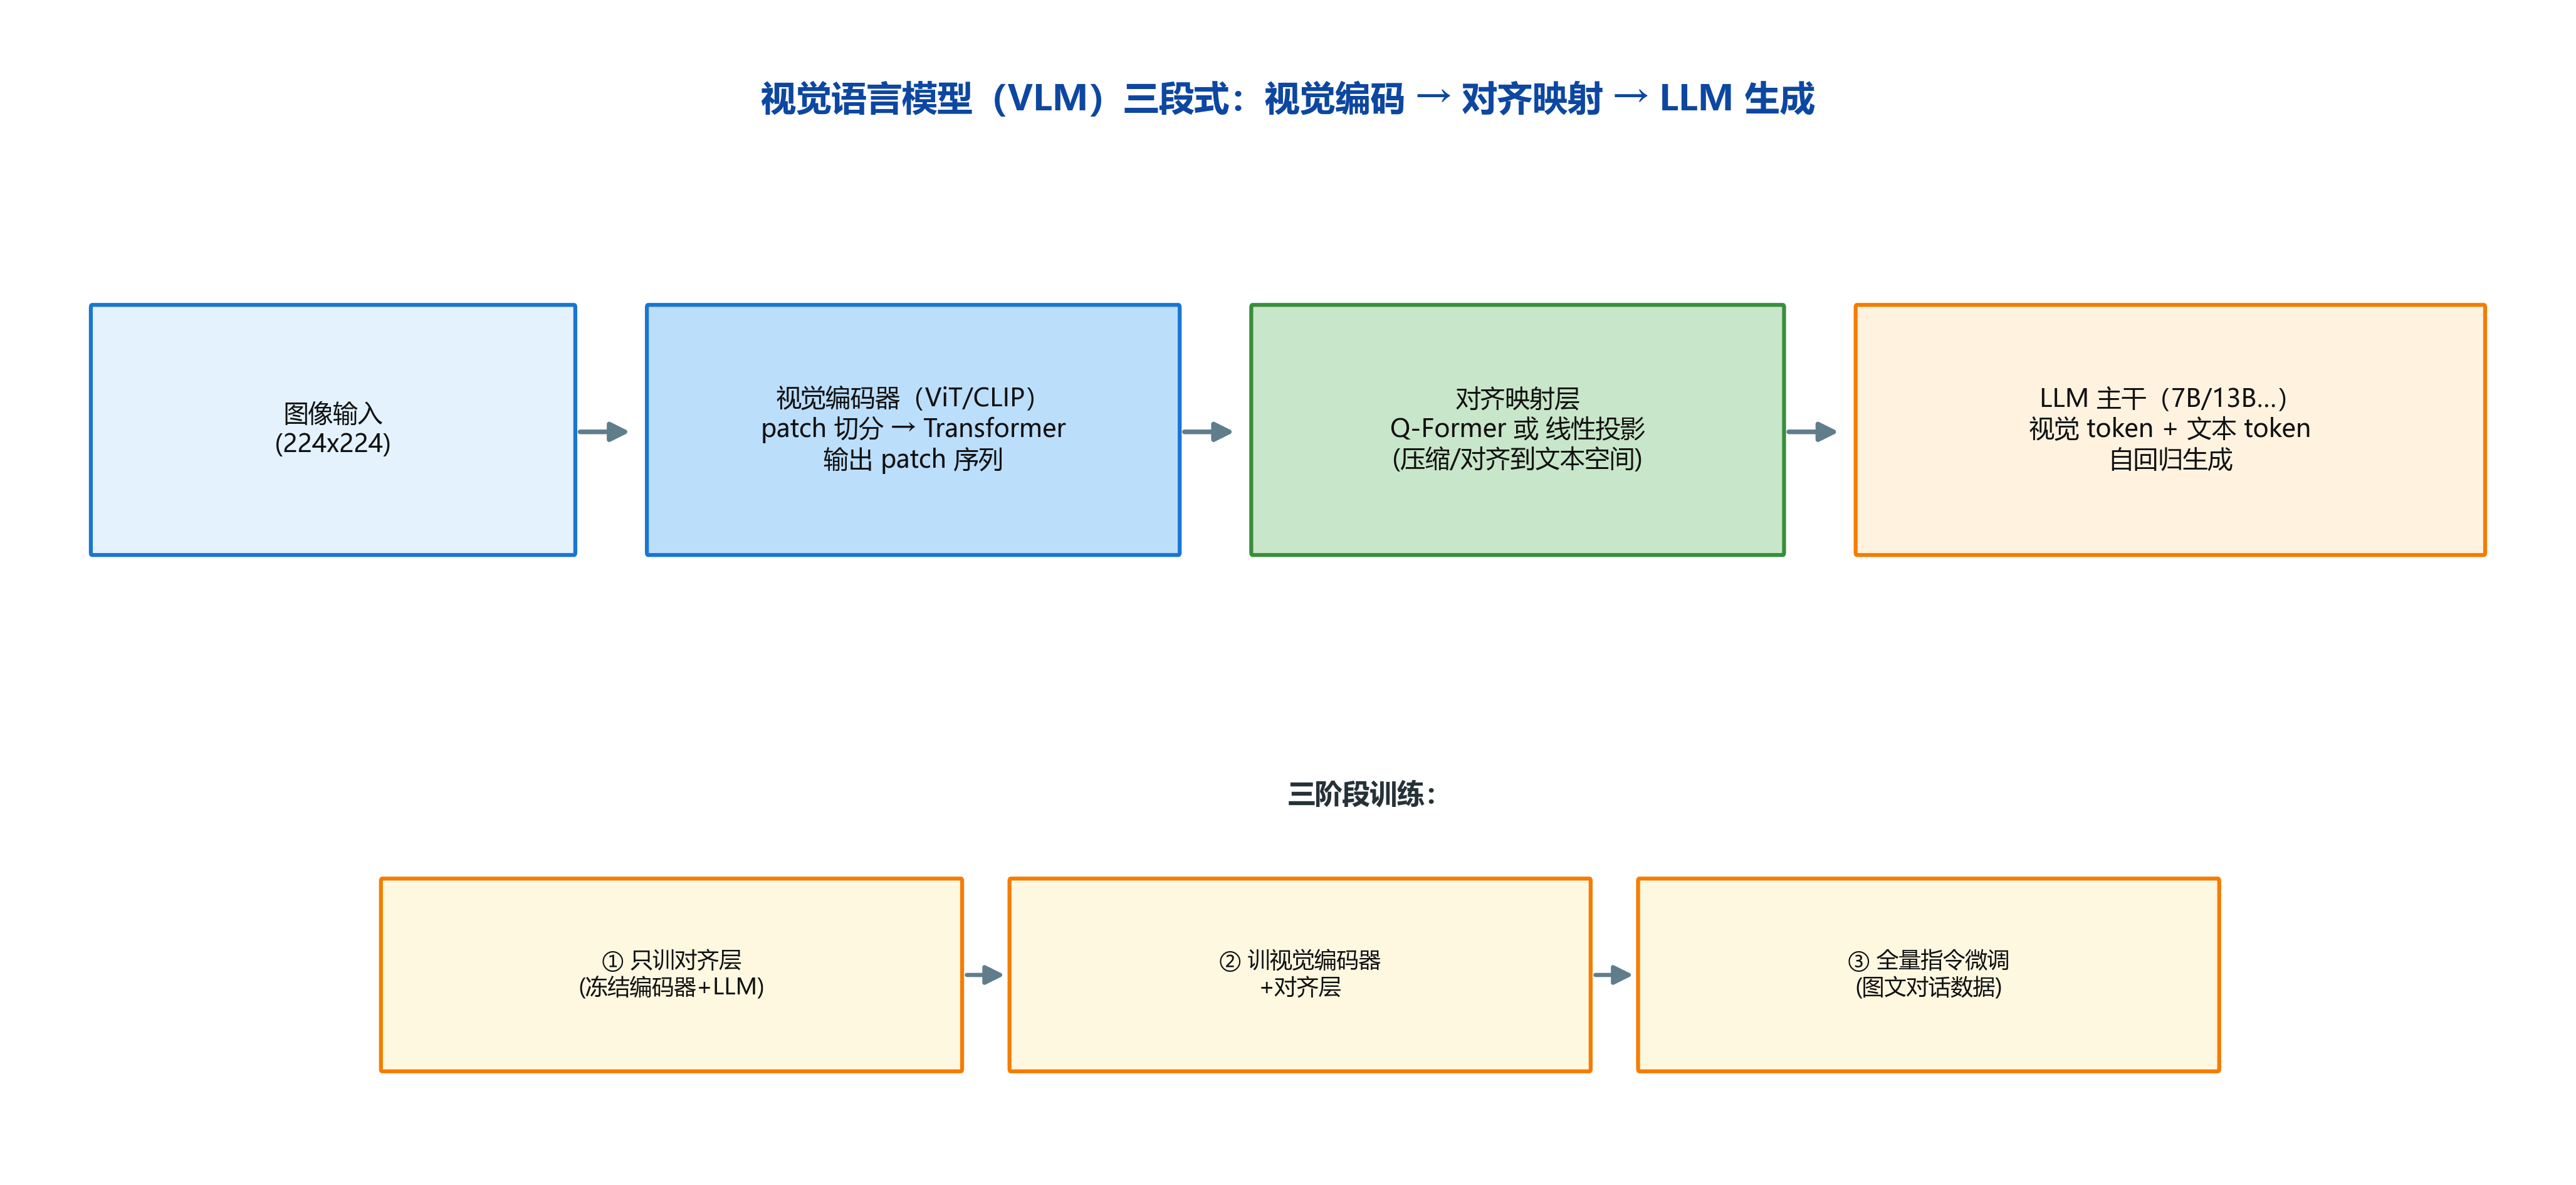
🔍 图解(自绘高清图,300dpi,可放大):视觉语言模型(VLM)的标准三段式架构——
- ① 视觉编码器(左):图像输入(可带文本指令)经 ViT/CLIP 视觉塔切成 patch 编码成 视觉 token 序列(每块图像区域一个向量)——把"像素"翻译成"向量语言";
- ② 对齐映射(中):视觉 token 与 LLM 的 token 维度不一致,用投影层(Adapter/MLP) 或 Q-Former(BLIP-2)把视觉特征映射到 LLM 的语义空间—— Q-Former 用可学习 query 从视觉特征里提炼固定长度 token(更省显存、抗干扰);
- ③ LLM 生成(右):视觉 token 与文本指令拼接后送入 LLM,自回归生成回答文本—— 视觉信息以"前缀 token"形式参与,LLM 负责推理与语言组织;
- 训练策略(图的隐藏信息):LLaVA 两阶段——先冻结视觉塔+LLM 只训练投影层(对齐), 再全量微调;BLIP-2 先训 Q-Former 再训解码器;VLM 的"大脑"是 LLM,"眼睛"是视觉塔。
🎬 背景故事¶
CLIP 只会"认"图,不会"说"——怎么让模型看图说话?……
CLIP 学会了图文匹配,但只会点头(匹配/不匹配),不会开口描述。要让模型"看图说话"(VQA/对话),就需要把视觉和 LLM 接起来。怎么接?这就是视觉语言模型(VLM)要解决的核心问题。本节对比两条路线:BLIP-2 用 Q-Former 压缩视觉信息,LLaVA 用一层线性投影直接对齐,并讲透三阶段训练。
🧭 本节逻辑主线:VLM 要解决什么 → 架构怎么拼(视觉编码器+对齐层+LLM)→ 两条对齐路线对比 → 三阶段训练为什么这么安排 → 推理流程。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | VLM 怎么把图像接进 LLM? | 视觉 token → 对齐层 → 语言模型 |
| 2 | BLIP-2 怎么对齐? | Q-Former(可学习 query) |
| 3 | LLaVA 怎么对齐? | 线性投影 + 指令微调 |
| 4 | 两类方法怎么选? | 冻结/微调、能力平衡 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ VLM 总体架构(必背)¶
print('''通用 VLM 架构:
  图像 -> 视觉编码器(ViT) -> 视觉 token(如 256/576 个)
       -> 对齐层(Projector/Q-Former/MLP)
       -> 语言模型(LLM) -> 文本输出

两条主流路线:
  A. Q-Former(BLIP-2):可学习 query 与视觉特征交叉注意力,压缩视觉信息;
  B. 线性/MLP 投影(LLaVA):视觉 token 直接投影进 LLM 的 embedding 空间;
  C. 原生多模态(最新):LLM 内部直接处理多模态 token(如 Qwen-VL、Gemini 的做法)。
''')
通用 VLM 架构:
  图像 -> 视觉编码器(ViT) -> 视觉 token(如 256/576 个)
       -> 对齐层(Projector/Q-Former/MLP)
       -> 语言模型(LLM) -> 文本输出

两条主流路线:
  A. Q-Former(BLIP-2):可学习 query 与视觉特征交叉注意力,压缩视觉信息;
  B. 线性/MLP 投影(LLaVA):视觉 token 直接投影进 LLM 的 embedding 空间;
  C. 原生多模态(最新):LLM 内部直接处理多模态 token(如 Qwen-VL、Gemini 的做法)。
📐 公式推导:VLM 的"视觉 → token → 对齐 → 语言建模"¶
整体前向(以 LLaVA 式投影层 $W \in \mathbb{R}^{d_v \times d_l}$ 为例):视觉编码器把图像变 $m$ 个 patch 特征 $\mathbf{z}_v \in \mathbb{R}^{m \times d_v}$,投影到 LLM 嵌入空间并拼接文本 token 嵌入 $E_t$:
$$ \mathbf{H} = [\; \mathbf{z}_v W \;\|\; E_t \;] \in \mathbb{R}^{(m + n) \times d_l} $$
训练目标:LLM 自回归,只对文本部分计算交叉熵(视觉部分是条件输入,不预测):
$$ L = -\sum_{t} \log p_\theta\big( y_t \mid y_{<t},\; \mathbf{z}_v W \big), \qquad p_\theta(y_t \mid \cdot) = \mathrm{softmax}\big( W_{\mathrm{out}} \mathbf{h}_t \big)_{y_t} $$
BLIP-2 的 Q-Former(另一种对齐):$Q$ 个可学习 query $\mathbf{q} \in \mathbb{R}^{Q \times d}$ 通过交叉注意力从视觉特征提取信息:
$$ \mathrm{CrossAttn}(\mathbf{q}, \mathbf{z}_v) = \mathrm{softmax}\Big( \frac{\mathbf{q} W_Q (\mathbf{z}_v W_K)^\top}{\sqrt{d_k}} \Big) \, \mathbf{z}_v W_V \;\in\; \mathbb{R}^{Q \times d} $$
推导要点:① 投影/交叉注意力的作用是把视觉信息压缩成 LLM 能读的 token(256 patch → 32~64 token,省显存);② 冻结视觉塔与 LLM、只训对齐层的阶段设计,是为了让投影层先学会"翻译",再放开指令微调——分阶段防灾难性遗忘。
✍️ §2.1 手算 视觉-文本对齐打分:3 对 embedding 的余弦排序与 BLIP 三任务损失¶
对齐的本质是"打分排序":把图像与文本投到共同空间,手算 3 对特征的距离与排序,再看 BLIP 的三任务损失怎么组合。
设定:3 个图文对,视觉/文本 embedding 均为 2 维单位向量($(0.8,0.6)$ 是勾股数,长度恰为 1):
$$v_1=(1,0),\ v_2=(0,1),\ v_3=(0.8,0.6);\qquad t_1=(1,0),\ t_2=(0,1),\ t_3=(0.8,0.6)$$
第 1 步:余弦相似度矩阵 $S=V T^{\top}$
| 图像\↓文本 | $t_1$ | $t_2$ | $t_3$ |
|---|---|---|---|
| $v_1$ | 1.000 | 0.000 | 0.800 |
| $v_2$ | 0.000 | 1.000 | 0.600 |
| $v_3$ | 0.800 | 0.600 | 1.000 |
第 2 步:每个图像 query 的文本排序(降序)
- $v_1$ → $t_1(1.00)>t_3(0.80)>t_2(0.00)$:命中 $t_1$ ✓
- $v_2$ → $t_2(1.00)>t_3(0.60)>t_1(0.00)$:命中 $t_2$ ✓
- $v_3$ → $t_3(1.00)>t_1(0.80)>t_2(0.60)$:命中 $t_3$ ✓
top-1 命中 3/3(100%),对角线平均打分 1.000。($v_3$ 与 $t_1$ 也有 0.8 的相似度——这就是"难负样本",对齐训练的关键对象。)
第 3 步:BLIP 三任务损失组合(ITC 图文对比 + ITM 图文匹配 + LM 语言建模,等权平均):
$$L=\frac{L_{\text{ITC}}+L_{\text{ITM}}+L_{\text{LM}}}{3}=\frac{0.42+0.36+0.30}{3}=\frac{1.08}{3}=0.36$$
手算收获:
- 打分排序就是检索:只要正确文本排 top-1 就命中——对齐训练(ITC)的本质是把"对角分数 vs 非对角分数"的差距拉大,让 $v_3$ 不会误配 $t_1$
- BLIP 三任务各司其职:ITC 拉近正对、ITM 做细粒度二分类、LM 做生成——组合损失等权平均(实际可按阶段调权),是"对齐+判别+生成"三合一
- 单位向量让点积=余弦,排序只看相对大小——手算前提是归一化,真实实现同样"先归一化、再点积"(与 00 的 CLIP 一致)
- 面试速答:对齐层(Q-Former / 线性投影)的唯一任务就是"把跨模态打分排序调对",Retrieval@1 是最直观的验收指标
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算 视觉-文本对齐打分 ----
import numpy as np

hc_v = np.array([[1.0, 0.0], [0.0, 1.0], [0.8, 0.6]])
hc_t = np.array([[1.0, 0.0], [0.0, 1.0], [0.8, 0.6]])
hc_S = hc_v @ hc_t.T
print('余弦相似度矩阵 =\n', np.round(hc_S, 4))
assert np.allclose(hc_S, [[1, 0, 0.8], [0, 1, 0.6], [0.8, 0.6, 1]], atol=1e-9)

hc_hits = sum(1 for i in range(3) if np.argmax(hc_S[i]) == i)
print(f'top-1 命中 = {hc_hits}/3,对角线平均打分 = {np.mean(np.diag(hc_S)):.4f}')
assert hc_hits == 3

hc_L = (0.42 + 0.36 + 0.30) / 3
print('BLIP 三任务组合损失 =', round(hc_L, 4))
assert abs(hc_L - 0.36) < 1e-9
print('\n✓ 与手算一致:排序 3/3 全中、组合损失 0.36')
2️⃣ 手写"视觉 token → 对齐 → LLM" 流程¶
# 🖼️ 配图:VLM 一条龙——图像进、文字出(LLaVA 式架构)
fig, ax = plt.subplots(figsize=(8.5, 4.2))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.6)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9.3)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=2))

box(0.4, 3.1, 2.0, 1.0, '图像', '#e2e8f0')
arrow(1.4, 3.1, 1.4, 2.5)
box(0.4, 1.6, 2.0, 0.9, '视觉编码器\n(ViT)', '#bfdbfe')
arrow(1.4, 1.6, 1.4, 1.0)
box(0.4, 0.2, 2.0, 0.8, '视觉 token\n(576 个)', '#dbeafe')

box(3.1, 0.2, 2.2, 0.8, '投影层 W\n(对齐到词空间)', '#fde68a')
arrow(2.5, 0.6, 3.0, 0.6)

box(5.9, 1.9, 2.4, 2.3, 'LLM\n(冻结或微调)\n\n自回归生成\n<|v|>图 token\n+ 文本提示\n→ 回答', '#bbf7d0')
box(5.9, 0.2, 2.4, 0.8, '文本 token\n(问题/指令)', '#fef9c3')
arrow(4.7, 0.6, 5.8, 1.2); arrow(5.9, 1.6, 8.3, 2.4)

box(8.7, 2.6, 1.1, 1.3, '回答\n文本', '#fecaca')
arrow(8.3, 3.1, 8.6, 3.2)
plt.title('LLaVA 式 VLM:视觉 token 投影进 LLM 空间 → 自回归生成回答', fontsize=10.5)
plt.show()
print('➡️ 图像信息通过投影层进入 LLM 的 token 序列,LLM 把它当"额外输入 token"处理')
➡️ 图像信息通过投影层进入 LLM 的 token 序列,LLM 把它当"额外输入 token"处理
C:\Users\24260\AppData\Local\Temp\ipykernel_31132\855794783.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 模拟:视觉编码器输出 256 个 patch 特征;LLM 输入空间 4096 维
n_visual = 256
vis_feat = rng.normal(0, 1, (n_visual, 1024))      # 视觉特征(如 ViT 输出)

# 路线 A:Q-Former 压缩到 32 个 query(简化:query 与视觉特征做注意力池化)
n_query = 32
Q = rng.normal(0, 0.1, (n_query, 1024))            # 可学习 query
scores = Q @ vis_feat.T / np.sqrt(1024)
attn_w = np.exp(scores - scores.max(axis=1, keepdims=True))
attn_w = attn_w / attn_w.sum(axis=1, keepdims=True)
qformer_out = attn_w @ vis_feat                     # (32, 1024)
print(f'Q-Former: {n_visual} 个视觉 token -> {n_query} 个 query(信息压缩)')

# 路线 B:线性投影直接把视觉 token 投到 LLM 空间
proj = rng.normal(0, 0.1, (1024, 4096))
llm_input_proj = vis_feat @ proj                    # (256, 4096)
print(f'线性投影: (256, 1024) -> {llm_input_proj.shape}')
assert qformer_out.shape == (n_query, 1024) and llm_input_proj.shape == (256, 4096)
print('✅ 两条对齐路线都能把视觉信息接入 LLM')
Q-Former: 256 个视觉 token -> 32 个 query(信息压缩)
线性投影: (256, 1024) -> (256, 4096)
✅ 两条对齐路线都能把视觉信息接入 LLM
3️⃣ 对齐训练三阶段(BLIP-2/LLaVA 风格)¶
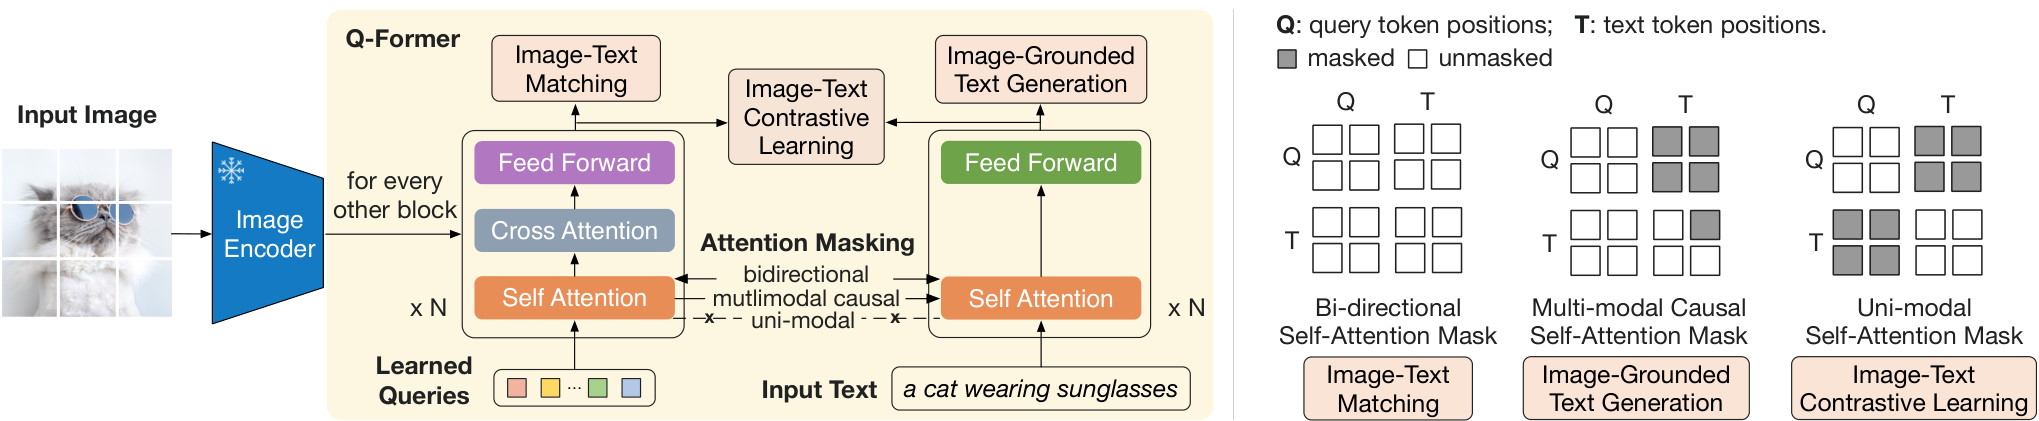
📄 经典论文原图:BLIP-2 Q-Former 架构
🔍 图解与逻辑衔接:图左是冻结的图像编码器,输出大量视觉 patch 特征;中间的 Q-Former 使用少量可学习 query 从视觉特征中提炼固定长度的视觉 token;右侧是冻结的大语言模型,接收这些 token 后生成文本。图中两阶段训练分别对应:第一阶段让 query 学会从图像中抽取有用信息,第二阶段让抽取出的 token 与 LLM 语义空间对齐。它解释了本节为什么不把全部视觉 patch 直接塞进 LLM:Q-Former 既压缩 token 数,又把视觉信息过滤成语言模型更容易使用的形式。
论文出处:Li et al., “BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models”, ICML 2023(arXiv:2301.12597),Figure 2。
print('''三阶段训练范式:
  阶段1:冻结视觉编码器+LLM,只训对齐层(图像-文本对比/生成对齐);
  阶段2:冻结视觉编码器+对齐层,微调 LLM(指令微调,学会看图回答);
  阶段3(可选):全量微调 / 视觉语言联合 SFT / RLHF。

面试点:
  为什么冻结?→ 省显存、防灾难性遗忘、对齐层先学会"翻译";
  视觉 token 太多怎么办?→ Q-Former 压缩 / 平均池化 / 视觉 token 降采样;
  训练数据?→ 图文对(预训练) + 指令数据(微调,如 LLaVA-Instruct)。
''')
三阶段训练范式:
  阶段1:冻结视觉编码器+LLM,只训对齐层(图像-文本对比/生成对齐);
  阶段2:冻结视觉编码器+对齐层,微调 LLM(指令微调,学会看图回答);
  阶段3(可选):全量微调 / 视觉语言联合 SFT / RLHF。

面试点:
  为什么冻结?→ 省显存、防灾难性遗忘、对齐层先学会"翻译";
  视觉 token 太多怎么办?→ Q-Former 压缩 / 平均池化 / 视觉 token 降采样;
  训练数据?→ 图文对(预训练) + 指令数据(微调,如 LLaVA-Instruct)。
4️⃣ 图文对话推理流程(示意)¶
print('''推理流程(以 LLaVA 为例):
  1. 用户上传图片
  2. ViT 编码 -> 576 个视觉 token
  3. MLP 投影 -> LLM embedding 空间
  4. 拼接文本指令 token(如 "请描述这张图")
  5. LLM 自回归生成回答

示例:
  图片:一只橘猫在窗台晒太阳
  指令:Describe the image.
  回答:A ginger cat is lying on a windowsill, basking in the sunlight.
''')
sample_visual = rng.normal(0, 1, (5, 1024))  # 5 个示例 token(象征性)
print('视觉 token 示例 (5, 1024):', sample_visual.shape)
推理流程(以 LLaVA 为例):
  1. 用户上传图片
  2. ViT 编码 -> 576 个视觉 token
  3. MLP 投影 -> LLM embedding 空间
  4. 拼接文本指令 token(如 "请描述这张图")
  5. LLM 自回归生成回答

示例:
  图片:一只橘猫在窗台晒太阳
  指令:Describe the image.
  回答:A ginger cat is lying on a windowsill, basking in the sunlight.

视觉 token 示例 (5, 1024): (5, 1024)
5️⃣ BLIP vs LLaVA(面试对比)¶
📄 经典论文原图:LLaVA 视觉指令微调架构
🔍 图解与逻辑衔接:图中视觉输入先经过 CLIP ViT 视觉塔,再经过一个线性投影层,把视觉特征映射到 LLM 的 token 维度,最后与用户指令一起送入语言模型生成回答。第一阶段只训练投影层,让视觉向量进入 LLM 的语义空间;第二阶段使用图文指令数据训练完整对话能力。与 BLIP-2 的 Q-Former 对照阅读:LLaVA 采用更简单的线性 projector,结构更轻;BLIP-2 用 query 机制压缩和筛选视觉信息。两者都解决同一个核心问题:视觉编码器和 LLM 之间如何对齐。
论文出处:Liu et al., “Visual Instruction Tuning”, NeurIPS 2023(arXiv:2304.08485),Figure 2。
print('''| 维度 | BLIP-2 | LLaVA |
|---|---|---|
| 对齐方式 | Q-Former(交叉注意力压缩) | 简单 MLP/线性投影 |
| 视觉信息 | 压缩到固定 query 数 | 保留全部 token(可加池化) |
| 参数量 | 中 | 轻 |
| 优点 | 对齐更充分、信息压缩可控 | 简单、微调成本低、社区迭代快 |
| 缺点 | 结构复杂、训练分阶段 | 视觉细节保留欠佳(早期版本) |
| 代表 | BLIP-2 / InstructBLIP | LLaVA-1.5/1.6 |

演进趋势:Qwen-VL/Gemini/Llama-3.2-Vision 走向"统一原生多模态"。
''')
| 维度 | BLIP-2 | LLaVA |
|---|---|---|
| 对齐方式 | Q-Former(交叉注意力压缩) | 简单 MLP/线性投影 |
| 视觉信息 | 压缩到固定 query 数 | 保留全部 token(可加池化) |
| 参数量 | 中 | 轻 |
| 优点 | 对齐更充分、信息压缩可控 | 简单、微调成本低、社区迭代快 |
| 缺点 | 结构复杂、训练分阶段 | 视觉细节保留欠佳(早期版本) |
| 代表 | BLIP-2 / InstructBLIP | LLaVA-1.5/1.6 |

演进趋势:Qwen-VL/Gemini/Llama-3.2-Vision 走向"统一原生多模态"。
6️⃣ 视觉 token 数量的权衡(高频追问)¶
# 视觉 token 数直接决定 LLM 输入长度与显存
for n in [64, 256, 576, 1024]:
    print(f'视觉 token {n} 个:序列长度=文本+n,注意力 O((T+n)^2)')
print('''
  少(token):推理快、显存省,但细粒度信息丢失(认不清小物体/文字);
  多(token):细节好,但计算贵、长上下文压力大;
  方案:分辨率分桶/降采样/视觉 token 压缩/只看 ROI 区域。
''')
视觉 token 64 个:序列长度=文本+n,注意力 O((T+n)^2)
视觉 token 256 个:序列长度=文本+n,注意力 O((T+n)^2)
视觉 token 576 个:序列长度=文本+n,注意力 O((T+n)^2)
视觉 token 1024 个:序列长度=文本+n,注意力 O((T+n)^2)

  少(token):推理快、显存省,但细粒度信息丢失(认不清小物体/文字);
  多(token):细节好,但计算贵、长上下文压力大;
  方案:分辨率分桶/降采样/视觉 token 压缩/只看 ROI 区域。
🎯 真实案例:视觉 token 压缩——省显存的量化账¶
背景:LLM 显存大头之一是 KV Cache,它与序列长度成正比。 视觉 token 越多,LLM 输入序列越长 → KV Cache 越大 → 显存越紧。 本节用真实公式算一笔账:一张图 576 个视觉 token vs Q-Former 压缩成 32 个, KV Cache 省多少、注意力计算省多少。
公式回顾(06 篇有完整推导):
- KV Cache 大小 ≈ 2 × 层数 × 头数 × 头维 × 序列长度 × 2 字节;
- 自注意力计算量 ≈ 序列长度² × 头维。
步骤分解:设具体模型参数 → 算两种方案的 KV 与 FLOPs → 对比 → 结论(为什么都要压缩视觉 token)。
# ===== 案例:视觉 token 压缩的显存与计算账 =====
layers, n_heads, head_dim = 32, 32, 128     # 常见 7B 级 LLM 配置
text_tokens = 50                            # 一段指令+回答的文本长度
def kv_mb(visual_tokens):
    L = text_tokens + visual_tokens
    bytes_total = 2 * layers * n_heads * head_dim * L * 2   # K 和 V 各一份,FP16=2B
    return bytes_total / 2**20
def attn_flops(visual_tokens):
    L = text_tokens + visual_tokens
    return 2 * L * L * head_dim * layers                    # 简化:每层 2·L²·d 次乘加

for vt, name in [(576, '原始视觉 token(LLaVA)'), (256, '视觉 token(一般)'), (32, 'Q-Former 压缩(BLIP-2)')]:
    print(f'{name:>28}: 序列 {text_tokens + vt:>4} | KV Cache {kv_mb(vt):7.2f} MB | 注意力 FLOPs {attn_flops(vt)/1e9:8.2f} G')

print()
print(f'Q-Former 压缩 vs 原始: KV Cache 省 {100 * (1 - kv_mb(32) / kv_mb(576)):.0f}%, '
      f'注意力 FLOPs 省 {100 * (1 - attn_flops(32) / attn_flops(576)):.0f}%')
print('➡️ 这就是工业上"视觉 token 压缩/降采样"的原因:多模态推理很吃显存')
assert kv_mb(32) < kv_mb(576)
print('✅ 真实案例完成:视觉 token 数量直接决定多模态推理的显存与速度')
           原始视觉 token(LLaVA): 序列  626 | KV Cache  313.00 MB | 注意力 FLOPs     3.21 G
                视觉 token(一般): 序列  306 | KV Cache  153.00 MB | 注意力 FLOPs     0.77 G
         Q-Former 压缩(BLIP-2): 序列   82 | KV Cache   41.00 MB | 注意力 FLOPs     0.06 G

Q-Former 压缩 vs 原始: KV Cache 省 87%, 注意力 FLOPs 省 98%
➡️ 这就是工业上"视觉 token 压缩/降采样"的原因:多模态推理很吃显存
✅ 真实案例完成:视觉 token 数量直接决定多模态推理的显存与速度
📝 自测清单¶
- 能画出 VLM 通用架构(视觉编码器→对齐层→LLM)
- 能讲清 Q-Former 与线性投影两条对齐路线
- 能背出三阶段训练范式与冻结原因
- 能对比 BLIP-2 与 LLaVA 的优劣
- 能回答"视觉 token 太多/太少怎么办"追问