🔁 24-信号处理 · 09 自适应滤波与 LMS¶
关键词:LMS、收敛、步长、学习率 固定滤波器解决不了"噪声随时间变"的问题——自适应滤波在线更新系数,LMS 是最经典最简的实现。
本节要解决的问题¶
| # | 问题 | 对应内容 |
|---|---|---|
| 1 | 自适应滤波解决什么问题? | §1 核心概念 |
| 2 | LMS 更新公式怎么手算三步? | §2 手算 ✍️ |
| 3 | 步长 μ 怎么选才不会发散? | §3 深入原理 |
| 4 | 应用:回声消除/降噪/系统辨识 | §4 代码实战 |
故事引入¶
免提通话时喇叭的声音又回到麦克风——回音路径随房间/人移动而变,固定滤波器永远对不齐。自适应滤波器实时观测误差、在线调整系数,把"未知时变系统"一点点学出来。
自适应滤波器在真实系统里是怎么接线的?下图(右侧示意)展示了 LMS 的在线工作模式:输入 x 经权向量 w 得到输出 y,与期望 d 比较得到误差 e,误差又驱动权重更新——一条"前向滤波 + 反向更新"的闭环。这和我们 §4 手推的 w←w+μex 三步更新完全对应。
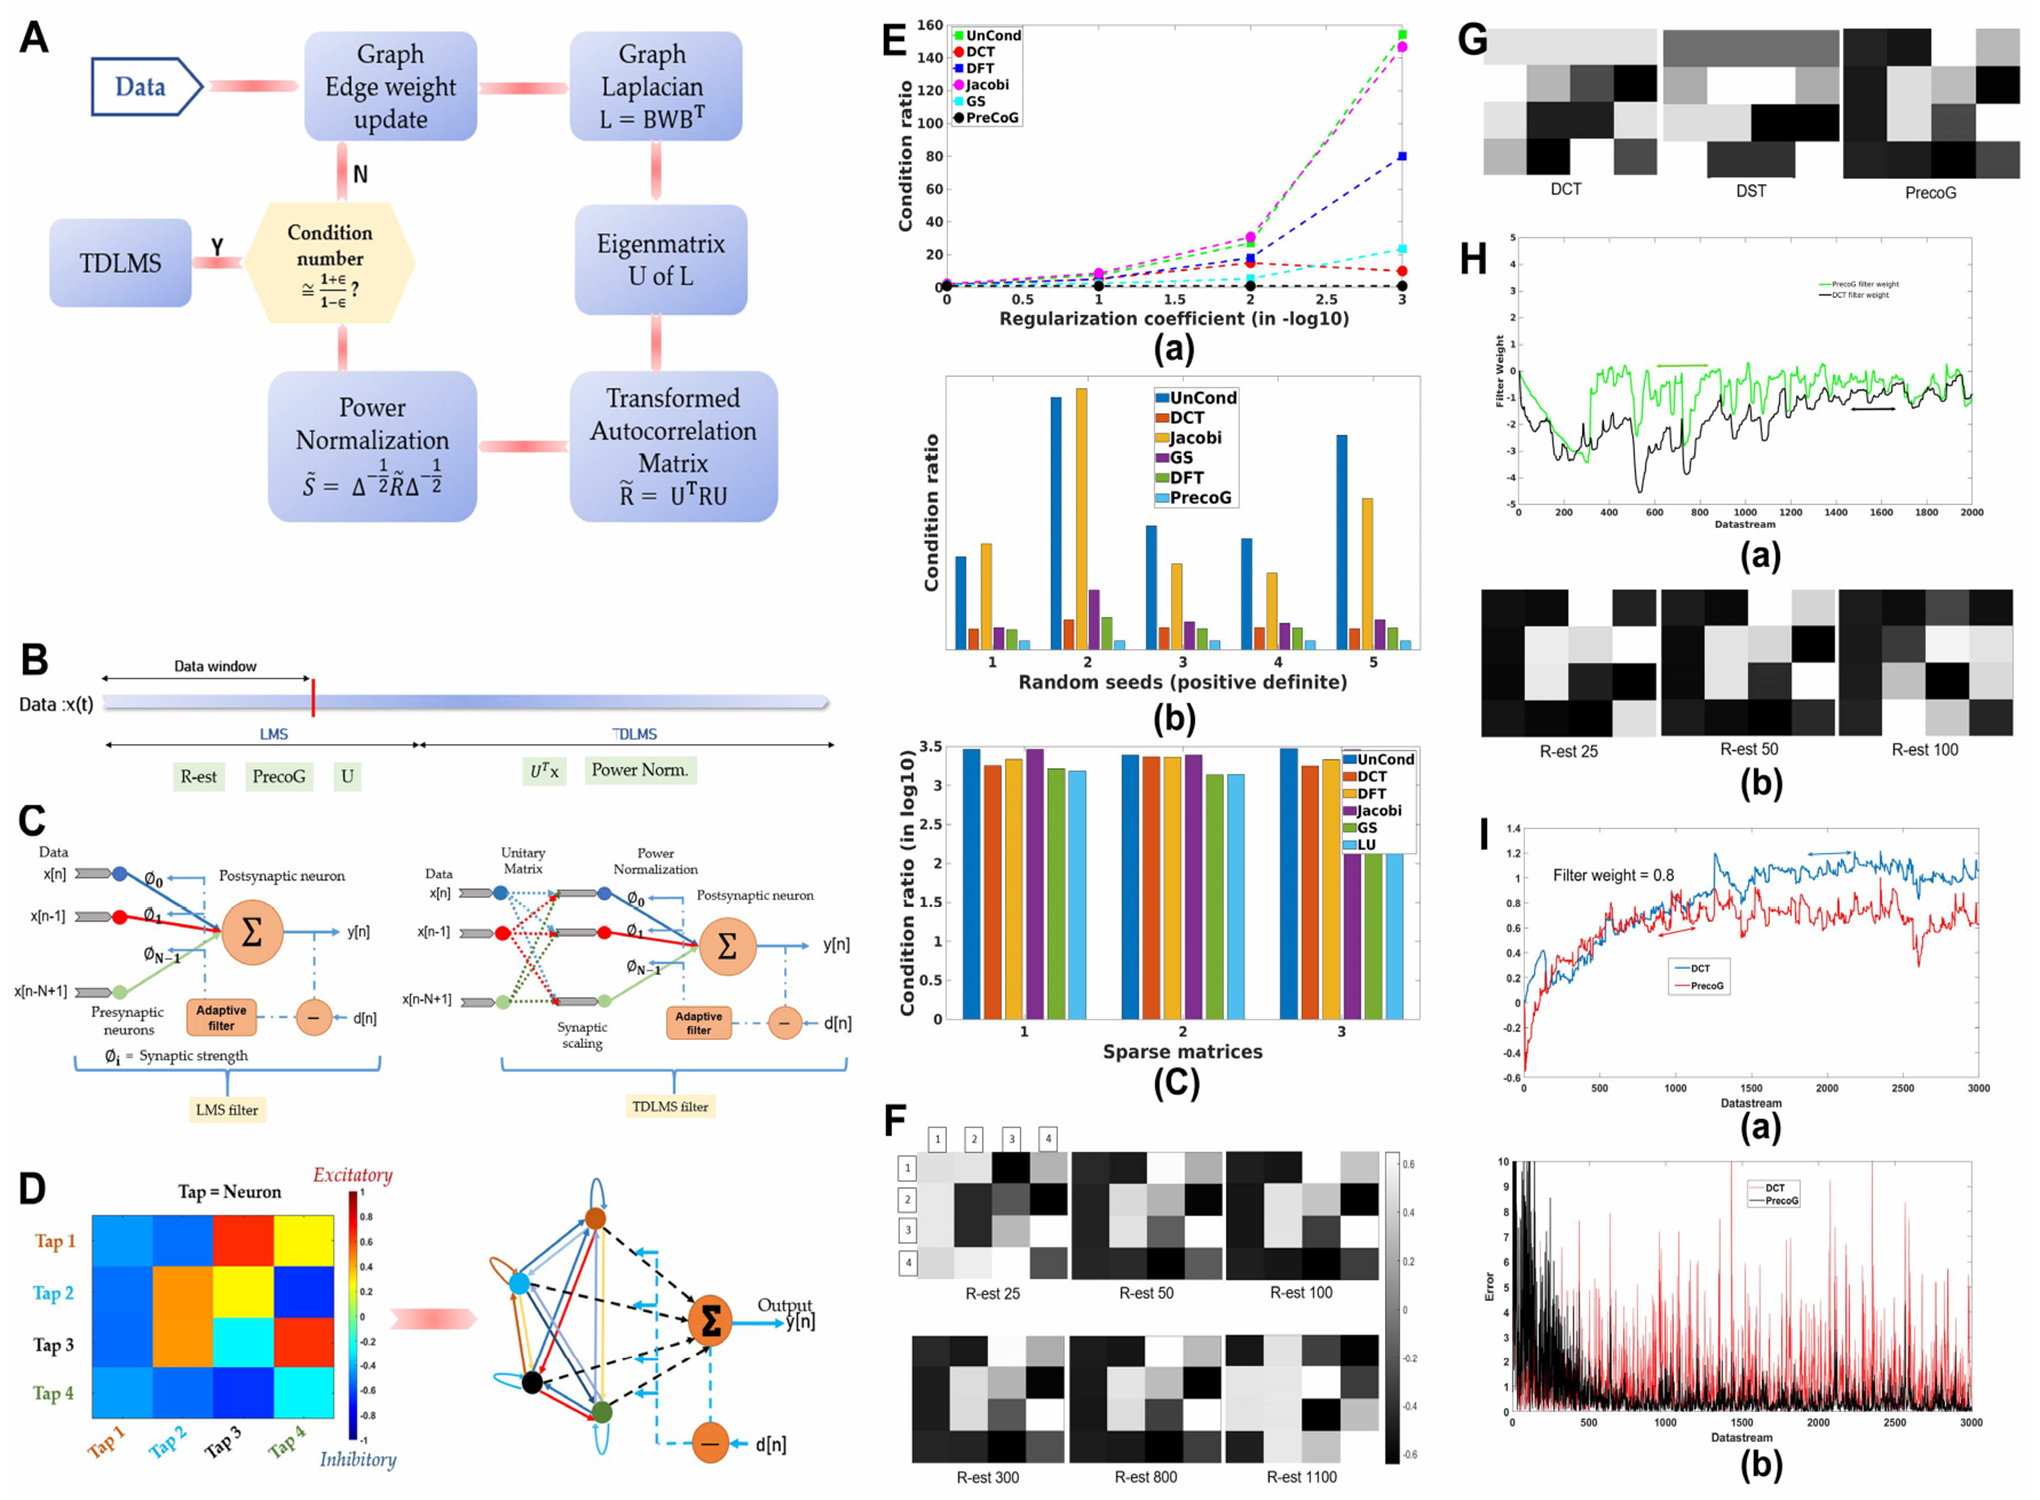
怎么读:看闭环结构:前向路径是滤波(y = wᵀx),下方回环是权重更新(w += μex)。没有这条回环,权重就无法自适应;有了它,滤波器才能在信道变化时持续跟踪——这正是回声消除等场景需要的"永远在学"的滤波器。
📚 图源:Batabyal T et al. (2023) Efficient Learning of Transform-Domain LMS Filter Using Graph Laplacian, IEEE TNNLS 34(10)(开放获取)图 1。
核心概念¶
系统辨识结构:未知系统 $w_{\text{opt}}$,输入 $x[n]$,期望输出 $d[n]=w_{\text{opt}}^\top x[n]+v[n]$;自适应滤波器 $w[n]$ 逼近 $w_{\text{opt}}$。
LMS 更新(最速下降的随机近似):
$$e[n]=d[n]-w[n]^\top x[n]$$
$$w[n+1]=w[n]+\mu\,e[n]\,x[n]$$
直觉:误差大 → 沿 $x$ 方向大步修正;没有误差 → 不再更新。
✍️ 手算 LMS 三步:μ=0.5, w_opt=[2,-1]¶
设定:真权重 $w_{\text{opt}}=[2,-1]$,固定激励 $x=[1,0.5]$,期望 $d=2\cdot1+(-1)\cdot0.5=1.5$,步长 $\mu=0.5$,初值 $w=[0,0]$。
第 1 步
$$e_1=1.5-0=\mathbf{1.5},\qquad w=[0,0]+0.5\times1.5\times[1,0.5]=[\mathbf{0.75},\mathbf{0.375}]$$
第 2 步
$$e_2=1.5-(0.75+0.375\times0.5)=1.5-0.9375=\mathbf{0.5625}$$
$$w=[0.75,0.375]+0.5\times0.5625\times[1,0.5]=[\mathbf{1.03125},\mathbf{0.515625}]$$
第 3 步
$$e_3=1.5-(1.03125+0.515625\times0.5)=1.5-1.2891=\mathbf{0.2109}$$
误差序列 $1.5\to0.5625\to0.2109$ 单调收敛。
手算收获:
- 每步更新量 $=\mu e x$:误差大时大改、误差小时微调——最速下降的随机版
- 固定激励下误差单调减:LMS 沿梯度把 $w\to w_{\text{opt}}=[2,-1]$;真实场景随机输入,误差在均值附近波动
- 步长 μ 与收敛/稳定矛盾:μ 大收敛快但抖动大,μ 小稳而慢(§3 界限)
- 应用三件套:系统辨识、回声消除(NLMS 归一化)、自适应均衡;语音增强用它与降噪组合(§04/§16-05 衔接)
# ---- §2.1 验证:numpy 复算 LMS 三步 ----
import numpy as np
mu, w_opt = 0.5, np.array([2.0, -1.0])
x = np.array([1.0, 0.5])
d = w_opt @ x
w = np.zeros(2)
errs = []
for _ in range(3):
    e = d - w @ x
    errs.append(e)
    w = w + mu * e * x
print('误差序列:', [round(float(e), 4) for e in errs])
print('w 最终:', np.round(w, 4).tolist())
assert abs(float(errs[0]) - 1.5) < 1e-9 and abs(float(errs[1]) - 0.5625) < 1e-9 and abs(float(errs[2]) - 0.2109) < 0.001
assert errs[2] < errs[1] < errs[0]
print('\n✓ 与手算一致')
误差序列: [1.5, 0.5625, 0.2109]
w 最终: [1.1367, 0.5684]

✓ 与手算一致
深入原理:收敛条件与改进¶
收敛条件(输入相关阵 $R=E[xx^\top]$,特征值 $\lambda_{\max}$):
$$0<\mu<\frac{2}{\lambda_{\max}}\ \text{(稳定)};\qquad \text{收敛时间常数}\ \tau\approx\frac{1}{\mu\lambda_{\min}}$$
步长上界由最大特征值决定,收敛速度由最小特征值拖累——特征值分散时 LMS 慢(本征值扩展问题)。
改进:
- NLMS:$\mu_n=\frac{\tilde\mu}{\epsilon+\|x\|^2}$——按输入能量归一化,步长自适应
- RLS:用协方差递推逐样本修正,收敛快 10x 但 $O(N^2)$ 计算
- 语音场景常用 NLMS 回声消除(收敛 + 数值稳定)
代码实战:交替激励 20 步收敛到真值¶
注意:单一固定激励的 LMS 只能学到 $\text{span}(x)$ 上的投影(秩 1 输入无法辨识二维权重)。用两个线性无关激励交替激励,20 步逼近 $w_{\text{opt}}=[2,-1]$:
# ---- LMS 交替激励 20 步收敛 ----
import numpy as np
w_opt = np.array([2.0, -1.0])
mu = 0.4
xs = [np.array([1.0, 0.5]), np.array([0.5, -1.0])]      # 线性无关激励
d = [w_opt @ x for x in xs]
w = np.zeros(2)
for i in range(20):
    x, dd = xs[i % 2], d[i % 2]
    e = dd - w @ x
    w = w + mu * e * x
print(f'20 步后 w = {np.round(w, 4).tolist()}(真值 [2, -1])')
dist = np.linalg.norm(w - w_opt)
print(f'距离真值: {dist:.4f}')
assert dist < 0.05
print('✓ 线性无关激励下 LMS 收敛到真权重(单激励只够学投影)')
20 步后 w = [1.998, -0.999](真值 [2, -1])
距离真值: 0.0022
✓ 线性无关激励下 LMS 收敛到真权重(单激励只够学投影)
面试考点¶
Q1:LMS 和维纳滤波的关系?
维纳解 $w^*=R^{-1}p$ 是 MSE 最优解(批处理、需统计量);LMS 用瞬时梯度随机逼近它,不需求逆、可在线。
Q2:μ 怎么定?
上界 $2/\lambda_{\max}$(输入功率可控时用 $2/(N\,P_x)$ 粗估);太大发散、太小收敛慢。
Q3:语音增强里自适应滤波怎么用?
噪声参考信号 → 自适应估计"频谱增益/噪声转移函数",从主麦克风信号中减去(谱减的进阶);或多个麦克风做自适应波束成形(§16-05 衔接)。
Q4:NLMS 为什么比 LMS 稳?
除以输入能量归一化,输入大时不失控;空参考/静音时也稳定。
小结与下一章预告¶
- LMS:$e=d-w^\top x$,$w\leftarrow w+\mu e x$;手算三步 $1.5\to0.5625\to0.2109$ 收敛
- μ 界 $<2/\lambda_{\max}$;NLMS/RLS 是实用改进
- 自适应滤波 = 机器学习的"在线梯度下降"——与优化/模型训练同构,衔接 02-机器学习
✅ 自测清单¶
- 能手算 LMS 三步更新(误差单调收敛)
- 能说出 μ 的稳定上界与 NLMS 的归一化
- 知道 LMS 与维纳滤波、RLS 的关系
- 能举出自适应滤波应用(回声消除/均衡/降噪)