🎤 07 · 推荐系统面试八股与工业流程
最后冲刺:60+ 高频问题速答 + 工业链路细节 + 常见坑。目标是能把「一条推荐系统的完整故事」讲顺。
🎬 背景故事
面试官说:'给我 5 分钟,把推荐系统讲一遍'……
秋招面试最常见的开场:"给我 5 分钟,把推荐系统讲一遍。" 这考验的不是你会几个模型,而是能不能把整条链路、每层的坑、每个指标的坑,串成一个逻辑自洽的故事。本节就是帮你把这个"5 分钟故事"准备好,并手撕两个最高频的代码题(多路合并去重、贪心打散)。
🧭 本节逻辑主线:一条链路(召回→粗排→精排→重排→AB)→ 每层的候选量与坑 → 16+ 高频速答 → 两个手撕 → 90 秒背诵骨架。
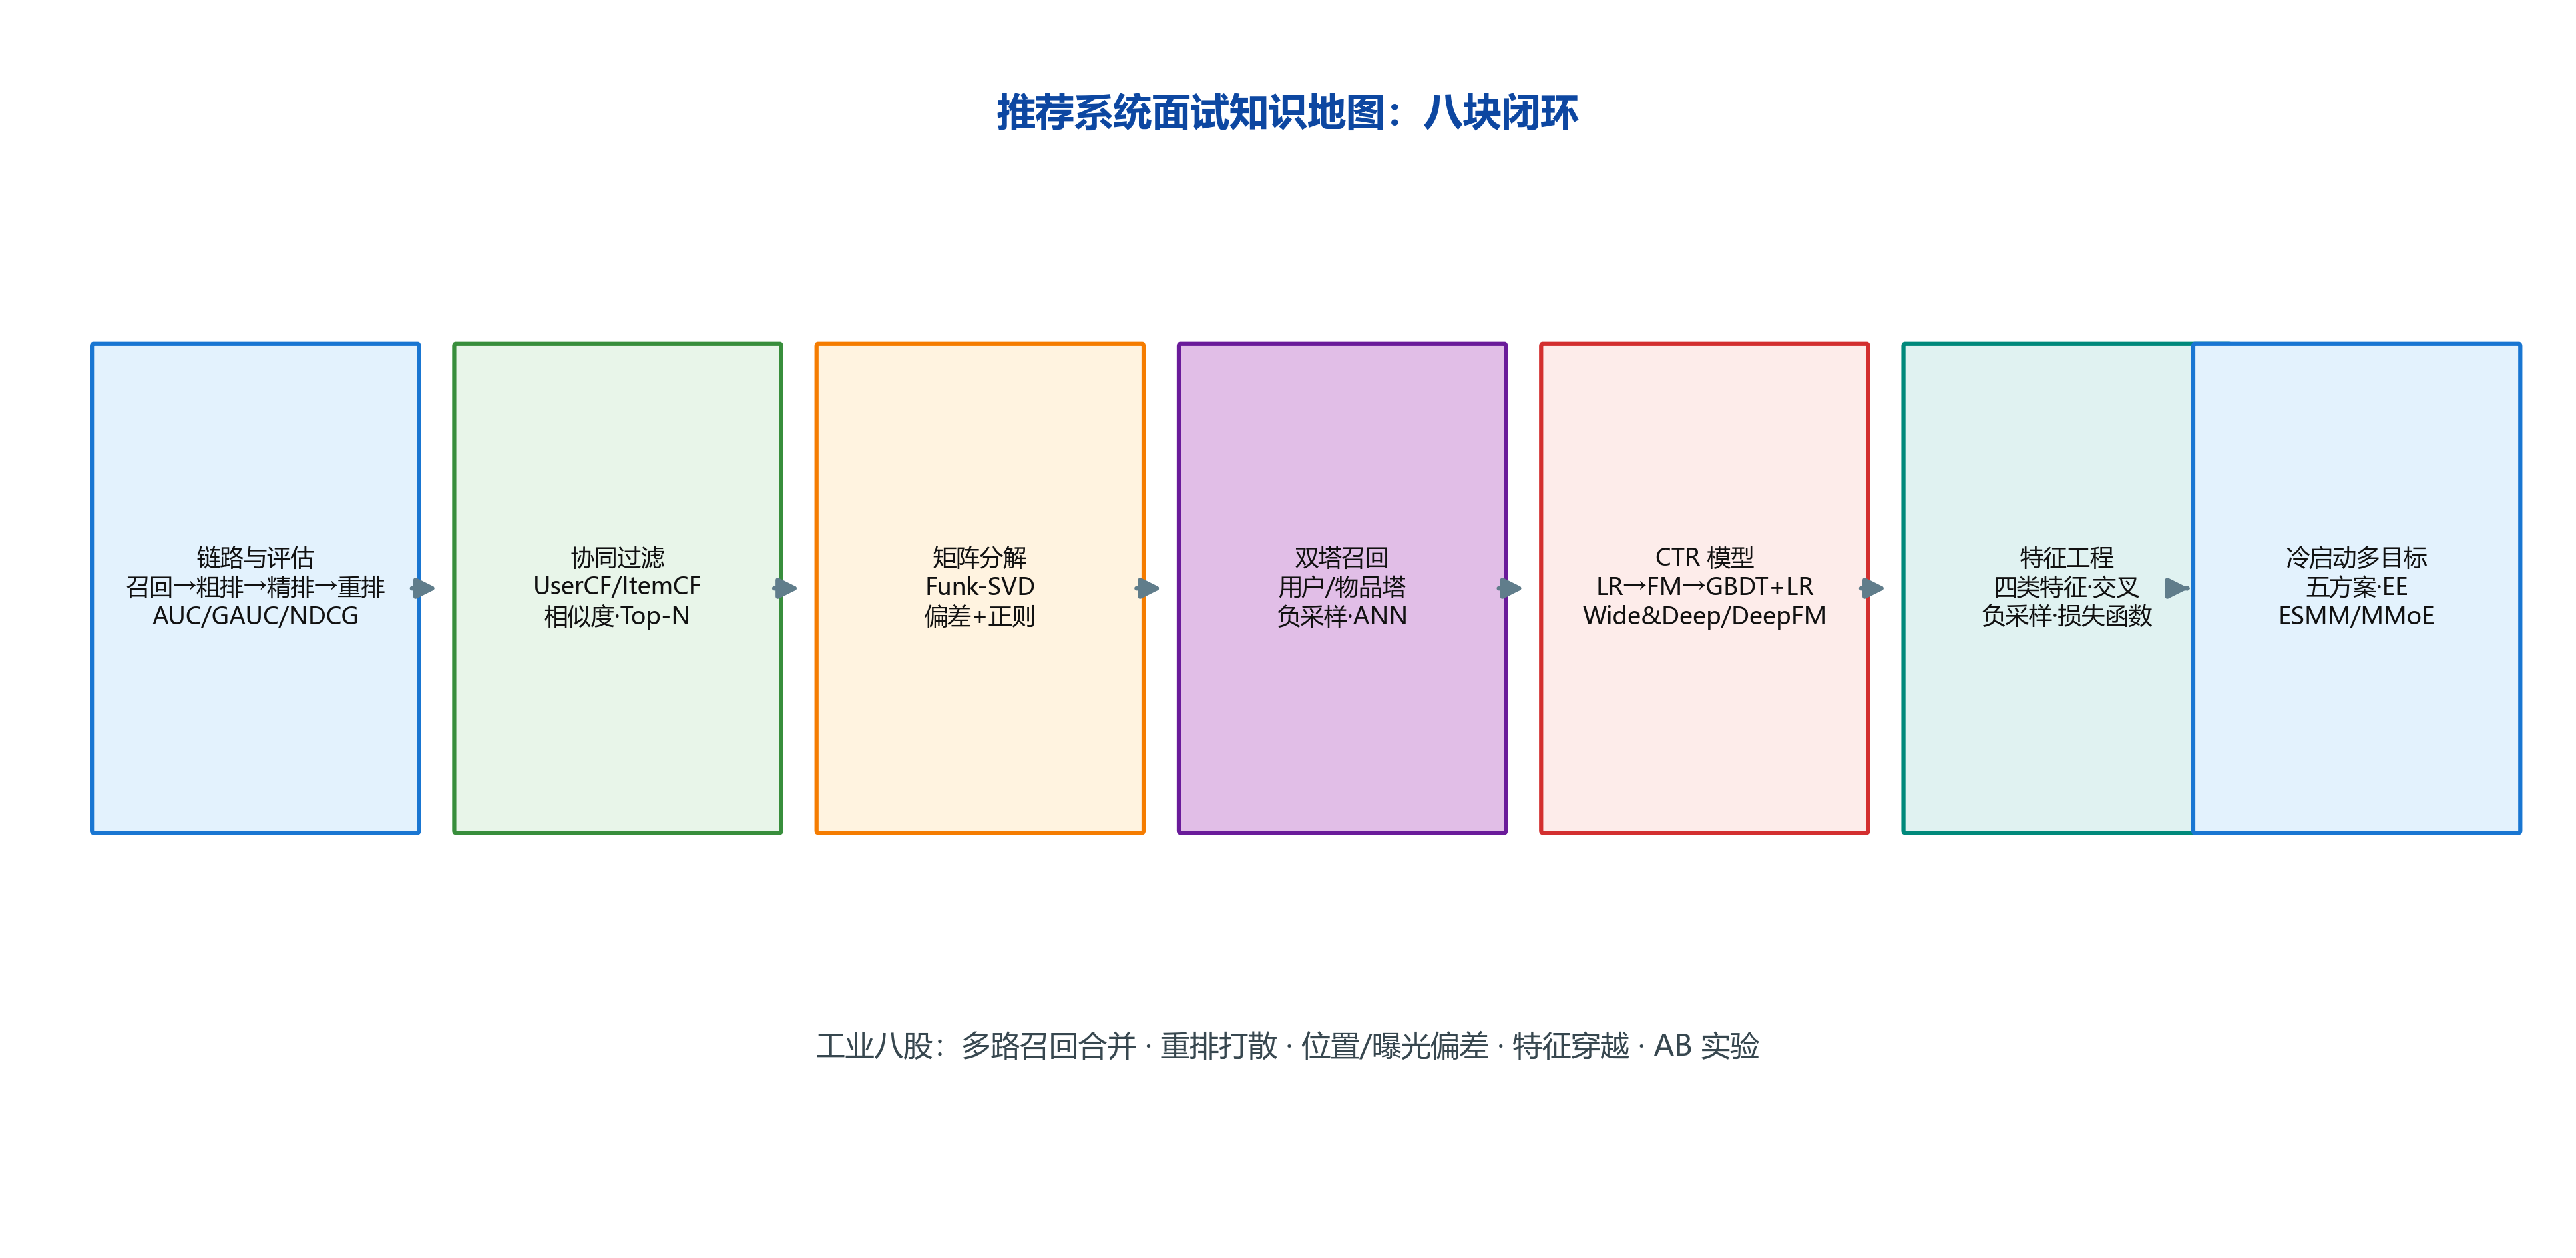
🔍 图解(自绘高清图,300dpi,可放大):这是推荐系统面试的完整知识地图(八块闭环)——
- 基础块:评估指标(GAUC/AUC/NDCG)与问题定义(CTR/CVR/多目标);
- 召回块:协同过滤(UserCF/ItemCF)、双塔向量召回、图召回(随机游走/GraphSAGE);
- 排序块:特征工程、LR/FM/Wide&Deep/DeepFM/Transformer 排序;
- 样本块:正负样本构造(曝光未点击/难负例)、采样偏差(SSB)、纠偏(ESMM);
- 冷启块:新用户/新物品冷启动(热门兜底/内容理解/元学习);
- 重排块:打散/多样性(MMR/DPP)、强插、业务约束;
- 多目标块:ESMM、MMoE、PLE;
- 工程块:特征平台、向量检索(ANN/FAISS)、AB 实验与在线学习;
- 闭环逻辑:数据采集 → 训练 → 线上推理 → AB 验证 → 回流数据——每一块都可能被面试官追问到。
1️⃣ 工业流程串讲(面试开场白)
import numpy as np
import pandas as pd
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
rng = np.random.default_rng(42)
# 🖼️ 配图:工业推荐系统全貌(面试画图必备)
fig, ax = plt.subplots(figsize=(9, 3.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=8.6)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.7))

box(0.4, 3.0, 1.7, 1.0, '召回\n双塔/CF/热度', '#bfdbfe')
box(2.6, 3.0, 1.7, 1.0, '粗排\n轻量模型', '#e2e8f0')
box(4.8, 3.0, 1.7, 1.0, '精排\nDeepFM/MMoE', '#fde68a')
box(7.0, 3.0, 1.7, 1.0, '重排\n打散/业务规则', '#bbf7d0')
box(9.05, 3.0, 0.7, 1.0, '曝光', '#fecaca')
arrow(2.2, 3.5, 2.5, 3.5); arrow(4.4, 3.5, 4.7, 3.5); arrow(6.6, 3.5, 6.9, 3.5); arrow(8.8, 3.5, 9.0, 3.5)
box(0.4, 1.3, 3.2, 0.9, '样本与特征\n(埋点→特征平台)', '#fef9c3')
box(4.2, 1.3, 3.2, 0.9, '模型训练/评估\n(离线 + 在线AB)', '#fef9c3')
box(7.8, 1.3, 1.9, 0.9, 'AB实验/监控', '#fef9c3')
arrow(1.2, 3.0, 1.6, 2.3); arrow(3.0, 3.0, 4.4, 2.3); arrow(5.7, 3.0, 5.4, 2.3)
box(0.4, 0.2, 9.4, 0.8, '反馈回流:曝光→点击→转化 样本 → 特征平台 → 下一轮模型迭代(离线/在线闭环)', '#e2e8f0')
arrow(9.4, 1.3, 8.6, 1.05)
plt.title('工业推荐系统:线上漏斗 + 线下闭环(样本→特征→训练→上线)', fontsize=11)
plt.show()
print('➡️ 面试画这张图:线上(召回→重排→曝光)+ 线下(数据→训练→AB)闭环')
➡️ 面试画这张图:线上(召回→重排→曝光)+ 线下(数据→训练→AB)闭环
C:\Users\24260\AppData\Local\Temp\ipykernel_47460\1017210686.py:26: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
print('''一条推荐的完整故事:
  数据:曝光/点击/转化日志 + 用户/物品画像 → 特征平台(实时+离线)
  召回:多路召回(双塔向量 + 协同过滤 + 热度 + 规则)合并去重
  粗排:轻量模型剪枝候选到百级(双塔/浅层 DNN)
  精排:DeepFM/MMoE 逐点估 CTR/CVR/时长,多目标加权得分
  重排:打散(类目/作者/颜色)、多样性、硬约束(不喜欢/已购过滤)、商业规则
  策略:探索-利用(EE)、冷启动配额、人群定向
  评估:离线 GAUC/NDCG → 线上 AB 分层实验 → 逐步放量
  监控:指标看板 + 异常告警 + 数据回流闭环
''')
一条推荐的完整故事:
  数据:曝光/点击/转化日志 + 用户/物品画像 → 特征平台(实时+离线)
  召回:多路召回(双塔向量 + 协同过滤 + 热度 + 规则)合并去重
  粗排:轻量模型剪枝候选到百级(双塔/浅层 DNN)
  精排:DeepFM/MMoE 逐点估 CTR/CVR/时长,多目标加权得分
  重排:打散(类目/作者/颜色)、多样性、硬约束(不喜欢/已购过滤)、商业规则
  策略:探索-利用(EE)、冷启动配额、人群定向
  评估:离线 GAUC/NDCG → 线上 AB 分层实验 → 逐步放量
  监控:指标看板 + 异常告警 + 数据回流闭环
2️⃣ 八大类高频题速答(一)
print('''1) 为什么召回和精排分开? → 候选池大(亿级)无法精排;召回快而粗、精排慢而准;
2) 双塔 vs 单塔?         → 双塔可离线预计算物品向量、在线只算用户侧,召回时延低;单塔交互强但慢;
3) 负样本怎么选?         → 随机/曝光未点击/难负样本;难负样本防模型"偷懒";
4) 向量检索用啥?         → HNSW/IVF/PQ;指标:召回@K、时延、内存;
5) FM 和 DeepFM 区别?     → FM 自动二阶交叉;DeepFM 加 DNN 高阶+共享 embedding;
6) 怎么解决冷启动?       → 热度/画像/迁移/试探/EE;内容特征 for 物品;
7) 什么是特征穿越?       → 用未来信息(如用全量统计算在线特征);训练/线上口径必须一致;
8) GAUC 为什么更准?      → 用户级排序贴近真实曝光场景。
''')
1) 为什么召回和精排分开? → 候选池大(亿级)无法精排;召回快而粗、精排慢而准;
2) 双塔 vs 单塔?         → 双塔可离线预计算物品向量、在线只算用户侧,召回时延低;单塔交互强但慢;
3) 负样本怎么选?         → 随机/曝光未点击/难负样本;难负样本防模型"偷懒";
4) 向量检索用啥?         → HNSW/IVF/PQ;指标:召回@K、时延、内存;
5) FM 和 DeepFM 区别?     → FM 自动二阶交叉;DeepFM 加 DNN 高阶+共享 embedding;
6) 怎么解决冷启动?       → 热度/画像/迁移/试探/EE;内容特征 for 物品;
7) 什么是特征穿越?       → 用未来信息(如用全量统计算在线特征);训练/线上口径必须一致;
8) GAUC 为什么更准?      → 用户级排序贴近真实曝光场景。
3️⃣ 八大类高频题速答(二)
print('''9) 怎么做 AB 实验?      → 用户级随机分流、AA 校验、SRM 检查、固定样本量与时长、防 peeking;
10) 实验怎么放量?        → 小流量验证 → 阶梯放量 → 全量;监控护栏指标;
11) 位置偏差怎么处理?    → 位置特征 + 训练时剔除位置影响(position bias 模型)或曝光消融;
12) 多样性怎么保证?      → MMR/DPP 重排;规则打散;覆盖度指标;
13) 用户/物品数量级大?    → 降采样、负采样、item 侧聚合、分片、增量更新;
14) 模型线上怎么更新?    → 全量定期重训 + 在线学习(实时特征/模型增量);
15) 如何评估推荐质量?    → 多级:模型指标 → 行为指标 → 业务指标;
16) EE 怎么做?           → ε-greedy、UCB、Thompson sampling;探索配额。
''')
9) 怎么做 AB 实验?      → 用户级随机分流、AA 校验、SRM 检查、固定样本量与时长、防 peeking;
10) 实验怎么放量?        → 小流量验证 → 阶梯放量 → 全量;监控护栏指标;
11) 位置偏差怎么处理?    → 位置特征 + 训练时剔除位置影响(position bias 模型)或曝光消融;
12) 多样性怎么保证?      → MMR/DPP 重排;规则打散;覆盖度指标;
13) 用户/物品数量级大?    → 降采样、负采样、item 侧聚合、分片、增量更新;
14) 模型线上怎么更新?    → 全量定期重训 + 在线学习(实时特征/模型增量);
15) 如何评估推荐质量?    → 多级:模型指标 → 行为指标 → 业务指标;
16) EE 怎么做?           → ε-greedy、UCB、Thompson sampling;探索配额。
📐 公式推导:多路召回加权融合与去重
加权分数融合:物品 $i$ 在 $M$ 路召回(向量路/CF 路/热度路)中各有归一化分数 $s_{i}^{(m)} \in [0,1]$,线性加权得最终分:
$$ s_i = \sum_{m=1}^{M} w_m \, s_i^{(m)}, \qquad \sum_{m=1}^{M} w_m = 1, \; w_m \ge 0 $$
Min-Max 归一化(各路分数尺度不同,先拉到同一量纲再融合,避免某路主导):
$$ s_i^{(m)} \leftarrow \frac{s_i^{(m)} - \min_k s_k^{(m)}}{\max_k s_k^{(m)} - \min_k s_k^{(m)}} $$
RRF(Reciprocal Rank Fusion,BM25 系常用):不用分数、用排名倒数融合,抗分数尺度差异:
$$ \mathrm{RRF}(i) = \sum_{m=1}^{M} \frac{1}{k + \mathrm{rank}_m(i)}, \qquad k \text{ 通常取 } 60 $$
推导要点:① 归一化保证融合前各路等权;② 权重 $w_m$ 可按路质量(如历史 AUC)学习/调参;③ 去重 = 对同一物品在多个 list 中的分数取 max 或求和——保底方案是"各取 top-N 再全局排序"。
4️⃣ 手撕:多路召回合并与去重
# 模拟多路召回结果:向量路 / CF 路 / 热度路
vec_rec = rng.choice(100, 30, replace=False)
cf_rec = rng.choice(100, 25, replace=False)
hot_rec = rng.choice(100, 20, replace=False)
candidates = np.unique(np.concatenate([vec_rec, cf_rec, hot_rec]))
print(f'向量路 {len(vec_rec)} + CF 路 {len(cf_rec)} + 热度路 {len(hot_rec)} → 合并去重后 {len(candidates)}')
assert len(candidates) <= len(vec_rec) + len(cf_rec) + len(hot_rec)
print('✅ 多路召回合并去重完成')
向量路 30 + CF 路 25 + 热度路 20 → 合并去重后 57
✅ 多路召回合并去重完成
5️⃣ 手撕:重排打散(类目多样性)
# 简单贪心打散:交替选不同类目的物品
n_rec = 12
cat_of = rng.integers(0, 3, n_rec)          # 精排结果的类目
scores_of = rng.uniform(0.5, 1, n_rec)
order = np.argsort(-scores_of)

result, last_cat, used = [], -1, set()
for idx in order:
    if len(result) >= n_rec:
        break
    c = cat_of[idx]
    if c == last_cat:
        # 找下一个不同类目
        for j in order:
            if j not in used and cat_of[j] != last_cat:
                idx = j
                c = cat_of[idx]
                break
    used.add(idx)
    result.append(idx)
    last_cat = c

print('打散后类目序列:', cat_of[result])
print('相邻同类目次数:', sum(1 for i in range(len(result)-1) if cat_of[result[i]] == cat_of[result[i+1]]))
assert len(result) == n_rec
print('✅ 贪心打散完成(相邻同类目最少)')
打散后类目序列: [0 1 0 1 0 1 2 0 1 2 1 0]
相邻同类目次数: 0
✅ 贪心打散完成(相邻同类目最少)
6️⃣ 推荐系统常见坑清单
print('''1) 曝光偏差:用曝光样本估计全量 → 加曝光权重/反事实校正;
2) 位置偏差:排前天然点击高 → 位置特征/消融;
3) 数据泄漏:特征用了未来或全量 → 时间切分、口径一致;
4) 冷启动缺失:新用户新物品没数据 → 配额与探索;
5) 实验污染:多实验互斥未隔离 → 分层分桶、SRM 监控;
6) 评估失真:离线好线上差 → 线上偏差/模型漂移/特征口径漂移;
7) 只看点击:点击好转化差 → 多目标(ESMM/MMoE);
8) 多样性缺失:越推越窄(信息茧房)→ 打散/覆盖度/探索。
''')
1) 曝光偏差:用曝光样本估计全量 → 加曝光权重/反事实校正;
2) 位置偏差:排前天然点击高 → 位置特征/消融;
3) 数据泄漏:特征用了未来或全量 → 时间切分、口径一致;
4) 冷启动缺失:新用户新物品没数据 → 配额与探索;
5) 实验污染:多实验互斥未隔离 → 分层分桶、SRM 监控;
6) 评估失真:离线好线上差 → 线上偏差/模型漂移/特征口径漂移;
7) 只看点击:点击好转化差 → 多目标(ESMM/MMoE);
8) 多样性缺失:越推越窄(信息茧房)→ 打散/覆盖度/探索。
7️⃣ 自测清单
- 能把一条推荐系统完整流程讲 5 分钟不卡壳
- 高频题 16+ 题能不看资料答出关键点
- 能手撕多路召回合并去重、贪心打散
- 能背出 8 个常见坑与对策
- 能回答"为什么离线好线上差"的排查思路
配套刷题:见 ../../19-推荐系统/高频面试题.md(72 题分八类)