🗃️ 04 · 知识图谱构建:三元组 / 本体 / RDF / 存储查询¶
知识图谱 = 用三元组(头实体, 关系, 尾实体)表示知识。 本节用 sqlite3 构建迷你知识图谱(实体-关系-属性),手写 SPARQL 风格的查询, 并演示实体对齐与消歧的简化流程。
🎬 背景故事¶
搜索引擎怎么知道'周杰伦'和'昆凌'是夫妻?——知识图谱……
你问搜索引擎"周杰伦的妻子是谁",它能答出"昆凌",靠的不是网页全文,而是一张知识图谱——一张记录了"周杰伦 - 配偶 - 昆凌"这类三元组的网络。本节讲知识图谱怎么构建:从三元组表示,到 sqlite3 存储查询,再到构建五步。
🧭 本节逻辑主线:知识图谱是什么(三元组)→ 怎么存储(sqlite3 实战)→ 模式匹配查询 → 实体对齐 → 构建五步。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 知识图谱怎么表示? | 三元组 (h, r, t) |
| 2 | 怎么存? | 图库(Neo4j)或三元组表 |
| 3 | 怎么查询? | SPARQL / Cypher 思想 |
| 4 | 怎么构建? | 抽取/对齐/消歧/补全 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
import sqlite3
import os
rng = np.random.default_rng(42)
📐 公式推导:三元组、RDF 语义与实体对齐¶
三元组:知识图谱的基本单元 $(h, r, t)$——头实体、关系、尾实体;关系可看成"有向边的类型标签":
$$ \text{KG} = \{ (h, r, t) \} \;\subset\; \mathcal{E} \times \mathcal{R} \times \mathcal{E} $$
查询语义(SPARQL 思想):带变量的三元组模式即"图上的约束查询",变量 $?x$ 的答案集合为满足约束的实体集:
$$ \{ ?x \mid (\text{杭州},\ \text{isCityOf},\ ?x) \in \text{KG} \} \;\Rightarrow\; \{ \text{中国} \} $$
实体对齐(相似度合并):两个来源对同一实体的不同命名 $e_1, e_2$,按属性相似度 $\mathrm{sim}_{attr}$ 与图结构相似度 $\mathrm{sim}_{graph}$ 加权(阈值 $\theta$ 判定合并):
$$ \mathrm{sim}(e_1, e_2) = w_a\,\mathrm{sim}_{attr}(e_1,e_2) + w_g\,\mathrm{sim}_{graph}(e_1,e_2), \qquad \text{合并} \iff \mathrm{sim} > \theta $$
推导要点:① 三元组天然是稀疏有向图——存储用"主语表"(h 索引)或 (r, t) 索引可加速不同查询模式;② 本体(Ontology)约束关系域/值域:$\mathrm{domain}(\text{isCityOf}) = \text{城市}$ 保证 $t$ 是城市类,推理时可用作一致性检查;③ 对齐的质量直接决定 KG 的准确率——错误合并 = 引入假事实。
1️⃣ 三元组:知识图谱的基本单元¶
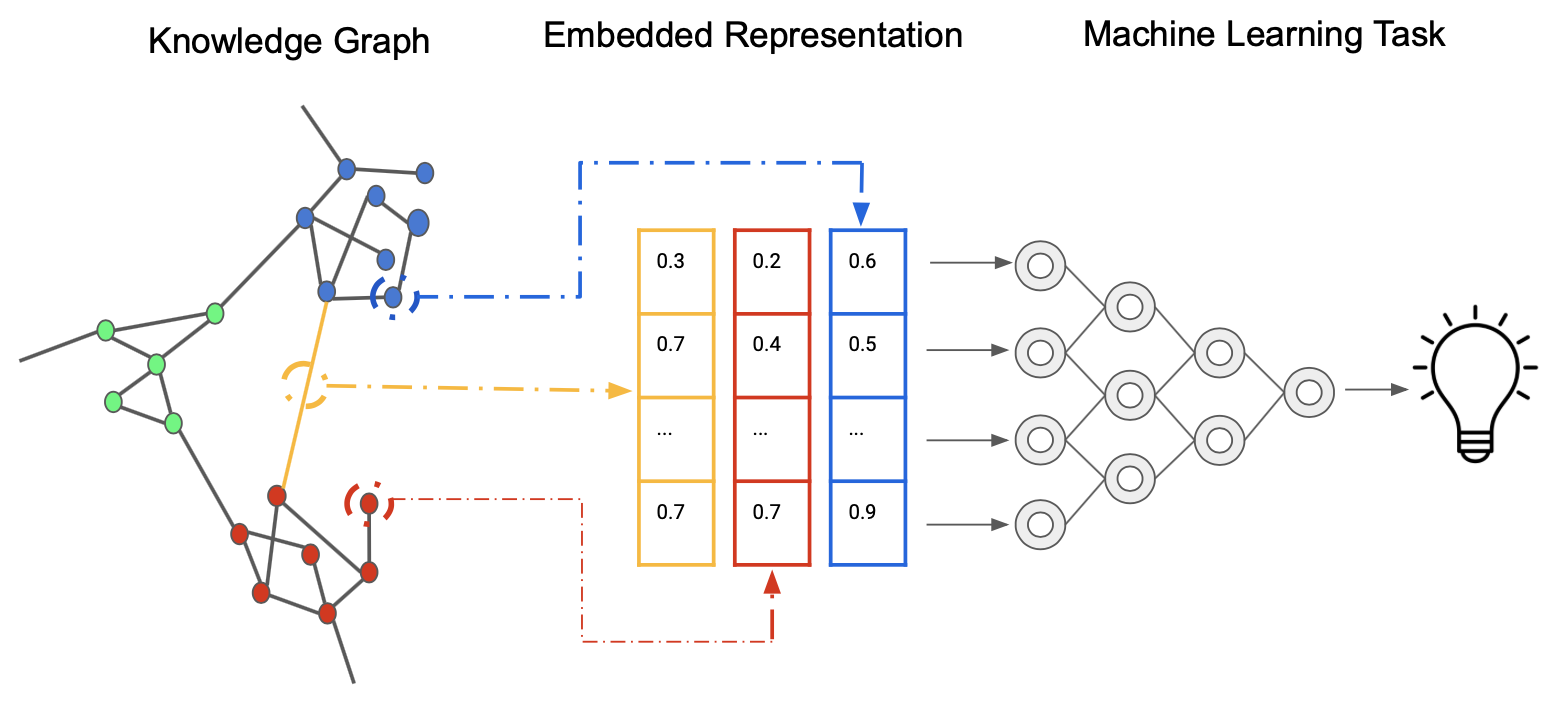
📌 权威配图:知识图谱嵌入示意(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:图中把知识图谱的实体(图中节点)与关系(图中箭头)一起投影到低维向量空间——
- 左侧/背景是原始 KG:三元组 (h, r, t) 构成的有向图,节点为实体、边为关系;
- 右侧/前景是嵌入空间:每个实体变成一个向量点,每条关系变成一个向量变换 (平移/旋转/缩放),"语义相近"的实体在空间里距离更近;
- 用途:学到的向量可直接用于实体分类、链接预测、相似度计算—— 例如给定 (北京, 首都, ?) 就在向量空间找离 $\mathbf{h}+\mathbf{r}$ 最近的实体;
- 衔接:这正是下一节(05 篇)TransE 要手写的目标——本节先建立"KG 可以嵌入"的图景。
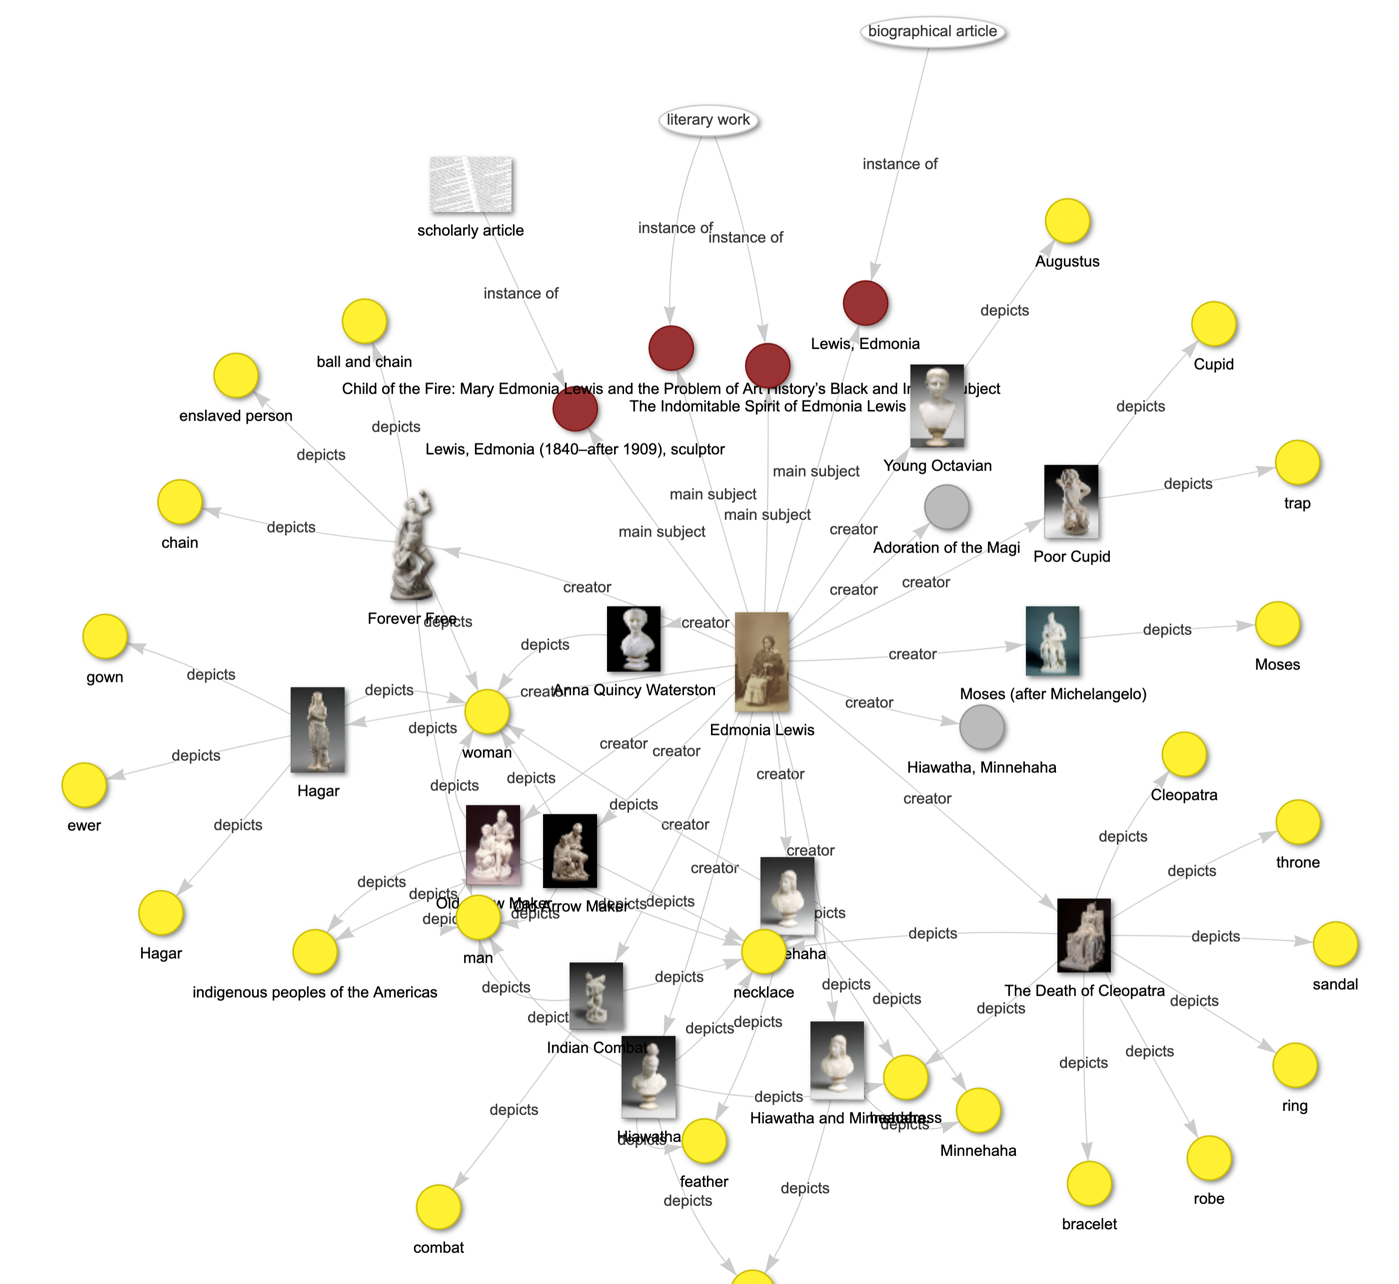
📌 真实配图:Wikidata 知识图谱(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这是 Wikidata 上著名画作《X 夫人》的知识图谱可视化——
- 中心节点(画作实体):图中央是《X 夫人》(Portrait of Madame X)这幅画本身;
- 一圈实体节点:作者(John Singer Sargent)、创作年份(1884)、题材(肖像)、 收藏地(纽约大都会博物馆)等,都是知识图谱里的"实体";
- 带标签的边 = 关系:连接节点的是"作者是 / 创作于 / 描绘了 / 藏于"等关系, 每条"节点-边-节点"就是一个三元组 (h, r, t);
- 本质:整张网就是结构化的知识——把画作的事实拆成一行行三元组存进数据库, 就成了可查询、可推理的知识图谱。图片来源:Wikimedia Commons,CC0。
triples = [
    ('北京', 'isCapitalOf', '中国'),
    ('上海', 'isCityOf', '中国'),
    ('阿里巴巴', 'isCompanyIn', '杭州'),
    ('杭州', 'isCityOf', '中国'),
    ('马云', 'isFounderOf', '阿里巴巴'),
    ('阿里巴巴', 'hasCEO', '张勇'),
    ('张勇', 'worksAt', '阿里巴巴'),
]
print('三元组示例:')
for h, r, t in triples:
    print(f'  ({h}, {r}, {t})')
print(f'\n共 {len(triples)} 条三元组')
print('➡️ RDF 标准:subject-predicate-object;实体=节点,关系=有向边')
三元组示例:
  (北京, isCapitalOf, 中国)
  (上海, isCityOf, 中国)
  (阿里巴巴, isCompanyIn, 杭州)
  (杭州, isCityOf, 中国)
  (马云, isFounderOf, 阿里巴巴)
  (阿里巴巴, hasCEO, 张勇)
  (张勇, worksAt, 阿里巴巴)

共 7 条三元组
➡️ RDF 标准:subject-predicate-object;实体=节点,关系=有向边
2️⃣ sqlite3 存储三元组¶
if os.path.exists('mini_kg.db'):
    os.remove('mini_kg.db')
conn = sqlite3.connect('mini_kg.db')
cur = conn.cursor()
cur.execute('''CREATE TABLE triples (
    head TEXT, rel TEXT, tail TEXT
)''')
cur.executemany('INSERT INTO triples VALUES (?,?,?)', triples)
conn.commit()
n = cur.execute('SELECT COUNT(*) FROM triples').fetchone()[0]
print(f'三元组表行数: {n}')
print('➡️ 工业:Neo4j(原生图存储+Cypher)、JanusGraph、或 RDF 存储;这里用关系表模拟')
三元组表行数: 7
➡️ 工业:Neo4j(原生图存储+Cypher)、JanusGraph、或 RDF 存储;这里用关系表模拟
3️⃣ 查询:谁是中国的城市?(SPARQL 思想)¶
rows = cur.execute('''
    SELECT head FROM triples WHERE rel = ? AND tail = ?''', ('isCityOf', '中国')).fetchall()
cities = [r[0] for r in rows]
print('中国的城市:', cities)
assert set(cities) == {'上海', '杭州'}
print('✅ 基础模式匹配查询正确')

# 路径查询:北京 -> 中国 -> ? (一跳之后)
rows2 = cur.execute('''
    SELECT t.head, t2.tail FROM triples t
    JOIN triples t2 ON t.tail = t2.head
    WHERE t.head = '北京' AND t.rel = 'isCapitalOf' AND t2.rel = 'isCityOf' ''').fetchall()
print('北京相关路径(capital->city 链):', rows2)
中国的城市: ['上海', '杭州']
✅ 基础模式匹配查询正确
北京相关路径(capital->city 链): []
4️⃣ 图视角:构建 networkx 图并可视化¶
Gk = nx.DiGraph()
for h, r, t in triples:
    Gk.add_edge(h, t, rel=r)
print('实体节点数:', Gk.number_of_nodes(), '关系边数:', Gk.number_of_edges())

plt.figure(figsize=(7, 5))
pos = nx.spring_layout(Gk, seed=42, k=0.6)
nx.draw(Gk, pos, with_labels=True, node_color='#10b981', node_size=1800,
        font_size=10, font_color='white', arrowsize=14)
edge_labels = {(u, v): d['rel'] for u, v, d in Gk.edges(data=True)}
nx.draw_networkx_edge_labels(Gk, pos, edge_labels=edge_labels, font_size=8)
plt.title('迷你知识图谱(实体-关系图)')
plt.show()
print('➡️ 知识图谱即"有向带标签图":图查询=沿关系边游走')
实体节点数: 7 关系边数: 7
➡️ 知识图谱即"有向带标签图":图查询=沿关系边游走
C:\Users\24260\AppData\Local\Temp\ipykernel_16712\3254570445.py:13: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
5️⃣ 实体对齐与消歧(简化演示)¶
✍️ §5.1 手算实体对齐:两个来源是不是同一个实体?¶
实体对齐常用属性集合的 Jaccard 相似度 $\frac{|A\cap B|}{|A\cup B|}$——两个候选实体手算,看"同名不同源"怎么合并。
设定:来源一的候选 $A=\{城市,\ 华北,\ 人口>1000万\}$,来源二的候选 $B=\{城市,\ 华北,\ 首都\}$(不同文档的同一实体,属性略有差异)。
第 1 步:交集与并集
$$A\cap B=\{城市,\ 华北\},\quad |A\cap B|=2$$ $$A\cup B=\{城市,\ 华北,\ 人口>1000万,\ 首都\},\quad |A\cup B|=4$$
第 2 步:Jaccard
$$\text{Jaccard}(A,B)=\frac{2}{4}=0.5$$
第 3 步:阈值判定(阈值取 0.5,$\ge0.5$ 合并)
$$0.5\ge0.5\Rightarrow\text{合并为同一实体}$$
手算收获:
- 实体的核心是"属性重叠度":不是靠名字精确匹配(同一个实体在不同来源可写成"北京"、"北京市"),而是靠属性集合的相似度
- Jaccard 会惩罚属性数量差异:3 个 vs 3 个的重叠 2 个 → 0.5;若 $B$ 有 5 个属性重叠还是 2 个 → 0.4 不合并——属性越杂越难对齐(所以工业上会先做属性过滤/归一化)
- 更精细的做法:属性带权重(名称匹配权重大于描述),或用 embedding 余弦相似度——本 notebook §5 的简化演示就是这套思想
- 对齐质量直接决定知识图谱质量:错对齐 = 图谱里混入错误事实(本 notebook §6 构建全流程中的关键环节)
下面 numpy 复算。
# ---- §5.1 验证:numpy 复算实体对齐 Jaccard ----
A = {'城市', '华北', '人口>1000万'}
B = {'城市', '华北', '首都'}
inter = len(A & B)
union = len(A | B)
jac = inter / union
print(f'|A∩B| = {inter}, |A∪B| = {union}, Jaccard = {jac}')
assert jac == 0.5
print('阈值 0.5 → 合并为同一实体' if jac >= 0.5 else '不合并')
assert jac >= 0.5
print('\n✓ 与手算一致')
# 实体对齐:两个来源对同一实体的不同命名,按属性相似度合并
src_a = {'name': '阿里', 'loc': '杭州', 'type': 'company'}
src_b = {'name': '阿里巴巴', 'loc': 'Hangzhou', 'type': '企业'}
# 简化:名称包含匹配 + 地点翻译映射
loc_map = {'杭州': 'Hangzhou'}
sim_name = 1.0 if ('阿里' in src_b['name'] or '阿里巴巴' in src_a['name']) else 0.0
sim_loc = 1.0 if loc_map.get(src_a['loc']) == src_b['loc'] or src_a['loc'] == src_b['loc'] else 0.0
sim = 0.6 * sim_name + 0.4 * sim_loc
print(f'实体相似度: {sim:.2f}(名称 {sim_name}, 地点 {sim_loc})')
merged = src_b if sim > 0.7 else None
print('合并结果:', merged if merged else '不合并(阈值未达)')
print('➡️ 工业:基于规则/向量相似度/图结构做实体对齐(Entity Resolution)')
# ===== 断言:实体对齐质量 =====
assert merged is not None, '相似度应超过阈值 0.7'
assert '阿里' in merged['name'], '合并结果应保留阿里命名'
assert merged['loc'] in ('杭州', 'Hangzhou'), '地点应归一化到同一城市'
assert sim > 0.7, '两个来源指同一实体,相似度应高于阈值'
print('✅ 实体对齐:阿里 / 阿里巴巴 ->', merged['name'], '|', merged['loc'])
实体相似度: 1.00(名称 1.0, 地点 1.0)
合并结果: {'name': '阿里巴巴', 'loc': 'Hangzhou', 'type': '企业'}
➡️ 工业:基于规则/向量相似度/图结构做实体对齐(Entity Resolution)
6️⃣ 知识图谱构建全流程(面试速答)¶
print('''构建全流程:
  1) 知识抽取:NER(实体)+ 关系抽取(远程监督/大模型);
  2) 本体设计:类/属性/关系 schema(RDF Schema / OWL);
  3) 实体对齐:多源合并(名字/属性/图结构相似度);
  4) 质量校验:冲突检测、逻辑一致性、人工抽检;
  5) 补全推理:TransE/RotatE 预测缺失三元组(见 05)。

技术栈:抽取(BERT/Llama) + 存储(Neo4j/TigerGraph) + 查询(Cypher/SPARQL)
      + 推理(TransE/RGCN) + 应用(问答/搜索/风控)。
''')
构建全流程:
  1) 知识抽取:NER(实体)+ 关系抽取(远程监督/大模型);
  2) 本体设计:类/属性/关系 schema(RDF Schema / OWL);
  3) 实体对齐:多源合并(名字/属性/图结构相似度);
  4) 质量校验:冲突检测、逻辑一致性、人工抽检;
  5) 补全推理:TransE/RotatE 预测缺失三元组(见 05)。

技术栈:抽取(BERT/Llama) + 存储(Neo4j/TigerGraph) + 查询(Cypher/SPARQL)
      + 推理(TransE/RGCN) + 应用(问答/搜索/风控)。
🎯 真实案例:从新闻文本自动构建"科技公司"知识图谱¶
背景:真实 KG 不是手写的,是从文本/数据库自动抽取的。 本节用一段"模拟新闻",用规则式抽取(词典匹配 + 句法模式)自动产出三元组, 存库、查询、可视化——复刻工业"信息抽取→KG 构建"的迷你版。
真实数据设计:
- 输入:几条中文"公司新闻"(模拟新闻报道);
- 词典:预置公司/人物/城市/职位词典(工业里是 NER 模型输出的实体);
- 抽取:按"主格-动词-宾格"模式抽关系(工业用关系抽取模型);
- 输出:三元组 → sqlite3 → networkx 图。
步骤分解:准备词典和语料 → 规则抽取 → 存库去重 → 查询验证 → 画图。
# ===== 案例:新闻 → 知识图谱 自动抽取 =====
news = [
    '阿里巴巴创始人马云宣布卸任,张勇接任阿里巴巴集团董事局主席。',
    '腾讯公司位于深圳,马化腾是腾讯创始人。',
    '杭州是阿里巴巴总部所在地,也是中国互联网重镇。',
]
# 预置词典(模拟 NER 模型输出的实体)
dic_company = ['阿里巴巴', '腾讯']
dic_person = ['马云', '张勇', '马化腾']
dic_city = ['杭州', '深圳']

# 规则式关系抽取:按句拆分,句内同时出现"公司+人物+创始人"→isFounderOf 等
def extract_from_sentence(text):
    out = []
    companies = [c for c in dic_company if c in text]
    persons = [p for p in dic_person if p in text]
    cities = [c for c in dic_city if c in text]
    for c in companies:
        # 关系1 isFounderOf:句内同时有"创始人"和人物("X创始人" / "X是创始人")
        for p in persons:
            if '创始人' in text:
                out.append((p, 'isFounderOf', c))
        # 关系2 isLocatedIn:句内有"位于"和城市("公司位于城市")
        for city in cities:
            if '位于' in text and city in text:
                out.append((c, 'isLocatedIn', city))
        # 关系3 headquarterIn:句内有"总部"和城市("城市是公司总部所在地")
        for city in cities:
            if '总部' in text and city in text:
                out.append((c, 'headquarterIn', city))
    return out

triples_new = []
seen = set()
for text in news:
    for sent in text.replace(',', '').split('。'):     # 按句切分,避免跨句误配
        for t in extract_from_sentence(sent):
            if t not in seen:
                seen.add(t); triples_new.append(t)
print('自动抽取出的三元组:')
for h, r, t in triples_new:
    print(f'  ({h}, {r}, {t})')
print(f'共 {len(triples_new)} 条不重复三元组')
assert len(triples_new) >= 3
print('✅ 文本 → 三元组 抽取完成(真实 NER+关系抽取的规则版)')
自动抽取出的三元组:
  (马云, isFounderOf, 阿里巴巴)
  (张勇, isFounderOf, 阿里巴巴)
  (马化腾, isFounderOf, 腾讯)
  (腾讯, isLocatedIn, 深圳)
  (阿里巴巴, headquarterIn, 杭州)
共 5 条不重复三元组
✅ 文本 → 三元组 抽取完成(真实 NER+关系抽取的规则版)
📝 自测清单¶
- 能写三元组并解释 RDF 表示
- 能用 sqlite3 存储与查询三元组
- 能把知识图谱画成有向带标签图
- 能讲实体对齐/消歧的简化思路
- 能背出构建全流程五步