📚 10-02 · Word2Vec 与 GloVe:分布式词向量¶
目标:学完本篇你能——① 从"词由邻居定义"出发,手写共现矩阵与 PMI/PPMI;② 用截断 SVD 和手写 numpy Skip-gram(负采样)把词变成稠密向量,并做相似词检索;③ 说清 GloVe 的损失逐步推导及其与 PMI/SVD 的关系;④ 用向量算术做 king−queen 类类比实验、用 PCA 画中文词向量图;⑤ 答出"为什么 Skip-gram 对低频词友好、负采样 3/4 次幂、OOV"等面试题。
🧭 本篇位置:前一篇
01-n-gram 与统计语言模型用词序列估计概率 P(w₁…wT);本篇把每个词映射成稠密向量(词义即坐标);下一篇03-RNN 与 LSTM让向量随上下文动态变化,解决静态表示的局限。
核心概念¶
(a) 🗂️ 词由邻居定义:Word2Vec 与 GloVe¶
one-hot 向量又高又稀又没语义,本篇把「上下文相似的词,语义也相似」变成可计算的词向量。先走统计路线(共现矩阵 → PMI → SVD),再走学习路线(CBOW/Skip-gram + 负采样),最后讲 GloVe 直接拟合全局共现,并用向量算术做类比实验。
flowchart TB
    Node1["😵 one-hot 两大痛点"]
    Node2["📖 分布式假设"]
    Node3["📊 共现矩阵 & PMI/PPMI"]
    Node4["✂️ 截断 SVD"]
    Node5["🎯 CBOW / Skip-gram"]
    Node6["🎲 负采样"]
    Node7["🌐 GloVe 全局统计"]
    Node8["➗ 类比实验与可视化"]
    Node9["🚧 局限与演进"]
    Node1 --> Node2
    Node2 --> Node3
    Node3 --> Node4
    Node2 --> Node5
    Node5 --> Node6
    Node3 --> Node7
    Node4 --> Node8
    Node6 --> Node8
    Node7 --> Node8
    Node9 -->|静态向量/一词多义| Node8
- one-hot 两大痛点:维度灾难——向量长度等于词表大小,稀疏且随语料膨胀;零语义——每个词只有自己那一维是 1,cat 和 dog 的相似度是 0,机器只能做精确匹配。
- 分布式假设:「You shall know a word by the company it keeps」——出现在相似上下文里的词语义相似,苹果和香蕉都常跟「吃、甜、水果」一起出现。这是全部词向量方法的理论基石。
- 共现矩阵 & PMI/PPMI:统计窗口内词对共现次数得到 V×V 矩阵;但次数高不等于关系强(the 和谁都常共现),PMI 把共现概率与随机基线比较,负值截断为 0 就是 PPMI,只保留「超出随机」的信号。
- 截断 SVD:PPMI 是稀疏大矩阵,SVD 把它分解成 U·Σ·Vᵀ,取前 d 个奇异值就能得到 d 维稠密词向量——这是经典统计路线的「降维压缩」。
- CBOW / Skip-gram:Word2Vec 把「统计邻居」换成「预测任务」:CBOW 用上下文预测中心词,Skip-gram 用中心词预测上下文。训练完的权重就是词向量,Skip-gram 对低频词更友好。
- 负采样:原始 softmax 每次要算整个词表 V 个词太贵,改成「认出 1 个正样本 + 拒绝 K 个随机负样本」的二分类,复杂度从 O(V) 降到 O(K)。负样本按频率的 3/4 次幂采样,给低频词更多出场机会。
- GloVe:Word2Vec 是「抽样」,GloVe 是「全局统计」——共现矩阵已经统计好了全部信息,直接拟合它。核心洞察是共现概率的「比值」比单个概率更能区分语义(ice 与 steam 的例子)。
- 类比实验与可视化:词向量最惊艳的性质——语义关系 = 向量平移,king − man + woman ≈ queen。用余弦相似度做类比检索、用 PCA 把词向量投影到 2D 看语义聚类。
- 局限与演进:词向量是「静态」的——一个词一个向量,多义词 bank 被压成平均向量,OOV 新词没向量。这些坑正是 ELMo/BERT 上下文相关表示的由来。
主线地图:从"统计邻居"到"学习邻居"¶
词表(V)
  │
  ├─→ 共现矩阵 M(V×V) ─→ PMI / PPMI ─→ 截断 SVD ─→ 稠密词向量(经典统计路线,§1-2)
  │
  ├─→ CBOW / Skip-gram ─→ 负采样(3/4 次幂) ─→ 手写训练 ─→ 相似词检索(§3)
  │
  ├─→ GloVe:直接拟合 log M 的加权平方误差(统计 + 学习的混合,§4)
  │
  ├─→ 类比实验(king−man+woman≈queen) + PCA 可视化(§5)
  │
  └─→ 局限:静态 / 一词多义 / OOV ─→ ELMo、BERT(05 篇,§6)
| 小节 | 内容 | 关键产出 |
|---|---|---|
| §1 分布假设与共现 | one-hot 痛点、词由邻居定义、窗口、PMI 推导、PPMI | 手写共现矩阵 + PPMI 数值验证 |
| §2 从矩阵到向量 | 截断 SVD 原理、重构误差、手写 vs sklearn | 8 维词向量 + 误差曲线 |
| §3 CBOW vs Skip-gram | 结构图、目标函数、softmax 代价、负采样、梯度推导、3/4 次幂 | 手写训练 + 相似词检索 + 手写采样器 |
| §4 GloVe | 损失逐步推导、与 PMI/SVD 关系、权重 f(x) | SVD 近似解 + f(x) 曲线 |
| §5 类比与可视化 | 向量算术、余弦相似度、PCA | 性别类比 + 中文散点图 |
| §6 局限与演进 | 静态 / 多义词 / OOV | 引出 ELMo/BERT |
0.1 历史背景:词向量是怎么"长"出来的¶
今天的"词向量"不是一步到位的,它经历了三次范式跃迁:
- 查表时代(one-hot):每个词是词表的一根"坐标轴",向量之间完全没有相似性结构,机器只能做精确匹配;
- 统计时代(共现矩阵 + LSA):Harris(1954)提出分布假设——"词义由它出现的上下文决定";Deerwester 等(1990)用 LSA/SVD 对"词—文档"共现矩阵做低秩分解,第一次得到稠密向量。但这条统计路线有两个顽疾:对低频词对极其敏感(少数几次共现就能带偏整个方向),且训练结束后无法吸收新词;
- 学习时代(Word2Vec/GloVe):不再"先统计、后分解",而是设计一个预测任务,用梯度下降把向量直接学出来。
Mikolov 等 2013 年的两篇论文脉络值得背下来:第一篇《Efficient Estimation of Word Representations in Vector Space》提出 CBOW 与 Skip-gram 两种结构,并展示 king−man+woman≈queen 的向量算术;第二篇《Distributed Representations of Words and Phrases and their Compositionality》补上负采样(替代昂贵的 softmax)、3/4 次幂噪声分布与高频词二次采样,让 word2vec 真正能在十亿词级语料上训练。为什么 2013 年才成功?三件事凑齐了:互联网时代的超大规模语料、可负担的 GPU 算力、以及负采样把每个样本的代价从 O(V) 压到 O(K)。一年后 Pennington 等(2014)的 GloVe 让"统计派"与"学习派"合流。本篇实验 1-7 就是这条脉络的逐段复现。
1. 从 one-hot 到稠密向量:为什么需要词向量¶
1.1 one-hot 的两大痛点¶
直觉:假设词表 V=10000,one-hot 用 10000 维 0/1 向量表示每个词。两个致命问题:
- 维度灾难:向量长度 = 词表大小,稀疏且随语料膨胀(存储与计算都 O(V));
- 零语义:
cat与dog的 one-hot 内积 = 0,cat与apple的内积也 = 0——机器看不出任何"谁和谁更像",词间距离完全失效。
🍎 生活化类比:one-hot 像"身份证号"——每个号独一无二,但光看号无法知道这个人住哪、做什么。我们要的是语义坐标卡:把词放进低维空间,相近的词坐标接近(就像 2D 地图上"北京"和"天津"挨着,而"北京"和"伦敦"很远)。
| 表示方法 | 维度 | 语义 | 时代 |
|---|---|---|---|
| one-hot | V(稀疏) | 无 | 传统 |
| 共现/SVD 统计向量 | d(稠密) | 有(统计近似) | LSA 时代 |
| Word2Vec/GloVe | d(稠密) | 有(学习得到) | 2013 起 |
1.2 分布式假设:词由邻居定义¶
分布式假设(distributional hypothesis):"You shall know a word by the company it keeps"(Firth, 1957)——出现在相似上下文里的词,语义相似("苹果"和"香蕉"都常跟"吃、甜、水果"一起出现)。
共现矩阵:设窗口大小 window=w,若词 $j$ 出现在词 $i$ 的左右各 $w$ 个位置内,则 $M_{ij}$ 加 1:
$$M_{ij} = \#\{\text{词 } j \text{ 出现在词 } i \text{ 的 } \pm w \text{ 窗口内}\}$$
- 窗口大小是分布假设的"朋友圈半径":w=1 只见紧邻词(偏句法),w=5 能看到主题词(偏语义);
- 复杂度:对长度 T 的语料,每个词扫 2w 个邻居,构建 O(T·w);矩阵存储 O(V²)——V 大时爆炸,这正是后面要用低秩/SVD 压缩的原因。
手算例子(本实验语料 5 句、词表 11 词):句子 he is a good boy 中,"good" 在 window=1 时的邻居只有 a、boy;window=2 时还多出 is、he。窗口越大,"good" 甚至能和 she、girl 间接共现——邻居圈越大,语义关系越"软"。
1.2b 手算演练:把 5 个句子逐句拆开(多走几步)¶
动手前先用纸笔把共现矩阵"拆"一遍,实验 1 打印的数字就会变得显然。语料共 5 句、11 个词,window=2 时每句的有序共现对数:
| 句子 | 内容 | 各位置邻居数 | 小计 |
|---|---|---|---|
| ① | he is a good boy | 2+3+4+3+2 | 14 |
| ② | good boy loves learning | 2+3+3+2 | 10 |
| ③ | she is a good girl | 2+3+4+3+2 | 14 |
| ④ | girl loves music | 2+2+2 | 6 |
| ⑤ | boy likes music | 2+2+2 | 6 |
以 ① 中的 is(位置 1)为例:window=2 时它能看到位置 0、2、3 的 he、a、good——而位置 4 的 boy 距离 3 步,看不到。全语料共现总次数
$$N=14+10+14+6+6=50\ \text{(有序对计数,M 对称)}$$
再看两个关键词对:boy 在 ①/②/⑤ 的窗口邻居分别是 {a, good}、{good, loves, learning}、{likes, music},girl 在 ③/④ 的邻居是 {a, good}、{loves, music}——两者从未落在彼此窗口内,所以 $M(\text{boy},\text{girl})=0$;而 boy 与 good 在 ① 和 ② 各共现一次,$M(\text{boy},\text{good})=2$。这些数字是下一节 PMI 手算的原料,也会被实验 1 的打印精确复现。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ---------- 实验 1:手写共现矩阵 + 窗口大小影响 ----------
import numpy as np
np.random.seed(0)

corpus = ['he is a good boy'.split(),
          'good boy loves learning'.split(),
          'she is a good girl'.split(),
          'girl loves music'.split(),
          'boy likes music'.split()]

vocab = sorted({w for s in corpus for w in s})
w2i = {w: i for i, w in enumerate(vocab)}
V = len(vocab)

def cooccurrence(corpus, window=2):
    """统计每个词 ±window 窗口内共现次数(对称窗口)"""
    M = np.zeros((V, V), dtype=float)
    for s in corpus:
        for i, w in enumerate(s):
            a = w2i[w]
            for j in range(max(0, i - window), min(len(s), i + window + 1)):
                if j != i:
                    M[a, w2i[s[j]]] += 1
    return M

M1 = cooccurrence(corpus, window=1)   # 紧邻词(偏句法)
M2 = cooccurrence(corpus, window=2)   # 稍远(偏语义)
print('词表(%d):' % V, vocab)
print('window=1 共现矩阵(前 6 词):\n', M1[:6, :6].astype(int))
print('window=2 共现矩阵(前 6 词):\n', M2[:6, :6].astype(int))
print('非零共现对: win1=%d | win2=%d' % ((M1 > 0).sum(), (M2 > 0).sum()))
print('boy-girl 共现次数: win1=%d | win2=%d' % (M1[w2i['boy'], w2i['girl']], M2[w2i['boy'], w2i['girl']]))
assert (M2 - M1 >= 0).all() and M2.sum() >= M1.sum()
print('要点:窗口是分布假设的"朋友圈半径";窗口越大越偏语义,越小越偏句法')
1.3 PMI:把"共同出现"变成"超出随机"¶
只数次数还不够:the 和任意词都常共现,次数高 ≠ 关系强。**PMI(点互信息)**把共现次数与随机基线比较,三步推导:
第一步:联合概率。 令 $N=\sum_{ij} M_{ij}$ 为总共现次数,则 $P(i,j)=\dfrac{M_{ij}}{N}$。
第二步:独立概率(随机基线)。 若 i、j 相互独立,期望共现概率为 $P(i)\,P(j)$,其中 $P(i)=\dfrac{M_i}{N}$,$M_i=\sum_j M_{ij}$ 是词 i 的行和。
第三步:比值取对数。
$$\text{PMI}(i,j) = \log \frac{P(i,j)}{P(i)\,P(j)} = \log \frac{M_{ij} \cdot N}{M_i \cdot M_j}$$
- PMI > 0:比随机更常共现 → 语义相关(如 boy 与 girl);
- PMI ≈ 0:与随机相当 → 无关(如 the 与 music);
- PMI < 0:比随机更少共现(如 he 与 music 几乎不挨着)——但负值多由低频噪音造成,不可靠。
负 PMI 的处理:PMI 下界是 $-\log N$,且负值没有"反义词"这类正面语义,所以普遍用 PPMI = max(PMI, 0)(正点互信息)只保留正相关,作为后续 SVD 的输入。
1.3b PMI 手算:代入真实数字再走一遍¶
把 §1.3 的公式套到具体词对上($N=50$,行和 $M_{\text{boy}}=7$、$M_{\text{good}}=8$,$M(\text{boy},\text{good})=2$):
$$\text{PMI}(\text{boy},\text{good})=\log\frac{M_{ij}\cdot N}{M_i\,M_j}=\log\frac{2\times50}{7\times8}=\log1.7857\approx0.580$$
视角 1(比值):观测共现 2 次,而"独立假设"下的期望次数只有 $\dfrac{M_i M_j}{N}=\dfrac{7\times8}{50}=1.12$ 次——实际是期望的 1.79 倍,所以 PMI>0(good 常修饰 boy/girl,形影不离)。
视角 2(对数):取对数把"倍率"变成可加减的"信息量",单位是 nat(以 e 为底)。对数的好处:$\log N$ 只带来整体平移、不改变词对排序,所以比较时直接用比值 $M_{ij}/(M_i M_j)$ 也行。
再看一个"该为 0 却算不下去"的词对:$M(\text{boy},\text{girl})=0$,直接代公式要算 $\log 0$——无定义!所以代码给分子加 $10^{-9}$ 平滑(M2 + 1e-9),于是
$$\text{PMI}(\text{boy},\text{girl})\approx\log\frac{50\times10^{-9}}{7\times4}\approx-20.1$$
被 PPMI 一刀切成 0。这就是 PPMI 的设计动机:不共现 ≠ 有意义的"负相关",负值绝大多数来自低频采样噪音,清零后 SVD 才能稳定工作。对照实验 1b 打印的"PMI 为负的元素数",你会发现大部分词对都落在这一档。
# ---------- 实验 1b:PMI 公式验证 + PPMI(负 PMI 清零) ----------
import numpy as np
np.random.seed(0)

N = M2.sum()                       # 总共现次数
row_sum = M2.sum(axis=1) + 1e-9    # 每词的共现次数(行和)
# PMI(i,j) = log( M_ij * N / (M_i * M_j) )
pmi = np.log((M2 + 1e-9) * N / (row_sum[:, None] * row_sum[None, :]))

# 手算对照:boy 与 good 这一对
i, j = w2i['boy'], w2i['good']
manual = np.log((M2[i, j] + 1e-9) * N / (row_sum[i] * row_sum[j]))
print('PMI(boy, good) 手算 = %.4f | 矩阵式 = %.4f' % (manual, pmi[i, j]))
assert abs(manual - pmi[i, j]) < 1e-8

# 负 PMI 处理:PPMI = max(PMI, 0)
ppmi = np.clip(pmi, 0, None)
print('PMI 为负的元素数: %d / %d(低频噪音造成,无"反义词"意义)' % ((pmi < 0).sum(), V * V))
print('PPMI 非零元素数: %d / %d' % ((ppmi > 0).sum(), V * V))
print('要点:PMI 衡量"比随机更常共现";PPMI 只保留正相关,是 SVD 的输入矩阵')
1.4 截断 SVD:从统计矩阵到稠密向量¶
PPMI 矩阵是 V×V 的稀疏大矩阵,直接当向量用代价高。SVD 把任意矩阵分解成三个因子:
$$X \approx U_d\, \Sigma_d\, V_d^{\top} = \underbrace{U_d \sqrt{\Sigma_d}}_{\text{词向量 } w_i} \cdot \underbrace{\sqrt{\Sigma_d}\, V_d^{\top}}_{\text{上下文向量 } \tilde{w}_j}$$
- 只保留前 $d$ 个奇异值/奇异向量,得到 $d$ 维词向量——这是 Frobenius 范数意义下的最优低秩近似;
- 重构误差:$\dfrac{\|X - \hat X_d\|_F}{\|X\|_F}$,d 越大误差越小(信息保留越多,但低频噪音也跟着进来);
- 复杂度:全量 SVD O(V³),大词表必须用随机化/迭代近似(sklearn
TruncatedSVD就是近似实现); - 这是 2013 年之前 LSA 时代的标准做法。局限:对矩阵每个元素一视同仁,低频对的噪音被同等对待;且无法在线学习新词 → 引出下一节的预测式词向量。
1.4b SVD 的几何直觉:旋转、拉伸、再旋转¶
SVD 的代数形式 $X=U\Sigma V^\top$ 背后是一个直观的几何故事:任何线性变换都可以拆成"旋转 → 沿坐标轴拉伸 → 旋转"三步。
- $V^\top$:先把向量旋转到"主方向坐标系";
- $\Sigma=\mathrm{diag}(\sigma_1,\dots,\sigma_r)$:沿每个主方向独立拉伸 $\sigma_i$ 倍——奇异值就是拉伸倍数,且 $\sigma_1\ge\sigma_2\ge\cdots$;
- $U$:把拉伸后的结果旋转回原空间。
截断 SVD 只保留前 $d$ 个主方向,等价于"扔掉拉伸倍数最小的方向":若 $\sigma_{d+1}\ll\sigma_1$,丢掉它几乎不损失信息。Eckart–Young 定理保证:在所有秩 ≤ d 的矩阵中,截断 SVD 是 Frobenius 范数意义下的最优近似——这正是实验 2 里手写与 sklearn 误差几乎相同的原因。
为什么词向量取 $U_d\sqrt{\Sigma_d}$ 而不是 $U_d$?因为要同时服务"词向量 $w_i$"与"上下文向量 $\tilde w_j$"两个角色,让 $\big(U_d\sqrt{\Sigma_d}\big)\big(\sqrt{\Sigma_d}\,V_d^\top\big)=U_d\Sigma_d V_d^\top\approx X$——两侧各分一半拉伸,内积 $w_i^\top\tilde w_j$ 才能还原"共现强度"。一分为二的奇异值,是把"词"与"上下文"映射进同一空间的关键。
# ---------- 实验 2:截断 SVD 词向量(手写 vs sklearn)+ 重构误差 ----------
%matplotlib inline
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import TruncatedSVD

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
np.random.seed(0)

def my_truncated_svd(X, d):
    """手写截断 SVD:X ≈ U_d Σ_d V_d^T,词向量取 U_d sqrt(Σ_d)"""
    U, S, Vt = np.linalg.svd(X, full_matrices=False)
    approx = U[:, :d] @ np.diag(S[:d]) @ Vt[:d, :]
    return approx, U[:, :d] * np.sqrt(S[:d])

ds = [1, 2, 3, 4, 6, 8, 10]
err_my, err_sk = [], []
for d in ds:
    approx, emb_d = my_truncated_svd(ppmi, d)
    err_my.append(np.linalg.norm(ppmi - approx) / np.linalg.norm(ppmi))
    svd = TruncatedSVD(n_components=d, random_state=0)
    emb_sk = svd.fit_transform(ppmi)
    err_sk.append(np.linalg.norm(ppmi - svd.inverse_transform(emb_sk)) / np.linalg.norm(ppmi))

print('d=8 重构相对误差: 手写=%.6f | sklearn=%.6f' % (err_my[5], err_sk[5]))
assert abs(err_my[5] - err_sk[5]) < 1e-4, '手写与 sklearn 应给出几乎相同的最优低秩近似'

plt.figure(figsize=(7, 4))
plt.plot(ds, err_my, 'o-', label='手写截断 SVD')
plt.plot(ds, err_sk, 's--', label='sklearn TruncatedSVD')
plt.xlabel('保留维度 d'); plt.ylabel('重构相对误差')
plt.title('截断 SVD 重构误差随维度下降(PPMI 矩阵)')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout(); plt.show()

emb_svd = my_truncated_svd(ppmi, 8)[1]
print('要点:SVD 给最优低秩近似;d 越大信息保留越多、误差越小(低频噪音也变多)')
2. CBOW 与 Skip-gram:把"统计邻居"变成"预测任务"¶
Word2Vec(Mikolov et al., 2013)把统计路线换成学习路线:训练神经网络用词预测词,训练完的权重就是词向量。
2.1 两种结构¶
CBOW(Continuous Bag-of-Words)            Skip-gram
 上下文 w_{t-2},w_{t-1},w_{t+1},w_{t+2}      中心词 w_t
        │  求和/平均                                │
        ▼                                          ▼
       h = (1/2m) Σ v_{w_j}                        v_{w_t}
        │  预测中心词                                │  预测每个上下文词
        ▼                                          ▼
  P(w_t | 上下文)                          P(w_{t+j} | w_t), j=±1..±m
| 特性 | CBOW | Skip-gram |
|---|---|---|
| 方向 | 上下文 → 中心词(聚合) | 中心词 → 上下文(展开) |
| 训练速度 | 快(一个样本聚合全部上下文) | 慢(一个中心词产生 2m 个样本) |
| 低频词 | 较弱(低频词很少当中心词被"看见") | 更强(低频词作中心词时照样更新自身向量) |
| 高频词 | 稳(高频词作中心词样本多) | 高频词样本爆炸,需负采样平衡 |
| 适合场景 | 大语料、高频词密集 | 小语料、低频词/稀有词 |
面试点:为什么 Skip-gram 对低频词友好? 低频词作为中心词出现一次,就产生 2m 个 (中心词, 上下文) 训练对,自身向量被更新 2m 次;而 CBOW 中低频词多数时候只是上下文里的一个词,自身向量只在"它当中心词"时更新,机会少得多。
2.1b 结构图:一眼看懂两种"预测方向"¶
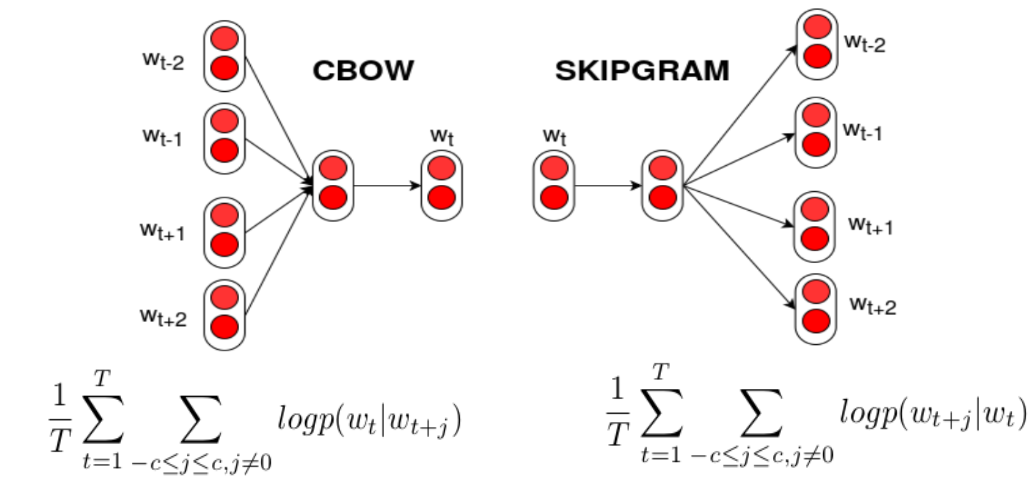
图 1:CBOW 与 Skip-gram 结构对比(来源:Wikimedia Commons,CC BY-SA 4.0)
图中左右两半是两种相反的信息流:左边 CBOW 把窗口内上下文词 $w(t-2)\dots w(t+2)$ 投影到隐藏层并求和/平均成一个向量,用它预测正中间的 $w(t)$——"多个输入、一个输出";右边 Skip-gram 从中心词 $w(t)$ 出发,分别预测窗口内每个上下文词——"一个输入、多个输出"。
注意两点:① 输入层→隐藏层的权重矩阵每一行是"词作为输入"的向量,隐藏层→输出层的权重每一行是"词作为输出"的向量,两者训练后都能当词向量用(通常取输入向量,或两者拼接/相加);② Skip-gram 的"多个输出"共享同一套参数,负采样后就等价于 2m 次独立二分类——这正是它"慢但稳、低频词友好"的根源。
2.2 原始目标:softmax 太贵¶
设中心词 $w$ 的向量为 $v_w$,上下文词 $c$ 的向量为 $u_c$(两类向量分开存,维度都是 d)。原始目标是多分类:
$$P(c \mid w) = \frac{\exp(u_c^{\top} v_w)}{\sum_{c' \in V} \exp(u_{c'}^{\top} v_w)}$$
对数似然 $\mathcal{L} = \sum_{(w,c)} \log P(c \mid w)$,用 SGD 最大化。
为什么不行:分母要对整个词表求和,一次更新 O(V·d)。V=10⁵、d=100 时,一个样本就要 10⁷ 次乘加——每个训练对都来一遍,完全不可接受。
复杂度对比:softmax 分母 O(V·d) vs 负采样 O((K+1)·d),K 通常取 5~20。V=10⁵、K=5 时相差约 1.7 万倍。
2.3 负采样:把多分类换成 K 次二分类¶
思想:不要求模型"从 V 个词里挑出正确项",只要求"认出正样本、拒绝 K 个随机负样本"。用 sigmoid 做二分类:
$$\sigma(x) = \frac{1}{1+e^{-x}}, \qquad \sigma(-x) = 1 - \sigma(x)$$
对每个 (中心词 $w$, 正上下文 $c$) 样本,损失为:
$$L = -\log \sigma(u_c^{\top} v_w) - \sum_{k=1}^{K} \log \sigma(-u_{w_k}^{\top} v_w)$$
- 第一项:正样本 logit 越大越好(σ→1,损失→0);
- 第二项:K 个负样本 $w_k$(按噪声分布采样)的 logit 越小越好(σ(-大数)→0);
- 总梯度来自 K+1 个"二分类",复杂度 O((K+1)·d);
- 注意:负采样不是 softmax 的等价物,只是代理目标(NCE 的简化版,无归一化项)——学出的向量好用,但 $e^{u_c^{\top}v_w}$ 不是真实概率。
2.3b 手算一个完整的负采样更新(V=3,跟着算一遍)¶
设微型词表只有 3 个词:中心词 apple、正上下文 fruit、负样本 the;向量 2 维,初值:
$$v_{\text{apple}}=(1.0,\ 0.5),\qquad u_{\text{fruit}}=(0.8,\ 0.2),\qquad u_{\text{the}}=(0.5,\ -0.5)$$
第一步:算两个 logit。 $x_+=u_{\text{fruit}}^\top v_{\text{apple}}=0.8\times1.0+0.2\times0.5=0.9$;$x_-=u_{\text{the}}^\top v_{\text{apple}}=0.5\times1.0+(-0.5)\times0.5=0.25$。
第二步:算损失(K=1)。 $$L=-\log\sigma(0.9)-\log\sigma(-0.25)\approx-\log0.711-\log0.438\approx0.342+0.826=1.168$$
第三步:算梯度并更新 $v_{\text{apple}}$($lr=0.5$)。 套用 §2.4 的公式: $$\nabla_{v_{\text{apple}}}L=\big(\sigma(0.9)-1\big)u_{\text{fruit}}+\sigma(0.25)\,u_{\text{the}}\approx-0.289\,(0.8,0.2)+0.562\,(0.5,-0.5)=(0.050,\ -0.339)$$ $$v_{\text{apple}}\leftarrow(1.0,\ 0.5)-0.5\times(0.050,\ -0.339)=(0.975,\ 0.669)$$
第四步:读结果。 更新前后两个 logit:$u_{\text{fruit}}^\top v_{\text{apple}}:\ 0.9\to0.914$(正样本方向再靠近一点),$u_{\text{the}}^\top v_{\text{apple}}:\ 0.25\to0.153$(负样本被明显推开)。一次更新同时完成"确认关系"与"划清界限"——这就是负采样全部的秘密。若负样本 logit 一开始就很小(如 −5,σ≈0.007),则 $\sigma(x_-)$ 项几乎为 0,负样本"不添乱"——梯度主要由正样本决定,训练自然稳定。实验 4 的 dW += ... 循环正是这三行的向量化实现(g1 对应 $\sigma(u_c^\top v_w)-1$,g2 对应 $\sigma(u_k^\top v_w)$)。
2.4 梯度推导(手撕必考,逐步来)¶
记 $x = u^{\top} v_w$。sigmoid 的导数 $\sigma'(x)=\sigma(x)(1-\sigma(x))$,由此 $\frac{d}{dx}\log\sigma(x)=1-\sigma(x)$。
① 正样本项 $L_+ = -\log\sigma(u_c^{\top} v_w)$:
$$\frac{\partial L_+}{\partial v_w} = \big(\sigma(u_c^{\top}v_w) - 1\big)\, u_c, \qquad \frac{\partial L_+}{\partial u_c} = \big(\sigma(u_c^{\top}v_w) - 1\big)\, v_w$$
② 负样本项 $L_- = -\log\sigma(-u_k^{\top} v_w)$:链式法则——由 $\frac{d}{dz}\log\sigma(z)=1-\sigma(z)=\sigma(-z)$ 与 $\frac{d}{dv_w}(-u_k^{\top}v_w)=-u_k$,令 $g_k=\sigma(u_k^{\top}v_w)$(注意:σ 作用在正 logit 上,因为 $\frac{d}{dx}[-\log\sigma(-x)]=\sigma(x)$):
$$\frac{\partial L_-}{\partial v_w} = g_k\, u_k, \qquad \frac{\partial L_-}{\partial u_k} = g_k\, v_w$$
③ 合并,按梯度下降 $v \leftarrow v - \text{lr}\cdot\nabla_v L$ 一次更新三处参数:
$$\boxed{\;\nabla_{v_w}L = \big(\sigma(u_c^{\top}v_w)-1\big) u_c + \sum_{k=1}^{K} \sigma(u_k^{\top}v_w)\, u_k\;}, \qquad \nabla_{u_c}L = \big(\sigma(u_c^{\top}v_w)-1\big) v_w, \qquad \nabla_{u_k}L = \sigma(u_k^{\top}v_w)\, v_w$$
直觉:正样本 logit 大 → σ→1 → 系数 (σ−1)→0(已学够,无需再改);负样本 logit($u_k^{\top}v_w$)不该大却大 → σ 大 → 梯度把中心词与负上下文向量互相推开。实验 4 完全按这三行实现,代码里 g2 = sigmoid(C[k] @ W[a]) 就是 $g_k$。
2.5 负采样分布:为什么是 3/4 次幂?¶
负样本按噪声分布 $P(w) \propto \text{freq}(w)^{\alpha}$ 采样,Word2Vec 取 α=0.75。为什么不是 α=1 或 α=0?
- α=1(原始频率):负样本几乎全是高频词(the、of…),模型反复"拒绝同一批词",低频词永远学不到"被拒绝"的梯度信号;
- α=0(均匀采样):负样本大多是"远房亲戚",训练不稳定;
- α=0.75:折中——压低高频、抬高低频。
数字示例(实验 3 会精确打印,此处为近似值;语料 freq 总和 7109):
| 词 | freq | P=freq/Σ | P=freq^0.75/Σ | 变化 |
|---|---|---|---|---|
| the | 2500 | ≈0.352 | ≈0.298 | 降到 ≈0.85× |
| girl | 4 | ≈0.0006 | ≈0.0024 | 提升 ≈4.2× |
直觉:3/4 次幂把稀有词的相对采样概率拉高 4 倍以上、高频词压低,负样本变得"有信息量",训练更稳。这也是面试常考数字:窗口 5、负采样 K=5、维度 100~300、α=0.75、GloVe x_max=100。
2.6 另一条路:层次 Softmax 与高频词二次采样¶
负采样不是唯一的加速手段,原始论文还提出层次 Softmax(hierarchical softmax):把词表组织成一棵 Huffman 树(高频词靠近根、编码短),每个词对应一条"根→叶"路径;预测一个词 = 沿路径逐层做二分类(每层只问"往左还是往右"),复杂度从 O(V) 降到 O(log V)。它与负采样二选一——论文正文用负采样,附录讨论层次 Softmax。面试若问"除了负采样还有什么加速 trick",答出"Huffman 树 + 每步一次二分类 + O(log V)"即可。
原论文还有两个常被忽略的训练技巧:
- 高频词二次采样(subsampling):训练时以概率 $P(w)=1-\sqrt{t/f_w}$ 丢弃高频词样本(阈值 $t\approx10^{-5}$),防止 the、of 这类词霸占梯度——方向与 3/4 次幂一致:给稀有词更多话语权;
- 短语合并:把 "New York" 这类高频共现组合(用 PMI 阈值判断)先拼成一个 token 再训练,让向量学到词组级语义。
📌 扩展阅读:2013 两篇论文定义 word2vec(CBOW/Skip-gram + 负采样/二次采样),2014 GloVe 把共现统计直接变成损失,2016 fastText 用字符 n-gram 解决 OOV——三者合称"静态词向量三件套"。
# ---------- 实验 3:负采样分布 3/4 次幂(数值演示 + 手写采样器) ----------
import numpy as np
np.random.seed(0)

words = ['the', 'of', 'and', 'to', 'a', 'in', 'boy', 'girl']
freq = np.array([2500, 1300, 1100, 900, 700, 600, 5, 4], dtype=float)

p1 = freq / freq.sum()                    # α=1:原始频率
p75 = freq ** 0.75; p75 /= p75.sum()      # α=0.75:3/4 次幂
ratio = p75 / p1

print('%-6s %6s %10s %12s %10s' % ('词', 'freq', 'P(freq)', 'P(freq^0.75)', '变化'))
for w, f, a, b, r in zip(words, freq, p1, p75, ratio):
    print('%-6s %6d %10.4f %12.4f %9.2fx' % (w, int(f), a, b, r))

print('\nthe  采样概率: %.4f -> %.4f(高频被降权)' % (p1[0], p75[0]))
print('girl 采样概率: %.4f -> %.4f(提升 %.2f 倍)' % (p1[-1], p75[-1], ratio[-1]))
assert ratio[-1] > 1.0 and ratio[0] < 1.0

# 手写负采样器:按 P(w) ∝ freq^0.75 采样 20000 次,验证经验频率 ≈ 理论
def neg_sampler(freq, power=0.75):
    pw = freq ** power
    return pw / pw.sum()

pw = neg_sampler(freq)
counts = np.zeros(len(freq))
for _ in range(20000):
    counts[np.random.choice(len(freq), p=pw)] += 1
emp = counts / counts.sum()
print('采样 20000 次: girl 经验频率=%.3f%% | 理论=%.3f%%' % (emp[-1] * 100, pw[-1] * 100))
assert abs(emp[-1] - pw[-1]) < 0.01
print('要点:3/4 次幂抬高稀有词、压低高频词 → 负样本多样,训练稳定')
# ---------- 实验 4:手写 numpy Skip-gram + 负采样训练 + 相似词检索 ----------
import numpy as np
np.random.seed(0)

def sigmoid(x):
    return 1 / (1 + np.exp(-np.clip(x, -30, 30)))

def train_skipgram(corpus, dim=12, epochs=800, ns=3, lr=0.05, window=2):
    """手写 Skip-gram:中心词向量 W + 上下文向量 C,负采样更新(§2.4 推导的梯度)"""
    vocab_l = sorted({w for s in corpus for w in s})
    w2i_l = {w: i for i, w in enumerate(vocab_l)}
    V = len(vocab_l)
    freq = np.array([sum(s.count(w) for s in corpus) for w in vocab_l], dtype=float)
    freq = np.maximum(freq, 1.0)
    r1, r2 = np.random.default_rng(0), np.random.default_rng(1)
    W = r1.normal(0, 0.1, (V, dim))     # 中心词向量
    C = r2.normal(0, 0.1, (V, dim))     # 上下文词向量
    pairs = []
    for s in corpus:
        for i, w in enumerate(s):
            a = w2i_l[w]
            for j in range(max(0, i - window), min(len(s), i + window + 1)):
                if j != i:
                    pairs.append((a, w2i_l[s[j]]))
    pw = freq ** 0.75; pw /= pw.sum()   # 负采样分布 freq^0.75
    for ep in range(epochs):
        r3 = np.random.default_rng(ep)
        for a, c_pos in pairs:
            negs = r3.choice(V, size=ns, p=pw)
            # 中心词梯度:∂L/∂v_w = (σ(u_c·v_w)-1)u_c + Σ σ(u_k·v_w) u_k
            dW = np.zeros(dim)
            g1 = sigmoid(C[c_pos] @ W[a]) - 1
            dW += g1 * C[c_pos]
            gs = []
            for k in negs:
                g2 = sigmoid(C[k] @ W[a])   # g_k = σ(u_k·v_w)(σ 作用在正 logit 上)
                dW += g2 * C[k]
                gs.append(g2)
            W[a] -= lr * dW
            # 正上下文梯度:∂L/∂u_c = (σ(u_c·v_w)-1) v_w
            C[c_pos] -= lr * g1 * W[a]
            # 负上下文梯度:∂L/∂u_k = σ(u_k·v_w) v_w(把负样本推开)
            for k, g2 in zip(negs, gs):
                C[k] -= lr * g2 * W[a]
    return vocab_l, w2i_l, W, C

vocab2, w2i2, W, C = train_skipgram(corpus)
print('训练完成: %d 个词 x %d 维 | boy 向量前 4 维: %s' %
      (len(vocab2), W.shape[1], np.round(W[w2i2['boy']][:4], 3)))

def cos(a, b):
    return a @ b / ((np.linalg.norm(a) + 1e-9) * (np.linalg.norm(b) + 1e-9))

def top_similar(v, k=5, exclude=None):
    sims = [cos(v, W[i]) for i in range(len(W))]
    order = np.argsort(-np.array(sims))
    return [(vocab2[i], round(sims[i], 3)) for i in order if i != exclude][:k]

print('boy 的相似词:', top_similar(W[w2i2['boy']], exclude=w2i2['boy']))
print('girl 的相似词:', top_similar(W[w2i2['girl']], exclude=w2i2['girl']))
assert W.shape == (len(vocab2), 12)
print('要点:训练不产生真实概率,产出的是"语义坐标";负采样 K 越大越稳、越慢')
# ---------- 实验 5(新增):手写 numpy CBOW + 负采样训练 ----------
import numpy as np
np.random.seed(0)

def train_cbow(corpus, dim=12, epochs=300, ns=3, lr=0.05, window=2):
    """CBOW:上下文向量取平均 h → 预测中心词,负采样更新"""
    vocab_l = sorted({w for s in corpus for w in s})
    w2i_l = {w: i for i, w in enumerate(vocab_l)}
    V = len(vocab_l)
    freq = np.array([sum(s.count(w) for s in corpus) for w in vocab_l], dtype=float)
    freq = np.maximum(freq, 1.0)
    Wc = np.random.normal(0, 0.1, (V, dim))   # 上下文词向量
    Wo = np.random.normal(0, 0.1, (V, dim))   # 输出(中心词)向量
    samples = []                             # (上下文索引列表, 中心词索引)
    for s in corpus:
        for i, w in enumerate(s):
            ctx = [w2i_l[s[j]] for j in range(max(0, i - window), min(len(s), i + window + 1)) if j != i]
            if ctx:
                samples.append((ctx, w2i_l[w]))
    pw = freq ** 0.75; pw /= pw.sum()
    for ep in range(epochs):
        for ctx, c in samples:
            h = np.mean(Wc[ctx], axis=0)          # 上下文平均 h
            g1 = sigmoid(Wo[c] @ h) - 1           # 正样本系数
            negs = np.random.choice(V, size=ns, p=pw)
            gs = []
            dWo = g1 * h
            for k in negs:
                gk = sigmoid(-Wo[k] @ h)          # 负样本系数
                dWo += gk * h
                gs.append(gk)
            Wo[c] -= lr * dWo
            # 上下文梯度:每个 ctx 词分摊 ∂L/∂h 的 1/|ctx|
            dWc = (g1 * Wo[c] + sum(gk * Wo[k] for k, gk in zip(negs, gs))) / len(ctx)
            for j in ctx:
                Wc[j] -= lr * dWc
    return vocab_l, w2i_l, Wc, Wo

vocab3, w2i3, Wc, Wo = train_cbow(corpus)
print('CBOW 训练完成: %d 个词 x %d 维' % (len(vocab3), Wc.shape[1]))

def cos_c(a, b):
    return a @ b / ((np.linalg.norm(a) + 1e-9) * (np.linalg.norm(b) + 1e-9))

def sim_cbow(w):
    v = Wc[w2i3[w]]
    sims = [(vocab3[i], cos_c(v, Wc[i])) for i in range(len(vocab3)) if i != w2i3[w]]
    return sorted(sims, key=lambda t: -t[1])[:4]

print('CBOW: girl 的相似词:', sim_cbow('girl'))
print('要点:CBOW 一次聚合全部上下文 → 训练快;对低频词不如 Skip-gram(低频词很少当中心词)')
3.2 GloVe 损失逐步推导¶
第一步:概率比比单个概率更有区分度。 对中心词 i 与两个上下文 j、k,定义共现概率 $P_{ij}=M_{ij}/M_i$。统计发现概率比 $P_{ij}/P_{ik}$ 比单个 $P_{ij}$ 更能区分语义(经典例子:ice 与 steam 对 solid/gas 的概率比差异巨大)。
第二步:双线性模型。 希望向量内积还原对数概率:
$$v_i^{\top} \tilde v_j = \log P_{ij} = \log M_{ij} - \log M_i$$
第三步:加偏置并转成加权平方误差。 用 $b_i + \tilde b_j$ 吸收 $\log M_i$ 等归一化项,损失为:
$$J = \sum_{i,j} f(M_{ij}) \big( v_i^{\top} \tilde v_j + b_i + \tilde b_j - \log M_{ij} \big)^2$$
第四步:权重函数 f(x)(降噪):
$$f(x) = \begin{cases} (x/x_{max})^{\alpha}, & x < x_{max} \\ 1, & x \ge x_{max} \end{cases}, \qquad \alpha = 0.75,\ x_{max} = 100$$
- 低频对(x 小、噪音大)降权;高频对封顶,防止 the 类词主导;
- 与 PMI/SVD 的关系:忽略偏置与权重时,最优解满足 $v_i^{\top}\tilde v_j \approx \log M_{ij}$——这正是对 logM 做低秩分解。所以实验 6 用 SVD 求 logM 的最优低秩近似,与 GloVe 是同一目标(真实 GloVe 用 SGD + 加权更精细);
- 复杂度:一次遍历矩阵全部非零元素 O(|M|₀·d),比逐样本 SGD 更可控。
3.2b 经典数字表:为什么"概率比"而非"概率"¶
GloVe 论文开篇的 Table 1 用 ice 与 steam 示范:单独看 $P(\text{solid}\mid\text{ice})$ 或 $P(\text{solid}\mid\text{steam})$ 都是 $10^{-4}$ 量级的小概率,看不出门道;但看比值立刻分层:
| 上下文词 k | $P(k\mid\text{ice})\ /\ P(k\mid\text{steam})$ | 解读 |
|---|---|---|
| solid | ≈ 8.9 | 与 ice 更相关(冰是固态) |
| gas | ≈ 8.5×10⁻² | 与 steam 更相关(汽是气态) |
| water | ≈ 1.36 | 与两者都相关(比值≈1) |
| fashion | ≈ 0.96 | 与两者都不相关(比值≈1) |
比值 ≫1 表示 k 能区分 ice/steam(相态);比值 ≈1 表示 k 对两者一视同仁——要么都相关(water),要么都不相关(fashion)。这就是 §3.2 第一步的动机:概率受词频污染,比值把词频因素约掉。数学上,GloVe 希望 $$v_i^\top(\tilde v_j-\tilde v_k)\approx\log\frac{P_{ij}}{P_{ik}}$$ 即"比值关系"被建模成向量内积之差——这为 §4 的向量算术提供了理论注脚:语义关系 = 词空间中的差向量。看完这张表再回看 §3.1 的类比:Word2Vec 靠抽样逼近这些比值,GloVe 直接拟合它们的对数。
# ---------- 实验 6:GloVe 损失 + SVD 近似解(手写 vs sklearn)+ f(x) 曲线 ----------
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import TruncatedSVD
np.random.seed(0)

# GloVe 忽略偏置与权重时的最优解 ≈ 对 logM 做低秩分解
logM = np.log(M2 + 1.0)

svd = TruncatedSVD(n_components=8, random_state=0)
emb_glove = svd.fit_transform(logM)
print('GloVe 式(logM 低秩分解)词向量维度:', emb_glove.shape)

U2, S2, Vt2 = np.linalg.svd(logM, full_matrices=False)
emb_glove2 = U2[:, :8] * np.sqrt(S2[:8])
logM_approx = U2[:, :8] @ np.diag(S2[:8]) @ Vt2[:8, :]

err_sk = np.linalg.norm(svd.inverse_transform(emb_glove) - logM) / np.linalg.norm(logM)
err_my = np.linalg.norm(logM_approx - logM) / np.linalg.norm(logM)
print('重构相对误差: sklearn=%.4f | 手写截断SVD=%.4f(同一 logM 的最优低秩近似)' % (err_sk, err_my))
assert err_my < 0.2 and err_sk < 0.3

# GloVe 权重函数 f(x) 可视化
def glove_weight(x, x_max=100.0, alpha=0.75):
    return np.minimum((x / x_max) ** alpha, 1.0)

xs = np.linspace(0, 200, 201)
plt.figure(figsize=(7, 4))
plt.plot(xs, glove_weight(xs), label=r'$f(x)=\min((x/100)^{0.75},1)$')
plt.axvline(100, ls='--', color='gray', label='x_max=100')
plt.xlabel('共现次数 x'); plt.ylabel('权重 f(x)')
plt.title('GloVe 权重函数:低频降权、高频封顶')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('要点:真实 GloVe 用 SGD 拟合"加权"平方误差;此处用 SVD 演示同一目标的近似最优解')
4. 类比实验与可视化:词向量的"王炸"性质¶
4.1 向量算术:语义关系 = 向量平移¶
训练好的向量里,语义关系表现为向量平移:
$$\vec{king} - \vec{man} + \vec{woman} \approx \vec{queen}$$
即"男性→女性"这个变换,在词空间对应一条一致的位移向量。评测用 Google analogy 数据集(语义/句法类比),准确率是经典基准。
余弦相似度(比较方向而非长度):
$$\cos(a, b) = \frac{a \cdot b}{\|a\| \, \|b\|}, \qquad \cos \in [-1, 1]$$
注意:小语料类比结果仅供参考——需要语料里真的存在"性别成对"用法(he/she、boy/girl)。我们的小语料恰好有这些词,可验证 boy − he + she ≈ girl、loves ≈ likes。
# ---------- 实验 7:余弦相似度 + 性别类比 + PCA 可视化 ----------
import numpy as np
import matplotlib.pyplot as plt
import os
from sklearn.decomposition import PCA
np.random.seed(0)

def cos7(a, b):
    return a @ b / ((np.linalg.norm(a) + 1e-9) * (np.linalg.norm(b) + 1e-9))

# 性别类比:boy - he + she 应最接近 girl(向量算术 = 语义关系)
r = W[w2i2['boy']] - W[w2i2['he']] + W[w2i2['she']]
sims = [(vocab2[i], cos7(r, W[i])) for i in range(len(W))]
sims_sorted = sorted(sims, key=lambda t: -t[1])[:5]
print('boy - he + she 的最近词:', [w for w, _ in sims_sorted])
rank = [w for w, _ in sims_sorted].index('girl') + 1 if 'girl' in [w for w, _ in sims_sorted] else None
print('girl 的相似度排名:', rank if rank else '不在 Top5')
assert cos7(r, W[w2i2['girl']]) > cos7(r, W[w2i2['music']])

# 近义对比:loves 与 likes 应比 loves 与 music 更接近
cll = cos7(W[w2i2['loves']], W[w2i2['likes']])
clm = cos7(W[w2i2['loves']], W[w2i2['music']])
print('cos(loves, likes)=%.3f | cos(loves, music)=%.3f' % (cll, clm))
assert cll > clm

# PCA 可视化(中文标题)
pts = PCA(n_components=2, random_state=0).fit_transform(W)
fig, ax = plt.subplots(figsize=(8, 6))
for w in vocab2:
    i = w2i2[w]
    ax.scatter(pts[i, 0], pts[i, 1], s=200)
    ax.annotate(w, (pts[i, 0], pts[i, 1]), ha='center', va='center', fontsize=11)
ax.set_title('词向量 PCA 投影(he/she、boy/girl 语义相近 -> 位置相近)')
ax.grid(alpha=0.3); plt.tight_layout()
img_dir = '10-自然语言处理/教学/images'
os.makedirs(img_dir, exist_ok=True)
plt.savefig(os.path.join(img_dir, 'nlp02_vec.png'), dpi=110, bbox_inches='tight')
plt.show()
print('读图:同义词/相关词聚在一起;这就是"语义坐标"的直观样子')
4.2 读图:词向量空间的"示意图"长什么样¶
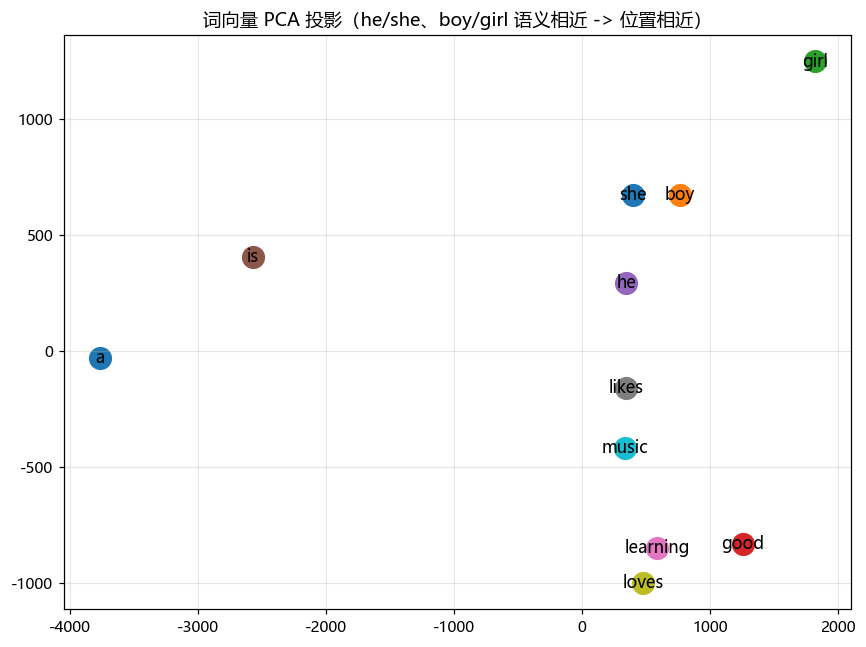
图 2:本实验 PCA 投影得到的词向量空间(实验 7 生成,自绘)
这是一张把 11 个词的向量压到 2D 的散点图,读图注意三点:
- 距离 = 语义:
he/she、boy/girl各自聚成小簇——它们出现在几乎相同的上下文里(he is a good… 与 she is a good…),学出的向量自然"挨着";boy与music这类只有间接关联的词距离明显更远; - PCA ≠ 原空间:2D 只保留方差最大的两个方向,图上距离是近似——定量比较请用 §4.1 的余弦相似度,别只盯 2D 散点;
- 为什么小语料也有效:本语料里性别词对 (he/she、boy/girl) 的用法高度成对("he is a good boy" vs "she is a good girl"),Skip-gram 从中学到了稳定的"男性↔女性"位移——这正是 §4.1 类比实验能成立的前提。
5. 局限与演进:为什么还需要 ELMo/BERT¶
① 静态向量:每个词只有一个向量,不随句子上下文变化——"bank" 在"河岸"和"银行"里是同一个向量。
② 一词多义:词向量是语料中所有用法统计的"平均值",多义词被压成"混合向量",哪个义项都不准。
③ OOV 问题:训练词表外的新词(专名、拼写变体)没有向量。经典缓解:<UNK> 占位、subword(fastText 用字符 n-gram)。
| 问题 | 表现 | 后续方案 |
|---|---|---|
| 静态 | 同一词处处同向量 | ELMo:双向 LSTM 输出随上下文变化 |
| 多义词 | bank / 苹果 混合向量 | BERT:自注意力按句内上下文重算表示 |
| OOV | 新词无向量 | subword/BPE 分词、字符级向量 |
演进主线:本篇的静态词向量(Word2Vec/GloVe)→
05-预训练模型与微调的上下文词向量(ELMo/BERT 把"查表"变成"按上下文计算")。
5.1 演进时间线:静态 → 上下文相关(一张图记住五代模型)¶
| 年份 | 模型 | 表示 | 关键创新 | 对应本节的补丁 |
|---|---|---|---|---|
| 2013 | Word2Vec | 静态 | 预测式训练 + 负采样 | 奠基 |
| 2014 | GloVe | 静态 | 全局共现加权拟合 | 更好利用统计量 |
| 2016 | fastText | 静态+subword | 字符 n-gram 求和 | OOV 与形态学 |
| 2018 | ELMo | 上下文相关 | 双向 LSTM 各层向量加权 | 一词多义 |
| 2018 | BERT | 上下文相关 | Transformer + MLM | 多义词 + 长距离 |
三个"补丁"分别对应 §5 的三个局限:
- OOV → fastText 子词:把 playing 拆成字符 n-gram 片段(
<pl、pla、lay…),词向量 = 片段向量之和——没见过的拼写也能"拼"出向量,且 play/playing/played 共享词根、形态相关; - 一词多义 → ELMo 的按句计算:不再查静态表,把句子喂进双向 LSTM,每个词位得到随上下文变化的向量——bank 在"河岸句"与"银行句"里表示不同;BERT 用 Transformer + 掩码语言模型把这条路走到极致(详见 05 篇);
- 静态 → 检索式 vs 计算式:Word2Vec/GloVe 训练完是"查表";预训练模型是"按句计算"。计算式天然能利用句内任意位置的上下文。
面试一句话:静态词向量回答"词像谁",上下文表示回答"这句话里的这个词是谁"——前者查表,后者算。
6. 数字敏感度与易错点(背诵)¶
必背数字
- Word2Vec 默认:窗口 5、负采样 K=5、维度 100~300、低频词截断 5(freq<5 丢弃)
- 负采样噪声分布指数 α=0.75;GloVe 的 x_max=100、α=0.75
- PPMI = max(PMI, 0);PMI 下界 $-\log N$
- 复杂度:softmax O(V·d) vs 负采样 O((K+1)·d);共现矩阵存储 O(V²)
面试官爱问的坑
- 负采样不是 softmax 等价物:σ 输出不构成归一化概率;向量可用、概率不可用(NCE 简化版)。
- CBOW 与 Skip-gram 谁快谁稳:CBOW 快但对低频词弱;Skip-gram 慢但对低频词友好——"低频"是面试高频关键词。
- 3/4 次幂的作用:提高稀有词采样概率、压低高频词(不是 0.5、不是 1)。
- 词向量不区分多义词:"苹果"公司 vs 水果是同一个向量——不是 bug,是静态表示的固有局限。
- 类比依赖语料:king−man+woman≈queen 需要语料里有足够多"性别成对"用法;小语料上结果不稳定,别拿小语料下结论。
7. 面试速答(30 秒背诵版)¶
- 分布式假设:上下文相似的词语义相似("词由邻居定义")。
- 共现 vs PMI:共现数次数;PMI 比随机基线 log(P(i,j)/(P(i)P(j)));负值截断为 PPMI。
- CBOW vs Skip-gram:上下文→中心 vs 中心→上下文;Skip-gram 对低频/小语料友好,CBOW 更快。
- 为什么负采样:softmax 分母 O(V) 太贵 → 1 正 + K 负的二分类,O((K+1)·d)。
- 3/4 次幂:freq^0.75 压低高频、抬高低频,负样本更有信息量。
- GloVe:拟合 v_i·v'_j + b ≈ log M_ij 的加权平方误差;本质是 logM 的低秩分解(≈ PMI/SVD 路线)。
- 类比:king − man + woman ≈ queen;语义关系 = 向量平移,用余弦相似度度量。
- 局限:静态、一词多义、OOV → ELMo/BERT 上下文表示(05 篇)。
8. 自测清单¶
- 手写共现矩阵与 PPMI 公式:PMI = log(M_ij·N/(M_i·M_j)),并解释负值为何清零
- 口算:V=1e5 词表,softmax 一次更新量级 vs 负采样 K=5(答案:1e5·d vs 6·d)
- 手写 Skip-gram 一次参数更新的三行梯度(正样本/负样本/中心词)并说出每步含义
- 解释 3/4 次幂:给定 freq=1000 与 freq=1 两词,判断采样概率提升/下降方向
- 说清 GloVe 损失四步推导与 f(x) 两段定义(x_max=100、α=0.75)
- 说出 Word2Vec 与 GloVe 的根本差异(在线抽样 vs 全局统计拟合)
- 用本实验复现:boy−he+she≈girl、loves≈likes,并画出中文 PCA 图
- 说出静态词向量三大局限及 ELMo/BERT 的对应解法
- 手撕:写一个按 freq^0.75 采样的负采样器(20 行内)
💡 下一篇
03-RNN 与 LSTM:词向量是"死的"(查表即得),RNN 让表示随序列上下文流动(h_t 携带历史信息),解决定长窗口与静态向量的问题。