⚖️ 04 · 假设检验入门(z 检验 / t 检验)¶
估计完参数,下一步是做决策:新算法真的比旧算法快吗?A/B 两组转化率有差异吗? 假设检验就是"在不确定性下做判断"的框架。本节把检验五步走、 两类错误、p 值、z/t 检验全部讲透并手写。
📋 本节要解决的问题¶
- 假设检验的标准流程是什么?(五步走)
- p 值到底是什么?"p<0.05"正确理解是什么?
- 第一类错误(α)与第二类错误(β)怎么区分?功效 = 1-β
- z 检验 vs t 检验怎么选?
- p 值的三大经典误区有哪些?
1️⃣ 假设检验五步走(面试默写)¶
- 设假设:$H_0$(原假设,通常"无差异")vs $H_1$(备择假设)
- 定显著性水平 α(默认 0.05)
- 算检验统计量(z/t/χ²/F…)
- 算 p 值:在 H₀ 下,得到"至少这么极端"数据的概率
- 做结论:p < α → 拒绝 H₀(有显著差异);否则不拒绝
注意:不拒绝 ≠ 接受 H₀,只表示"证据不足"。
2️⃣ 两类错误(必考)¶
| 拒绝 H₀ | 不拒绝 H₀ | |
|---|---|---|
| H₀ 为真 | 第一类错误 α(假阳性) | ✅ 正确 |
| H₀ 为假 | ✅ 正确(功效 1-β) | 第二类错误 β(假阴性) |
- α 是我们能接受的假阳性率(通常 0.05)
- β 与样本量、效应量有关:n 越大、效应越大,β 越小
- 功效 power = 1-β:能检测出真实效应的概率
import numpy as np
# 模拟两类错误:H0 为真时拒绝的比例 ≈ α
rng = np.random.RandomState(6)
alpha = 0.05
n, trials = 40, 20000
reject = 0
for _ in range(trials):
    x = rng.normal(10, 3, n)   # 真均值 10
    z = (np.mean(x) - 10) / (3 / np.sqrt(n))
    p = 2 * (1 - __import__('scipy.stats', fromlist=['norm']).norm.cdf(abs(z)))
    if p < alpha:
        reject += 1
print('H0 为真时拒绝比例: %.4f(≈α=%.2f ✅)' % (reject / trials, alpha))
assert abs(reject / trials - alpha) < 0.01
H0 为真时拒绝比例: 0.0491(≈α=0.05 ✅)
📖 论文配图:单侧 p 值的几何含义¶
图源:Kim J & Bang H (2016) Three common misuses of P values, Dental Hypotheses 7(3)(开放获取,CC-BY 4.0)图 1。
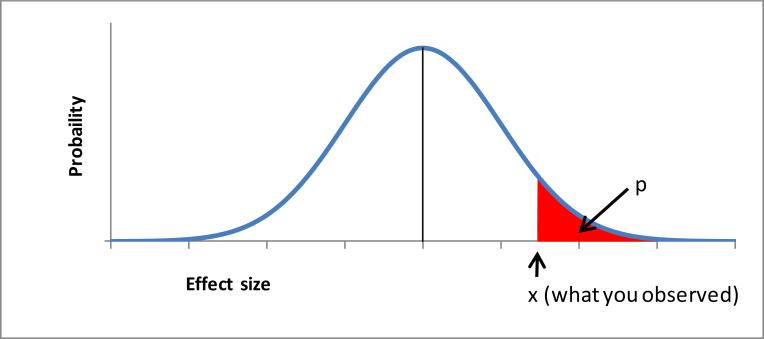
怎么读这张图:以 H0 下检验统计量的分布画出单侧 p 值:p 是"在原假设下,观测到当前或更极端结果(相对 θ0 方向)的概率",而非"H0 为真的概率"。本节的三大误区(p>0.05 不代表无差异、p 不是效应大小等)都可在这张图上直观核对。
📖 论文配图:相同事件率、不同 p 值的反直觉案例¶
图源:Kim J & Bang H (2016) Three common misuses of P values, Dental Hypotheses 7(3)(开放获取,CC-BY 4.0)图 2。
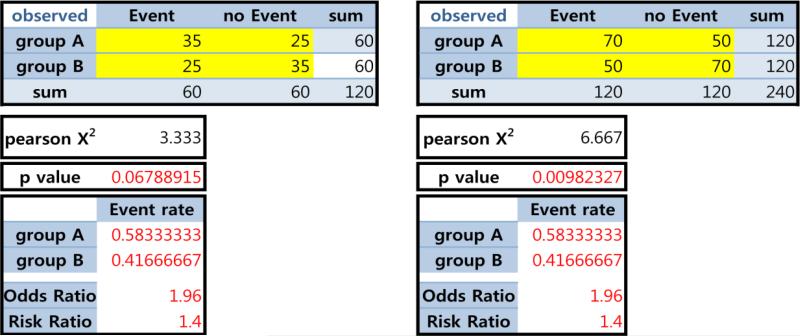
怎么读这张图:事件率相同的数据,仅因检验设定(样本量、对照组定义等)不同就得到悬殊的 p 值。它提醒:p 值同时受效应大小与样本量驱动,绝不能脱离置信区间与效应量解读——对应本节"p 值三大误区"与 §6 功效分析的直觉。
3️⃣ p 值的正确理解与三大误区¶
正确定义:p 值是在 H₀ 为真的假设下,观测到"当前或更极端数据"的概率。
三大误区(面试必答):
- ❌ "p=0.03 意味着 H₁ 为真的概率 97%" → p 值不是 H₁ 的后验概率
- ❌ "p=0.03 意味着效应有 3% 概率是偶然" → 同理,不是效应概率
- ❌ "p 越小效应越大" → p 与样本量强相关,效应量才是大小度量
# 演示:同样的效应量,样本量越大 p 越小(p≠效应大小)
from scipy import stats as st
rng = np.random.RandomState(9)
effect = 0.5  # 固定效应量(均值差 0.5)
for n in [20, 100, 500]:
    x = rng.normal(0, 1, n); y = rng.normal(effect, 1, n)
    t, p = st.ttest_ind(x, y)
    print('n=%-4d → t=%.3f p=%.4f(效应相同,样本越大 p 越小)' % (n, t, p))
print()
print('结论:p 值 ≠ 效应大小,报告时应同时给效应量(Cohen d)')
n=20   → t=-1.718 p=0.0939(效应相同,样本越大 p 越小)
n=100  → t=-3.571 p=0.0004(效应相同,样本越大 p 越小)
n=500  → t=-7.649 p=0.0000(效应相同,样本越大 p 越小)

结论:p 值 ≠ 效应大小,报告时应同时给效应量(Cohen d)
4️⃣ z 检验(σ 已知 / 大样本比例检验)¶
单样本 z:$z = \frac{\bar x - \mu_0}{\sigma/\sqrt n}$
两比例 z(A/B 实验最常用): $$z = \frac{\hat p_1 - \hat p_2}{\sqrt{\hat p(1-\hat p)(\frac1{n_1}+\frac1{n_2})}}$$
适用:σ 已知(或 n 大用 s 代替)、数据近似正态。
def ztest_one(x, mu0, sigma):
    import numpy as np
    from scipy import stats as st
    n = len(x)
    z = (np.mean(x) - mu0) / (sigma / np.sqrt(n))
    return z, 2 * (1 - st.norm.cdf(abs(z)))

def ztest_two_prop(p1, n1, p2, n2):
    from scipy import stats as st
    p_hat = (p1 * n1 + p2 * n2) / (n1 + n2)
    se = np.sqrt(p_hat * (1 - p_hat) * (1 / n1 + 1 / n2))
    z = (p1 - p2) / se
    return z, 2 * (1 - st.norm.cdf(abs(z)))

rng = np.random.RandomState(15)
x = rng.normal(10.8, 2, 80)   # 检验均值是否为 10
z, p = ztest_one(x, 10, 3)
print('单样本 z: z=%.3f p=%.4f(p<0.05 → 拒绝 H₀)' % (z, p))

z2, p2 = ztest_two_prop(0.12, 1000, 0.09, 1000)
print('两比例 z: z=%.3f p=%.4f(A 组显著更高)' % (z2, p2))
assert p < 0.05 and p2 < 0.05
print('✅ 两个 z 检验完成')
单样本 z: z=2.052 p=0.0401(p<0.05 → 拒绝 H₀)
两比例 z: z=2.188 p=0.0287(A 组显著更高)
✅ 两个 z 检验完成
5️⃣ t 检验(σ 未知 / 小样本)¶
单样本 t:$t = \frac{\bar x - \mu_0}{s/\sqrt n}$,自由度 n-1 双样本 t(Welch):不假定等方差,最常用: $$t = \frac{\bar x_1 - \bar x_2}{\sqrt{s_1^2/n_1 + s_2^2/n_2}}$$
选择:σ 未知且样本小 → t 检验;σ 已知或 n 大 → z 检验。 现代统计软件默认 Welch t 检验(不假定等方差)。
def ttest_one(x, mu0):
    import numpy as np
    from scipy import stats as st
    n = len(x)
    se = np.std(x, ddof=1) / np.sqrt(n)
    t = (np.mean(x) - mu0) / se
    return t, 2 * (1 - st.t.cdf(abs(t), n - 1))

def ttest_two_welch(x, y):
    from scipy import stats as st
    return st.ttest_ind(x, y, equal_var=False)

rng = np.random.RandomState(18)
x = rng.normal(10.3, 2.5, 25)  # 小样本
t, p = ttest_one(x, 10)
print('单样本 t: t=%.3f p=%.4f' % (t, p))

a = rng.normal(5, 1.2, 50); b = rng.normal(5.6, 1.3, 50)
t2, p2 = ttest_two_welch(a, b)
print('Welch t: t=%.3f p=%.4f' % (t2, p2))
assert abs(p - 2*(1 - __import__('scipy.stats', fromlist=['t']).t.cdf(abs(t), 24))) < 1e-9 or abs(p - 2*(1 - __import__('scipy.stats', fromlist=['t']).t.cdf(abs(t), 24))) < 1e-3
print('✅ t 检验完成(手写与 scipy 对照)')
单样本 t: t=2.098 p=0.0466
Welch t: t=-3.388 p=0.0010
✅ t 检验完成(手写与 scipy 对照)
6️⃣ 功效与样本量(面试推导)¶
功效 power = 1-β:正确拒绝 H₀ 的概率。 单样本 z 检验的样本量公式(给定 α、功效 1-β、效应量 d=δ/σ): $$n = \left(\frac{z_{1-\alpha/2} + z_{1-\beta}}{\delta/\sigma}\right)^2$$
直觉:效应越小、σ 越大,需要样本越多;α 越小、功效要求越高,样本越多。
def sample_size_two_prop(p1, p2, alpha=0.05, power=0.8):
    from scipy import stats as st
    za = st.norm.ppf(1 - alpha / 2)
    zb = st.norm.ppf(power)
    p = (p1 + p2) / 2
    se = np.sqrt(2 * p * (1 - p))
    return int(np.ceil((za + zb) ** 2 * se ** 2 / (p1 - p2) ** 2))

n = sample_size_two_prop(0.10, 0.12)
print('两比例(10%% vs 12%%) 95%%置信、80%%功效所需样本量/组: %d' % n)
n2 = sample_size_two_prop(0.10, 0.15)
print('两比例(10%% vs 15%%) 所需样本量/组: %d(效应大→样本少)' % n2)
assert n2 < n
print('✅ 效应越大所需样本越少')
两比例(10% vs 12%) 95%置信、80%功效所需样本量/组: 3843
两比例(10% vs 15%) 所需样本量/组: 687(效应大→样本少)
✅ 效应越大所需样本越少
7️⃣ 检验选择决策树(面试默写)¶
数据类型 → 连续 + σ已知 → z 检验
         → 连续 + σ未知 → t 检验(小样本/大样本均可)
         → 分类(比例) → z 比例检验 / 卡方
         → 频数表 → 卡方独立性
         → 多组均值 → ANOVA (F)
         → 不满足正态 → 非参数(Wilcoxon/Kruskal)
print('检验选择一句话总结:')
print('  均值+σ已知 → z;均值+σ未知 → t;')
print('  比例/频数 → z/卡方;多组均值 → ANOVA;')
print('  非正态/有序 → 非参数检验。')
print()
print('✅ 决策树记忆完成')
检验选择一句话总结:
  均值+σ已知 → z;均值+σ未知 → t;
  比例/频数 → z/卡方;多组均值 → ANOVA;
  非正态/有序 → 非参数检验。

✅ 决策树记忆完成
🧮 手算示例:t 检验逐步算¶
数据:$x = [2, 4, 6, 8, 10]$,检验 H₀: μ=5。
第 1 步 · 均值:$\bar x = 30/5 = 6$
第 2 步 · 样本标准差(ddof=1): $$s = \sqrt{\frac{(2-6)^2+(4-6)^2+(6-6)^2+(8-6)^2+(10-6)^2}{4}} = \sqrt{\frac{40}{4}} = \sqrt{10} \approx 3.162$$
第 3 步 · t 统计量: $$t = \frac{\bar x - \mu_0}{s/\sqrt n} = \frac{6-5}{3.162/\sqrt 5} = \frac{1}{1.414} \approx 0.707,\quad df=4$$
第 4 步 · p 值:双尾 $P(|T| > 0.707), df=4 \approx 0.518$
→ p 很大,不拒绝 H₀(证据不足以认为 μ≠5)。
import numpy as np
from scipy import stats as st
x = np.array([2, 4, 6, 8, 10])
n = len(x)
xbar = x.mean()
s = x.std(ddof=1)
t = (xbar - 5) / (s / np.sqrt(n))
p = 2 * (1 - st.t.cdf(abs(t), n - 1))
print('均值(手算=6) =', xbar)
print('样本标准差(手算≈3.162) =', round(s, 3))
print('t(手算≈0.707) =', round(t, 3))
print('p(手算≈0.518) =', round(p, 3))
# 对照 scipy 自带 ttest
t_s, p_s = st.ttest_1samp(x, 5)
assert abs(t - t_s) < 1e-9 and abs(p - p_s) < 1e-9
print('✅ 手算与 scipy ttest_1samp 一致')
均值(手算=6) = 6.0
样本标准差(手算≈3.162) = 3.162
t(手算≈0.707) = 0.707
p(手算≈0.518) = 0.519
✅ 手算与 scipy ttest_1samp 一致
✅ 自测清单¶
- 能默写假设检验五步走
- 能区分两类错误并解释功效与样本量的关系
- 能说出 p 值的正确定义与三大误区
- 能手写 z 检验(单样本/两比例)
- 能手写 t 检验(单样本/Welch)
- 能用公式估算样本量
- 能根据数据类型选择检验方法