00-数学基础 · 信息论¶
信息论研究一个看起来有点哲学的问题:一条消息到底「值多少钱」? 1948 年香农(Claude Shannon)给出了答案:信息量可以用比特(bit)来度量,越「没想到」的消息信息量越大。今天深度学习的分类损失(交叉熵)、softmax、语言模型的困惑度、RLHF 的 KL 约束,全都在这一棵树上。这一篇用最直白的方式把整棵树讲清楚。
学完你能回答:熵为什么等于平均信息量?交叉熵为什么能当损失函数?KL 散度为什么 ≥ 0?困惑度和熵是什么关系?
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 一条消息的信息量到底怎么度量? | 自信息与信息熵(直觉 + 公式) |
| 两个随机变量「一起看」,信息会不会重复算? | 联合熵 / 条件熵 |
| 拿一个错误的分布去描述世界,代价是什么? | 交叉熵 |
| 两个分布差多少?凭什么 KL 散度 ≥ 0? | KL 散度(含 Jensen 不等式证明) |
| 一个变量对另一个变量的「信息贡献」怎么量化? | 互信息 |
| 语言模型「说不准话」的程度怎么度量? | 困惑度 |
| 这些概念在 ML / DL 里到底长什么样? | 交叉熵损失、softmax、KL 约束、决策树信息增益 |
故事引入¶
春节联欢晚会有 32 位歌手角逐「年度金曲」,冠军只有一个。你在群里问:「冠军到底是谁?」朋友答「不知道」——这句话信息量几乎为零,因为听了跟没听一样。但朋友改口:「冠军在左半区还是右半区?」——每问一次就把候选范围对半砍,最多 5 次就能锁定冠军:$2^5=32$。所以「32 选 1」的信息量恰好是 5 bit。这就是香农的洞见:信息量 = 出人意料的程度 = 被消除的不确定性,用 $\log_2$ 来度量最自然——因为你每多问一个「是 / 否」的问题,就多获得 1 bit,而 $\log_2 32 = 5$。再想想:「明天太阳照常升起」几乎必然发生,信息量 ≈ 0;「我中彩票了」概率极小,信息量巨大。如果一位朋友天天发「哈哈哈」,这条消息的熵极低(净是废话);另一位朋友每条都是干货,每条都能帮你少踩一个坑——信息论衡量的不是「内容好不好」,而是「帮你排除了多少不确定」。机器学习的交叉熵损失、决策树的信息增益、语言模型的困惑度,全都建立在这个「猜谜游戏」之上:模型每输出一个词,就是在压缩你的不确定性;输出越「意外却正确」的答案,信息量越大、模型越好。
核心概念¶
(a) 🗂️ 信息论主干:从「一条消息的信息量」到「两个分布的差距」¶
信息论的出发点只有一句话:信息量 = 出人意料的程度。由它定义自信息,把自信息按概率加权平均就是熵;把「拿估计分布去描述真实分布」的额外代价定义成交叉熵与 KL 散度;「一个变量给出的关于另一个变量的信息」就是互信息;把熵取指数放进语言模型,就得到困惑度。先看地图,再逐个击破。
flowchart TB
    A["🧠 自信息<br/>越意外信息量越大"] --> B["🧠 信息熵<br/>平均自信息"]
    B --> C["🧠 联合熵 & 条件熵<br/>一起看 / 知道之后"]
    B --> D["🧠 交叉熵<br/>用估计分布编码"]
    B --> E["🧠 KL 散度<br/>分布差距,≥ 0"]
    C --> F["🧠 互信息<br/>共享的信息量"]
    D --> E
    F --> G["🧠 困惑度<br/>语言模型的不确定度"]
    D --> H["🧠 ML/DL 应用<br/>交叉熵损失 / softmax / KL 约束"]
    E --> H
    H --> I["🧠 决策树信息增益<br/>切分带来的熵减"]
- 自信息:一条消息的信息量 = $-\log_2 P(消息)$。事件越不可能,信息量越大——「明天太阳升起」信息量 ≈ 0,「明天我中彩票」信息量巨大。
- 信息熵:随机变量所有取值的自信息按概率加权平均,是「平均信息量」,也是「平均不确定度」。公平硬币的熵恰好是 1 bit。
- 联合熵 / 条件熵:联合熵是「两个变量一起看」的总不确定度;条件熵 $H(Y|X)$ 是「知道 X 之后,Y 还剩多少不确定」。条件熵 ≤ 无条件熵——信息只会减少不确定,不会增加。
- 交叉熵:用估计分布 Q 去「编码」真实分布 P 的事件时所需的平均比特数。分类任务的交叉熵损失就是它,训练时最小化它就是在让 Q 逼近 P。
- KL 散度:交叉熵 − 熵 = 用 Q 近似 P 时多花的比特数,度量两个分布的差距:永远 ≥ 0(Jensen 不等式),P = Q 时取 0,且不对称。
- 互信息:$I(X;Y)=H(X)-H(X|Y)$,即「知道 Y 能让 X 的不确定减少多少」,等于两个变量共享的信息量,恰好为 0 当且仅当 X、Y 独立。
- 困惑度:把熵取 2 的指数:$PPL=2^{H}$。它是语言模型好坏的经典指标,越低说明模型越「有把握」,均匀瞎猜时 PPL = 词表大小。
- ML/DL 应用:交叉熵损失 + softmax 是分类标配;RLHF / DPO 用 KL 约束模型别跑偏太远;决策树 / 随机森林每次切分都按「信息增益(熵减)」选特征。
- 决策树信息增益:$Gain = H(D)-H(D|特征)$,切分后纯度提升越多越好——ID3 决策树的核心准则。
深入原理¶
这一节把信息论的每个核心量都拆开:直觉 → 公式 → 推导 → 面试怎么问。核心心法只有一句:信息量 = 出人意料的程度 = 被消除的不确定性,其余全是它的展开。
(1) 自信息与信息熵:为什么偏偏是 log?¶
大白话直觉:猜谜游戏里每问一个「是 / 否」问题得到 1 bit 信息。一个事件发生的概率是 $p$,等价于「要从 $1/p$ 种可能里把它挑出来」,需要 $\log_2(1/p)$ 个是非问题,所以信息量 = $-\log_2 p$。把每个可能取值的自信息按概率加权平均,得到的就是平均信息量——熵。
公式: $$I(x)=-\log_b P(x),\qquad H(X)=-\sum_{x}P(x)\log_b P(x)$$ (底数 b = 2 时单位是 bit,b = e 时单位是 nat,b = 10 时是 dit;机器学习里习惯用自然底数 e。)
关键推导步骤(为什么 log 是唯一合理的选择):
- 两条独立消息 $x,y$ 同时出现时信息量应相加:$I(x,y)=I(x)+I(y)$;
- 而独立事件的联合概率相乘:$P(x,y)=P(x)P(y)$;
- 「把乘法变加法」的运算恰好是取对数:$I=-\log P$。若用别的函数,独立消息的信息量就无法相加——所以 log 不是约定,是被迫的。
面试怎么问:「熵的单位 bit / nat 怎么换算?为什么不用底数 10?」
(2) 联合熵与条件熵:知道一点,不确定少一点¶
大白话直觉:联合熵 $H(X,Y)$ 是「两个变量一起看」时总共还剩多少不确定;条件熵 $H(Y|X)$ 是「我已经知道 X」之后,Y 还让我多抓狂多少。常识告诉我们:多知道一点,不确定只会变少不会变多,所以 $H(Y|X)\le H(Y)$——这是信息论里第一个「不等式直觉」。
公式: $$H(X,Y)=-\sum_{x,y}P(x,y)\log P(x,y)$$ $$H(Y|X)=\sum_{x}P(x)\,H(Y|X{=}x)=-\sum_{x,y}P(x,y)\log P(y|x)$$ 两者与无条件熵的链式关系(信息论的「乘法法则」): $$H(X,Y)=H(X)+H(Y|X)=H(Y)+H(X|Y)$$
关键推导步骤:
- 由 $P(x,y)=P(x)P(y|x)$ 取负对数:$-\log P(x,y)=-\log P(x)-\log P(y|x)$;
- 两边同时关于 $P(x,y)$ 求期望,左边是 $H(X,Y)$,右边第一项是 $H(X)$,第二项正是 $H(Y|X)$;
- 由此得到链式法则,并推出 $H(Y|X)=H(X,Y)-H(X)\le H(X,Y)$,进一步结合 $H(X,Y)\le H(X)+H(Y)$(联合熵小于等于两个熵之和,等号当且仅当独立)得到 $H(Y|X)\le H(Y)$。
面试怎么问:「$H(X,Y)$ 与 $H(X)+H(Y)$ 什么关系?什么时候取等号?」
(3) 交叉熵:用「估计的分布」去编码「真实的世界」¶
大白话直觉:真实分布 P 是「世界真相」,但你只能用估计分布 Q 来编码事件。用 Q 编码真实事件的平均代价就是交叉熵 $CE(P,Q)$。世界越不可预测($H(P)$ 大)、你的估计越离谱($KL(P||Q)$ 大),代价就越高。分类时真实标签的分布 P 固定不动,最小化交叉熵 = 最小化 KL = 让模型分布 Q 逼近真实分布 P。
公式: $$CE(P,Q)=-\sum_{x}P(x)\log Q(x)=H(P)+KL(P\,\|\,Q)$$ 分类问题(softmax 输出 $q_y$,one-hot 标签 $p_y\in\{0,1\}$)退化为 负对数似然: $$\mathcal{L}_{CE}=-\log q_{y_{true}}$$
关键推导步骤:
- 代入 $\log Q$:$-\sum_x P(x)\log Q(x)=-\sum_x P(x)\log P(x)-\sum_x P(x)\log\frac{Q(x)}{P(x)}$;
- 第一项是熵 $H(P)$(与 Q 无关的常数),第二项正是 $KL(P\|Q)$——所以 $CE=H+KL$;
- 训练时 P 固定,$H(P)$ 是常数,最小化 CE 等价于最小化 KL。这解释了为什么分类任务里交叉熵损失「天然合理」。
面试怎么问:「为什么交叉熵能当损失函数?它和负对数似然是什么关系?」
✍️ §3.1 手算信息量三件套:熵、交叉熵、KL 散度¶
$H(p)=-\sum p\log p$、$H(p,q)=-\sum p\log q$、$\text{KL}(p\|q)=\sum p\log\frac{p}{q}$——一个真实分布、一个估计分布算到底,看三者的关系。
设定:真实分布 $p=(0.5,\ 0.25,\ 0.25)$,估计分布 $q=(0.4,\ 0.4,\ 0.2)$(底数取 2)。
第 1 步:熵($\log_2 0.5=-1$,$\log_2 0.25=-2$)
$$H(p)=-\big[0.5\log_2 0.5+0.25\log_2 0.25+0.25\log_2 0.25\big]=-(-0.5-0.5-0.5)=1.5\ \text{bits}$$
第 2 步:交叉熵(用 $q$ 编码 $p$;$\log_2 0.4=-1.322$,$\log_2 0.2=-2.322$)
$$H(p,q)=-\big[0.5\log_2 0.4+0.25\log_2 0.4+0.25\log_2 0.2\big]=0.661+0.330+0.580=1.572$$
第 3 步:KL 散度(交叉熵 − 熵 = "用错分布多花的比特")
$$\text{KL}(p\|q)=H(p,q)-H(p)=1.572-1.5=0.072$$
手算收获:
- 熵 1.5 bits = 描述 $p$ 所需的最少比特数;交叉熵 1.572 = 用 $q$ 编码 $p$ 的实际开销——KL 0.072 就是"编码错配"的浪费
- $\text{KL}\ge0$:估计越准 KL 越小,$q=p$ 时 KL=0、交叉熵=熵——这就是 ML 里交叉熵损失 = "最小化 KL(从数据分布到模型分布)"
- 底数决定单位:log2 → bits,ln → nats(神经网络里常用 ln,数值差 $\log_2 e\approx1.44$ 倍)
- 语言模型困惑度 $\text{PPL}=2^{H}$:$H=1.5$ bits → PPL≈2.83;熵越小困惑度越低、"越说得准"
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算熵/交叉熵/KL ----
import numpy as np

p = np.array([0.5, 0.25, 0.25])
q = np.array([0.4, 0.4, 0.2])
H = -(p * np.log2(p)).sum()
CE = -(p * np.log2(q)).sum()
KL = (p * np.log2(p / q)).sum()
print(f'H(p) = {H:.4f} bits(手算 1.5)')
print(f'H(p,q) = {CE:.4f}(手算 1.572)')
print(f'KL(p||q) = {KL:.4f}(手算 0.072);H(p,q)-H(p) = {CE-H:.4f}')
assert abs(H - 1.5) < 1e-9 and abs(CE - 1.5719) < 1e-3 and abs(KL - 0.0719) < 1e-3
print(f'PPL = 2^H = {2**H:.2f}')
print('\n✓ 与手算一致')
(4) KL 散度:两个分布差多远?凭什么 ≥ 0?¶
大白话直觉:KL 散度(相对熵)回答「我原本用 P 描述世界,现在被迫改成 Q,平均每条消息多花多少 bit」。它衡量「Q 偏离 P 的程度」:完全一致时多花 0 bit,越偏越多。注意它是「从 P 的视角看 Q」——换个视角结果不同,所以不对称,它不是严格意义上的距离。
公式: $$KL(P\,\|\,Q)=\sum_{x}P(x)\log\frac{P(x)}{Q(x)}=\mathbb{E}_{P}\Big[\log\frac{P}{Q}\Big]\ge 0,\qquad \text{等号当且仅当}\ P=Q$$
关键推导步骤(利用 $-\ln$ 的凸性与 Jensen 不等式):
- 写成 $KL=\mathbb{E}_{P}[-\ln(Q/P)]$(换到自然对数,差一个常数因子 $\log_2 e$);
- $g(t)=-\ln t$ 是凸函数,Jensen 不等式说 $\mathbb{E}[g(t)]\ge g(\mathbb{E}[t])$;
- 代入 $t=Q/P$:$KL=\mathbb{E}[-\ln(Q/P)]\ge -\ln\mathbb{E}[Q/P]=-\ln 1=0$;
- 等号条件:凸函数取等需要 $t$ 恒为常数,即 $Q/P\equiv 1$ ⟹ $P=Q$。
面试怎么问:「KL 散度为什么 ≥ 0?KL 对称吗?什么时候取 0?在实际中它的不对称会带来什么问题?」
(5) 互信息:两个变量共享多少「信息」?¶
大白话直觉:互信息回答「知道 Y 之后,我对 X 的不确定减少了多少」。天气预报只能告诉你「下雨概率」,但真正的降雨事件 X 和天气预报 Y 之间共享的那部分信息就是互信息。如果 Y 与 X 独立,预报等于没说,互信息 = 0;如果 Y 完全决定 X,互信息 = H(X)——X 的不确定被 Y 全部消除。
公式: $$I(X;Y)=H(X)-H(X|Y)=H(X)+H(Y)-H(X,Y)=\sum_{x,y}P(x,y)\log\frac{P(x,y)}{P(x)P(y)}$$
关键推导步骤:
- 从 $H(X,Y)=H(X)+H(Y|X)$ 出发,轮换变量得 $I=H(X)-H(X|Y)$(对称式);
- 把 $H(X|Y)$ 展开为联合期望 $-\sum P(x,y)\log P(x|y)$,合并对数得 $I=\sum P(x,y)\log\frac{P(x,y)}{P(x)P(y)}$;
- 与 KL 公式对比:$I(X;Y)=KL\big(P(x,y)\,\|\,P(x)P(y)\big)$——互信息就是「联合分布偏离独立情形」的 KL 散度,所以由 KL ≥ 0 立刻得到 $I\ge 0$,且 $I=0$ 当且仅当 $P(x,y)=P(x)P(y)$,即独立。
面试怎么问:「互信息和相关系数有什么区别?什么时候互信息为 0?为什么它不是有上界的指标(信息还能归一化吗)?」
(6) 困惑度:语言模型「说不准话」的程度¶
大白话直觉:困惑度(Perplexity,PPL)把熵从「bit 数」翻译回「平均有多少个选项让模型纠结」。PPL = 10 大致等于「模型每预测一个词,平均要在 10 个候选里纠结」;均匀瞎猜 10000 个词的词表,PPL = 10000;一个好的语言模型 PPL 可以压到 10 以内。PPL 越低,模型越有把握、越好——这也解释了为什么语言模型训练目标就是最小化交叉熵:交叉熵最小,熵才有机会接近真实分布的下限。
公式: $$PPL = 2^{H(P)} = 2^{-\frac{1}{n}\sum_{i}\log_2 P(w_i|\text{上文})} = \exp\Big(-\frac{1}{n}\sum_i \ln P(w_i|\text{上文})\Big)$$ (最后一步是常见的自然指数形式,对应机器学习里的平均负对数似然。)
关键推导步骤:
- $n$ 个词的序列,独立假设下联合概率 $P(w_1,\dots,w_n)=\prod_i P(w_i)$;
- 对联合概率取 $1/n$ 次幂再取倒数,得「每个位置平均需要的选项数」:$PPL = P(w_1,\dots,w_n)^{-1/n}$ 的指数形式;
- 取对数展开:$-\frac{1}{n}\sum_i \ln P(w_i)$ 正是平均负对数似然(损失),所以 PPL = $e^{\text{loss}}$——训练 loss 每降 1.0,PPL 大约除以 e。语言模型评估里两者通用。
面试怎么问:「PPL 和交叉熵损失是什么关系?PPL 越低一定越好吗(有哪些坑,比如词表大小、数据集难度的影响)?」
代码实战:从零实现信息论的六个核心量¶
代码只依赖 numpy + matplotlib,固定随机种子、可复现。四个代码块分别: ① 手写自信息 / 熵 / 联合熵 / 条件熵 / 互信息(用「天气 → 带伞」的联合分布验证四条不等式)→ ② 熵函数曲线图 + 手写交叉熵 / KL 散度(验证 $CE=H+KL$、$KL\ge 0$、不对称,并画两张图)→ ③ softmax + 交叉熵损失的解析梯度核对 + 困惑度 → ④ 决策树信息增益(经典《打网球》数据集)。 每段末尾都有「核对结果」,数值与理论对上才算真正掌握。
代码块 1/4:手写自信息、熵、联合熵、条件熵与互信息
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ═══════════════════════════════════════════════════════════════
# 代码块 1/4:从零实现 自信息 / 熵 / 联合熵 / 条件熵 / 互信息
# 并用「天气 → 带伞」的联合分布验证四条信息论不等式
# ═══════════════════════════════════════════════════════════════
import sys, io
if getattr(sys.stdout, 'buffer', None) is not None:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')

import numpy as np

def self_info(p, base=2):
    """自信息:I = -log_b p(p→0 时不出现,返回 0)"""
    p = np.clip(p, 1e-300, 1.0)
    return -np.log(p) / np.log(base)

def entropy(p, base=2):
    """信息熵:H = -Σ p log_b p(只累加概率 > 0 的项)"""
    p = np.asarray(p, dtype=float)
    p = p[p > 0]
    return float(-(p * np.log(p)).sum() / np.log(base))

def joint_entropy(P, base=2):
    """联合熵 H(X,Y):把联合分布矩阵拉平后直接套熵公式"""
    return entropy(np.asarray(P, dtype=float).ravel(), base)

def cond_entropy(P, base=2):
    """条件熵 H(Y|X) = Σ_x p(x) H(Y|X=x),P[i][j] = P(X=i, Y=j)"""
    P = np.asarray(P, dtype=float)
    px = P.sum(axis=1)                 # 边缘分布 P(X=i)
    h = 0.0
    for i in range(P.shape[0]):
        if px[i] > 0:
            h += px[i] * entropy(P[i] / px[i], base)   # 在 X=i 的行内算 Y 的熵
    return float(h)

def mutual_info(P, base=2):
    """互信息 I(X;Y) = H(X) + H(Y) - H(X,Y)"""
    P = np.asarray(P, dtype=float)
    hx = entropy(P.sum(axis=1), base)
    hy = entropy(P.sum(axis=0), base)
    return float(hx + hy - joint_entropy(P, base))

# —— 验证 1:自信息「越不可能,信息量越大」
print('自信息:P=0.9 →', round(self_info(0.9), 4), 'bit;P=0.1 →', round(self_info(0.1), 4), 'bit')
assert self_info(0.1) > self_info(0.9)
print('✅ 核对通过:越罕见的事件信息量越大\n')

# —— 验证 2:公平硬币熵 = 1 bit
h_coin = entropy([0.5, 0.5])
print('公平硬币的信息熵 =', round(h_coin, 6), 'bit')
assert abs(h_coin - 1.0) < 1e-9
print('✅ 核对通过:公平硬币 H = 1 bit\n')

# —— 验证 3:构造「天气 → 带伞」两种联合分布:相关 与 独立
P_corr = np.array([[0.45, 0.05],   # X=晴:Y=不带伞 / 带伞
                   [0.05, 0.45]])  # X=雨:Y=不带伞 / 带伞(雨天大概率带伞)
px = np.array([0.5, 0.5]); py = np.array([0.5, 0.5])
P_ind = np.outer(px, py)           # 独立:P(X,Y)=P(X)P(Y)

for name, P in [('相关(雨天→带伞)', P_corr), ('独立', P_ind)]:
    Hxy = joint_entropy(P)
    Hx = entropy(P.sum(axis=1)); Hy = entropy(P.sum(axis=0))
    Hyx = cond_entropy(P)
    Ixy = mutual_info(P)
    print(f'[{name}] H(X)={Hx:.4f}  H(Y)={Hy:.4f}  H(X,Y)={Hxy:.4f}  H(Y|X)={Hyx:.4f}  I(X;Y)={Ixy:.4f}')
    assert Hyx <= Hy + 1e-9, '条件熵应不超过无条件熵'
    assert Ixy >= -1e-9, '互信息应 ≥ 0'
    if name == '独立':
        assert abs(Ixy) < 1e-9, '独立时互信息应为 0'
        assert abs(Hxy - (entropy(px) + entropy(py))) < 1e-9, '独立时联合熵 = 两个熵之和'
    else:
        assert Ixy > 0.2, '相关时互信息应明显大于 0'

print('✅ 核对通过:H(Y|X) ≤ H(Y);独立 ⇔ 互信息 = 0;H(X,Y) = H(X)+H(Y)-I(X;Y)')
print('全部核对通过 ✅✅')
自信息:P=0.9 → 0.152 bit;P=0.1 → 3.3219 bit
✅ 核对通过:越罕见的事件信息量越大

公平硬币的信息熵 = 1.0 bit
✅ 核对通过:公平硬币 H = 1 bit

[相关(雨天→带伞)] H(X)=1.0000  H(Y)=1.0000  H(X,Y)=1.4690  H(Y|X)=0.4690  I(X;Y)=0.5310
[独立] H(X)=1.0000  H(Y)=1.0000  H(X,Y)=2.0000  H(Y|X)=1.0000  I(X;Y)=0.0000
✅ 核对通过:H(Y|X) ≤ H(Y);独立 ⇔ 互信息 = 0;H(X,Y) = H(X)+H(Y)-I(X;Y)
全部核对通过 ✅✅
# ═══════════════════════════════════════════════════════════════
# 代码块 2/4:熵函数曲线图 + 手写交叉熵与 KL 散度
# 验证:CE = H + KL;KL ≥ 0 且 P=Q 时取 0;KL 不对称(两张图)
# ═══════════════════════════════════════════════════════════════
import numpy as np
import matplotlib
matplotlib.use('Agg')            # 无界面后端,保证可离线运行
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

def entropy(p, base=2):
    p = np.asarray(p, dtype=float); p = p[p > 0]
    return float(-(p * np.log(p)).sum() / np.log(base))

def cross_entropy(p, q, base=2):
    """交叉熵 CE(P,Q) = -Σ p·log q。
    约定 0·log0 = 0(真实分布 P 中不出现的符号不贡献损失)。"""
    p = np.asarray(p, dtype=float)
    q = np.asarray(q, dtype=float)
    q = np.clip(q, 1e-300, None)          # 防 log(0)
    return float(-(p * np.log(q)).sum() / np.log(base))

def kl_div(p, q, base=2):
    """KL 散度 KL(P||Q) = Σ p·log(p/q),只累加 p>0 的项"""
    p = np.asarray(p, dtype=float); q = np.asarray(q, dtype=float)
    p = p[p > 0]
    q = q[p > 0]
    return float((p * (np.log(p) - np.log(q))).sum() / np.log(base))

# —— 验证 1:CE(P,Q) = H(P) + KL(P||Q)
P = np.array([0.3, 0.7]); Q = np.array([0.5, 0.5])
ce, h, kld = cross_entropy(P, Q), entropy(P), kl_div(P, Q)
print(f'CE(P,Q) = {ce:.4f},H(P) = {h:.4f},KL(P||Q) = {kld:.4f},H(P)+KL = {h + kld:.4f}')
assert abs(ce - (h + kld)) < 1e-9
print('✅ 核对通过:交叉熵 = 熵 + KL 散度(真实 P 固定时最小化 CE = 最小化 KL)\n')

# —— 验证 2:KL ≥ 0,且 P = Q 时取 0(Jensen 不等式)
Qs = [np.array([a, 1 - a]) for a in np.linspace(0.02, 0.98, 49)]
kl_vals = [kl_div(P, q) for q in Qs]
print(f'扫描 49 个 Q:KL 最小值 = {min(kl_vals):.6f}(应 ≥ 0);P=Q 时 KL = {kl_div(P, P):.2e}')
assert min(kl_vals) >= -1e-9 and abs(kl_div(P, P)) < 1e-9
print('✅ 核对通过:KL ≥ 0,等号当且仅当 P = Q\n')

# —— 验证 3:KL 不对称(不是距离度量)
Q2 = np.array([0.9, 0.1])
print(f'KL(P||Q2) = {kl_div(P, Q2):.4f},KL(Q2||P) = {kl_div(Q2, P):.4f} —— 两者不相等')
assert abs(kl_div(P, Q2) - kl_div(Q2, P)) > 1e-3
print('✅ 核对通过:KL 散度不对称(KL(P||Q) ≠ KL(Q||P))\n')

# —— 图 1:二值分布的熵函数 H(p),p = 0.5 时最大
ps = np.linspace(1e-6, 1 - 1e-6, 400)
Hp = -ps * np.log2(ps) - (1 - ps) * np.log2(1 - ps)
fig, ax = plt.subplots(figsize=(7.5, 4.2))
ax.plot(ps, Hp, color='#2a6fb0', lw=2)
ax.axvline(0.5, color='crimson', ls='--', lw=1)
ax.set_xlabel('p(正面概率)')
ax.set_ylabel('熵 H(p)(bit)')
ax.set_title('二值分布的熵:p = 0.5 时不确定度最大')
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig('images/math03_entropy.png', dpi=130)
plt.close(fig)

# —— 图 2:固定真实 P = 伯努利(0.3),CE 与 KL 随 Q 的参数 q 变化
p_true = 0.3
qs = np.linspace(0.01, 0.99, 400)
CEs = [cross_entropy([p_true, 1 - p_true], [q, 1 - q]) for q in qs]
KLs = [kl_div([p_true, 1 - p_true], [q, 1 - q]) for q in qs]
fig, ax = plt.subplots(figsize=(7.5, 4.2))
ax.plot(qs, CEs, color='#7fb069', lw=2, label='交叉熵 CE(P,Q)')
ax.plot(qs, KLs, color='#c44e52', lw=2, label='KL 散度 KL(P||Q)')
ax.axhline(entropy([p_true, 1 - p_true]), color='gray', ls=':', lw=1.2, label='H(P)(常数下界)')
ax.axvline(p_true, color='crimson', ls='--', lw=1)
ax.set_xlabel('估计分布 Q 的参数 q')
ax.set_ylabel('bit')
ax.set_title('固定 P=伯努利(0.3):CE 与 KL 都在 Q=P 处取最小值')
ax.legend()
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig('images/math03_kl_ce.png', dpi=130)
plt.close(fig)
plt.show()
print('已保存图片 images/math03_entropy.png 与 images/math03_kl_ce.png')
print('全部核对通过 ✅✅')
CE(P,Q) = 1.0000,H(P) = 0.8813,KL(P||Q) = 0.1187,H(P)+KL = 1.0000
✅ 核对通过:交叉熵 = 熵 + KL 散度(真实 P 固定时最小化 CE = 最小化 KL)

扫描 49 个 Q:KL 最小值 = -0.000000(应 ≥ 0);P=Q 时 KL = 0.00e+00
✅ 核对通过:KL ≥ 0,等号当且仅当 P = Q

KL(P||Q2) = 1.4897,KL(Q2||P) = 1.1457 —— 两者不相等
✅ 核对通过:KL 散度不对称(KL(P||Q) ≠ KL(Q||P))
已保存图片 images/math03_entropy.png 与 images/math03_kl_ce.png
全部核对通过 ✅✅
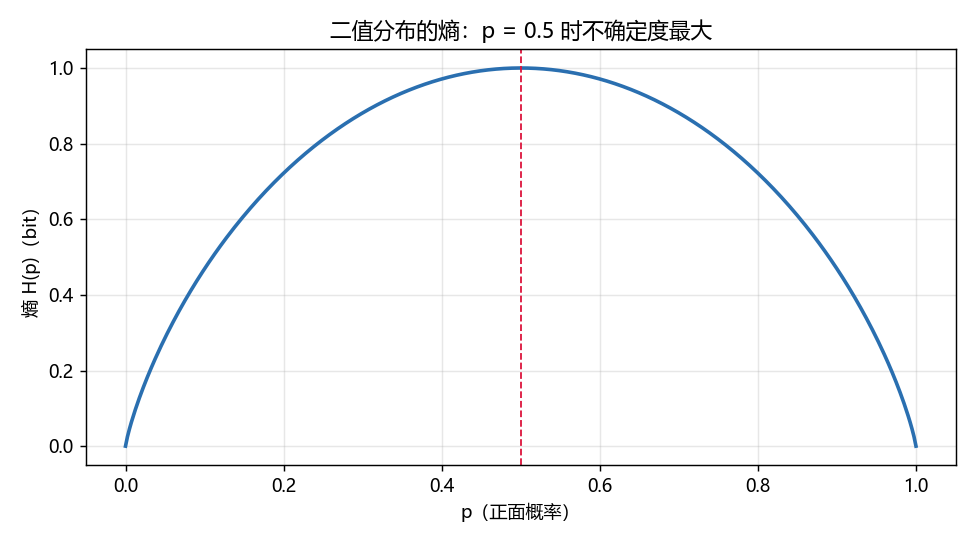
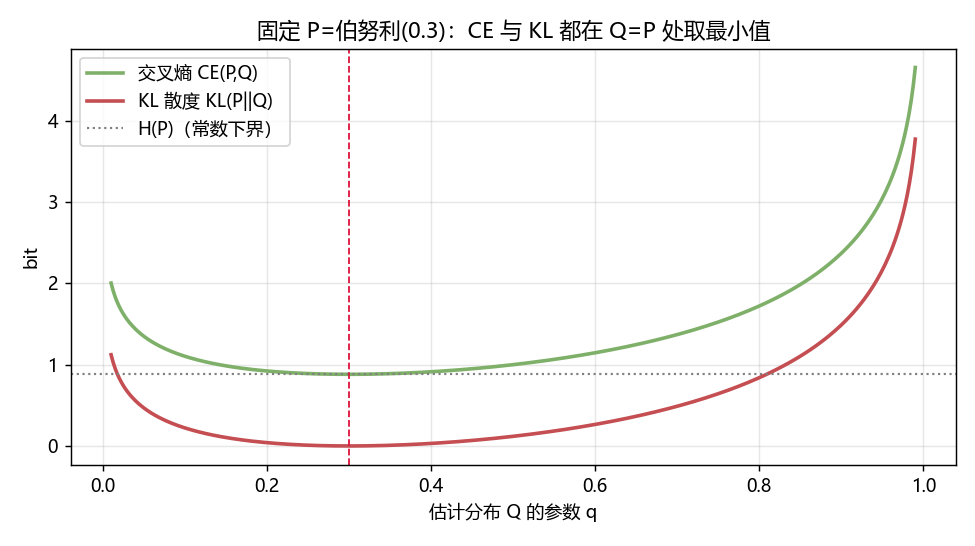
读图要点:
- 图 1:抛硬币「越不确定(p 越接近 0.5),熵越大」——均匀分布的熵最大,这就是「最大熵原理」的雏形;
- 图 2:两条曲线都在 q = 0.3 = p 处取最小值——Q 完全等于 P 时 KL = 0、交叉熵 = 熵;且交叉熵曲线 = KL 曲线 + 常数 H(P),所以「真实分布固定时,最小化交叉熵和最小化 KL 完全等价」——这就是分类训练的理论依据。
# ═══════════════════════════════════════════════════════════════
# 代码块 3/4:softmax + 交叉熵损失(解析梯度 vs 数值梯度核对)+ 困惑度
# ═══════════════════════════════════════════════════════════════
import numpy as np

def softmax(z):
    """数值稳定的 softmax:先减去最大值,防止 exp 溢出"""
    z = z - z.max()
    e = np.exp(z)
    return e / e.sum()

def ce_loss(logits, y):
    """单样本分类交叉熵损失:-log softmax(logits)[y]"""
    p = softmax(logits)
    return float(-np.log(max(p[y], 1e-300)))

def d_ce_d_logits(logits, y):
    """解析梯度:∂L/∂z = softmax(z) - onehot(y)(反向传播标准结论)"""
    p = softmax(logits).copy()
    p[y] -= 1.0
    return p

def numerical_grad(logits, y, eps=1e-6):
    """数值梯度:中心差分,用于核对解析式"""
    g = np.zeros_like(logits, dtype=float)
    for i in range(len(logits)):
        zp = logits.copy(); zp[i] += eps
        zm = logits.copy(); zm[i] -= eps
        g[i] = (ce_loss(zp, y) - ce_loss(zm, y)) / (2 * eps)
    return g

# —— 验证 1:softmax 输出是合法概率分布
rng = np.random.default_rng(42)
logits = rng.normal(size=(5,))
p = softmax(logits)
print('softmax 概率(总和):', round(p.sum(), 12), ',最大概率类 =', int(np.argmax(p)))
assert abs(p.sum() - 1.0) < 1e-12
print('✅ 核对通过:softmax 输出归一化且非负\n')

# —— 验证 2:解析梯度 ≈ 数值梯度(梯度就地核对)
y = 2
loss = ce_loss(logits, y)
ga = d_ce_d_logits(logits, y)
gn = numerical_grad(logits, y)
max_diff = float(np.abs(ga - gn).max())
print(f'交叉熵损失 = {loss:.4f};解析梯度与数值梯度最大差距 = {max_diff:.2e}')
assert max_diff < 1e-5
assert abs(ga.sum()) < 1e-12
print('✅ 核对通过:∂L/∂z = softmax(z) - onehot(y),且梯度向量之和为 0(概率守恒)\n')

# —— 验证 3:正确类的 logit 越大,损失越小(训练目标的方向)
losses = [ce_loss(np.array([t, -1.0, 1.0]), y=0) for t in np.linspace(-5, 5, 50)]
assert all(b <= a for a, b in zip(losses, losses[1:]))   # 后一个 ≤ 前一个:损失随 logit 单调下降
print('✅ 核对通过:正确类 logit 越大 → 交叉熵损失单调下降(“让模型更有把握”)\n')

# —— 验证 4:困惑度 PPL = exp(平均负对数似然)
def perplexity(token_probs):
    """token_probs:模型给每个 token 位置的预测概率(一阶语言模型视角)"""
    return float(np.exp(-np.mean(np.log(np.clip(token_probs, 1e-300, 1.0)))))

uniform = np.full(10, 0.1)              # 均匀瞎猜:10 个词等概率,PPL = 10
ppl_uniform = perplexity(uniform)
confident = np.full(10, 0.6)           # 有把握的模型:每个位置都以 0.6 命中目标词
ppl_confident = perplexity(confident)
print(f'均匀分布困惑度 = {ppl_uniform:.4f}(理论 = 词表大小 10);有把握模型困惑度 = {ppl_confident:.4f}(理论 = 1/0.6 = {1/0.6:.4f})')
assert abs(ppl_uniform - 10.0) < 1e-9 and ppl_confident < ppl_uniform
print('✅ 核对通过:困惑度越低 ≈ 模型越有把握;均匀分布 PPL = 词表大小')
print('全部核对通过 ✅✅')
softmax 概率(总和): 1.0 ,最大概率类 = 3
✅ 核对通过:softmax 输出归一化且非负

交叉熵损失 = 1.1261;解析梯度与数值梯度最大差距 = 9.86e-11
✅ 核对通过:∂L/∂z = softmax(z) - onehot(y),且梯度向量之和为 0(概率守恒)

✅ 核对通过:正确类 logit 越大 → 交叉熵损失单调下降(“让模型更有把握”)

均匀分布困惑度 = 10.0000(理论 = 词表大小 10);有把握模型困惑度 = 1.6667(理论 = 1/0.6 = 1.6667)
✅ 核对通过:困惑度越低 ≈ 模型越有把握;均匀分布 PPL = 词表大小
全部核对通过 ✅✅
# ═══════════════════════════════════════════════════════════════
# 代码块 4/4:决策树信息增益(ID3 经典《打网球》数据集)
# 验证:信息增益 = 熵减;最优切分特征 = 天气 Outlook
# ═══════════════════════════════════════════════════════════════
import numpy as np

def entropy(p, base=2):
    p = np.asarray(p, dtype=float); p = p[p > 0]
    return float(-(p * np.log(p)).sum() / np.log(base))

def class_entropy(labels):
    """对「标签列」算熵:先统计类别频率(bincount),再套熵公式"""
    labels = np.asarray(labels)
    counts = np.bincount(labels)               # 每个类别的样本数
    probs = counts[counts > 0] / len(labels)   # 类别频率 = 概率分布
    return entropy(probs)

def cond_entropy_by_group(labels, groups):
    """条件熵 H(标签|特征) = Σ_v (|D_v|/|D|) · H(D_v)"""
    labels = np.asarray(labels)
    total = len(labels)
    h = 0.0
    for v in np.unique(groups):
        mask = groups == v
        h += mask.sum() / total * class_entropy(labels[mask])
    return float(h)

def information_gain(labels, groups):
    """信息增益 Gain = H(D) - H(D|特征)"""
    return class_entropy(labels) - cond_entropy_by_group(labels, groups)

# 经典 ID3「打网球」14 条数据(0 = 不去,1 = 去)
outlook  = np.array(['晴','晴','阴','雨','雨','雨','阴','晴','晴','雨','晴','阴','阴','雨'])
temp     = np.array(['热','热','热','暖','凉','凉','凉','暖','凉','暖','暖','暖','热','暖'])
humidity = np.array(['高','高','高','高','正常','正常','正常','高','正常','正常','正常','高','正常','高'])
wind     = np.array(['弱','强','弱','弱','弱','强','强','弱','弱','弱','强','强','弱','强'])
play     = np.array([0, 0, 1, 1, 1, 0, 1, 0, 1, 1, 1, 1, 1, 0])   # 1 = 去打网球

H_D = class_entropy(play)
print(f'全样本熵 H(D) = {H_D:.4f}')
gains = {}
for name, feat in [('天气 outlook', outlook), ('温度 temp', temp),
                   ('湿度 humidity', humidity), ('风力 wind', wind)]:
    g = information_gain(play, feat)
    gains[name] = g
    print(f'信息增益 {name} = {g:.4f}')

best = max(gains, key=gains.get)
print(f'\n最优切分特征 = {best}')
assert best == '天气 outlook', 'ID3 首选切分特征应为 outlook(经典结论)'
assert gains['天气 outlook'] > 0
for g in gains.values():
    assert g >= -1e-9, '信息增益不应为负(条件熵 ≤ 熵)'
print('✅ 核对通过:信息增益 = 熵减(纯度提升),越大越好;ID3 首选天气——与教科书结论一致')
print('全部核对通过 ✅✅')
全样本熵 H(D) = 0.9403
信息增益 天气 outlook = 0.2467
信息增益 温度 temp = 0.0292
信息增益 湿度 humidity = 0.1518
信息增益 风力 wind = 0.0481

最优切分特征 = 天气 outlook
✅ 核对通过:信息增益 = 熵减(纯度提升),越大越好;ID3 首选天气——与教科书结论一致
全部核对通过 ✅✅
面试考点:信息论高频 Q&A¶
Q1:熵的直觉是什么?为什么底数常取 2 和 e?
- 答:熵是「平均信息量」,也是「平均不确定度」——把所有事件的自信息按概率加权平均。底数 2 时单位是 bit(一个公平硬币的信息量 = 1 bit),底数 e 时单位是 nat(机器学习求导方便,因为 $\frac{d}{dx}\ln x$ 简洁);两者仅差常数因子,$1\ \text{nat}=\log_2 e$ bit。
- 追问:为什么必须是 log?→ 独立事件的信息量要相加,而概率相乘,把乘法变加法只有 log 能做到(故事引入的猜谜游戏就是直观演示)。
- 30 秒速答:熵 = 平均自信息 = 平均不确定度;bit 和 nat 只差常数倍。
Q2:交叉熵为什么能当分类损失?为什么配 softmax?
- 答:分类的真实分布 P 是 one-hot(固定),交叉熵 = $H(P)+KL(P\|Q)$,其中 $H(P)=0$,所以最小化交叉熵 = 最小化 KL = 让模型分布 Q 逼近真实标签分布;同时它等价于负对数似然。配 softmax 是因为:softmax 把 logits 变成合法概率,且交叉熵对 logits 的梯度是 $p-y$,不含 sigmoid 的饱和导数项,梯度不会消失;MSE 配 sigmoid 则有 $\sigma'(z)$ 因子,预测错时梯度趋近 0,学不动。
- 追问:CE 对 logits 的梯度是什么?→ $\partial L/\partial z = q - y$(softmax 概率减 one-hot 标签)。
- 30 秒速答:CE = 负对数似然,梯度 = p − y 不饱和;softmax 负责产出概率。
Q3:KL 散度为什么 ≥ 0?何时取 0?它是对称的吗?
- 答:把 $KL$ 写成 $\mathbb{E}_P[-\ln(Q/P)]$,由 $-\ln$ 的凸性 + Jensen 不等式:$\mathbb{E}[-\ln t] \ge -\ln \mathbb{E}[t] = -\ln 1 = 0$;等号当且仅当 $Q/P\equiv 1$,即 $P=Q$。不对称:$KL(P\|Q)\ne KL(Q\|P)$,所以它不是距离度量;更严格的说法是它是一个「前向 / 反向」有方向的散度。
- 追问:$KL(P||Q)$ 与 $KL(Q||P)$ 在机器学习里各自对应什么?→ 前者(reverse KL)对应变分推断 / GAN 的 mode-seeking,后者(forward KL)对应 MLE / 监督学习。
- 30 秒速答:Jensen 不等式保证 ≥ 0;P=Q 取 0;不对称,方向有讲究。
Q4:互信息是什么?和相关系数有什么区别?
- 答:$I(X;Y)=H(X)-H(X|Y)=KL(P(x,y)\|P(x)P(y))$——知道 Y 能让 X 的不确定减少多少,也是对「联合分布偏离独立」的度量;$I=0$ 当且仅当 X、Y 独立。相关系数只捕捉线性关系($Y=X^2$ 时相关系数为 0 但互信息很大),互信息捕捉任意依赖关系。
- 追问:互信息有没有上界、怎么归一化?→ $0\le I\le \min(H(X),H(Y))$,可除以 $\min$ 或 $H(X,Y)$ 得到 $[0,1]$ 的归一化互信息(NMI)。
- 30 秒速答:互信息 = 共享信息 = 与独立的差距;能抓非线性,相关系数只能抓线性。
Q5:困惑度是什么?越低越好吗?
- 答:$PPL = e^{\text{平均负对数似然}} = 2^{H}$,直觉是「模型平均在几个候选里纠结」;均匀分布 PPL = 词表大小,好的模型可以到 10 以下。一般越低越好,但跨模型比较要小心:词表大小、分词方式、数据难度都会影响 PPL,不同词表下不可直接比。
- 追问:PPL 和 loss 的关系?→ $PPL = e^{loss}$,训练 loss 降 1,PPL 约除以 e;所以看训练曲线时两者形状一致。
- 30 秒速答:PPL = e 的损失次方,越低越有把握;跨模型比要控制词表与数据。
Q6:决策树为什么用信息增益?信息增益有什么偏好?
- 答:信息增益 = $H(D)-H(D|特征)$,衡量「按该特征切分后纯度(确定性)提升了多少」,越大越好——ID3 就按它选根节点。它偏好取值多的特征(如「编号」能把每个样本单独成叶,增益最大但纯属过拟合),所以 C4.5 改用增益率(信息增益 ÷ 特征自身熵)来校正。
- 追问:剪枝和信息增益什么关系?→ 后剪枝比较「剪前 / 剪后」的泛化误差或信息增益变化,防止过拟合。
- 30 秒速答:信息增益 = 熵减;偏好取值多的特征,C4.5 用增益率校正。
Q7:生成模型 / RLHF 里的 KL 约束是怎么回事?
- 答:RLHF 在奖励里减掉 $\beta\cdot KL(\pi_\theta\|\pi_{ref})$:既要模型讨好奖励,又不许偏离参考策略太远(防止奖励过拟合导致胡说八道);DPO 把这一 KL 项写成闭式解,训练时无需显式奖励模型。KL 在这里就是「两个分布的差距=跑偏的代价」。
- 追问:为什么用 KL 不用别的?→ KL 与交叉熵同源、可微、有明确信息论含义(多余 bit 数),且在 PPO 里能写成与策略梯度一致的估计量。
- 30 秒速答:RLHF 减 β·KL 约束模型别跑偏;DPO 把它闭式化。
小结与下一章预告¶
- 一条主线:信息量 = 出人意料的程度,用 $-\log P$ 度量 → 平均得到熵 → 展开出条件熵、联合熵、交叉熵、KL 散度、互信息、困惑度;
- 两个大用途:① 交叉熵损失是深度学习的分类标配(等价于负对数似然 + 隐式 KL 最小化);② KL 散度贯穿正则化(RLHF)、变分推断(VAE)、蒸馏等等;
- 三条不等式要能随手写出来:$H(Y|X)\le H(Y)$、$KL(P\|Q)\ge 0$、$I(X;Y)\ge 0$。
下一章预告:04-最优化与数值基础 —— 有了损失函数(交叉熵、MSE),怎么把它的最小值找出来?凸性、梯度下降、牛顿法、拉格朗日对偶与 KKT 条件,就是让模型「学会」的引擎。
🧪 自测:不看笔记,写出 $CE=H+KL$ 并口述 KL ≥ 0 的证明梗概;说出交叉熵对 logits 的梯度;解释 PPL 与 loss 的关系;讲清「信息增益为什么偏好取值多的特征」。