14-具身智能 · 05 具身智能面试八股与高频题
本篇是 00–04 五篇笔记的“考前 30 分钟压缩包”:公式速查表 + 高频追问 20 问(每题 30 秒标准答案 + 一句话口诀)。 覆盖范围:旋转矩阵 / 齐次变换 / 正逆运动学 / 雅可比 / A* / RRT / PID / MPC / 动作 token / 损失函数 / 数据与 Sim2Real / 评估指标。
本节要解决的问题
| 要解决的问题 | 一句话答案 |
|---|---|
| 考前 30 分钟看什么? | 先扫公式速查表,再背 20 个高频追问的标准答案和口诀 |
| 齐次变换为什么“右乘”? | 右乘 = 在动坐标系(当前坐标系)下做变换;左乘 = 在世界坐标系下做变换 |
| 雅可比是干什么的? | 关节速度↔末端速度的映射,兼做力控对偶 τ=JᵀF 与数值逆解 |
| A* 和 RRT 怎么对比? | A* 图搜索最优但高维爆炸;RRT 采样快速、概率完备、不保证最优 |
| PID 怎么整定? | 先 P 后 D 再 I:P 让系统动起来,D 压超调,I 消稳态误差 |
| MPC 和 PID 有什么区别? | MPC 有模型、预测 H 步、显式处理约束;PID 无模型、看当前一步 |
| RT-2 如何把动作变成 token? | 7 维动作各量化成 256 个 bin 的 token,拼进序列做自回归生成 |
| 具身智能和 LLM Agent 的区别? | LLM Agent 动“数字工具”,具身智能动“物理世界” |
| 具身智能有哪些评估指标? | success rate 为主,加完成度/效率/鲁棒性/泛化/安全五维 |
故事引入
明天早上 10 点面试,小明昨晚翻完 00–04 五篇笔记已经凌晨一点。第二天 9 点 30 分他到了公司楼下,掏出手机打开这篇“考前 30 分钟速查”:前 5 分钟扫公式表——旋转矩阵、齐次变换、雅可比、A*、RRT、PID、MPC、动作 token、损失函数;中间 20 分钟过 20 个高频追问,每题先自己默答一遍,再对答案;最后 5 分钟只背口诀。
面试官开问:“RT-2 怎么把动作变成 token?” 小明答:“把 7 维末端动作各自量化成 256 个 bin,变成 token 拼在指令后面,用语言模型的交叉熵损失训练。” 面试官追问:“那和 OpenVLA 有什么区别?” 小明:“RT-2 是闭源两阶段(预训练 + 微调),OpenVLA 是开源、用预训练 VLM 加 LoRA 微调,参数量小很多,社区可复现。” 面试官点点头,又问“齐次变换为什么右乘”——小明默念口诀“左乘世界系,右乘动坐标系”,两句话讲清楚。
面试官最后问了一道综合题:“机械臂桌面整理,你会怎么设计数据、模型和评估?” 小明用本篇第 20 题的框架,把感知→规划→控制→数据→评估一条线串下来,面试官当场给了一个“过”。
30 分钟能做的事不多,但恰恰是把“会看”变成“会答”的关键一步:公式一眼认得出,概念一句话说得清,坑提前踩过一遍。
核心概念
(a) 🗂️ 具身智能知识地图:一张图串起 00–05 五篇笔记
面试官问的东西再多,也逃不出这张图的 8 个环节。答题时先想“这个问题属于哪个环节”,再往该环节的知识点里找答案。
flowchart TB
    A["00 表示与运动学<br/>旋转矩阵/齐次变换/正逆解/雅可比"] --> B["01 感知与环境<br/>RGB-D/点云/SLAM/场景表示"]
    B --> C["02 规划与控制<br/>A*/RRT/PID/MPC/阻抗控制"]
    A --> C
    C --> D["03 VLA<br/>RT-2/OpenVLA/动作token/损失"]
    A --> D
    D --> E["04 数据与Sim2Real<br/>遥操作/域随机化/评估"]
    E --> F["05 面试输出<br/>公式快查+20问+口诀"]
    F --> G["综合考察<br/>给场景选方法/手推公式/讲坑"]
    B --> E
- 00 表示与运动学:机器人的“身体语言”——用什么数学表达位姿(旋转矩阵/齐次变换),怎么算末端在哪(正解)、怎么反推关节角(逆解)、速度怎么映射(雅可比)。答不齐这个环节,后面全塌。
- 01 感知与环境:机器人的“眼睛”——RGB-D、点云、检测分割、SLAM,解决“世界长什么样、我在哪、物体在哪”。
- 02 规划与控制:机器人的“小脑”——A*/RRT 决定“走哪条路”,PID/MPC 决定“怎么沿着路动”,阻抗控制决定“跟环境接触时多硬多软”。
- 03 VLA:机器人的“大脑”——RT-2/OpenVLA 把视觉、语言、动作拼进一个序列模型,“看懂指令、想好动作”。
- 04 数据与 Sim2Real:机器人的“粮食”——真实遥操作、仿真、视频三类数据怎么来、怎么用,域随机化怎么让策略过“仿真→真机”这道坎,怎么科学评估。
- 05 面试输出:本篇——把前五篇浓缩成公式快查 + 20 问 + 口诀,用于考前 30 分钟。
- 综合考察:真正面试会把多个环节串起来考,比如“机械臂抓取 + 桌面整理”综合题,答题模板见本篇第 20 问。
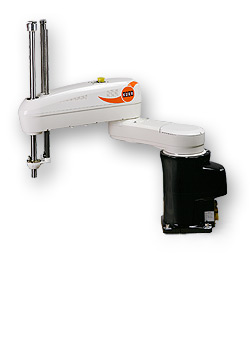
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Jo Teichmann · Public domain
深入原理(一)公式速查:旋转矩阵与齐次变换
大白话直觉
旋转矩阵 = 一个坐标系的姿态(三根轴在另一个坐标系里的投影);齐次变换矩阵 = 姿态 + 位置打包成 4×4,让“旋转 + 平移”能像普通矩阵乘法一样连乘,机器人每个关节的变换链就能一行一行乘出来。
公式
绕 z 轴旋转 θ 的旋转矩阵(绕 x、y 轴同理交换行列):
$$ R_z(\theta) = \begin{bmatrix} \cos\theta & -\sin\theta & 0 \\ \sin\theta & \cos\theta & 0 \\ 0 & 0 & 1 \end{bmatrix} $$
旋转矩阵三大性质(面试必背):
$$ R^{\mathsf{T}} R = I \;\;(\text{正交}), \qquad \det(R) = +1 \;\;(\text{右手系、不翻转}), \qquad R^{-1} = R^{\mathsf{T}} \;\;(\text{转置即逆}) $$
齐次变换与求逆(SE(3) 群元):
$$ T = \begin{bmatrix} R & p \\ 0^{\mathsf{T}} & 1 \end{bmatrix}, \qquad T^{-1} = \begin{bmatrix} R^{\mathsf{T}} & -R^{\mathsf{T}} p \\ 0^{\mathsf{T}} & 1 \end{bmatrix} $$
推导/记忆:左乘 vs 右乘(高频追问 #1 的正式推导)
设物体先绕 z 轴转 α(旋转 A),再绕 y 轴转 β(旋转 B):
- 左乘(世界系叠加):R = R_B · R_A —— B 是在世界坐标系中定义的,所以放在左边先作用(后乘的放左边);
- 右乘(动坐标系叠加):R = R_A · R_B —— B 是在物体旋转后的当前坐标系中定义的,所以放在右边。
机器人链式正解 $T_{0n} = T_{01} T_{12} \cdots T_{n-1,n}$:每个相邻关节的变换都定义在“当前关节坐标系”里,正是右乘——把这一句记住,面试“为什么右乘”直接拿下。
面试怎么问
- Q:齐次变换为什么右乘? A:因为每个关节变换定义在动坐标系(当前坐标系)里;左乘对应在世界坐标系中施加变换。
- Q:为什么引入齐次变换? A:把旋转 + 平移统一成矩阵乘法,链式求位姿、求逆、坐标变换全部变成线性代数,计算机实现简单。
- Q:旋转矩阵为什么正交? A:旋转只改变方向不改变长度,列向量(坐标轴单位向量)两两正交且模长为 1 → RᵀR = I。
深入原理(二)公式速查:正逆运动学与雅可比
大白话直觉
正运动学:告诉每个关节转多少度,算出末端在哪、什么姿态(唯一答案);逆运动学:告诉末端要去哪,反推关节转多少度(多个答案,还得挑);雅可比:末端速度和关节速度之间的“变速箱”,同时是力传递的“杠杆”,也是数值逆解的工具。
公式
正解(DH 参数 + 链式相乘,n 关节机械臂):
$$ T_{EE} = T_{01}(\theta_1)\, T_{12}(\theta_2) \cdots T_{n-1,n}(\theta_n) $$
雅可比速度映射与静力对偶(由虚功原理推导:末端做功 = 关节做功):
$$ v_{EE} = J(q)\,\dot{q}, \qquad \tau = J(q)^{\mathsf{T}} F_{EE} $$
数值逆解(雅可比伪逆迭代;λ 为阻尼项,防奇异点附近数值爆炸):
$$ \dot{q} = J^{\dagger}(q)\, \dot{x}_d = J^{\mathsf{T}}(J J^{\mathsf{T}} + \lambda^2 I)^{-1}\, \dot{x}_d $$
推导/记忆:逆解三选一 + 奇异点
- 解析解:6 自由度带球形手腕(三轴交于一点,Pieper 准则)可把位置/姿态解耦,闭式求解,快且稳;
- 数值迭代:给定末端位姿误差 Δx,用 Δq = J⁺Δx 反复迭代逼近,通用但可能落入局部极小;
- 冗余自由度(7 轴/人形):多出来的自由度用于避障、省力等任务约束,选“最优解”。
- 奇异点:rank(J) 下降处,J⁺ 数值爆炸,末端在某些方向“发不上力/动不了”,需阻尼最小二乘兜底。
面试怎么问
- Q:雅可比干什么? A:三件事——速度映射 v = Jq̇、力控对偶 τ = JᵀF、数值逆解迭代。
- Q:为什么逆解比正解难? A:多解(多种构型可达同一末端位姿)、可能无解(超出工作空间)、奇异点病态,需要解析/数值/优化三选一。
- Q:怎么判断奇异点? A:看 J 的秩或 det(JJᵀ) 是否趋于 0;关节空间用可操作性椭球(manipulability)衡量。
深入原理(三)公式速查:路径规划 A* 与 RRT
大白话直觉
A* 像“拿着地图找最短路线”:每个格子记“已经走了多远 g + 估计还要多远 h”,总是先探最有希望的格子;RRT 像“蒙眼撒网”:随机往空间撒点,把能连上的点连成树,树长到终点就有一条路。一个适合离散地图求最优,一个适合高维连续空间求快。
公式
A* 的评分函数(h 必须可采纳,即 h ≤ 真实代价 h*,才能保证最优):
$$ f(n) = g(n) + h(n), \qquad g(n) = \text{起点到 } n \text{ 的实际代价}, \quad h(n) \le h^{*}(n) $$
RRT 扩展一步:随机采样 x_rand,找树中最近点 x_near,朝 x_rand 方向步进 δ 得 x_new,碰撞检测通过则加入树:
$$ x_{new} = x_{near} + \delta\, \frac{x_{rand} - x_{near}}{\|x_{rand} - x_{near}\|} $$
推导/记忆:对比表(高频追问 #5 的标准答法)
| 维度 | A* | RRT |
|---|---|---|
| 空间 | 离散图/栅格 | 连续空间(对高维友好) |
| 最优性 | 完备且最优(h 可采纳) | 概率完备,不保证最优(RRT* 渐近最优) |
| 复杂度 | 随维度指数增长 | 采样开销小,绕过维度灾难 |
| 适用 | 2D 地图、可离散化问题 | 机械臂/移动机器人高维构型空间 |
| 风险 | 栅格太粗会失真 | 窄通道难采样、路径绕 |
面试怎么问
- Q:为什么 RRT 是概率完备不是完备? A:完备要求“只要存在解就必然找到”;RRT 靠随机采样,只有当采样点足够多(趋于无穷)时才能以概率 1 覆盖解空间(尤其窄通道),所以是概率完备。
- Q:A 的启发函数为什么必须可采纳?* A:若 h 高估真实代价,可能把“实际更优”的节点误判为差而跳过,丢掉最优解;h 可采纳(不高估)保证 f 排序不会错过最优路径。
- Q:什么时候用 A,什么时候用 RRT?* A:低维、可离散、要最优用 A*;高维连续空间、只要快不要最优用 RRT/RRT-Connect;要最优又要高维用 RRT*。
深入原理(四)公式速查:控制 PID 与 MPC
大白话直觉
PID 像“近视的司机”:看当前离目标多远(P)、以前偏了多久(I)、现在偏得有多快(D),拍脑袋给一脚油门;MPC 像“有导航的司机”:看一眼未来十秒的路(模型预测),在满足限速(约束)的前提下选一条最优轨迹,走一小步再重新算。一个不建模、一个建模;一个看当下、一个看未来。
公式
连续 PID:
$$ u(t) = K_p e(t) + K_i \int_0^t e(\tau)\,d\tau + K_d \frac{de(t)}{dt} $$
离散 MPC(滚动时域优化,H 为预测步数,Q/R/Q_f 为权重矩阵):
$$ \min_{u_{0:H-1}} \sum_{k=0}^{H-1} \Big( (x_k - x_{ref})^{\mathsf{T}} Q (x_k - x_{ref}) + u_k^{\mathsf{T}} R u_k \Big) + (x_H - x_{ref})^{\mathsf{T}} Q_f (x_H - x_{ref}) $$
$$ \text{s.t.}\quad x_{k+1} = f(x_k, u_k), \quad u_k \in \mathcal{U}, \quad x_k \in \mathcal{X} $$
推导/记忆:对比表 + 整定口诀
| 维度 | PID | MPC |
|---|---|---|
| 模型 | 无模型 | 需要模型 f(越准越好) |
| 视野 | 当前一步误差 | 预测未来 H 步 |
| 约束 | 不处理(只能靠限幅) | 显式处理状态/输入约束 |
| 算力 | 极低、易嵌入式部署 | 每步解一个优化问题,较高 |
| 典型场景 | 电机、简单跟踪 | 强耦合、强约束、高动态系统 |
整定口诀:先 P 后 D 再 I——先加 P 让系统动起来(过大则振荡),再加 D 压超调,最后加 I 消稳态误差;或 Ziegler–Nichols 法:只开 P 调到临界振荡,记下临界增益 Ku 与临界周期 Tu,再按表查 Kp/Ki/Kd。 Q/R 含义:Q 惩罚“状态偏离目标”,R 惩罚“用力过猛”;Q 大 → 跟踪更狠,R 大 → 动作更温和。
面试怎么问
- Q:PID 三个增益分别管什么? A:Kp 管力度(对当前误差的反应),Ki 管消差(累积历史误差消除稳态误差),Kd 管刹车(预测误差趋势抑制超调/振荡)。
- Q:MPC vs PID? A:有模型/无模型、预测/单步、约束/无约束、算力高/低;简单线性任务 PID 够用,强约束强耦合用 MPC。
- Q:MPC 代价函数里 Q 和 R 什么意思? A:Q 权重状态偏差、R 权重控制量;加分答“终端代价 Q_f 可用于保证稳定性”。
深入原理(五)公式速查:VLA 动作 token 化与损失
大白话直觉
VLA(视觉-语言-动作模型)把机器人当成一个“会动手的多模态大模型”:输入图像 + 指令,输出动作。关键思想是**“动作即语言”**——把连续动作切成有限档位(token),像写作文一样一个 token 一个 token 生成,训练损失和语言模型几乎一样。
公式
RT-2 式动作 token 化:7 维末端控制动作(平移 3 + 旋转 3 + 夹爪 1)各自量化成 256 个 bin:
$$ a_d \in [-1, 1] \;\xrightarrow{\text{量化 256 bins}}\; t_d \in \{0, 1, \ldots, 255\}, \quad d = 1, \ldots, 7 $$
序列与损失(下一 token 预测 + 动作 token 上的交叉熵,语言任务作为预训练/辅助目标):
$$ \mathcal{L} = - \sum_{t} \log p_{\theta}\big( \text{token}_t \mid \text{image, instruction}, \text{token}_{<t} \big) $$
连续动作策略的模仿损失(不 token 化时的备选):回归 $ \mathcal{L}_{BC} = \mathbb{E}_{(o,a) \sim \mathcal{D}}\big[ \| a - \pi_{\theta}(o) \|^2 \big] $,或最大似然 $ -\log \pi_\theta(a \mid o) $。
推导/记忆:为什么“量化 + 交叉熵”
连续动作直接回归的坏处:多峰动作分布(同一个状态有多个合理动作)用 MSE 会学成“平均值”,动作模糊;量化成 token 后:① 复用 Transformer 自回归生成框架,天然处理序列;② 交叉熵损失对多峰分布更友好;③ 与语言共享 tokenizer 生态。代价:量化误差(bin 粒度),推理时反量化回连续值交给低层控制器补偿。
面试怎么问
- Q:RT-2 的动作 token 怎么来的? A:7 维动作各量化成 256 个 bin → 动作 token 拼在指令 token 之后 → 自回归生成 + 交叉熵训练;推理时反量化成连续动作。
- Q:VLA 的损失函数? A:主体是语言模型的“下一 token 交叉熵”,动作 token 参与其中;OpenVLA 等开源路线用预训练 VLM + LoRA 微调,动作 token 处理方式相同。
- Q:为什么动作要离散? A:复用序列生成框架、表达多峰分布、训练稳定;离散粒度是精度上限,通常末端加低层控制器。
深入原理(六)公式速查:数据、Sim2Real 与评估收尾
大白话直觉
把 04 篇压成三块:数据(真实/仿真/视频怎么配比)、迁移(域随机化让策略不怕参数漂移)、评估(success rate 别只看一个数)。
公式
域随机化训练目标(参数 ξ 服从随机分布 p(ξ)):
$$ \theta^{*} = \arg\max_{\theta} \mathbb{E}_{\xi \sim p(\xi)} \mathbb{E}_{\tau \sim \pi_\theta(\cdot \mid \xi)} \big[ R(\tau) \big] $$
成功率与 95% 置信区间(N 次试验,s_i 为成功指示):
$$ \widehat{SR} = \frac{1}{N} \sum_{i=1}^N s_i, \qquad \text{CI}_{95\%} \approx \widehat{SR} \pm 1.96 \sqrt{\frac{\widehat{SR}(1-\widehat{SR})}{N}} $$
一条示范的样本格式(proprioception + action):
$$ \tau = [(o_1, a_1), \ldots, (o_T, a_T)], \quad o_t = \big( \underbrace{q_t, \dot{q}_t, \text{末端位姿}, \text{夹爪开合}}_{\text{proprioception 本体感觉}} + \text{图像/点云} \big), \quad a_t = \big( \text{关节角/角速度/力矩命令}, \text{夹爪命令} \big) $$
推导/记忆:三张表背完
| 数据源 | 优点 | 缺点 | 用途 |
|---|---|---|---|
| 真实遥操作 | 可信、带动作标签 | 贵、慢、少 | 微调 + 评估(定上限) |
| 仿真 | 便宜、可并行、可控 | reality gap | 大规模训练(扩量) |
| 互联网视频 | 海量、场景丰富 | 无动作标签 | 预训练/世界模型(开眼界) |
| sim2real 步骤 | 一句话 |
|---|---|
| 1 系统辨识 | 把真机质量/摩擦/延迟标定出来填回仿真(减差距) |
| 2 域随机化 | 参数分布随机化训练鲁棒策略(抗差距) |
| 3 仿真评估 | 多 seed 统计 SR,筛 checkpoint |
| 4 真机部署 | 先零样本,不行再少量微调(收尾) |
面试怎么问
- Q:sim2real 整体怎么做? A:标定 → 随机化 → 仿真训练 → 多 seed 评估 → 真机零样本/微调,闭环迭代。
- Q:评估只看 success rate 吗? A:不够——补平均完成度、效率(步数/时间)、鲁棒性(多 seed)、泛化(新物体/新布局/新指令)、安全(碰撞/违规次数);仿真 SR 不能替代真机 SR。
代码实战(可选):numpy 数值验证——旋转矩阵性质 + 齐次变换 + PID 手推一致
考前 5 分钟手不能生,这四个核对项都是面试手推题的“指纹”:
- 旋转矩阵正交性:R·Rᵀ = I、det(R) = +1;
- 左乘 vs 右乘:同一对旋转,世界系叠加(左乘)≠ 动系叠加(右乘);
- 齐次变换链:T03 = T01·T12·T23(右乘)且 T·T⁻¹ = I;
- PID 手推一致:程序仿真的前 3 步 u 值 == 用公式在纸上手推的值。
全程 numpy、固定数值、无随机,输出即核对。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# -*- coding: utf-8 -*-
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, io.UnsupportedOperation):
    pass  # Jupyter 内核下 stdout 无 buffer,跳过重包装

import numpy as np

# ---------- 1. 旋转矩阵性质:R·Rᵀ = I, det(R) = +1 ----------
def Rz(theta):
    c, s = np.cos(theta), np.sin(theta)
    return np.array([[c, -s, 0.0], [s, c, 0.0], [0.0, 0.0, 1.0]])

def Ry(beta):
    c, s = np.cos(beta), np.sin(beta)
    return np.array([[c, 0.0, s], [0.0, 1.0, 0.0], [-s, 0.0, c]])

th = 0.7
R = Rz(th)
print('核对1a:R·Rᵀ =\n', np.round(R @ R.T, 12))
print('核对1a:Rᵀ·R =\n', np.round(R.T @ R, 12))
assert np.allclose(R @ R.T, np.eye(3)) and np.allclose(R.T @ R, np.eye(3)), '正交性失败'
assert np.isclose(np.linalg.det(R), 1.0), '行列式应为 +1'
print('核对1:R·Rᵀ = Rᵀ·R = I ✔,det(R) = %.6f ✔' % np.linalg.det(R))

# ---------- 2. 左乘(世界系) vs 右乘(动系) ----------
a, b = 0.5, 0.3
R_world = Ry(b) @ Rz(a)   # 先绕z再绕y,且 y 旋转定义在世界系 → 左乘 Rz(a) 先作用
R_body  = Rz(a) @ Ry(b)   # y 旋转定义在动系 → 右乘 Ry(b) 后作用
print('核对2:同一对旋转,左乘结果 ≠ 右乘结果:', not np.allclose(R_world, R_body), '✔')
print('  R_world(世界系先绕z再绕y)=\n', np.round(R_world, 4))
print('  R_body (动系先绕z再绕y) =\n', np.round(R_body, 4))

# ---------- 3. 齐次变换链(右乘)与求逆 ----------
def T4(Rmat, p):
    T = np.eye(4)
    T[:3, :3] = Rmat
    T[:3, 3] = p
    return T

T01 = T4(Rz(0.4), [1.0, 0.0, 0.0])
T12 = T4(Ry(0.2), [0.0, 1.0, 0.0])
T23 = T4(Rz(-0.3), [0.0, 0.0, 1.0])
T03 = T01 @ T12 @ T23
print('核对3:链式右乘 T03 = T01·T12·T23,末端位置 p03 =', np.round(T03[:3, 3], 4), '✔')
assert np.allclose(T03 @ np.linalg.inv(T03), np.eye(4)), '齐次求逆失败'
print('核对3b:T03 · T03⁻¹ = I ✔(齐次逆 = [Rᵀ, -Rᵀp; 0, 1])')

# ---------- 4. 离散 PID:程序结果与"手推"一致 ----------
# 离散 PI 控制律:u_k = Kp·e_k + Ki·S_k,S_k = S_{k-1} + e_k(误差累积)
# 被控对象:x_{k+1} = x_k + dt·u_k(一阶简化,只为验证控制律数值)
Kp, Ki, dt, target = 1.5, 0.3, 0.1, 1.0

x, S = 0.0, 0.0
u_loop = []
for _ in range(6):
    e = target - x
    S += e
    u = Kp * e + Ki * S
    u_loop.append(u)
    x += dt * u

# 手推前三步(面试可现场演算):
#   e0=1.0,    S0=1.0,              u0 = 1.5*1.0 + 0.3*1.0    = 1.80000
#   x1=0.18,   e1=0.82,  S1=1.82,   u1 = 1.5*0.82 + 0.3*1.82  = 1.77600
#   x2=0.3576, e2=0.6424,S2=2.4624, u2 = 1.5*0.6424+0.3*2.4624= 1.70232
u_hand = [1.80000, 1.77600, 1.70232]
print('核对4:程序仿真前 3 步 u =', np.round(u_loop[:3], 5))
print('核对4:手推前 3 步 u     =', u_hand)
assert np.allclose(u_loop[:3], u_hand), 'PID 与手推不一致'
print('核对4:程序与手推完全一致 ✔(u0=1.8, u1=1.776, u2=1.70232)')
print('全部核对通过:旋转矩阵正交 ✔ 左右乘语义 ✔ 齐次链 ✔ PID 手推一致 ✔')
核对1a:R·Rᵀ =
 [[1. 0. 0.]
 [0. 1. 0.]
 [0. 0. 1.]]
核对1a:Rᵀ·R =
 [[ 1. -0.  0.]
 [-0.  1.  0.]
 [ 0.  0.  1.]]
核对1:R·Rᵀ = Rᵀ·R = I ✔,det(R) = 1.000000 ✔
核对2:同一对旋转,左乘结果 ≠ 右乘结果: True ✔
  R_world(世界系先绕z再绕y)=
 [[ 0.8384 -0.458   0.2955]
 [ 0.4794  0.8776  0.    ]
 [-0.2593  0.1417  0.9553]]
  R_body (动系先绕z再绕y) =
 [[ 0.8384 -0.4794  0.2593]
 [ 0.458   0.8776  0.1417]
 [-0.2955  0.      0.9553]]
核对3:链式右乘 T03 = T01·T12·T23,末端位置 p03 = [0.7936 0.9984 0.9801] ✔
核对3b:T03 · T03⁻¹ = I ✔(齐次逆 = [Rᵀ, -Rᵀp; 0, 1])
核对4:程序仿真前 3 步 u = [1.8     1.776   1.70232]
核对4:手推前 3 步 u     = [1.8, 1.776, 1.70232]
核对4:程序与手推完全一致 ✔(u0=1.8, u1=1.776, u2=1.70232)
全部核对通过:旋转矩阵正交 ✔ 左右乘语义 ✔ 齐次链 ✔ PID 手推一致 ✔
📌 运行结果解读(核对)
四个核对项依次验证了面试最常考的四类“手推题”:
- R·Rᵀ = I:数值上 R 乘转置得到单位阵、行列式为 +1——旋转矩阵是正交矩阵、转置即逆;
- 左乘 ≠ 右乘:相同的“先绕 z 再绕 y”,左乘(y 在世界系)得到 Tait-Bryan 欧拉角顺序的结果,右乘(y 在动系)得到完全不同矩阵——这就是“右乘 = 动系变换”的数值证据;
- 齐次链:T03 = T01·T12·T23 右乘连乘得到末端位姿,且逆矩阵满足 T·T⁻¹ = I,验证齐次逆公式 [Rᵀ, −Rᵀp];
- PID 手推一致:u0 = 1.8、u1 = 1.776、u2 = 1.70232 与程序仿真逐位一致——面试被要求“手推 PID 一步”时,按 e→S→u 的顺序现场算三行即可。
口诀:左乘世界系,右乘动坐标;R 乘转置得单位阵;PID 先 P 后 D 再 I。
模型详解(面试深度)
本篇补两块:① 全章 30 个模型/方法一张档案总表(前夜只背这一张);② 15 个追问层高频题(总表背完,被问深一层也不慌)。
一、全章模型档案总表(30 行 · 考前一张表)
| 分类 | 模型/方法 | 一句话核心思想 | 关键公式一句话 | 适用场景 | 面试一句话答法 |
|---|---|---|---|---|---|
| 位姿 | 旋转矩阵/四元数 | 旋转矩阵 R 描述姿态;四元数 q 无万向节锁、利于融合与插值 | $R^\mathsf{T}R=I$、det R=+1;四元数→R 用罗德里格斯公式 | 位姿表示/坐标变换/姿态插值 | 姿态两件套:矩阵算变换,四元数做插值融合 |
| 位姿 | DH 正运动学 | 每关节用 4 个 DH 参数建一个齐次变换,链式相乘得末端位姿 | $T_{0n}=A_1A_2\cdots A_n$(当前系右乘) | 机械臂末端位姿计算 | 给关节角求末端:参数表一路乘到底 |
| 位姿 | 雅可比 | 关节速度与末端速度的线性映射,兼做力映射对偶 | $v=J(q)\dot{q}$;$\tau=J^{\mathsf{T}}F$ | 速度映射/奇异分析/数值逆解 | J 是"关节↔末端"翻译官,不满秩即奇异 |
| 位姿 | 逆运动学 IK | 由末端位姿反求关节角,多解、无解、奇异三难 | $\dot{q}=J^{\dagger}\dot{x}$ 迭代求解 | 轨迹执行/抓取位姿落关节 | 解析优先、数值兜底,奇异处阻尼最小二乘 |
| 感知 | PointNet/PointNet++ | 点云置换不变编码;++ 分层聚合局部几何 | $f=\gamma(\max_i h(x_i))$;FPS 球邻域 | 点云分类/分割 | max-pooling 保不变,分层补局部 |
| 感知 | PointPillars | 点云按柱聚合压成 2D 伪图,走 2D 检测 | pillar 内聚合→BEV CNN→2D 检测头 | 激光 3D 检测 | 稀疏 3D 压成稠密 2D |
| 感知 | SAM | 可提示(点/框/文字)的通用分割基础模型 | mask = decoder(prompt, image_feat) | 通用分割/抓取候选 | 提示即分割,零样本换任务 |
| 感知 | BEVFormer | 多相机用可变形注意力投影到 BEV 网格,含时序 | BEV query 采样多视角特征 | 纯视觉 3D 检测/占用 | 相机统一到 BEV 再做 2D 检测 |
| 感知 | Occupancy | 体素化空间,预测每格占用与语义 | 逐 voxel 分类 logits | 遮挡推理/导航避障 | 把环境变成"能走/不能走"的格子 |
| 感知 | ORB-SLAM3 / LIO-SAM | 视觉+IMU 多地图 SLAM / 激光+IMU 因子图 | 重投影误差 BA / ICP+预积分因子 | 定位建图/导航 | 视觉管纹理、激光管几何、IMU 管短时 |
| 规划 | A* | 图搜索,优先扩展 f=g+h 最小的节点 | $f(n)=g(n)+h(n)$,h 可采纳→最优 | 低维栅格/拓扑路径 | h 不超真实代价即最优 |
| 规划 | RRT* | 随机采样树 + 邻域重连,渐近最优 | 新点半径 r 内选父节点并重连 | 高维 C 空间快速规划 | 概率完备 + 渐近最优 |
| 规划 | 三次样条 | 分段三次多项式拟合路径点,保证 C² 连续 | 相邻段一阶、二阶导数连续 | 轨迹平滑/速度规划 | 让折线路径过弯不抖 |
| 规划 | CHOMP | 用"平滑+避障"代价梯度优化整条轨迹 | $\min\int(\text{曲率代价}+\text{障碍代价})$,梯度迭代 | 机械臂轨迹优化 | 先几何规划,再代价优化 |
| 控制 | PID | 比例+积分+微分三项线性反馈 | $u=K_p e+K_i\int e+K_d\dot{e}$ | 单变量伺服/位姿保持 | P 出力、I 消差、D 刹车 |
| 控制 | MPC | 有模型 + 显式约束的滚动时域优化 | $\min\sum[(x-x_{ref})^{\mathsf{T}}Q(x-x_{ref})+u^{\mathsf{T}}Ru]$,只执行第一步 | 约束多/多变量控制 | 每步重解未来 H 步,只执行一步 |
| 控制 | 阻抗控制 | 末端模拟质量-弹簧-阻尼,外力→位置偏差 | $M\Delta\ddot{x}+B\Delta\dot{x}+K\Delta x=F_{ext}$ | 柔顺装配/打磨/人机交互 | 位置不硬顶,外力泄进柔顺里 |
| 控制 | 行为树 | 选择/序列/装饰节点组织任务逻辑 | Selector 失败即换分支;Sequence 全成即过 | 任务调度/状态切换 | 把"何时做什么"画成树 |
| VLA | RT-1 | 视频语言动作模型,FiLM+Transformer 输出分箱动作 | 动作离散 bin,语言条件化自回归 | 桌面抓放(谷歌机器人) | 动作分箱当 token |
| VLA | RT-2 | 7 维动作每维分 256 bin 成 token,与文本一起自回归 | $a_i=\mathrm{quantize}\in\{0..255\}$,交叉熵 | 跨任务泛化/视觉语言推理 | 动作即语言,VLM 直接吐动作 |
| VLA | PaLM-E | 具身 VLM:图像/状态/文本 token 一起进 LLM 推理 | 多模态 token 拼接 + 自回归 | 具身推理/长程任务规划 | 让大模型看得见、回答带动作 |
| VLA | OpenVLA | 7B 开源 VLA,LoRA 微调,动作 7×256 token | 动作 token 自回归 + LoRA 低秩微调 | 开放词汇操作/多任务微调 | 开源主力,小参数量可微调 |
| VLA | ACT | CVAE+Transformer 一次性生成整段动作序列 | 训练加噪声、隐变量采样、按 chunk 执行 | 精细操作/数据少场景 | 关键在噪声训练与节拍执行 |
| VLA | Diffusion Policy | 扩散模型在动作序列上生成,天然多峰 | 整段动作迭代去噪 $\epsilon_\theta$ | 灵巧操作/多峰策略 | 一步出整段动作,多峰友好 |
| VLA | π0 | VLM 主干 + 动作专家头,动作 patch 做流匹配 | $\mathcal{L}=\mathbb{E}\|v_\theta(x_t,t)-u_t\|^2$,几步采样 | 通用双臂/灵巧操作 | 流匹配快且连续,不丢精度 |
| VLA | GR00T | 人形机器人基础模型,多模态输入、动作 token 输出 | 大规模仿真+真机数据联合训练 | 人形运动与操作 | 人形版 VLA |
| 仿真 | 域随机化 | 训练时随机化物理/视觉参数,让分布覆盖真机 | 参数 $p\sim U(p_{min},p_{max})$ 每局重采样 | 无真机数据时的 sim2real | 用分布之广盖真机之散 |
| 仿真 | 系统辨识 | 用真机实验标定仿真参数,缩小动力学 gap | $\min\sum\|y_{真}-y_{仿}(\theta)\|^2$ 拟合 | 仿真校准/模型自检 | 先让仿真"像真机"再迁移 |
| 仿真 | 遥操作 | 人示教采集(图像, 指令)→动作数据 | 固定频率记录状态+动作+指令 | 真机示范数据生产 | 贵在人工,决定能力上限 |
| 仿真 | sim2real | 仿真训练→真机部署的方法论整体 | 系统辨识+域随机化+真机微调 | 一切仿真训练的落地 | 让训练分布盖住真机分布 |
二、高频追问扩展 15 题(30 秒标准答案)
Q-a 齐次变换矩阵为什么用 4×4?右乘和左乘怎么分?
30 秒标准答案:3×3 旋转矩阵只能做旋转,平移得另加,做不到"一次乘法"。把坐标升到齐次 $\tilde{p}=[x,y,z,1]^{\mathsf{T}}$,用 $\mathbf{T}=\begin{bmatrix}\mathbf{R}&\mathbf{t}\\ \mathbf{0}^{\mathsf{T}}&1\end{bmatrix}$,则 $\tilde{p}'=\mathbf{T}\tilde{p}$ 一次乘出"旋转+平移",链式复合与求逆也都合法。左乘是在世界(固定)坐标系叠加变换,右乘是在当前(动)坐标系叠加——DH 正解每个变换都定义在"当前关节系",所以 $T_{0n}=A_1A_2\cdots A_n$ 是右乘链。
Q-b 四元数为什么适合融合/插值?怎么避免漂移?
30 秒标准答案:四元数 $q=(w,\mathbf{v})$ 用 4 个数、单位范数表示旋转,无万向节锁,且对插值封闭——Slerp:$q(t)=\frac{\sin((1-t)\theta)}{\sin\theta}q_0+\frac{\sin(t\theta)}{\sin\theta}q_1$,其中 $\cos\theta=q_0\cdot q_1$,得到最短弧匀速插值,欧拉角做不到。避免漂移三板斧:① 每步归一化 $q\leftarrow q/\|q\|$(数值误差致范数偏离 1);② 滤波器状态用误差小量 $\delta\theta$(向量部分),避免过参数化奇异;③ 角速度积分必然漂,必须用视觉/重力等观测闭环修正(互补滤波或因子图)。
Q-c 雅可比奇异了怎么办?(阻尼最小二乘公式)
30 秒标准答案:奇异处 $J$ 不满秩,伪逆 $J^{\dagger}$ 的最小奇异值趋于 0,关节速度爆炸。用阻尼最小二乘(DLS):$\dot{q}=J^{\mathsf{T}}(JJ^{\mathsf{T}}+\lambda^2 I)^{-1}\dot{x}$,等价于最小化 $\|J\dot{q}-\dot{x}\|^2+\lambda^2\|\dot{q}\|^2$——用"牺牲一点跟踪精度"换"速度有界"。SVD 视角 $\dot{q}=\sum_i\frac{\sigma_i}{\sigma_i^2+\lambda^2}v_i u_i^{\mathsf{T}}\dot{x}$:奇异时 $\sigma_i\to 0$,该项自动被压到约 $1/\lambda$。
Q-d A* 的 h 怎么设计才最优?和 RRT 什么时候互换?
30 秒标准答案:最优条件是 h 可采纳($h\le h^*$,不超真实代价)且一致($h(n)\le c(n,n')+h(n')$);h 越贴近 $h^*$,扩展节点越少——几何问题用欧氏距离、四邻域栅格用曼哈顿距离。与 RRT 互换:低维、地图已知、要最优 → A*;高维连续 C 空间(如 7 轴机械臂)、要快、可接受次优 → RRT;RRT* 靠"半径 r 内重连"做到渐近最优,但更慢。
Q-e MPC 的预测模型从哪里来?滚动优化怎么"滚动"?
30 秒标准答案:预测模型三个来源:① 机理模型(刚体动力学/运动学微分方程);② 数据驱动(系统辨识拟合的状态空间/高斯过程);③ 残差混合(机理 + 学习残差)。"滚动"指 receding horizon:每步拿最新状态 $x_k$ 当初值,解有限时域 OCP,只执行第一步 $u_k$,下一采样周期重测状态再重解。代价 $\min\sum_{i=1}^{H}\big[(x_{k+i}-x_{ref})^{\mathsf{T}}Q(x_{k+i}-x_{ref})+u_{k+i-1}^{\mathsf{T}}Ru_{k+i-1}\big]$,约束 $x\in\mathcal{X}, u\in\mathcal{U}$ 直接进优化——强在有模型、显式约束、闭环重解。
Q-f 阻抗控制怎么理解"柔顺"?力控与位控区别?
30 秒标准答案:阻抗控制把末端建模成质量-弹簧-阻尼:$M\Delta\ddot{x}+B\Delta\dot{x}+K\Delta x=F_{ext}$,$\Delta x=x_d-x$ 是期望与实际的位置偏差——外力越大偏差越大、但不硬顶,像"弹簧撑着"的柔顺手。位控只认轨迹(刚度极大,接触力会爆);力控只认力(要力传感、稳定性难);阻抗是"位置目标 + 柔顺泄力"的折中,插孔、打磨、人机交互都靠它。补充:导纳控制是阻抗的对偶——阻抗"输入力出位置",导纳"输入位置出力"。
Q-g PointNet 怎么保证置换不变性?为什么后来要分层?
30 秒标准答案:置换不变靠对称聚合:每个点先经共享 MLP $h$ 升维,再 max-pooling,$f=\gamma(\max_i h(x_i))$——顺序无关;再用 T-Net 学小网络预测 3×3 变换做输入对齐。但全局池化只留"整体特征",局部几何全丢——所以 PointNet++ 用最远点采样分球邻域,逐层"局部 PointNet"聚合 $f_i^{(l)}=\mathrm{PN}(\{p_j:\|p_j-p_i\|<r\})$,相当于给点云加了"卷积感受野",多尺度局部结构才出得来。
Q-h 3D 检测为什么用 BEV 而不是纯点云?(点云稀疏性)
30 秒标准答案:点云稀疏:3D 空间大部分体素是空的,3D 卷积在空体素上白耗算力,远距离点更稀、长距上下文不足,直接 3D 操作还吃内存。BEV 把高度维聚合掉(PointPillars 的 pillar 就是"竖柱聚合"),得到密度均匀的 2D 鸟瞰图,直接复用成熟 2D 检测器;物体在 BEV 不重叠、尺度即物理尺寸,NMS 干净,多传感器也容易统一。BEVFormer 更进一步:BEV 网格做 query,可变形注意力去多相机特征图上采样。一句话:稀疏 3D 难题压成稠密 2D 熟题。
Q-i SLAM 前端后端各做什么?为什么要 BA?
30 秒标准答案:前端管"数据关联":提特征、匹配、算帧间运动(视觉 ORB 匹配 / 激光 ICP),实时给粗位姿和局部地图——误差一步步累积。后端管"全局优化":把位姿与路标放进因子图,最小化重投影误差 $\min_{T_i,P_j}\sum_{ij}\|\pi(T_i^{-1}P_j)-z_{ij}\|_{\Sigma}^2$,即 BA——用多帧冗余约束把前端漂移"摊平",回环闭合后效果立竿见影。为什么必须 BA:前端只看相邻两帧,信息利用率低;BA 同时调所有相关位姿与点,才有全局一致。ORB-SLAM3 是视觉多地图 BA,LIO-SAM 是激光因子图 + IMU 预积分。
Q-j 域随机化会不会把策略"练傻"?怎么设范围?
30 秒标准答案:会——随机范围大到"最坏组合不可行"时任务无解,策略只能学"平均世界"的折中动作(比如重力随机到 30 m/s²,走路策略直接瘫掉)。设范围三原则:① 中心值先做系统辨识贴近真机真值,再在其周围开区间,如摩擦 ±50%、质量 ±30%、延迟 ±20 ms;② 保证"任何随机组合下任务仍可解",可行性是前提;③ 优先级按"动力学 > 视觉 > 初始条件"。补救:adaptive domain randomization——根据真机观测在线收缩分布,或真机少量数据微调兜底。
Q-k sim2real 成功率差距主要来自哪三处?
30 秒标准答案:三处:① 动力学 gap——摩擦、质量/惯量、电机延迟与带宽仿真不准,动态行为就偏;② 感知 gap——渲染与真实相机在光照、纹理、反射、噪声上的差异,视觉特征错位;③ 接触/执行 gap——接触力、柔顺、抓取滑动、软硬件时序延迟建模粗,开环动作失效。对应解法:系统辨识填①,域随机化/图像风格迁移填②,真机微调 + 闭环反馈填③。
Q-l VLA 的动作 token 化和文本 token 化有什么异同?
30 秒标准答案:同:都做离散化、都是"下一 token 预测 + 交叉熵"自回归、都能拼进同一序列(动作即语言)。异:文本天然离散、词表固定语义稳定;动作是连续高维物理量,必须量化——RT-2 每维分 256 bin($a_i=\mathrm{quantize}\in\{0..255\}^7$),OpenVLA/ACT 用 VQ-VAE 学码本——量化必有信息损失,精度被 bin 锁死;且动作 token 强时序依赖,生成错一个后面全偏,还得反量化成连续值交给低层控制器。所以才有连续动作模型(Diffusion Policy、π0 流匹配)挑战 token 化路线。
Q-m 为什么 π0 用流匹配不用扩散/自回归?
30 秒标准答案:自回归逐 token 生成,序列越长越慢,动作强时序依赖难学;扩散要几十步迭代去噪,控制周期扛不住。流匹配用一条 ODE 把噪声"线性插值"到数据分布,训练 $\mathcal{L}=\mathbb{E}_t\|v_\theta(x_t,t)-u_t\|^2$ 学速度场,采样只需几步甚至一步,非自回归、一次前向出整段连续动作——快、连续、不丢精度,适合实时灵巧操作。π0 的做法:VLM 主干 + 动作专家头,对"动作 patch"做流匹配。
Q-n VLA 评估用什么指标?success rate 有什么坑?
30 秒标准答案:主流是任务级 success rate,配套:平均完成度、首试成功率、success@k、泛化测试(新物体/新布局/新指令)、效率(时间/步数)、安全(碰撞/违规次数)。SR 的坑:① 判据不统一,"放上桌"vs"放回原位"跨论文不可比;② 二项分布方差大——SR=0.8、n=10 时 95% 置信区间宽达约 [0.44, 0.97],seed 少等于瞎报;③ 长程任务"最后一步失败全盘皆输",要用分步 SR + 完成度拆开看;④ 仿真 SR 只能筛模型,真机 SR 才是最终答案;⑤ "给几次机会"不注明,数字没法比。
Q-o 具身数据为什么贵?怎么用互联网视频补数据?
30 秒标准答案:贵在三处:真人逐帧示教慢、设备贵(机械臂+相机+夹具)、还要标注语言指令、清洗失败轨迹、人工布置场景多样性——没有 LLM 那种"免费互联网文本"。互联网视频补位三步:① 预训练视觉/世界模型(视频只学"世界怎么变",不学动作)——补语义与视觉多样性;② 学 affordance/子目标分解(看视频学会"该碰哪、先做什么");③ 学轨迹先验或 reward,再用少量真机动作数据微调动作分布。铁律:视频无动作标签,不能直接行为克隆,只能借"眼界"。
结尾:一句话串联全章(看-想-动)
一眼看过去:相机与点云先被 PointNet++/SAM/BEVFormer 变成物体与场景结构,ORB-SLAM3/LIO-SAM 把"我在哪"钉在地图上(感知);脑子里想:A*/RRT* 在 C 空间找路、三次样条把路磨平,VLA(RT-2/OpenVLA/π0)把语言指令翻译成"动作意图"(规划与决策);手上动:MPC/PID/阻抗控制把意图落成关节力矩,雅可比与 IK 负责关节↔末端翻译(控制);支撑这一切的,是遥操作攒的真机数据、域随机化与系统辨识垫底的仿真迁移(数据与 sim2real);最后用 success rate + 五维指标验收闭环。面试答任何综合题都按这条链走:看(感知)→ 想(规划/VLA)→ 动(控制)→ 练(数据/sim2real)→ 评(评估)。
面试考点:高频追问 20 问(30 秒标准答案 + 一句话口诀)
答题心法:每题先说结论一句话,再补 1–2 句论据,最后给例子。30 秒讲完,别拖。
Q1 齐次变换矩阵为什么是“右乘”?
30 秒标准答案:左乘是在世界坐标系(绝对系)下叠加变换,右乘是在动坐标系(当前系)下叠加变换。机器人每个关节的变换都定义在“当前关节坐标系”里,所以链式正解 $T_{0n} = T_{01} T_{12} \cdots$ 是右乘。例如末端先绕 z 转 α、再绕“旋转后的 y”转 β,就是 R = Rz(α)·Ry(β)(右乘顺序)。
一句话口诀:左乘世界系,右乘动坐标系。
Q2 旋转矩阵有哪些性质?为什么 R·Rᵀ = I?
30 秒标准答案:旋转矩阵是正交矩阵:列向量两两正交且模长为 1,所以 RᵀR = RRᵀ = I;行列式为 +1(右手系、不翻转);因此逆矩阵等于转置 R⁻¹ = Rᵀ。原因:旋转只改变方向不改变长度,坐标轴单位向量经旋转后仍是单位正交向量组。
一句话口诀:正交单位列,转置即逆,行列式为 +1。
Q3 雅可比矩阵是干什么的?
30 秒标准答案:三件事:① 速度映射——$v_{EE} = J(q)\dot{q}$,把关节速度映射成末端笛卡尔速度;② 力控对偶——$\tau = J^{\mathsf{T}} F_{EE}$(虚功原理),把末端力映射成关节力矩;③ 数值逆解——用伪逆 $\dot{q} = J^{\dagger}\dot{x}_d$ 迭代逼近关节角。J 不满秩处是奇异点,末端在某些方向失去运动能力。
一句话口诀:关节速度出末端速度,末端力进关节力矩。
Q4 正运动学和逆运动学的区别?
30 秒标准答案:正解:给关节角求末端位姿,唯一、好算(DH 链式相乘);逆解:给末端位姿求关节角,难——多解(同一末端位姿对应多种构型)、可能无解(超出工作空间)、奇异点病态。解法三选一:解析解(6 自由度球形手腕可解耦)、数值迭代(雅可比伪逆)、冗余自由度加任务约束选最优。
一句话口诀:正解唯一好算,逆解多解难求。
Q5 A* 和 RRT 怎么对比?什么时候用哪个?
30 秒标准答案:A* 是离散图搜索,f = g + h,h 可采纳时完备且最优,但高维栅格指数爆炸;RRT 是连续空间随机采样树,快速、概率完备(采样无穷时以概率 1 找到解)、不保证最优(RRT* 渐近最优)。低维可离散、要最优用 A*;高维连续、要快用 RRT/RRT-Connect。
一句话口诀:A* 求最优靠启发,RRT 求快靠采样。
Q6 PID 三个增益分别管什么?怎么整定?
30 秒标准答案:Kp 比例——对当前误差立即出力(力度);Ki 积分——累积历史误差消稳态误差(消差);Kd 微分——预测误差趋势抑制超调振荡(刹车)。整定:先只加 P 到接近振荡,再加 D 压超调,最后加 I 消稳态误差;也可用 Ziegler–Nichols 临界振荡法查表。
一句话口诀:P 管力度,I 管消差,D 管刹车;先 P 后 D 再 I。
Q7 MPC 和 PID 的区别?MPC 的代价函数是什么?
30 秒标准答案:PID 无模型、看当前一步误差、不处理约束、算力低;MPC 有模型、预测未来 H 步、显式处理状态/输入约束($u_k \in \mathcal{U}$)、每步滚动重解,效果好但算力高、依赖模型精度。代价函数:$\min \sum_k (x_k-x_{ref})^{\mathsf{T}} Q (x_k-x_{ref}) + u_k^{\mathsf{T}} R u_k$(加终端代价 Q_f 保证稳定)。
一句话口诀:PID 看脚下,MPC 看前方十步还带约束。
Q8 RT-2 如何把动作 token 化?
30 秒标准答案:RT-2 把 7 维末端控制动作(平移 3 + 旋转 3 + 夹爪 1)各自量化成 256 个离散 bin,变成动作 token,像文本 token 一样拼在指令 token 后,用“下一 token 预测 + 交叉熵”训练;推理时自回归生成动作 token,再反量化成连续动作交给低层控制器。这就是“动作即语言”。
一句话口诀:动作压成 256 档,当成文字一路生成。
Q9 VLA 的训练数据从哪里来?
30 秒标准答案:三类。① 真实遥操作数据——动捕/VR/夹具录制,如 Open X-Embodiment 这类跨机构汇聚的示范数据集,是主训练数据;② 仿真数据——域随机化批量生成,规模大;③ 互联网视频——海量但无动作标签,用于预训练视觉/世界模型。VLA 主训练样本是 (图像, 语言指令) → 动作 的配对。
一句话口诀:遥操作打底、仿真扩量、视频开眼界。
Q10 VLA 和传统 BC(行为克隆)策略的区别?
30 秒标准答案:传统 BC 直接做“图像→动作”映射,泛化弱、对指令理解差;VLA 用预训练 LLM/VLM 的语义能力,把“视觉 + 语言指令”共同条件化动作生成,零样本/少样本迁移强,能理解新指令甚至新任务。代价:模型大、推理慢、动作精度有限,通常下接低层控制器。
一句话口诀:VLA 先听懂再看懂,传统 BC 只看图像照抄。
Q11 sim2real 具体怎么做?
30 秒标准答案:标准流程:① 系统辨识——把真机上的质量、摩擦、电机延迟等标定出来,填回仿真(减差距);② 域随机化——在参数分布上随机训练策略(抗差距);③ 仿真多 seed 评估,筛 checkpoint;④ 真机部署——先零样本试,不行再用少量真机数据微调或渐进式迁移。核心:让训练分布覆盖真机分布。
一句话口诀:标定、随机化、仿真练、真机验,不行就微调。
Q12 仿真数据 vs 真实数据 vs 互联网视频数据?
30 秒标准答案:真实遥操作:可信、带动作标签,但贵少慢,决定上限;仿真:便宜、可并行、可控,但有 reality gap,负责扩量;互联网视频:海量、场景丰富,但无动作标签,只能用于预训练视觉/世界模型。三者的典型用法:视频开眼界(预训练)、仿真练动作(大规模训练)、真机定胜负(微调 + 评估)。
一句话口诀:真的贵、假的便宜、视频只能看不能上手。
Q13 具身智能和 LLM Agent 的区别?
30 秒标准答案:LLM Agent 的“行动”是调用数字工具(API/代码/网页),环境虚拟、可回滚、低成本;具身智能的“行动”是物理世界的运动与操作——状态连续、噪声大、不可逆、有安全风险,还要处理运动学/动力学/接触等底层问题。共同点:都是“感知→决策→行动”的循环,LLM 可作为具身的“大脑”(VLA 就用 LLM 底座)。
一句话口诀:Agent 点鼠标,具身动真格。
Q14 具身智能的评估指标有哪些?
30 秒标准答案:任务层:success rate(成功率)、平均完成度、success@k;效率层:步数/时间、成功率-时间曲线;鲁棒性:多 seed/多初始条件/干扰下的成功率;泛化层:新物体、新布局、新指令的零样本成功率;安全层:碰撞次数、违反约束次数。注意:仿真 SR 只能筛模型,最终以真机 SR 为准。
一句话口诀:成功率为王,效率、鲁棒、泛化、安全四维补。
Q15 RLHF 在具身智能里怎么用?
30 秒标准答案:动作级策略直接跑 RLHF 不现实(物理交互反馈太贵),但用在两处:① VLA 的偏好对齐——人类对视频/动作排序,训练奖励模型,再用于策略优化或预训练;② 任务级决策——给 LLM 规划器做指令偏好对齐。底层动作级 RL 多用 PPO/SAC 类算法;奖励可用“成功率 + 完成度 + 安全惩罚”等稀疏/密集组合。
一句话口诀:动作级用 PPO,任务级才用 RLHF。
Q16 世界模型在具身智能中的作用?
30 秒标准答案:世界模型学习状态转移与奖励的隐式模型 p(s', r | s, a)。三个用处:① 预测式控制——拿学到的模型做规划/想象 rollout(相当于可学习的仿真器);② 数据增强——在想象空间里扩增训练数据;③ 弥补 sim2real——在真实交互上学习世界模型,比固定仿真器更接近真机分布。
一句话口诀:世界模型 = 会预测的仿真器。
Q17 为什么具身智能这么难?(Moravec 悖论)
30 秒标准答案:Moravec 悖论:人类觉得难的(下棋、推理)对 AI 简单,觉得简单的(走路、抓杯子)对机器人极难。原因:物理世界连续、高维、噪声大、接触动力学复杂、样本获取贵;且没有语言模型那种海量免费文本数据(动作标签数据要靠遥操作/仿真攒)。另外感知-决策-控制必须闭环实时,任何一环的延迟和误差都会被放大。
一句话口诀:思考容易动作难,物理世界最残酷。
Q18 机器人动作空间有哪些表示?
30 秒标准答案:① 关节空间:各关节角/角速度,物理可直接执行;② 笛卡尔/末端空间:末端位置/姿态/速度,直观但需逆解;③ 增量式(delta pose):相对当前位姿的增量,更平滑、更好学;④ 夹爪:二值或连续开合。离散化后就是 VLA 的动作 token。选型考虑:执行器约束、任务需求、学习难度。
一句话口诀:关节好用、笛卡尔好懂、增量好训。
Q19 遥操作数据怎么采?怎么保证质量?
30 秒标准答案:采集方式:动捕(精度高、设备贵)、VR 手柄(直观、精度低)、示教夹具/主从(最贴近任务)。质量保障:多人多场景采集防风格单一;记录完整 proprioception + action;按固定频率重采样对齐(如 5–10 Hz 一致);去抖、裁剪失败轨迹;标注语言指令;按演示成功率筛选数据。
一句话口诀:多人多场景多录几遍,脏数据全删掉。
Q20 长程任务怎么测?除了成功率还看什么?
30 秒标准答案:长程任务先拆子目标(subgoal):测各子目标完成率 + 全程 success@k(前 k 个子目标内成功),避免“最后一步失败全盘皆输”掩盖进展;再补平均完成度、中途回退次数、效率(步数/时间)、鲁棒性(多 seed/干扰)与安全指标。综合题答法:感知(检测/点云)→ 规划(A*/RRT 或学习策略)→ 控制(PID/MPC/阻抗)→ 数据(遥操作/仿真/域随机化)→ 评估(SR + 五维)。
一句话口诀:长程看子任务分解,别让一步失败抹掉全程。
小结与下一章预告:本模块完结,怎么综合运用
模块小结:00–05 六篇构成具身智能面试的完整知识闭环——
- 00 机器人学基础:位姿表示、齐次变换、正逆运动学、雅可比;
- 01 感知:RGB-D、点云、检测分割、SLAM;
- 02 规划与控制:A*/RRT、PID/MPC、阻抗控制;
- 03 VLA:动作 token 化、RT-2/OpenVLA、世界模型;
- 04 数据与 Sim2Real:遥操作、仿真、域随机化、评估;
- 05 本篇:公式速查 + 20 问 + 口诀,考前 30 分钟压缩包。
综合运用示例(面试官最爱问的“全流程题”):机械臂桌面整理任务怎么设计?
- 表示:用齐次变换表达桌面/物体/末端的位姿,链式求正解;
- 感知:RGB-D/点云检测物体与目标位置;
- 规划:A*/RRT 规划无碰撞路径到抓取点;
- 控制:位置环 PID/MPC 跟踪轨迹,接触阶段用阻抗控制保安全;
- 学习:若有新物体/新指令,用 VLA + 遥操作数据训练/微调;
- 数据与迁移:仿真域随机化扩量,真机微调校准 reality gap;
- 评估:success rate + 完成度 + 效率 + 鲁棒性 + 安全五维打分。
按这个模板答,任何“给场景选方法”的题都能结构化输出。
下一章预告:本模块到此完结。建议第 3 遍复习时只看本篇速查 + 各篇「面试考点」; 接着可以去 06-面试复盘 看真实面经复盘,或在 09-计算机视觉 / 07-强化学习 / 04-LLM 大模型 中把相关环节继续加深。 祝秋招顺利,一句口诀收尾:表示打底、感知看路、规划选径、控制执行、数据管够、评估说话。