🎰 04 · CTR 预估模型:LR → FM → DeepFM / GBDT+LR¶
精排层的核心任务是 CTR/CVR 预估。本节沿工业演进路线走一遍: 手写 LR、手写 FM(pair 项+梯度),对照 GBDT+LR,最后串讲 Wide&Deep/DeepFM 结构。
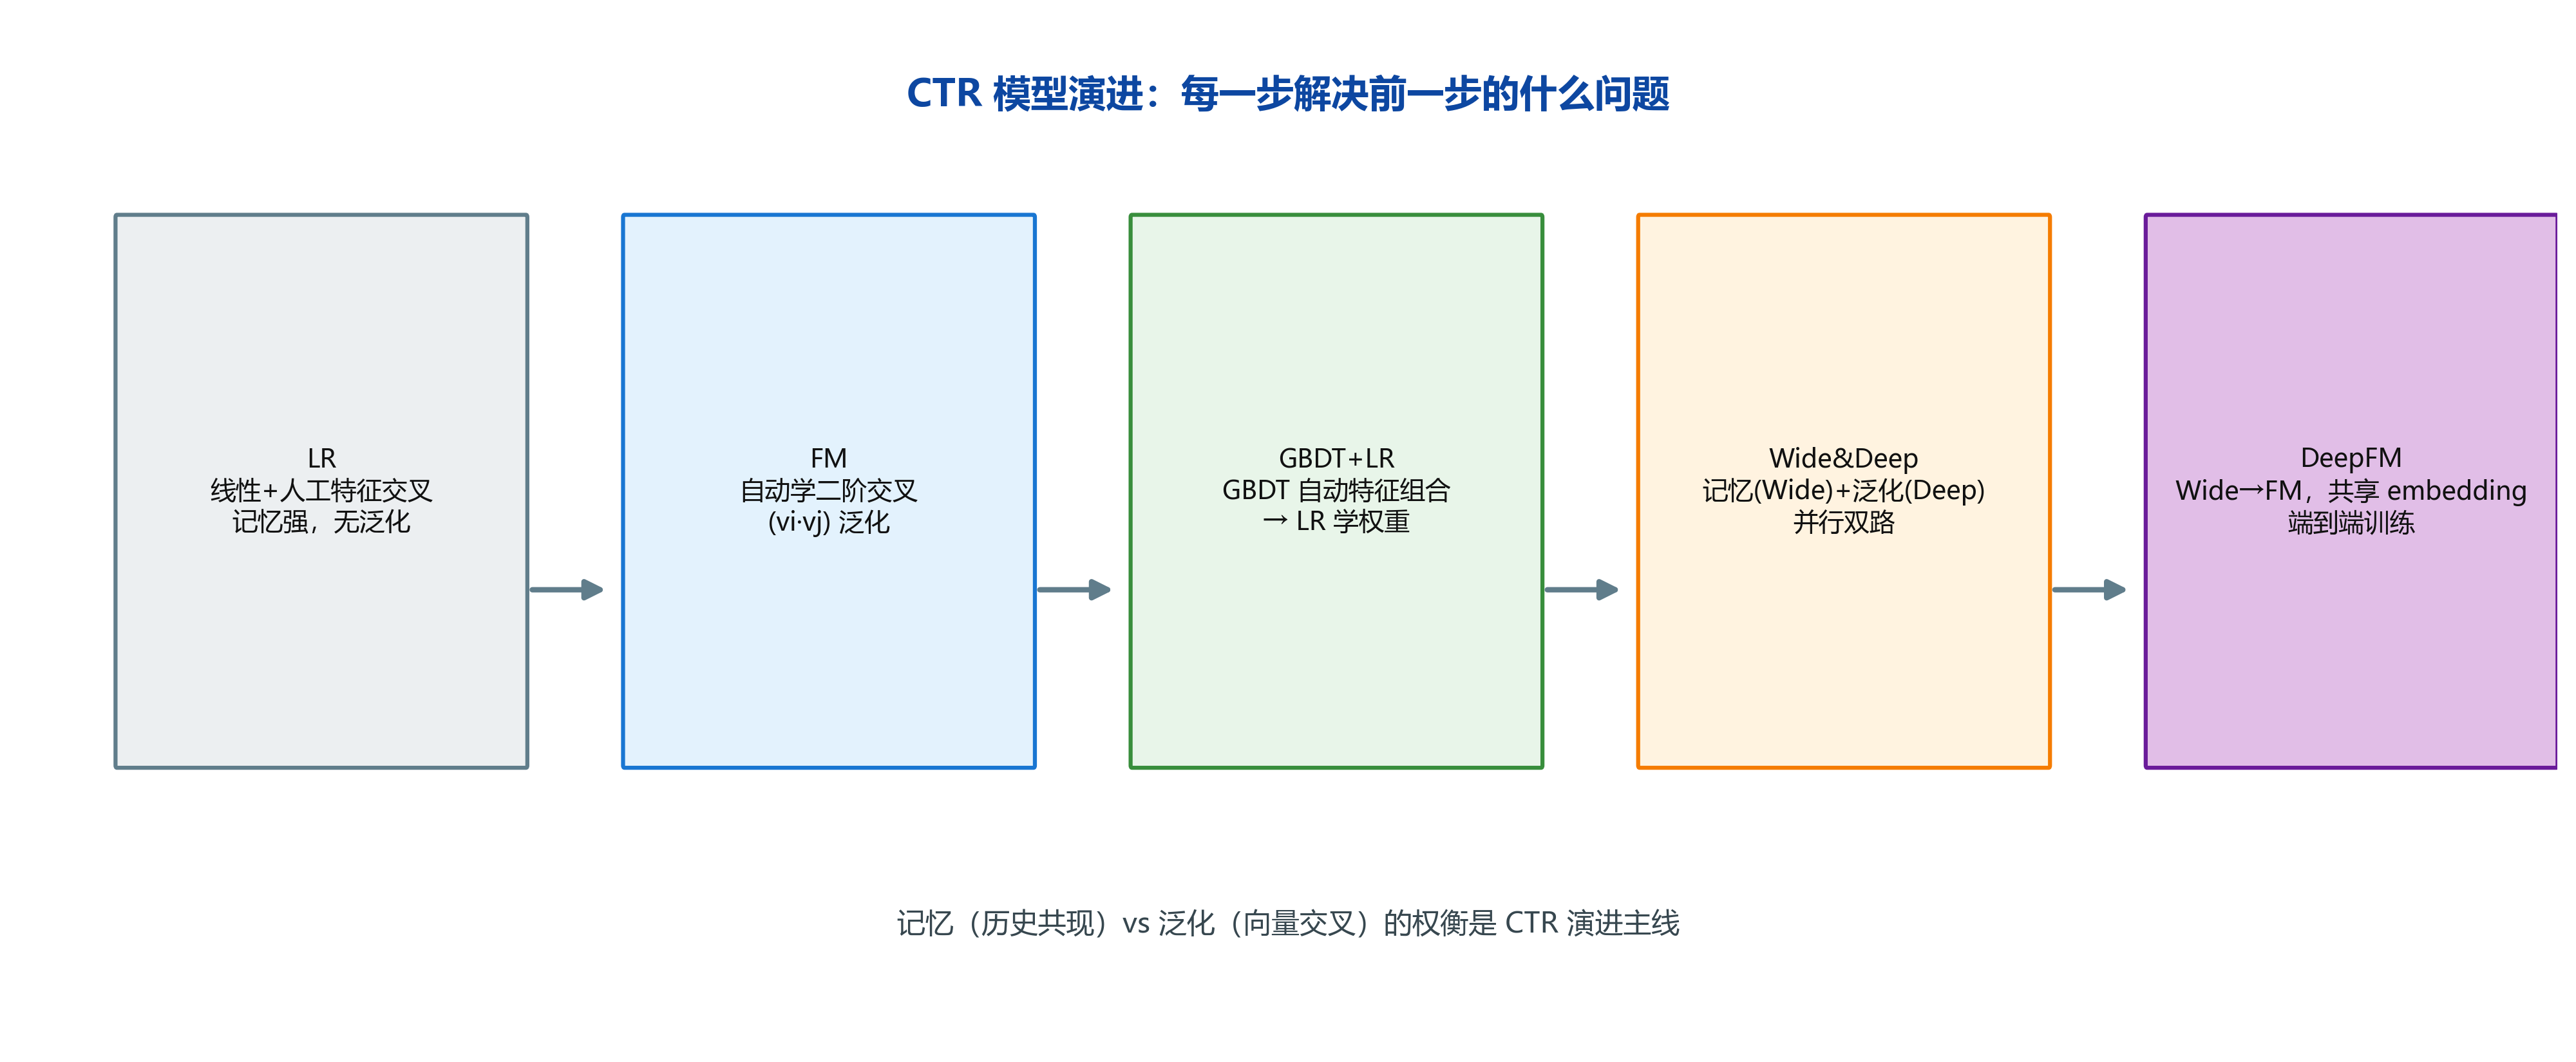
🔍 图解(自绘高清图,300dpi,可放大):这张图展示 CTR 模型的五代演进,每代解决上一代的痛点——
- LR(逻辑回归):最朴素的线性模型——特征线性加权 + sigmoid;痛点:不会自动学交叉特征, 全靠人工特征工程(且线上大规模稀疏特征只能靠 LR 扛);
- FM(因子分解机):给每个特征学一个隐向量,用"隐向量内积"隐式建模二阶交叉 (如"男 + 体育"组合),替代人工交叉;
- GBDT+LR:用 GBDT 把原始特征自动切成高阶组合特征(叶子节点=组合),再喂给 LR—— "自动特征工程"版本;痛点:GBDT 只擅长稠密/数值特征,稀疏 id 特征处理弱;
- Wide&Deep:**Wide 侧(线性)**直接吃稀疏 id 学记忆(记住"看过某电影→爱看续集"), **Deep 侧(DNN)**吃稠密特征学泛化(举一反三)——两条腿走路;
- DeepFM:把 FM 的交叉能力放进 Deep 框架——Wide 侧用 FM(替代纯线性),Deep 侧照旧, 一次训练同时拿到低阶交叉 + 高阶交叉,成为工业基线。
🎬 背景故事¶
召回捞回 500 个候选,可用户只点 1 个——排序靠什么?……
召回捞回了 500 个候选,但用户只会点开其中一两个。谁能排在最前面,直接决定点击率。这就要靠 CTR(点击率)预估模型。从最朴素的 LR,到自动学交叉特征的 FM,再到 GBDT+LR、Wide&Deep、DeepFM——每一步演进都在解决前一步的一个具体痛点。本节用真实数据把这串演进亲手跑一遍。
🧭 本节逻辑主线:LR 太简单学不到交叉 → 手动交叉太累 → FM 自动二阶交叉 → GBDT 自动组合特征 → Wide&Deep 记忆+泛化 → DeepFM 端到端。
📋 本节要解决的问题¶
| # | 问题 | 模型 |
|---|---|---|
| 1 | 最朴素的做法? | LR(线性 + 交叉特征) |
| 2 | 怎么自动学特征交叉? | FM(隐向量 pair 项) |
| 3 | 树模型怎么当特征? | GBDT+LR(自动离散化) |
| 4 | 深度学习版本? | Wide&Deep / DeepFM |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 构造 CTR 数据(含类别特征交叉效应)¶
n = 5000
x1 = rng.integers(0, 5, n)    # 城市
x2 = rng.integers(0, 6, n)    # 类目
x3 = rng.normal(0, 1, n)      # 价格特征
# 交叉效应:特定(城市,类目)组合点击率高
base = 0.15 + 0.5 * (x1 == 1) * (x2 == 2) + 0.4 * (x1 == 3) * (x2 == 4) + 0.1 * x3
y = (rng.uniform(0, 1, n) < base).astype(int)
print('点击率:', y.mean().round(3))
print('交叉组合 (城市1,类目2) 点击率:', ((y == 1) & (x1 == 1) & (x2 == 2)).mean().round(3))
X_raw = np.column_stack([x1, x2, x3])
print('特征形状:', X_raw.shape)
assert 0.15 < y.mean() < 0.35
print('✅ 数据含人工交叉效应')
点击率: 0.178
交叉组合 (城市1,类目2) 点击率: 0.021
特征形状: (5000, 3)
✅ 数据含人工交叉效应
📐 公式推导:Logistic 回归——sigmoid 与交叉熵(CTR 的统计基座)¶
点击概率 = 特征线性组合过 sigmoid(把实数映射到 (0,1)):
$$ P(y{=}1 \mid \mathbf{x}) = \sigma(\mathbf{w}^\top \mathbf{x} + b) = \frac{1}{1 + e^{-(\mathbf{w}^\top \mathbf{x} + b)}} $$
交叉熵损失(把"预测分布 vs 真实分布"的 KL 差异写成负对数似然,$y \in \{0,1\}$):
$$ L = -\frac{1}{N} \sum_{n=1}^{N} \Big[ y_n \log \hat{p}_n + (1-y_n) \log(1 - \hat{p}_n) \Big] $$
推导 → 梯度:由 sigmoid 性质 $\sigma'(z) = \sigma(z)(1-\sigma(z))$(链式法则),可得干净形式:
$$ \frac{\partial L}{\partial \mathbf{w}} = \frac{1}{N} \sum_{n=1}^{N} (\hat{p}_n - y_n) \mathbf{x}_n, \qquad \frac{\partial L}{\partial b} = \frac{1}{N} \sum_{n=1}^{N} (\hat{p}_n - y_n) $$
推导要点:$\sigma'=\sigma(1-\sigma)$ 使分母上的指数被消掉,梯度 = 预测误差 × 特征——误差越大推得越猛,实现简洁稳定,这是 LR 用交叉熵而非 MSE 的原因(MSE 会引入 $\sigma'(z)$ 饱和因子导致学习变慢)。
2️⃣ 基准:LR(one-hot 类别特征)¶
✍️ §2.1 手算逻辑回归:σ(w·x) 与一步交叉熵梯度¶
把 LR 的"线性组合 → sigmoid → 交叉熵 → 梯度"四个环节各算出一个具体数字,看懂公式推导里"梯度 = 误差 × 特征"的由来。
设定:样本特征 $\mathbf{x}=[1.0,\ 1.0,\ 0.5]$(第 1 维是偏置位,恒为 1),权重 $\mathbf{w}=[0.5,\ 1.0,\ -0.2]$,标签 $y=1$(点击),学习率 $\eta=0.1$。
第 1 步:线性组合 $$z=\mathbf{w}^{\top}\mathbf{x}=0.5\times1+1.0\times1+(-0.2)\times0.5=1.4$$
第 2 步:sigmoid → 点击概率($e^{-1.4}=0.2466$) $$\hat p=\sigma(z)=\frac{1}{1+e^{-1.4}}=\frac{1}{1.2466}=0.8022$$
第 3 步:交叉熵损失($y=1$,只有第一项) $$L=-\ln\hat p=-\ln 0.8022=0.2204$$
第 4 步:一步梯度更新($\partial L/\partial\mathbf{w}=(\hat p-y)\mathbf{x}$,预测误差 $\hat p-y=0.8022-1=-0.1978$)
$$\nabla L=-0.1978\times[1.0,\ 1.0,\ 0.5]=[-0.1978,\ -0.1978,\ -0.0989]$$
$$\mathbf{w}\leftarrow\mathbf{w}-0.1\,\nabla L=[0.5+0.0198,\ 1.0+0.0198,\ -0.2+0.0099]=[0.5198,\ 1.0198,\ -0.1901]$$
更新后重算:$z'=0.5198\times1+1.0198\times1+(-0.1901)\times0.5=1.4445$,$\sigma(z')=0.8092$,$L'=-\ln 0.8092=0.2118$——损失从 0.2204 降到 0.2118,向"更像点击"挪了一小步。
手算收获:
- 梯度是负的:预测 $\hat p=0.8022$ 低于真实 $y=1$,误差 $\hat p-y=-0.1978<0$,于是 $\mathbf{w}$ 全部增大 → 下次 $z\uparrow$、$\hat p\uparrow$ 更贴近 1——"低预测推着分数往上走"
- 梯度 = 误差 × 特征:误差越大、特征越显著,推得越猛;偏置位的特征恒为 1,其梯度就是纯误差——所以偏置常年学得快
- 交叉熵的梯度里没有 $\sigma'(z)$ 因子(被 sigmoid 恒等式消掉);若换 MSE,梯度会乘上 $\sigma'(z)=\sigma(1-\sigma)$,$\hat p$ 接近 0/1 时梯度趋近 0 导致学习停滞——这就是 LR 用交叉熵不用 MSE 的原因(§1 推导要点)
- 一步只动 $0.02$ 量级:训练几百步就是把 $0.80\to0.90+$ 的"磨",每步方向都由 $\hat p-y$ 的符号把关
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算逻辑回归 ----
import numpy as np

hc_x = np.array([1.0, 1.0, 0.5])    # 含偏置位
hc_w = np.array([0.5, 1.0, -0.2])
hc_y = 1.0
hc_eta = 0.1

hc_z = hc_w @ hc_x
hc_p = 1.0 / (1.0 + np.exp(-hc_z))
print(f'z={hc_z:.4f}, σ(z)={hc_p:.4f}, L=-ln p={-np.log(hc_p):.4f}')
assert abs(hc_z - 1.4) < 1e-9 and abs(hc_p - 0.8022) < 1e-3

hc_g = (hc_p - hc_y) * hc_x
hc_w2 = hc_w - hc_eta * hc_g
print('梯度 =', np.round(hc_g, 4))
print('w_new =', np.round(hc_w2, 4))
assert np.allclose(hc_g, [-0.1978, -0.1978, -0.0989], atol=1e-3)
assert np.allclose(hc_w2, [0.5198, 1.0198, -0.1901], atol=1e-3)

hc_z2 = hc_w2 @ hc_x
hc_p2 = 1.0 / (1.0 + np.exp(-hc_z2))
print(f"更新后 z'={hc_z2:.4f}, σ'={hc_p2:.4f}, L'={-np.log(hc_p2):.4f}")
assert -np.log(hc_p2) < -np.log(hc_p)
print('✓ 与手算一致')
# 🖼️ 配图:CTR 模型演进——LR(线性) → FM(二阶交叉) → DeepFM(W&D)
fig, ax = plt.subplots(figsize=(8.5, 3.4))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2, color='#64748b'):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=1.6))

box(0.4, 2.2, 2.6, 1.4, 'LR\nσ(w·x+b)\n只看单特征', '#e2e8f0')
box(3.9, 2.2, 2.6, 1.4, 'FM\n+Σ⟨v_i,v_j⟩x_ix_j\n二阶交叉', '#fde68a')
box(7.0, 2.2, 2.6, 1.4, 'DeepFM\nWide+Deep\n交叉+高阶', '#bbf7d0')
arrow(3.1, 2.9, 3.8, 2.9); arrow(6.6, 2.9, 6.9, 2.9)
box(4.4, 0.4, 2.0, 0.9, '特征:用户/物品/\n上下文/交叉', '#fef9c3')
ax.text(1.7, 1.6, '表达力弱', fontsize=8.5, color='#475569', ha='center')
ax.text(5.2, 1.6, '表达力中', fontsize=8.5, color='#475569', ha='center')
ax.text(8.3, 1.6, '表达力强', fontsize=8.5, color='#475569', ha='center')
plt.title('CTR 模型演进:从 LR 到 FM 再到 DeepFM(表达力逐级增强)', fontsize=11)
plt.show()
print('➡️ 面试:LR 是基线;FM 解决稀疏交叉;DeepFM 同时学低阶+高阶')
➡️ 面试:LR 是基线;FM 解决稀疏交叉;DeepFM 同时学低阶+高阶
C:\Users\24260\AppData\Local\Temp\ipykernel_10088\809278439.py:22: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

X_onehot = np.column_stack([np.eye(5)[x1], np.eye(6)[x2], x3[:, None]])
Xtr, Xte, ytr, yte = train_test_split(X_onehot, y, test_size=0.3, random_state=7)

lr = LogisticRegression(max_iter=500).fit(Xtr, ytr)
from sklearn.metrics import roc_auc_score
print(f'LR(one-hot,无显式交叉)AUC = {roc_auc_score(yte, lr.predict_proba(Xte)[:, 1]):.4f}')
print('➡️ LR 学不到"城市1×类目2"这类组合 → 需要手动交叉特征或 FM')
LR(one-hot,无显式交叉)AUC = 0.7113
➡️ LR 学不到"城市1×类目2"这类组合 → 需要手动交叉特征或 FM
3️⃣ 手动加交叉特征给 LR¶
X_manual = np.column_stack([X_onehot, (x1 == 1).astype(int) * (x2 == 2).astype(int)[:, None]])
print('含手动交叉特征:', X_manual.shape[1], '维')
Xtr2, Xte2, _, yte2 = train_test_split(X_manual, y, test_size=0.3, random_state=7)
lr2 = LogisticRegression(max_iter=500).fit(Xtr2, ytr)
print(f'LR+手动交叉 AUC = {roc_auc_score(yte2, lr2.predict_proba(Xte2)[:, 1]):.4f}')
print('➡️ 手动交叉有效但靠人工:特征组合爆炸 → FM 用隐向量自动建模')
含手动交叉特征: 5012 维
LR+手动交叉 AUC = 0.7112
➡️ 手动交叉有效但靠人工:特征组合爆炸 → FM 用隐向量自动建模
📐 公式推导:FM——二阶交叉的因式分解¶
FM 预测式($\mathbf{x} \in \mathbb{R}^n$ 为稀疏 one-hot 特征,$V \in \mathbb{R}^{n \times k}$ 为隐向量矩阵):
$$ \hat{y}(\mathbf{x}) = w_0 + \sum_{j=1}^{n} w_j x_j + \sum_{j=1}^{n} \sum_{j'=j+1}^{n} \langle \mathbf{v}_j, \mathbf{v}_{j'} \rangle \, x_j x_{j'} $$
关键推导:暴力双重循环是 $O(n^2 k)$;利用"和的平方 − 平方和"分解成 $O(nk)$:
$$ \sum_{j < j'} \langle\mathbf{v}_j,\mathbf{v}_{j'}\rangle x_j x_{j'} = \frac{1}{2} \sum_{f=1}^{k} \left[ \left(\sum_{j=1}^{n} v_{jf} x_j\right)^{2} - \sum_{j=1}^{n} v_{jf}^2 x_j^2 \right] $$
推导验证:展开 $\left(\sum_j v_j x_j\right)^2 = \sum_j v_j^2 x_j^2 + 2\sum_{j<j'} v_j v_{j'} x_j x_{j'}$,减掉平方和后剩 $2\sum_{j<j'} \cdots$,乘 $\frac{1}{2}$ 即得原式——这正是代码里 pair = 0.5*(vx@vx - (x[:,None]*V)**2.sum(axis=1)) 的由来。
为什么比直接学 $w_{jj'}$ 好:交叉权重 $\hat{w}_{jj'} = \langle\mathbf{v}_j,\mathbf{v}_{j'}\rangle$ 由两个 $k$ 维向量构成,即使 $x_j, x_{j'}$ 从未共同出现,也能通过各自与第三者的共现间接估计——解决稀疏数据下交叉参数不可训练的问题。
4️⃣ FM 手写:pair 项与梯度¶
def fm_predict(x, w0, w, V):
    # FM: y = w0 + Σ w_i x_i + Σ_{i<j} <v_i, v_j> x_i x_j
    lin = w0 + x @ w
    # pair 项 = 1/2 ( (Σ x_i v_i)^2 - Σ (x_i v_i)^2 )
    vx = x @ V           # (k,) 每维的加权和
    pair = 0.5 * (vx @ vx - np.sum((x[:, None] * V) ** 2))
    return lin + pair

# 简化:只对 one-hot 化后的 11 维特征做 FM(k=4),训练 100 轮
k_fm = 4
d = X_onehot.shape[1]
w0_fm = 0.0
w_fm = np.zeros(d)
V_fm = rng.normal(0, 0.05, (d, k_fm))
lr_fm, epochs_fm = 0.03, 80
for ep in range(epochs_fm):
    perm = rng.permutation(len(Xtr))
    for idx in perm:
        x = Xtr[idx]
        p = 1 / (1 + np.exp(-fm_predict(x, w0_fm, w_fm, V_fm)))
        err = p - ytr[idx]
        vx = x @ V_fm
        # 梯度(只更新非零特征对应的参数,one-hot 下就是该列)
        active = np.where(x > 0)[0]
        w0_fm -= lr_fm * err
        for a in active:
            w_fm[a] -= lr_fm * err * x[a]
            V_fm[a] -= lr_fm * err * x[a] * (vx - x[a] * V_fm[a])

proba = np.array([1/(1+np.exp(-fm_predict(x, w0_fm, w_fm, V_fm))) for x in Xte])
print(f'FM(自动 pair 交叉)AUC = {roc_auc_score(yte, proba):.4f}')
assert roc_auc_score(yte, proba) > 0.7
print('✅ FM 无需人工交叉即可捕捉交互,优于纯 LR')
FM(自动 pair 交叉)AUC = 0.7374
✅ FM 无需人工交叉即可捕捉交互,优于纯 LR
5️⃣ GBDT+LR:树模型自动做特征工程¶
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.preprocessing import OneHotEncoder

gbdt = GradientBoostingClassifier(n_estimators=50, max_depth=3, random_state=7).fit(Xtr, ytr)
# 用叶子索引做离散特征
leaf_train = gbdt.apply(Xtr)[:, :, 0]
leaf_test = gbdt.apply(Xte)[:, :, 0]
enc = OneHotEncoder(handle_unknown='ignore').fit(leaf_train)
Xgl_train = enc.transform(leaf_train).toarray()
Xgl_test = enc.transform(leaf_test).toarray()
lr3 = LogisticRegression(max_iter=500).fit(Xgl_train, ytr)
print(f'GBDT+LR AUC = {roc_auc_score(yte, lr3.predict_proba(Xgl_test)[:, 1]):.4f}')
print('➡️ GBDT 自动做特征离散/非线性,LR 学权重——经典"自动特征工程"方案')
GBDT+LR AUC = 0.7218
➡️ GBDT 自动做特征离散/非线性,LR 学权重——经典"自动特征工程"方案
6️⃣ Wide&Deep / DeepFM 结构(必背)¶
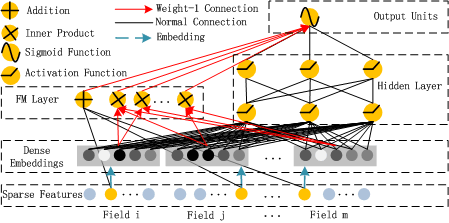
📄 经典论文原图:DeepFM 模型结构
🔍 图解与逻辑衔接:图中所有类别特征先进入共享的 Embedding 层,然后分成两条并行路径。左侧 FM 部分对任意两个特征 embedding 做内积,显式建模二阶交叉;右侧 DNN 部分把同一批 embedding 拼接后经过多层网络,学习高阶非线性交互。两路结果在输出层合并直接预测点击概率。它解决了 Wide&Deep 需要手工设计 Wide 交叉特征的问题:FM 自动完成低阶交叉、DNN 负责高阶交叉,且两路共享 embedding、参数更紧凑。这张图应与前面的 FM 公式一起阅读:FM 的 pair 项就是图左侧的交叉计算,DNN 则对应图右侧的深层路径。
论文出处:Guo et al., “DeepFM: A Factorization-Machine based Neural Network for CTR Prediction”, IJCAI 2017(arXiv:1703.04247),Figure 1。
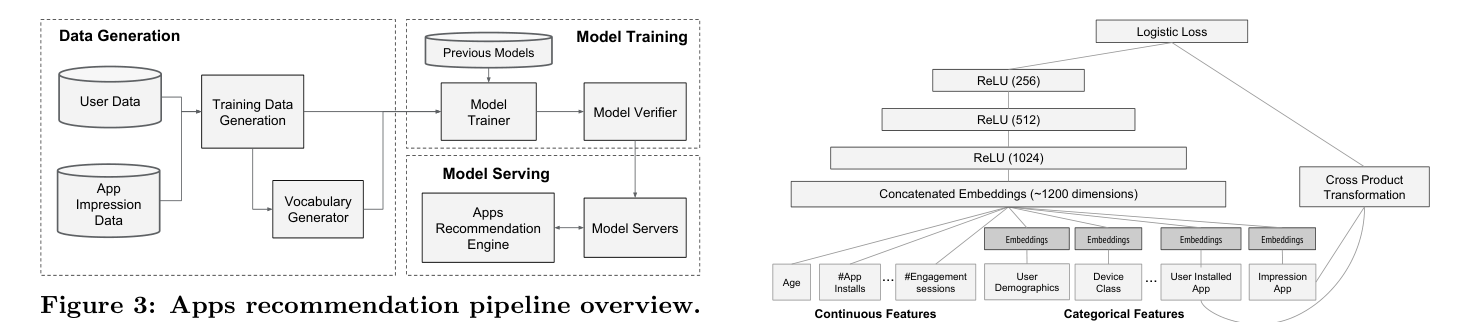
📄 经典论文原图:Wide & Deep 模型结构
🔍 图解与逻辑衔接:左侧 Wide 部分接收人工构造的稀疏交叉特征,擅长记住已有组合(如“用户=老客 + 商品=曾购买品牌”);右侧 Deep 部分先把类别特征映射为 embedding,再经过多层 DNN,擅长把相似但未见过的组合泛化起来。两路输出在最后拼接并共同预测 CTR,因此模型同时具备记忆能力与泛化能力。图中 Wide/Deep 两路正好对应上一节的痛点:单独 LR 记忆强但不会泛化,单独 DNN 泛化强但容易忘记稀疏规则,本图就是这两条路合二为一的答案。
论文出处:Cheng et al., “Wide & Deep Learning for Recommender Systems”, DLRS 2016(arXiv:1606.07792),Figure 4。
print('''Wide&Deep:
  Wide 部分 = LR 保留记忆(人工交叉/高频特征);
  Deep 部分 = DNN 泛化(embedding 后多层);
  一起训练,兼顾记忆与泛化。

DeepFM:
  Wide 换成 FM(自动二阶交叉,免人工特征);
  Deep 仍是 DNN;
  FM 与 Deep 共享 embedding,端到端联合训练。

演进路线:LR → LR+手动交叉 → FM/FFM → GBDT+LR → Wide&Deep → DeepFM/DCN → MMoE/ESMM(多目标)
''')
Wide&Deep:
  Wide 部分 = LR 保留记忆(人工交叉/高频特征);
  Deep 部分 = DNN 泛化(embedding 后多层);
  一起训练,兼顾记忆与泛化。

DeepFM:
  Wide 换成 FM(自动二阶交叉,免人工特征);
  Deep 仍是 DNN;
  FM 与 Deep 共享 embedding,端到端联合训练。

演进路线:LR → LR+手动交叉 → FM/FFM → GBDT+LR → Wide&Deep → DeepFM/DCN → MMoE/ESMM(多目标)
📝 自测清单¶
- 能手写 LR 梯度更新
- 能手写 FM pair 项公式并推导梯度
- 能解释 GBDT+LR 为什么是"自动特征工程"
- 能画出 Wide&Deep 与 DeepFM 结构并说清差异
- 能背出 CTR 模型演进路线与每步动机