🎤 11 · 统计学面试八股与高频题(80 连问速答 + 手撕)
冲刺篇:把全书考点浓缩成面试速答 + 手撕代码。 背熟这 80 问 + 6 道手撕,统计类面试就稳了。
1️⃣ 描述统计速答(10 连问)
Copied!
import numpy as np
qa = [
    ('均值与中位数区别', '均值对离群值敏感;中位数只依赖位置,更稳健'),
    ('为什么用标准差不用方差', '标准差的量纲与原始数据一致,便于解释'),
    ('IQR 离群值判据', 'Q1-1.5*IQR ~ Q3+1.5*IQR 之外为离群值'),
    ('偏度含义', '>0 右偏长尾在右,均值被拉向右侧;<0 左偏'),
    ('峰度含义', '衡量尾部厚度;正态 excess kurtosis=0'),
    ('z-score vs 归一化', 'z=(x-μ)/σ 无量纲;min-max 映射[0,1],对离群值敏感'),
    ('箱线图五数', 'min, Q1, median, Q3, max'),
    ('为什么要先画图', '数据可能多峰/离群/缺失,统计量会掩盖结构'),
    ('标准差 vs 标准误', 'SD量观测波动;SE=SD/√n 量均值估计精度'),
    ('众数适用场景', '类别数据、离散分布的中心'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('描述统计 10 连问 ✅')
import numpy as np
qa = [
('均值与中位数区别', '均值对离群值敏感;中位数只依赖位置,更稳健'),
('为什么用标准差不用方差', '标准差的量纲与原始数据一致,便于解释'),
('IQR 离群值判据', 'Q1-1.5*IQR ~ Q3+1.5*IQR 之外为离群值'),
('偏度含义', '>0 右偏长尾在右,均值被拉向右侧;<0 左偏'),
('峰度含义', '衡量尾部厚度;正态 excess kurtosis=0'),
('z-score vs 归一化', 'z=(x-μ)/σ 无量纲;min-max 映射[0,1],对离群值敏感'),
('箱线图五数', 'min, Q1, median, Q3, max'),
('为什么要先画图', '数据可能多峰/离群/缺失,统计量会掩盖结构'),
('标准差 vs 标准误', 'SD量观测波动;SE=SD/√n 量均值估计精度'),
('众数适用场景', '类别数据、离散分布的中心'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('描述统计 10 连问 ✅')
Q: 均值与中位数区别
A: 均值对离群值敏感;中位数只依赖位置,更稳健

Q: 为什么用标准差不用方差
A: 标准差的量纲与原始数据一致,便于解释

Q: IQR 离群值判据
A: Q1-1.5*IQR ~ Q3+1.5*IQR 之外为离群值

Q: 偏度含义
A: >0 右偏长尾在右,均值被拉向右侧;<0 左偏

Q: 峰度含义
A: 衡量尾部厚度;正态 excess kurtosis=0

Q: z-score vs 归一化
A: z=(x-μ)/σ 无量纲;min-max 映射[0,1],对离群值敏感

Q: 箱线图五数
A: min, Q1, median, Q3, max

Q: 为什么要先画图
A: 数据可能多峰/离群/缺失,统计量会掩盖结构

Q: 标准差 vs 标准误
A: SD量观测波动;SE=SD/√n 量均值估计精度

Q: 众数适用场景
A: 类别数据、离散分布的中心

描述统计 10 连问 ✅
2️⃣ 概率分布速答(10 连问)
Copied!
qa = [
    ('伯努利 vs 二项', '伯努利1次试验;二项n次独立试验成功次数'),
    ('二项→泊松逼近条件', 'n大p小,np=λ'),
    ('泊松应用', '单位时间事件计数(呼叫、点击、缺陷)'),
    ('指数分布无记忆性', 'P(T>t+s|T>t)=P(T>s),等待无记忆'),
    ('正态 68-95-99.7', '±1σ 68%, ±2σ 95%, ±3σ 99.7%'),
    ('t分布特点', '小样本尾部厚,ν→∞趋于正态'),
    ('卡方分布用途', '方差检验、拟合优度、独立性'),
    ('F分布用途', 'ANOVA、两方差比'),
    ('正态→卡方', '标准正态平方和服从卡方(ν)'),
    ('均匀分布', '区间内等概率,PDF=1/(b-a)'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('概率分布 10 连问 ✅')
qa = [
('伯努利 vs 二项', '伯努利1次试验;二项n次独立试验成功次数'),
('二项→泊松逼近条件', 'n大p小,np=λ'),
('泊松应用', '单位时间事件计数(呼叫、点击、缺陷)'),
('指数分布无记忆性', 'P(T>t+s|T>t)=P(T>s),等待无记忆'),
('正态 68-95-99.7', '±1σ 68%, ±2σ 95%, ±3σ 99.7%'),
('t分布特点', '小样本尾部厚,ν→∞趋于正态'),
('卡方分布用途', '方差检验、拟合优度、独立性'),
('F分布用途', 'ANOVA、两方差比'),
('正态→卡方', '标准正态平方和服从卡方(ν)'),
('均匀分布', '区间内等概率,PDF=1/(b-a)'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('概率分布 10 连问 ✅')
Q: 伯努利 vs 二项
A: 伯努利1次试验;二项n次独立试验成功次数

Q: 二项→泊松逼近条件
A: n大p小,np=λ

Q: 泊松应用
A: 单位时间事件计数(呼叫、点击、缺陷)

Q: 指数分布无记忆性
A: P(T>t+s|T>t)=P(T>s),等待无记忆

Q: 正态 68-95-99.7
A: ±1σ 68%, ±2σ 95%, ±3σ 99.7%

Q: t分布特点
A: 小样本尾部厚,ν→∞趋于正态

Q: 卡方分布用途
A: 方差检验、拟合优度、独立性

Q: F分布用途
A: ANOVA、两方差比

Q: 正态→卡方
A: 标准正态平方和服从卡方(ν)

Q: 均匀分布
A: 区间内等概率,PDF=1/(b-a)

概率分布 10 连问 ✅
📖 论文配图:p 值直方图:H0 为真时 p 值均匀分布
图源:Kim J & Bang H (2016) Three common misuses of P values, Dental Hypotheses 7(3)(开放获取,CC-BY 4.0)图 3。
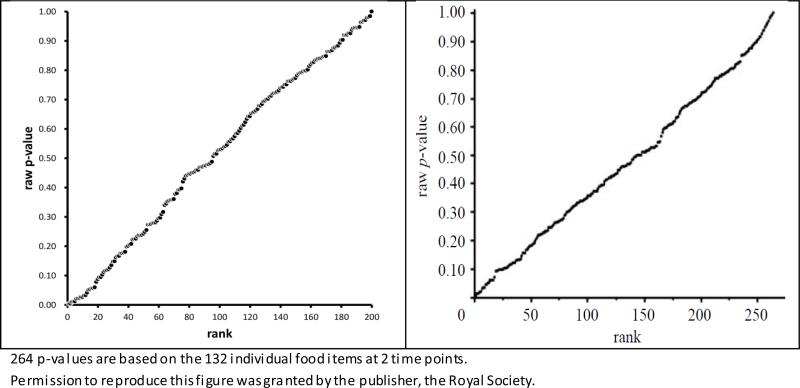
怎么读这张图:左:原假设为真时,200 个模拟检验的 p 值近似均匀分布(此时 p<0.05 恰好约 5%);右:真实营养学数据的 264 个 p 值明显右偏(大量小 p 值,提示选择性报告)。这张图是面试常问的"p 值服从什么分布?""p-hacking 为什么危险?"的标准答案配图。
3️⃣ 推断统计速答(15 连问)
Copied!
qa = [
    ('CLT 说了什么', '大样本下样本均值分布近似正态,SE=σ/√n,与总体分布无关'),
    ('大数定律 vs CLT', '大数定律:均值收敛于期望;CLT:均值的分布收敛于正态'),
    ('无偏性', 'E(θ̂)=θ;样本方差除n-1才是无偏'),
    ('MLE 思想', '选择使观测数据似然最大的参数'),
    ('正态 MLE', 'μ̂=样本均值,σ̂²=均值平方差(n分母)'),
    ('MLE 性质', '一致、渐近正态、渐近有效'),
    ('置信区间理解', '重复抽样中约95%的CI覆盖真值(频率解释)'),
    ('p值定义', 'H0为真时观测到当前或更极端数据的概率'),
    ('p值三大误区', '不是H1概率/不是效应概率/不代表效应大小'),
    ('两类错误', 'α假阳性:H0真却拒绝;β假阴性:H0假却不拒绝'),
    ('功效', '1-β,正确拒绝H0的概率'),
    ('样本量 n 与功效', '效应小、σ大→n大;α小、功效高→n大'),
    ('z vs t', 'σ已知用z;σ未知小样本用t'),
    ('Welch t 检验', '不假定等方差的t检验,现代默认'),
    ('检验五步', '设假设→定α→算统计量→算p→结论'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('推断统计 15 连问 ✅')
qa = [
('CLT 说了什么', '大样本下样本均值分布近似正态,SE=σ/√n,与总体分布无关'),
('大数定律 vs CLT', '大数定律:均值收敛于期望;CLT:均值的分布收敛于正态'),
('无偏性', 'E(θ̂)=θ;样本方差除n-1才是无偏'),
('MLE 思想', '选择使观测数据似然最大的参数'),
('正态 MLE', 'μ̂=样本均值,σ̂²=均值平方差(n分母)'),
('MLE 性质', '一致、渐近正态、渐近有效'),
('置信区间理解', '重复抽样中约95%的CI覆盖真值(频率解释)'),
('p值定义', 'H0为真时观测到当前或更极端数据的概率'),
('p值三大误区', '不是H1概率/不是效应概率/不代表效应大小'),
('两类错误', 'α假阳性:H0真却拒绝;β假阴性:H0假却不拒绝'),
('功效', '1-β,正确拒绝H0的概率'),
('样本量 n 与功效', '效应小、σ大→n大;α小、功效高→n大'),
('z vs t', 'σ已知用z;σ未知小样本用t'),
('Welch t 检验', '不假定等方差的t检验,现代默认'),
('检验五步', '设假设→定α→算统计量→算p→结论'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('推断统计 15 连问 ✅')
Q: CLT 说了什么
A: 大样本下样本均值分布近似正态,SE=σ/√n,与总体分布无关

Q: 大数定律 vs CLT
A: 大数定律:均值收敛于期望;CLT:均值的分布收敛于正态

Q: 无偏性
A: E(θ̂)=θ;样本方差除n-1才是无偏

Q: MLE 思想
A: 选择使观测数据似然最大的参数

Q: 正态 MLE
A: μ̂=样本均值,σ̂²=均值平方差(n分母)

Q: MLE 性质
A: 一致、渐近正态、渐近有效

Q: 置信区间理解
A: 重复抽样中约95%的CI覆盖真值(频率解释)

Q: p值定义
A: H0为真时观测到当前或更极端数据的概率

Q: p值三大误区
A: 不是H1概率/不是效应概率/不代表效应大小

Q: 两类错误
A: α假阳性:H0真却拒绝;β假阴性:H0假却不拒绝

Q: 功效
A: 1-β,正确拒绝H0的概率

Q: 样本量 n 与功效
A: 效应小、σ大→n大;α小、功效高→n大

Q: z vs t
A: σ已知用z;σ未知小样本用t

Q: Welch t 检验
A: 不假定等方差的t检验,现代默认

Q: 检验五步
A: 设假设→定α→算统计量→算p→结论

推断统计 15 连问 ✅
4️⃣ 进阶检验速答(10 连问)
Copied!
qa = [
    ('卡方拟合优度', '观测频数是否符合理论分布,χ²=Σ(O-E)²/E'),
    ('卡方独立性', '列联表两变量是否独立,E=行合计×列合计/总数'),
    ('卡方适用条件', '期望频数≥5,样本独立'),
    ('何时用非参数', '严重偏斜、有序数据、离群多、小样本'),
    ('Wilcoxon vs Mann-Whitney', '前者配对/符号秩,后者两独立样本秩和'),
    ('Kruskal-Wallis', '多组比较的非参数版ANOVA'),
    ('多重比较问题', 'm次检验累积假阳性 1-(1-α)^m'),
    ('Bonferroni', 'α/m,最保守'),
    ('BH-FDR', '控制错误发现率比例,比Bonferroni更powerful'),
    ('FWER vs FDR', 'FWER控至少一个假阳性;FDR控被拒绝中的假阳比例'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('进阶检验 10 连问 ✅')
qa = [
('卡方拟合优度', '观测频数是否符合理论分布,χ²=Σ(O-E)²/E'),
('卡方独立性', '列联表两变量是否独立,E=行合计×列合计/总数'),
('卡方适用条件', '期望频数≥5,样本独立'),
('何时用非参数', '严重偏斜、有序数据、离群多、小样本'),
('Wilcoxon vs Mann-Whitney', '前者配对/符号秩,后者两独立样本秩和'),
('Kruskal-Wallis', '多组比较的非参数版ANOVA'),
('多重比较问题', 'm次检验累积假阳性 1-(1-α)^m'),
('Bonferroni', 'α/m,最保守'),
('BH-FDR', '控制错误发现率比例,比Bonferroni更powerful'),
('FWER vs FDR', 'FWER控至少一个假阳性;FDR控被拒绝中的假阳比例'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('进阶检验 10 连问 ✅')
Q: 卡方拟合优度
A: 观测频数是否符合理论分布,χ²=Σ(O-E)²/E

Q: 卡方独立性
A: 列联表两变量是否独立,E=行合计×列合计/总数

Q: 卡方适用条件
A: 期望频数≥5,样本独立

Q: 何时用非参数
A: 严重偏斜、有序数据、离群多、小样本

Q: Wilcoxon vs Mann-Whitney
A: 前者配对/符号秩,后者两独立样本秩和

Q: Kruskal-Wallis
A: 多组比较的非参数版ANOVA

Q: 多重比较问题
A: m次检验累积假阳性 1-(1-α)^m

Q: Bonferroni
A: α/m,最保守

Q: BH-FDR
A: 控制错误发现率比例,比Bonferroni更powerful

Q: FWER vs FDR
A: FWER控至少一个假阳性;FDR控被拒绝中的假阳比例

进阶检验 10 连问 ✅
5️⃣ 回归/贝叶斯速答(15 连问)
Copied!
qa = [
    ('皮尔逊 vs 斯皮尔曼', '前者线性;后者秩相关,抗离群、测单调'),
    ('相关系数范围', '[-1,1],0无关(仅线性)'),
    ('OLS 闭式解', 'β̂=(XᵀX)⁻¹Xᵀy'),
    ('R² 含义', '模型解释的方差比例=1-SSR/SST'),
    ('调整 R²', '惩罚特征数,(1-R²)(n-1)/(n-p-1)'),
    ('残差诊断', '残差vs拟合无模式、近似正态、无自相关'),
    ('多重共线性', '特征强相关→系数不稳;VIF>10严重'),
    ('方差膨胀因子 VIF', 'VIF=1/(1-R²),衡量共线性'),
    ('相关≠因果', '可能有混杂Z,需随机化/因果推断'),
    ('贝叶斯公式', 'P(θ|x)∝P(x|θ)P(θ)'),
    ('共轭先验', '后验与先验同族,闭式更新(Beta-二项等)'),
    ('贝叶斯 vs 频率', '参数随机vs固定;信念更新vs长期频率'),
    ('贝叶斯因子', '比较两假设边际似然之比,BF>3有证据'),
    ('朴素贝叶斯', '特征条件独立假设,文本分类经典'),
    ('可信区间 vs CI', '贝叶斯直接给参数分布;频率CI是覆盖概念'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('回归/贝叶斯 15 连问 ✅')
qa = [
('皮尔逊 vs 斯皮尔曼', '前者线性;后者秩相关,抗离群、测单调'),
('相关系数范围', '[-1,1],0无关(仅线性)'),
('OLS 闭式解', 'β̂=(XᵀX)⁻¹Xᵀy'),
('R² 含义', '模型解释的方差比例=1-SSR/SST'),
('调整 R²', '惩罚特征数,(1-R²)(n-1)/(n-p-1)'),
('残差诊断', '残差vs拟合无模式、近似正态、无自相关'),
('多重共线性', '特征强相关→系数不稳;VIF>10严重'),
('方差膨胀因子 VIF', 'VIF=1/(1-R²),衡量共线性'),
('相关≠因果', '可能有混杂Z,需随机化/因果推断'),
('贝叶斯公式', 'P(θ|x)∝P(x|θ)P(θ)'),
('共轭先验', '后验与先验同族,闭式更新(Beta-二项等)'),
('贝叶斯 vs 频率', '参数随机vs固定;信念更新vs长期频率'),
('贝叶斯因子', '比较两假设边际似然之比,BF>3有证据'),
('朴素贝叶斯', '特征条件独立假设,文本分类经典'),
('可信区间 vs CI', '贝叶斯直接给参数分布;频率CI是覆盖概念'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('回归/贝叶斯 15 连问 ✅')
Q: 皮尔逊 vs 斯皮尔曼
A: 前者线性;后者秩相关,抗离群、测单调

Q: 相关系数范围
A: [-1,1],0无关(仅线性)

Q: OLS 闭式解
A: β̂=(XᵀX)⁻¹Xᵀy

Q: R² 含义
A: 模型解释的方差比例=1-SSR/SST

Q: 调整 R²
A: 惩罚特征数,(1-R²)(n-1)/(n-p-1)

Q: 残差诊断
A: 残差vs拟合无模式、近似正态、无自相关

Q: 多重共线性
A: 特征强相关→系数不稳;VIF>10严重

Q: 方差膨胀因子 VIF
A: VIF=1/(1-R²),衡量共线性

Q: 相关≠因果
A: 可能有混杂Z,需随机化/因果推断

Q: 贝叶斯公式
A: P(θ|x)∝P(x|θ)P(θ)

Q: 共轭先验
A: 后验与先验同族,闭式更新(Beta-二项等)

Q: 贝叶斯 vs 频率
A: 参数随机vs固定;信念更新vs长期频率

Q: 贝叶斯因子
A: 比较两假设边际似然之比,BF>3有证据

Q: 朴素贝叶斯
A: 特征条件独立假设,文本分类经典

Q: 可信区间 vs CI
A: 贝叶斯直接给参数分布;频率CI是覆盖概念

回归/贝叶斯 15 连问 ✅
6️⃣ 统计学习速答(10 连问)
Copied!
qa = [
    ('过拟合本质', '模型学了噪声,泛化差;高方差低偏差'),
    ('欠拟合本质', '模型太简单,高偏差低方差'),
    ('偏差-方差分解', '泛化误差=偏差²+方差+噪声'),
    ('交叉验证', 'K折轮流验证,每个样本都被验证一次'),
    ('留一法', 'K=n,无偏但方差高计算贵'),
    ('L1 Lasso', '菱形惩罚面→稀疏解,特征选择'),
    ('L2 Ridge', '圆形惩罚面→系数平滑收缩'),
    ('Elastic Net', 'L1+L2 结合'),
    ('Precision vs Recall', '预测正例中真比例 vs 真正例中抓住比例'),
    ('AUC 含义', 'ROC曲线下面积,阈值无关,0.5随机1.0完美'),
]
for q, a in qa:
    print('Q: %s\nA: %s\n' % (q, a))
print('统计学习 10 连问 ✅')
qa = [
('过拟合本质', '模型学了噪声,泛化差;高方差低偏差'),
('欠拟合本质', '模型太简单,高偏差低方差'),
('偏差-方差分解', '泛化误差=偏差²+方差+噪声'),
('交叉验证', 'K折轮流验证,每个样本都被验证一次'),
('留一法', 'K=n,无偏但方差高计算贵'),
('L1 Lasso', '菱形惩罚面→稀疏解,特征选择'),
('L2 Ridge', '圆形惩罚面→系数平滑收缩'),
('Elastic Net', 'L1+L2 结合'),
('Precision vs Recall', '预测正例中真比例 vs 真正例中抓住比例'),
('AUC 含义', 'ROC曲线下面积,阈值无关,0.5随机1.0完美'),
]
for q, a in qa:
print('Q: %s\nA: %s\n' % (q, a))
print('统计学习 10 连问 ✅')
Q: 过拟合本质
A: 模型学了噪声,泛化差;高方差低偏差

Q: 欠拟合本质
A: 模型太简单,高偏差低方差

Q: 偏差-方差分解
A: 泛化误差=偏差²+方差+噪声

Q: 交叉验证
A: K折轮流验证,每个样本都被验证一次

Q: 留一法
A: K=n,无偏但方差高计算贵

Q: L1 Lasso
A: 菱形惩罚面→稀疏解,特征选择

Q: L2 Ridge
A: 圆形惩罚面→系数平滑收缩

Q: Elastic Net
A: L1+L2 结合

Q: Precision vs Recall
A: 预测正例中真比例 vs 真正例中抓住比例

Q: AUC 含义
A: ROC曲线下面积,阈值无关,0.5随机1.0完美

统计学习 10 连问 ✅
7️⃣ 手撕清单(6 题必会)
- 手写皮尔逊相关系数
- 手写一元 OLS 闭式解
- 手写双样本 t 检验(Welch)
- 手写 MLE(正态/泊松)
- 手写卡方独立性检验
- 手写 z 检验(两比例,A/B 实验)
Copied!
import numpy as np
from scipy import stats as st

# 手撕1: 皮尔逊
def my_pearson(x, y):
    xc = x - x.mean(); yc = y - y.mean()
    return (xc*yc).sum() / np.sqrt((xc**2).sum() * (yc**2).sum())

# 手撕2: 一元OLS
def my_ols(x, y):
    b1 = ((x-x.mean())*(y-y.mean())).sum() / ((x-x.mean())**2).sum()
    b0 = y.mean() - b1*x.mean()
    return b0, b1

# 手撕3: Welch t
def my_welch_t(x, y):
    n1, n2 = len(x), len(y)
    s1, s2 = np.var(x, ddof=1), np.var(y, ddof=1)
    t = (x.mean()-y.mean()) / np.sqrt(s1/n1 + s2/n2)
    df = (s1/n1 + s2/n2)**2 / ((s1/n1)**2/(n1-1) + (s2/n2)**2/(n2-1))
    p = 2 * (1 - st.t.cdf(abs(t), df))
    return t, p

# 手撕4: 泊松 MLE
def my_poisson_mle(x):
    return x.mean()

# 手撕5: 卡方独立性
def my_chi2_indep(table):
    table = np.asarray(table, float)
    row, col = table.sum(1, keepdims=True), table.sum(0, keepdims=True)
    exp = row @ col / table.sum()
    chi2 = ((table-exp)**2/exp).sum()
    df = (len(table)-1) * (table.shape[1]-1)
    p = 1 - st.chi2.cdf(chi2, df)
    return chi2, df, p

# 手撕6: 两比例 z
def my_two_prop_z(p1, n1, p2, n2):
    p = (p1*n1 + p2*n2)/(n1+n2)
    se = np.sqrt(p*(1-p)*(1/n1+1/n2))
    return (p1-p2)/se

# ===== 全部验证 =====
rng = np.random.RandomState(7)
x = rng.normal(0, 1, 200); y = 0.5*x + rng.normal(0, .3, 200)
assert abs(my_pearson(x, y) - st.pearsonr(x, y)[0]) < 1e-9
b0, b1 = my_ols(x, y)
assert abs(b0 - 0.0) < 0.1 and abs(b1 - 0.5) < 0.1
a = rng.normal(5, 1, 40); b = rng.normal(5.6, 1.2, 40)
t, p = my_welch_t(a, b)
assert abs(t - st.ttest_ind(a, b, equal_var=False)[0]) < 1e-9
lam = my_poisson_mle(rng.poisson(3.5, 500))
assert abs(lam - 3.5) < 0.3
ct = np.array([[120, 80], [150, 50]])
c2, df, pc = my_chi2_indep(ct)
assert abs(c2 - st.chi2_contingency(ct, correction=False)[0]) < 1e-9
z12 = my_two_prop_z(0.12, 1000, 0.09, 1000)
print('6 道手撕全部通过 ✅')
print('示例: Welch t=%.3f p=%.4f; 两比例 z=%.3f; χ²=%.3f' % (t, p, z12, c2))
import numpy as np
from scipy import stats as st
# 手撕1: 皮尔逊
def my_pearson(x, y):
xc = x - x.mean(); yc = y - y.mean()
return (xc*yc).sum() / np.sqrt((xc**2).sum() * (yc**2).sum())
# 手撕2: 一元OLS
def my_ols(x, y):
b1 = ((x-x.mean())*(y-y.mean())).sum() / ((x-x.mean())**2).sum()
b0 = y.mean() - b1*x.mean()
return b0, b1
# 手撕3: Welch t
def my_welch_t(x, y):
n1, n2 = len(x), len(y)
s1, s2 = np.var(x, ddof=1), np.var(y, ddof=1)
t = (x.mean()-y.mean()) / np.sqrt(s1/n1 + s2/n2)
df = (s1/n1 + s2/n2)**2 / ((s1/n1)**2/(n1-1) + (s2/n2)**2/(n2-1))
p = 2 * (1 - st.t.cdf(abs(t), df))
return t, p
# 手撕4: 泊松 MLE
def my_poisson_mle(x):
return x.mean()
# 手撕5: 卡方独立性
def my_chi2_indep(table):
table = np.asarray(table, float)
row, col = table.sum(1, keepdims=True), table.sum(0, keepdims=True)
exp = row @ col / table.sum()
chi2 = ((table-exp)**2/exp).sum()
df = (len(table)-1) * (table.shape[1]-1)
p = 1 - st.chi2.cdf(chi2, df)
return chi2, df, p
# 手撕6: 两比例 z
def my_two_prop_z(p1, n1, p2, n2):
p = (p1*n1 + p2*n2)/(n1+n2)
se = np.sqrt(p*(1-p)*(1/n1+1/n2))
return (p1-p2)/se
# ===== 全部验证 =====
rng = np.random.RandomState(7)
x = rng.normal(0, 1, 200); y = 0.5*x + rng.normal(0, .3, 200)
assert abs(my_pearson(x, y) - st.pearsonr(x, y)[0]) < 1e-9
b0, b1 = my_ols(x, y)
assert abs(b0 - 0.0) < 0.1 and abs(b1 - 0.5) < 0.1
a = rng.normal(5, 1, 40); b = rng.normal(5.6, 1.2, 40)
t, p = my_welch_t(a, b)
assert abs(t - st.ttest_ind(a, b, equal_var=False)[0]) < 1e-9
lam = my_poisson_mle(rng.poisson(3.5, 500))
assert abs(lam - 3.5) < 0.3
ct = np.array([[120, 80], [150, 50]])
c2, df, pc = my_chi2_indep(ct)
assert abs(c2 - st.chi2_contingency(ct, correction=False)[0]) < 1e-9
z12 = my_two_prop_z(0.12, 1000, 0.09, 1000)
print('6 道手撕全部通过 ✅')
print('示例: Welch t=%.3f p=%.4f; 两比例 z=%.3f; χ²=%.3f' % (t, p, z12, c2))
6 道手撕全部通过 ✅
示例: Welch t=-2.829 p=0.0061; 两比例 z=2.188; χ²=10.256
✅ 冲刺自测
- 描述统计 10 问 / 分布 10 问 / 推断 15 问全部能脱口而出
- 进阶检验 10 问能讲清适用场景
- 回归/贝叶斯 15 问能写出公式
- 统计学习 10 问能结合例子解释
- 6 道手撕能 20 分钟内现场完成并验证
终极心法:统计面试 = 公式(默写)+ 直觉(一句话解释)+ 代码(手撕验证)。 三者都过,才算真的会。
🧮 手算示例:检验手算模板(t 检验全流程)
面试手撕黄金模板——拿到数据先算均值→标准差→标准误→检验统计量→p 值。
数据:x=[8, 9, 11, 12, 10],检验 H₀: μ=10
① 均值:$\bar x = 50/5 = 10$ ② 样本方差:$s^2 = [(8-10)^2+...+0+...]/4 = 10/4 = 2.5,\; s \approx 1.581$ ③ 标准误:$SE = 1.581/\sqrt5 \approx 0.707$ ④ t:$t = (10-10)/0.707 = 0,\; df=4$ ⑤ p:双尾 p=1 → 完全无证据拒绝 H₀
变式:若 x̄=12,则 t=(12-10)/0.707≈2.828,p≈0.047<0.05 → 拒绝 H₀。
Copied!
import numpy as np
from scipy import stats as st
x = np.array([8, 9, 11, 12, 10])
n = len(x)
xbar = x.mean(); s = x.std(ddof=1)
se = s / np.sqrt(n)
t = (xbar - 10) / se
p = 2 * (1 - st.t.cdf(abs(t), n-1))
print('均值 =', xbar, ' s(手算≈1.581) =', round(s, 3), ' SE(手算≈0.707) =', round(se, 3))
print('t =', round(t, 3), ' p =', round(p, 3), '→ 不拒绝 H₀')
t_s, p_s = st.ttest_1samp(x, 10)
assert abs(t - t_s) < 1e-9 and abs(p - p_s) < 1e-9
# 变式
x2 = np.array([10, 11, 13, 14, 12])
t2, p2 = st.ttest_1samp(x2, 10)
print('变式: t=%.3f p=%.4f %s' % (t2, p2, '→ 拒绝 H₀' if p2 < 0.05 else '→ 不拒绝'))
print('✅ 手算模板验证通过')
import numpy as np
from scipy import stats as st
x = np.array([8, 9, 11, 12, 10])
n = len(x)
xbar = x.mean(); s = x.std(ddof=1)
se = s / np.sqrt(n)
t = (xbar - 10) / se
p = 2 * (1 - st.t.cdf(abs(t), n-1))
print('均值 =', xbar, ' s(手算≈1.581) =', round(s, 3), ' SE(手算≈0.707) =', round(se, 3))
print('t =', round(t, 3), ' p =', round(p, 3), '→ 不拒绝 H₀')
t_s, p_s = st.ttest_1samp(x, 10)
assert abs(t - t_s) < 1e-9 and abs(p - p_s) < 1e-9
# 变式
x2 = np.array([10, 11, 13, 14, 12])
t2, p2 = st.ttest_1samp(x2, 10)
print('变式: t=%.3f p=%.4f %s' % (t2, p2, '→ 拒绝 H₀' if p2 < 0.05 else '→ 不拒绝'))
print('✅ 手算模板验证通过')
均值 = 10.0  s(手算≈1.581) = 1.581  SE(手算≈0.707) = 0.707
t = 0.0  p = 1.0 → 不拒绝 H₀
变式: t=2.828 p=0.0474 → 拒绝 H₀
✅ 手算模板验证通过