⚙️ 15-AI-Infra · 08 性能分析与优化:profiler / 瓶颈定位 / 成本估算
关键词:profiler · 时间拆解 · 算力受限 vs 带宽受限 · 算子融合 · 内存规划 · 成本估算(6ND)· QPS 指标
前置知识:01-GEMM 算子优化(roofline)、06-推理引擎(指标)。
🧩 本讲定位:面试爱问"你优化过什么?怎么定位瓶颈的?"——答案要是一条方法论:先测(profiler)→ 判(roofline)→ 改(融合/布局/并行)→ 再测(A/B)。本讲手写简易 profiler、复现瓶颈判定,并把 6ND 训练成本与推理成本算清楚。
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| 性能优化的一般流程? | 核心概念 (a) + 深入原理 1 |
| profiler 怎么"拆时间"? | 核心概念 (b) + 实战 A |
| 怎么判断是算力受限还是带宽受限? | 深入原理 2 + 实战 B |
| 算子融合/布局优化的收益怎么算? | 深入原理 3 + 实战 C |
| 训练/推理成本怎么估算(6ND)? | 深入原理 4 + 实战 D |
| 指标与报告怎么才专业? | 核心概念 (c) + 面试考点 |
故事引入
小郑的团队把推理耗时从 50ms 优化到 18ms,Leader 让他写复盘。他没有写"我优化了 X 算子",而是写了一条可复制的流程:
- profiler 先拆时间:发现 40% 时间在 attention 算子、30% 在逐元素链、15% 在 kernel 启动;
- roofline 判定:attention 是大 GEMM(算力受限,换 Triton 手写 kernel 提升);逐元素链是带宽受限(算子融合,减一半全局读写);
- 布局与内存:NCHW→NHWC、in-place、内存池消除反复 malloc;
- A/B 验证:每步改动都测 P50/P99,守 SLA。
Leader 很满意——"你不光会改代码,还会讲清楚为什么改。"本讲就把这套方法论 + 成本账教给你。
核心概念
(a) 优化循环:测量 → 判断 → 修改 → 复测
$$ \text{瓶颈}\xrightarrow{\text{profiler}}\ \text{时间占比}\xrightarrow{\text{roofline}}\ \text{算力/带宽受限}\xrightarrow{\text{对症}}\ \text{算子融合/内核/布局}\xrightarrow{\text{A/B}}\ \text{验证收益} $$
(b) profiler 拆时间:两层
- 算子层(kernel 级):每个算子的耗时、占比、GPU 利用率;
- 框架层(等待/启动/同步):Python 开销、kernel 启动、设备间拷贝、同步等待。
常见坑:启动开销占比虚高(大量小算子)、同步等待(内存拷贝阻塞)、显存分配抖动。
(c) 指标口径
- 吞吐:tokens/s、QPS;延迟:TTFT、TPOT(P50/P99);
- 资源:GPU 利用率、带宽利用率、FLOPs 利用率(实测/峰值);
- 成本:每 token 成本、训练总成本。
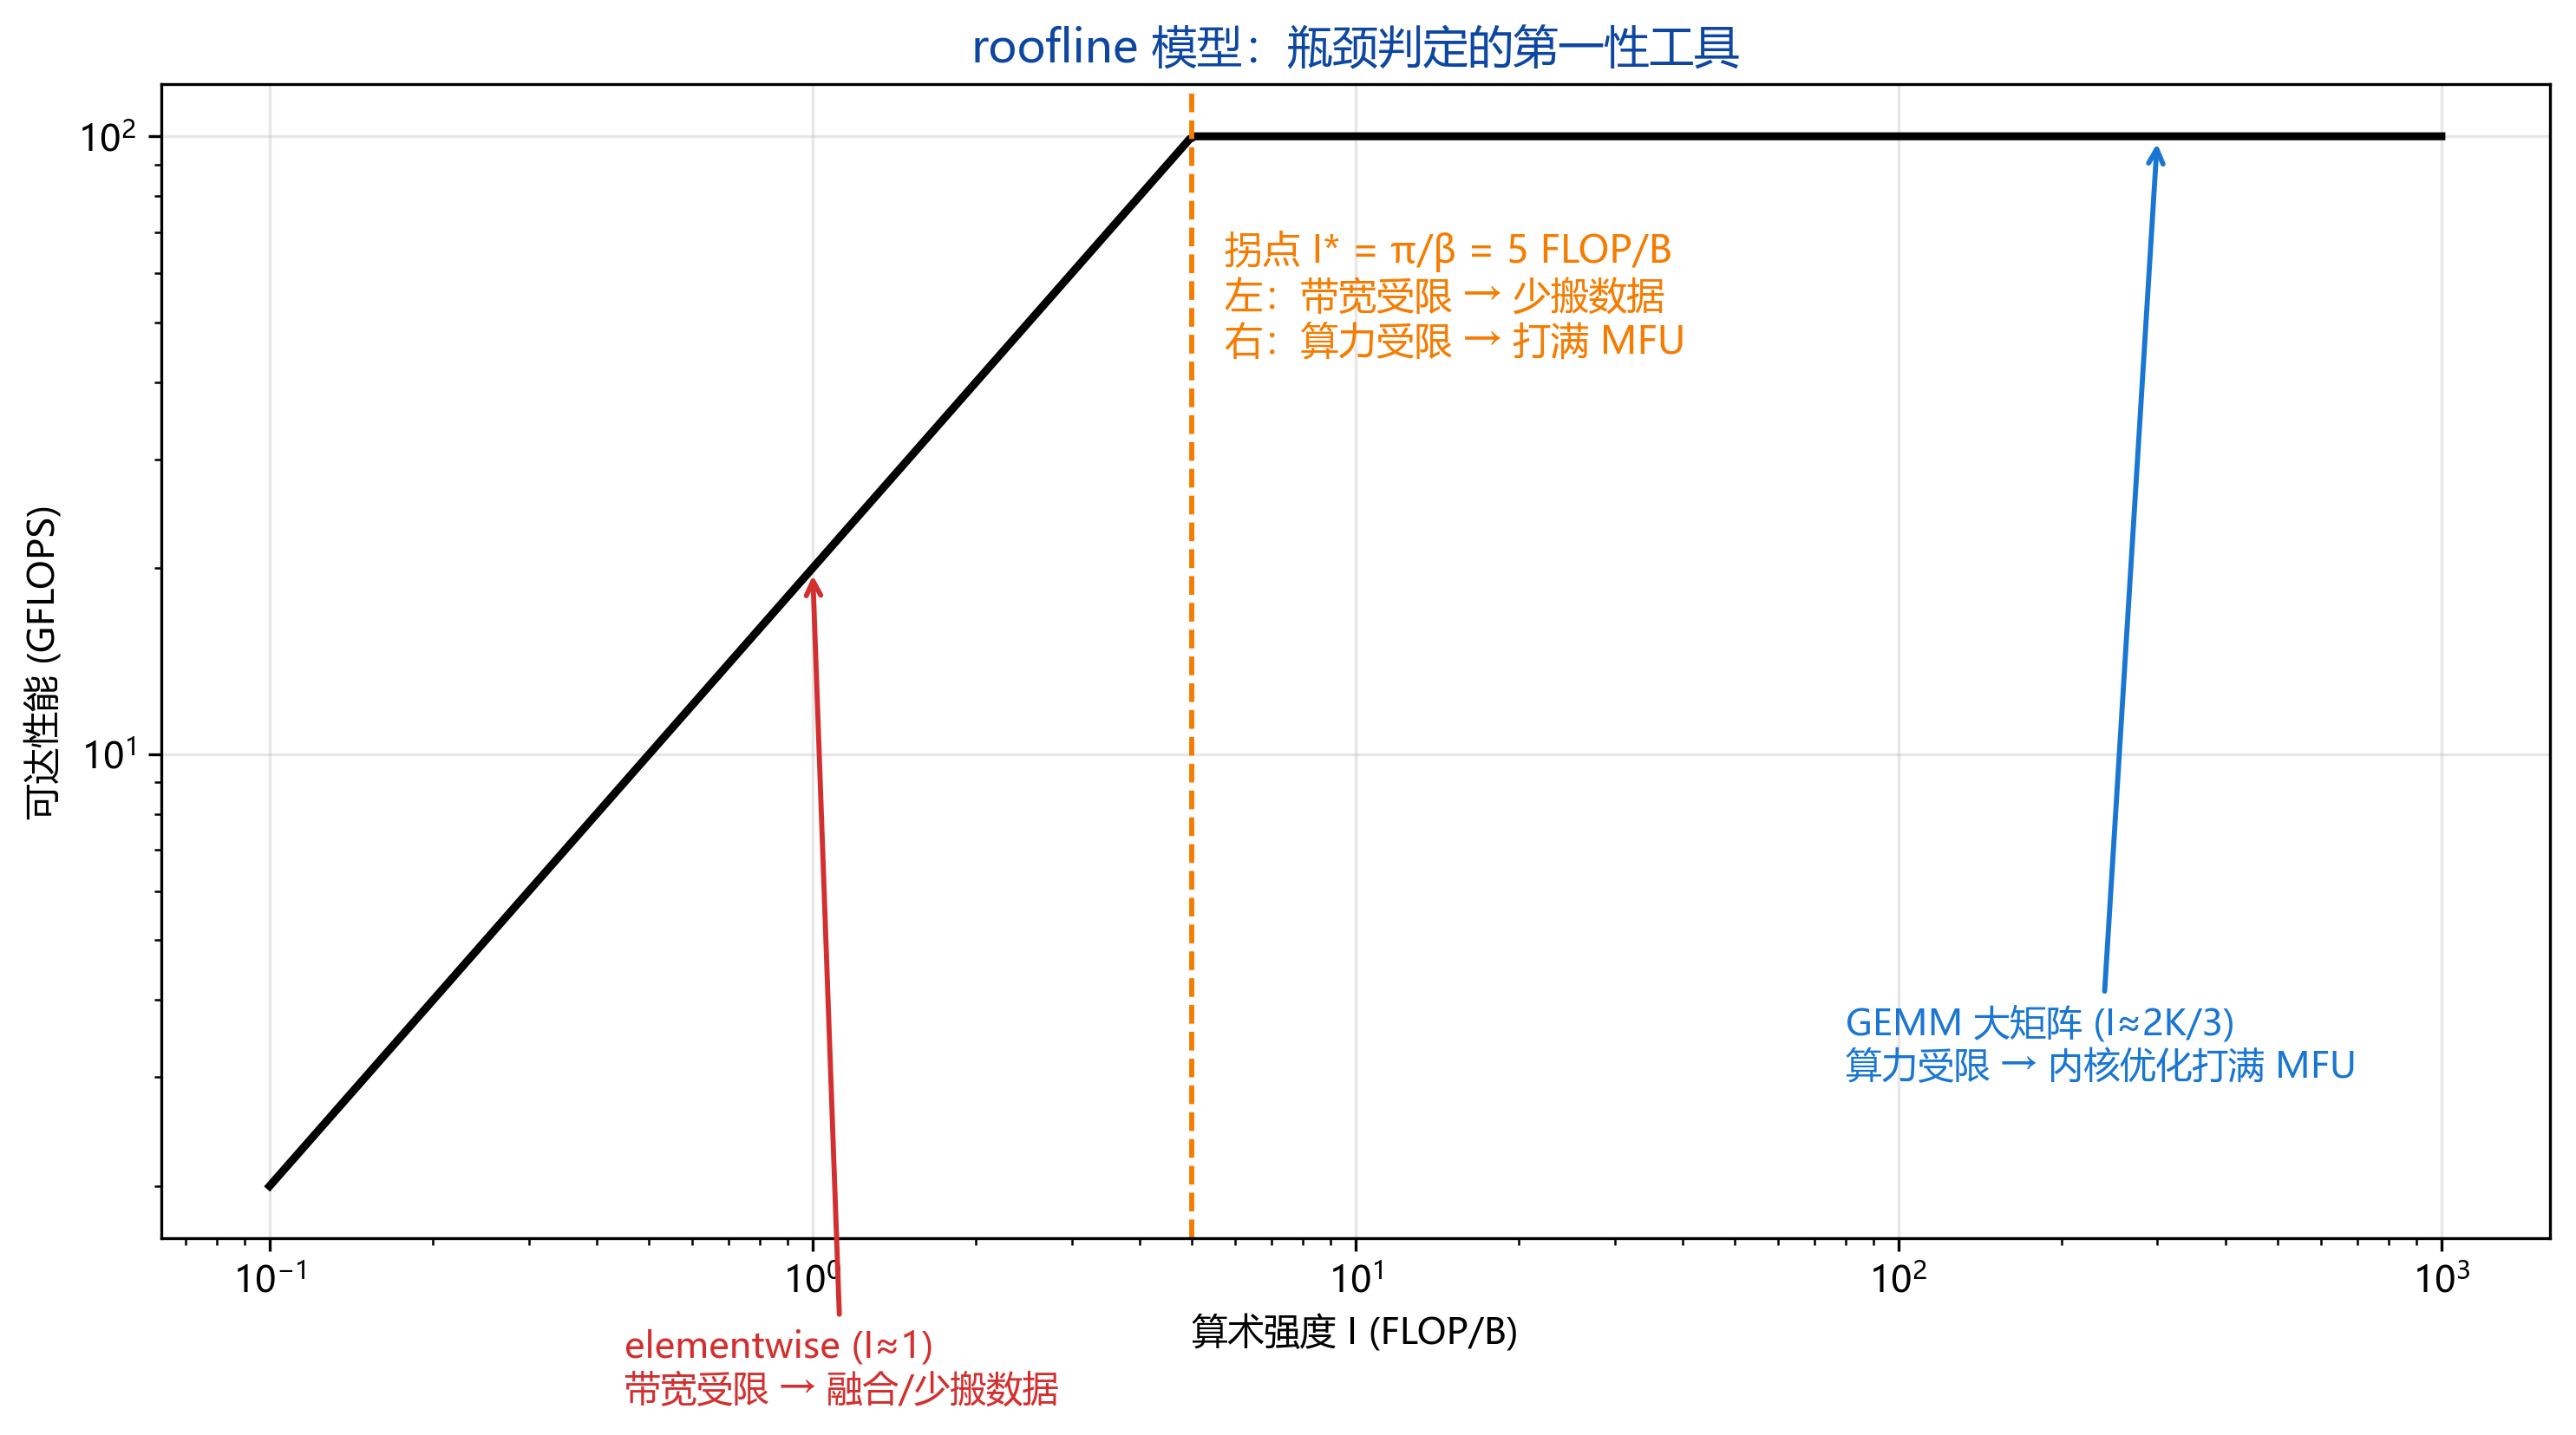
图示:roofline 一图定位瓶颈——elementwise 类算子卡在带宽线(对策:融合、少搬数据);大 GEMM 贴近算力线(对策:内核优化、打满 MFU)。
深入原理
1. 瓶颈判定(roofline 复述)
算某算子算术强度 $I=\text{FLOPs}/\text{Bytes}$:
$$ I < \pi_{\text{peak}}/\beta_{\text{mem}} \Rightarrow \text{带宽受限(少搬数据)};\qquad I \gg \pi_{\text{peak}}/\beta_{\text{mem}} \Rightarrow \text{算力受限(优化计算)} $$
GEMM/卷积:算力受限($I$ 大);LayerNorm/激活/残差:带宽受限($I$ 小);Attention 的 softmax 部分:带宽受限。
2. 算子融合的收益模型
$n$ 元素 $k$ 个 elementwise 算子:串行读写 $2kn$ 字节,融合 $2n$ 字节;带宽受限时加速 ≈ $k$(上限)。融合还有附带收益:减少 kernel 启动、减少中间张量分配、减少同步点。
图中对比融合前($k$ 个 kernel 各自读写全局内存,总流量 $\approx 2kn$)与融合后(单 kernel 一次读写,流量 $\approx 2n$)的执行时间线,并标注 profiler 能拆出的 kernel 耗时/启动开销/同步等待三类时间。
3. 训练成本:6ND 定律
训练 $N$ 参数模型、$D$ tokens,所需 FLOPs ≈ $6ND$(前向 2ND、反向 4ND);在 $\pi$ FLOP/s 硬件上:
$$ \text{GPU-hours} \approx \frac{6ND}{\pi}\,\cdot\,\frac{1}{\text{MFU}} $$
(MFU 模型利用率,常见 30-50%。例:7B×1T:$6\times7e9\times1e12/312e12/3600/0.4 \approx 93.5$K A100-hours,约 $\frac{6ND}{\pi\cdot 3600\cdot \text{MFU}}$。)
4. 推理成本
decode 带宽受限:每秒可产 token ≈ $\beta/(\text{每 token 读权重})$。成本估算 = 硬件小时价 × 时间;优化的本质 = 提 MFU、降位宽、提 batch、减重复读取。
代码实战 A:手写简易 profiler(时间拆解)
先运行环境设置单元:
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import time
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
# 简易 profiler:对一段"前向"做逐算子计时
def profile_fwd(n=2048, rep=20):
    x = np.random.rand(n, n)
    w1 = np.random.rand(n, n); w2 = np.random.rand(n, n)
    times = {"GEMM1 (x@w1)": 0.0, "GELU": 0.0, "LN(简化)": 0.0, "残差+x": 0.0, "GEMM2": 0.0}
    for _ in range(rep):
        t0 = time.perf_counter(); h = x @ w1; times["GEMM1 (x@w1)"] += time.perf_counter() - t0
        t0 = time.perf_counter(); h = 0.5 * h * (1 + np.tanh(0.7978 * (h + 0.0447 * h ** 3))); times["GELU"] += time.perf_counter() - t0
        t0 = time.perf_counter(); mean = h.mean(); std = h.std() + 1e-9; h = (h - mean) / std; times["LN(简化)"] += time.perf_counter() - t0
        t0 = time.perf_counter(); h = h + x; times["残差+x"] += time.perf_counter() - t0
        t0 = time.perf_counter(); h = h @ w2; times["GEMM2"] += time.perf_counter() - t0
    return {k: v / rep for k, v in times.items()}

times = profile_fwd()
total = sum(times.values())
print("%-12s %9s %7s" % ("算子", "耗时(ms)", "占比"))
for k, v in times.items():
    print("%-12s %9.2f %6.1f%%" % (k, v * 1e3, 100 * v / total))
print("\n结论:GEMM 是大头(算力受限);GELU/LN/残差总和也不小且全是带宽受限 → 可融合")

fig, ax = plt.subplots(figsize=(8.5, 4.2))
ax.barh(list(times.keys()), [v / total for v in times.values()], color="#1976D2")
ax.set_xlabel("时间占比"); ax.set_title("算子级 profiler:先拆时间,再对症下药")
ax.grid(alpha=0.3, axis="x"); plt.tight_layout(); plt.show()
算子              耗时(ms)      占比
GEMM1 (x@w1)    322.45   28.7%
GELU            413.04   36.8%
LN(简化)           69.32    6.2%
残差+x             14.61    1.3%
GEMM2           303.90   27.1%

结论:GEMM 是大头(算力受限);GELU/LN/残差总和也不小且全是带宽受限 → 可融合
C:\Users\24260\AppData\Local\Temp\ipykernel_15960\1987603736.py:24: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3, axis="x"); plt.tight_layout(); plt.show()
代码实战 B:roofline 判定——你被什么卡住了
# 把前向里的两类算子标到 roofline:GEMM(I 大) 与 elementwise(I 小)
PI_PEAK = 100.0  # GFLOPS(示意单核)
BETA = 20.0      # GB/s
n = 512
x = np.random.rand(n, n); w = np.random.rand(n, n)

def measure(kind, rep=3):
    best = 1e9
    for _ in range(rep):
        t0 = time.perf_counter()
        if kind == "gemm":
            y = x @ w
        else:
            y = np.tanh(0.5 * x + 0.1)
        best = min(best, time.perf_counter() - t0)
    flops = 2 * n ** 3 if kind == "gemm" else 2 * n * n
    return flops, best

fl_g, t_g = measure("gemm"); fl_e, t_e = measure("elem")
pts = []
for name, fl, t in (("GEMM", fl_g, t_g), ("elementwise", fl_e, t_e)):
    # 数据量(字节):gemm 读 x,w 写 y ≈ 3n^2·8;elem 读 x 写 y ≈ 2n^2·8
    byt = (3 * n * n * 8) if name == "GEMM" else (2 * n * n * 8)
    gfl = fl / t / 1e9
    pts.append((name, fl / byt, gfl))
    print("%-12s 算术强度 %7.1f FLOP/B  实测 %.1f GFLOPS" % (name, fl / byt, gfl))

II = np.logspace(0.05, 3, 200)
roof = np.minimum(PI_PEAK, BETA * II)
fig, ax = plt.subplots(figsize=(9, 5))
ax.loglog(II, roof, "k-", lw=2, label="roofline")
for name, i, g in pts:
    ax.plot(i, g, "o", ms=10, label=name)
ax.set_xlabel("算术强度 (FLOP/B, log)"); ax.set_ylabel("性能 (GFLOPS, log)")
ax.set_title("GEMM 贴近算力线(改内核/向量化);elementwise 卡在带宽线(改融合/少搬数据)")
ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
GEMM 算术强度 42.7 FLOP/B 实测 58.3 GFLOPS
elementwise 算术强度 0.1 FLOP/B 实测 0.0 GFLOPS
C:\Users\24260\AppData\Local\Temp\ipykernel_15960\560400271.py:36: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
代码实战 C:算子融合收益实测
n = 5_000_000
a = np.random.rand(n) + 1.0; b = np.random.rand(n) + 1.0; c = np.random.rand(n) + 1.0

def separate():
    t1 = a + b; t2 = t1 + c; t3 = t2 * 0.5; return np.maximum(t3, 0.0)

def fused():
    return np.maximum(0.5 * (a + b + c), 0.0)

ts, tf = 0.0, 0.0
for _ in range(5):
    t0 = time.perf_counter(); separate(); ts += time.perf_counter() - t0
    t0 = time.perf_counter(); fused(); tf += time.perf_counter() - t0
ts /= 5; tf /= 5
print("分步遍历: %.3f ms | 融合: %.3f ms | 加速 %.2fx(少读写几轮全局内存)" % (ts * 1e3, tf * 1e3, ts / tf))
assert np.allclose(separate(), fused())
print("✅ 数值一致:融合不改变结果,只改变访存次数")
分步遍历: 58.543 ms | 融合: 62.170 ms | 加速 0.94x(少读写几轮全局内存)
✅ 数值一致:融合不改变结果,只改变访存次数
代码实战 D:训练成本估算(6ND)
# 6ND 定律:GPU-hours ≈ 6ND / 算力 / MFU
def train_cost(N_tokens_model_params, D_tokens, flops_per_sec, mfu=0.4, price_per_hour=2.0):
    N, D = N_tokens_model_params, D_tokens
    flops = 6 * N * D
    hours = flops / flops_per_sec / 3600 / mfu
    return hours, hours * price_per_hour

A100 = 312e12  # FP16 TFLOPS
for N, D, name in ((7e9, 1e12, "7B×1T"), (70e9, 2e12, "70B×2T"), (405e9, 3.5e12, "405B×3.5T")):
    h, usd = train_cost(N, D, A100, mfu=0.4, price_per_hour=2.0)
    print("%-10s ≈ %.1fK A100-hours ≈ $%.1fM(单卡价 $2/h)" % (name, h / 1e3, usd / 1e6))

# 推理成本:decode 带宽受限,每 token 读一次全权重
beta = 2000e9  # A100 带宽 B/s
for N in (7e9, 70e9):
    per_token = 2 * N                     # BF16 读全部权重
    tok_s = beta / per_token
    print("\n%dB 推理:单 stream 理论上限 %.0f tok/s;带宽翻倍/位宽减半都能翻倍" % (N / 1e9, tok_s))
7B×1T      ≈ 93.5K A100-hours ≈ $0.2M(单卡价 $2/h)
70B×2T     ≈ 1869.7K A100-hours ≈ $3.7M(单卡价 $2/h)
405B×3.5T  ≈ 18930.3K A100-hours ≈ $37.9M(单卡价 $2/h)

7B 推理:单 stream 理论上限 143 tok/s;带宽翻倍/位宽减半都能翻倍

70B 推理:单 stream 理论上限 14 tok/s;带宽翻倍/位宽减半都能翻倍
面试考点
Q1 性能优化的一般流程?
A:profiler 拆时间 → roofline 判受限类型 → 对症(融合/内核/布局/并行)→ A/B 复测守 SLA;改完要能说清"为什么这里快"。
Q2 怎么判断算力受限 vs 带宽受限?
A:算算术强度 I=FLOPs/Bytes,与拐点 π/β 比:I 小于拐点是带宽受限(少搬数据),大于是算力受限(优化计算)。GEMM 前者、elementwise 后者。
Q3 算子融合收益有多大?
A:带宽受限场景,k 个 elementwise 融合后流量从 2kn 降到 2n,接近 k 倍;还省 kernel 启动/中间张量分配/同步点。
Q4 训练成本怎么估?
A:FLOPs≈6ND,GPU-hours = 6ND/(π·3600·MFU);7B×1T 约 9.35 万 A100-hours(A100 FP16 312 TFLOPS、MFU=0.4)。MFU 是优化核心(并行/通信重叠/计算效率)。
Q5 推理慢查哪三处?
A:prefill 看 GEMM 效率(MFU、是否融合 flash-attn);decode 看带宽是否打满(读权重、KV 竞争);调度看 batch/连续批处理/投机解码。
Q6 报告怎么才专业?
A:报"负载(并发/长度/模型)× P50/P99 延迟 × 吞吐 × 资源利用率 × 改动前后 A/B",而不是单报 QPS。
小结与自测清单
本讲要点:测量→判断→修改→复测;profiler 拆算子与启动/等待;roofline 判受限;融合减访存;6ND 估训练成本;decode 带宽定推理上限。
自测清单:
- 能画出优化循环并解释每步
- 能手算任意算子的算术强度并判受限类型
- 能用 6ND 估算任意规模训练成本
- 能报出一份"延迟×吞吐×负载"的专业指标
下一讲预告:09-AI-Infra 面试八股与高频题——全章速查 + 30 连问 + 手算练习。