09. CNN 经典架构与 PyTorch 实现(🔴 面试必考)
承接 08 篇:从「卷积为什么适合图像」走向「经典架构怎么堆出来的」。 本节用 torch 从零实现关键部件:手写卷积(对照 nn.Conv2d)、感受野计算、 LeNet/VGG/ResBlock、1×1 卷积、Depthwise Separable、EfficientNet 缩放公式。
与
02-卷积神经网络CNN.ipynb互补:02 篇讲卷积的训练视角(im2col/反向/TinyCNN), 本篇讲结构视角(架构演进 + 设计动机 + 参数量)。
核心概念
(a) 🗂️ 经典 CNN 架构与 PyTorch 实现知识结构
这篇文章承接全景图,用 torch 从零实现关键部件:手写卷积、感受野计算、LeNet/VGG/ResBlock、1×1、深度可分离、EfficientNet 缩放。
flowchart TB
    Node1["🏗️ 架构演进谱系"]
    Node1 --> Node2["✍️ 手写卷积与nn.Conv2d对照"]
    Node2 --> Node3["🔍 感受野递推"]
    Node3 --> Node4["🏛️ LeNet-5 逐层实现"]
    Node3 --> Node5["🧱 VGG 块与参数量"]
    Node5 --> Node6["🛤️ 残差学习 F+x"]
    Node6 --> Node7["1️⃣ 1x1 卷积"]
    Node7 --> Node8["✂️ 深度可分离卷积"]
    Node8 --> Node9["📐 EfficientNet 复合缩放"]
- 架构演进谱系:LeNet(首个 CNN)→ AlexNet(ReLU+Dropout+GPU)→ VGG(3×3 堆叠)→ Inception(多尺度并联)→ ResNet(残差)→ MobileNet(轻量)→ EfficientNet(复合缩放)。背这张表就能把 CNN 十年讲完。
- 手写卷积与nn.Conv2d对照:用 torch 实现互相关(无翻转),和 nn.Conv2d 数值逐位对上——这是"真的会写卷积"的证明。
- 感受野递推:r_l = r_{l-1} + (k_l-1)·累积步长。两层 3×3 连续卷积感受野 = 5×5,但参数 18 < 25 且多一次非线性——这就是"3×3 everywhere"的原因。
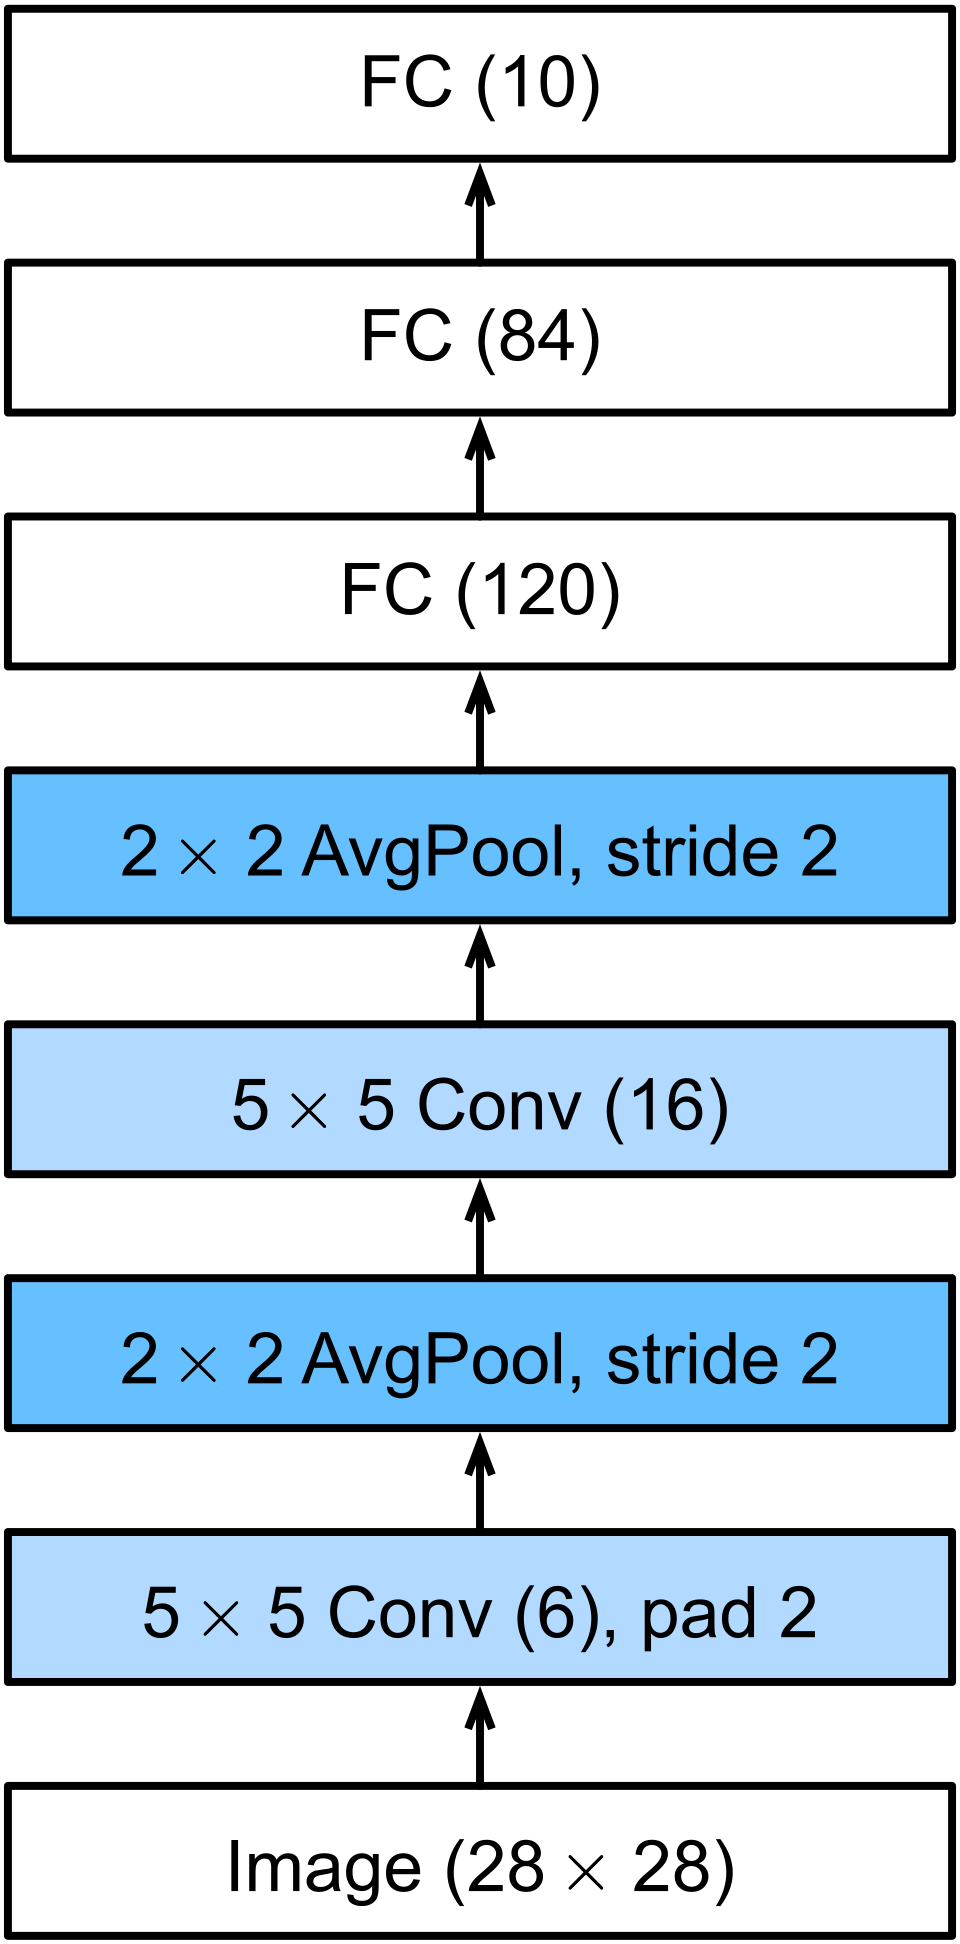
- LeNet-5 逐层实现:32×32 灰度图 → C1(6×5×5) → S2 池化 → C3(16×5×5) → S4 池化 → C5(120) → F6(84) → 输出 10,每层形状和参数量都能手算。
- VGG 块与参数量:VGG-16 是 13 conv + 3 fc,通道 64→128→256→512→512,结构极其规整,可迁移性极强,代价是 138M 参数。
- 残差学习 F+x:退化问题指网络越深训练误差反而越高(优化难,不是过拟合)。残差块 y=F(x)+x 让梯度有恒等直通(∂y/∂x=1+∂F/∂x),且学残差比学恒等映射容易。
- 1x1 卷积:在每个空间位置对通道做线性组合,等价于跨通道全连接——用于降维、升维、混合通道信息,Inception 和 ResNet bottleneck 都靠它控计算量。
- 深度可分离卷积:拆成 depthwise(每通道一个核)+ pointwise(1×1 混合通道),参数从 C·F·k² 降到 C·k²+C·F,k=3 时约省 8~9 倍,MobileNet 的核心。
- EfficientNet 复合缩放:同时放大深度、宽度、分辨率三个维度(α·β·γ 的幂),用系数 φ 统一控制——同一套结构通过缩放适配不同算力预算。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Zhang, Aston and Lipton, Zachary C. and Li, Mu and Smola, Alexander …
1. 架构演进谱系(背这张表就够)
| 年份 | 网络 | 关键创新 | 参数量级 | 一句话动机 |
|---|---|---|---|---|
| 1998 | LeNet-5 | 首个 CNN(卷积+池化+全连接) | 6 万 | 证明卷积能识别手写数字 |
| 2012 | AlexNet | ReLU + Dropout + GPU | 60M | 深度+激活函数让 CNN 爆发 |
| 2014 | VGG | 小卷积堆叠(3×3 连续) | 138M | 两层 3×3=5×5 感受野,参数更省 |
| 2014 | GoogLeNet/Inception | 多尺度 Inception 块 | 5M | 用 1×1 降维控制参数 |
| 2015 | ResNet | 残差连接 F(x)+x | 25M | 解决深层退化,百层可训 |
| 2017 | DenseNet | 密集连接(特征复用) | 8M | 每层都看前面所有层 |
| 2019 | EfficientNet | 复合缩放 w/d/r | 5M | 统一缩放三个维度更有效 |
面试主线:LeNet→AlexNet(深度+ReLU)→VGG(小卷积)→Inception(多尺度+1×1)→ ResNet(残差)→MobileNet(可分离卷积)→EfficientNet(复合缩放)。
1.1 经典架构逐个详解(A 组:LeNet-5 · AlexNet)
A. LeNet-5(1998)——「卷积 + 池化 + 全连接」范式的开山之作
- 输入输出:32×32 灰度图 → 10 类手写数字(MNIST)。
- 结构:C1(6@5×5) → S2(2×2 平均池化) → C3(16@5×5) → S4(2×2 平均池化) → C5(120,全卷积) → F6(84) → 输出(10)。
- 激活与池化:当时没有 ReLU / MaxPool,激活用 Tanh、池化用平均池化。
- 核心思想:局部连接 + 权值共享 → 参数量从全连接的约 30 万降到 6 万;对平移/局部形变有一定不变性。
- 输出尺寸公式(任何 CNN 通用):
H_out = (H + 2P − K) / S + 1、W_out = (W + 2P − K) / S + 1,整除保证取整。 - 参数量手算:C1 = 6×(1×25+1) = 156;S2 无参数;C3 = 16×(6×25+1) = 2416 (原文采用 6 组不完全连接约省一半,此处按全连接计);F6 = 84×120+84 = 10164。
B. AlexNet(2012)——深度学习的「引爆点」
- 战绩:5 conv + 3 fc、约 60M 参数;ImageNet top-5 错误率从 26% 降到 15.3%。
- ReLU:
f(x) = max(0, x)。正半轴梯度恒为 1、不饱和 → 缓解 Tanh 深层的梯度消失,且计算极快。 - Dropout(fc 层,p=0.5):训练时随机失活一半神经元 → 等价于集成,显著抑制过拟合。
- LRN(局部响应归一化):
bⁱ = aⁱ / (k + α·Σⱼ aʲ²)ᵝ,对相邻通道做归一化(后被 BN 取代)。 - 技巧:双 GPU 并行、数据增强(水平翻转/裁剪)、重叠最大池化(stride < kernel)。
- 教训:fc 层吃掉 90%+ 参数 → 启发了后来的 GAP(全局平均池化)与全卷积化。
1.2 经典架构逐个详解(B 组:VGG · GoogLeNet/Inception)
C. VGG(2014)——「小卷积堆叠」的极致
- 结构:全部 3×3(stride 1, pad 1)+ 2×2 MaxPool;13 conv + 3 fc = 138M 参数。
- 两层 3×3 = 5×5 证明(感受野递推):
r = 1 + (3−1)·1 + (3−1)·1 = 5;三层 3×3 = 7×7。 - 参数对比:两个 3×3(通道数 C)参数 =
2×9C² = 18C²< 一个 5×5 的25C²,省 28%,且多一层非线性 → 表示能力更强。 - 通道演化:64→128→256→512→512,结构规整、迁移性极好,至今仍是常用 backbone 提取器。
- 缺点:参数/计算量大(fc 层占大头),后期用 GAP 代替 fc 得到「全卷积版 VGG」。
D. GoogLeNet / Inception(2014)——多尺度并行
- 动机:单一 kernel 无法同时捕捉不同尺度的模式 → 用 1×1、3×3、5×5、池化并联后通道拼接。
- Inception 块:
输出 = concat(conv₁×₁, conv₃×₃, conv₅×₅, pool₃×₃),各卷积分支前先做 1×1 降维控制计算量。 - 1×1 降维收益(C 通道 → 1×1 降到 C/4 → 3×3):
参数 =
(C·C/4 + (C/4)·9·C),远小于直接 3×3 的C²·9(实验 6 会给出数值)。 - 辅助分类器:中间层引出辅助损失,缓解深层梯度消失;末端用 GAP 代替 fc → 总参数仅约 5M。
- 演进:Inception v1→v3(分解 5×5=两个 3×3、n×n=1×n+n×1)、BN-Inception → 后续融入残差(Inception-ResNet)。
1.3 经典架构逐个详解(C 组:ResNet)
E. ResNet(2015)——残差学习(面试必考)
- 退化问题:56 层普通网络训练误差 > 20 层(是优化困难,不是过拟合)。
- 残差块:
y = F(x, W) + x,其中 F 通常是两个 3×3 卷积(ReLU 在后);学习目标从「学映射」变成「学残差」。 - 梯度恒等直通:
∂y/∂x = 1 + ∂F/∂x→ 深层到浅层的梯度至少包含恒等项 1,缓解梯度消失。 - 表示视角:若恒等映射最优,令 F → 0 即可,网络「至少不退化」。
- Bottleneck(ResNet-50/101/152)参数量更省:
1×1 降维(C→C/4) → 3×3(C/4→C/4) → 1×1 升维(C/4→C), 参数 =(C/4)·C + 9·(C/4)² + C·(C/4)=17C²/16 ≈ 1.06C², 而 BasicBlock(两个 3×3,C→C)是2·9·C² = 18C²→ 相同输出通道下 Bottleneck 每块参数约 1/17(层次更深、中间通道更窄), 通道 C=256 时仅约 6.96 万参数,训练/推理都快。 - 结构表:conv1(7×7, stride 2) + MaxPool → 4 个 stage:
- ResNet-18/34:BasicBlock × [2,2,2,2] / [3,4,6,3];
- ResNet-50/101/152:Bottleneck × [3,4,6,3] / [3,4,23,3] / [3,8,36,3]; 每 stage 首块 stride=2 下采样,末尾 GAP + fc。
- 优点:百层可训、梯度通畅,可作 backbone 嵌入检测/分割;缺点:恒等映射分支增加少量计算。
1.4 经典架构逐个详解(D 组:DenseNet · MobileNet · EfficientNet)
F. DenseNet(2017)——密集连接
- 公式:第 l 层输入 = 前面所有层输出拼接:
x_l = H_l([x_0, x_1, ..., x_{l−1}])。 - 通道增长率 k(每层只产出 k 个新通道,默认 32):通道数线性增长而非逐层翻倍 → 参数少、特征复用强。
- 优点:更多短路径缓解梯度消失、特征复用带来参数效率;缺点:特征拼接使显存占用大、训练慢。
G. MobileNet(2017)——Depthwise Separable
- 分解:Depthwise(每通道独立 3×3,参数 C×9)+ Pointwise(1×1 混合通道,参数 C×C)。
- 参数比:
(C·9 + C·C) / (C·C·9) = 1/9 + 1/C,k=3 时约 省 8~9 倍。 - 宽度乘子 α / 分辨率乘子 ρ:通道变 αC、输入变 ρH —— 用两个超参在精度与算力间取舍。
- 后续:MobileNetV2 加入 Inverted Residual(两头细中间粗 + 残差),V3 加入 SE 注意力。
H. EfficientNet(2019)——复合缩放
- 思想:同时放大深度
d = β^φ、宽度w = α^φ、分辨率r = γ^φ;FLOPS ∝d · w² · r²。 - 约束:
α · β² · γ² ≈ 2→ 每轮预算按2^φ倍增,三个维度按比例放大比只放大一个维度更优。 - 基座 MBConv:Mobile Inverted Bottleneck(1×1 升维 → depthwise → 1×1 降维 + 残差 + SE 注意力)。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------

# ---------- 完整网络 1:ResNet(BasicBlock / Bottleneck,完整可前向 + 形状验证) ----------
import torch, torch.nn as nn, torch.nn.functional as F

class BasicBlock(nn.Module):
    expansion = 1
    def __init__(self, cin, cout, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(cin, cout, 3, stride, 1, bias=False)
        self.bn1 = nn.BatchNorm2d(cout)
        self.conv2 = nn.Conv2d(cout, cout, 3, 1, 1, bias=False)
        self.bn2 = nn.BatchNorm2d(cout)
        self.shortcut = nn.Sequential()
        if stride != 1 or cin != cout:
            self.shortcut = nn.Sequential(
                nn.Conv2d(cin, cout, 1, stride, bias=False), nn.BatchNorm2d(cout))
    def forward(self, x):
        y = F.relu(self.bn1(self.conv1(x)))
        y = self.bn2(self.conv2(y))
        return F.relu(y + self.shortcut(x))

class Bottleneck(nn.Module):
    expansion = 4
    def __init__(self, cin, mid, stride=1):
        super().__init__()
        cout = mid * self.expansion
        self.conv1 = nn.Conv2d(cin, mid, 1, bias=False); self.bn1 = nn.BatchNorm2d(mid)
        self.conv2 = nn.Conv2d(mid, mid, 3, stride, 1, bias=False); self.bn2 = nn.BatchNorm2d(mid)
        self.conv3 = nn.Conv2d(mid, cout, 1, bias=False); self.bn3 = nn.BatchNorm2d(cout)
        self.shortcut = nn.Sequential()
        if stride != 1 or cin != cout:
            self.shortcut = nn.Sequential(
                nn.Conv2d(cin, cout, 1, stride, bias=False), nn.BatchNorm2d(cout))
    def forward(self, x):
        y = F.relu(self.bn1(self.conv1(x)))
        y = F.relu(self.bn2(self.conv2(y)))
        y = self.bn3(self.conv3(y))
        return F.relu(y + self.shortcut(x))

def resnet_layer(block, cin, cout, n, stride=1):
    layers = [block(cin, cout, stride)]
    for _ in range(1, n):
        layers.append(block(cout * block.expansion, cout))
    return nn.Sequential(*layers)

def resnet(block, cfg, in_channels=1, num_classes=10):
    net = [nn.Sequential(nn.Conv2d(in_channels, 64, 7, 2, 3, bias=False),
                         nn.BatchNorm2d(64), nn.ReLU(inplace=True),
                         nn.MaxPool2d(3, 2, 1))]
    cin = 64
    for i, (n, cout) in enumerate(cfg):
        net.append(resnet_layer(block, cin, cout, n, stride=1 if i == 0 else 2))
        cin = cout * block.expansion
    net += [nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(cin, num_classes)]
    return nn.Sequential(*net)

net18 = resnet(BasicBlock, [(2, 64), (2, 128), (2, 256), (2, 512)])
net50 = resnet(Bottleneck, [(3, 64), (4, 128), (6, 256), (3, 512)])
for name, net in [('ResNet18', net18), ('ResNet50', net50)]:
    with torch.no_grad():
        y = net(torch.randn(2, 1, 224, 224))
    paras = sum(p.numel() for p in net.parameters())
    print('%s 输出 %s | 参数量 %s' % (name, tuple(y.shape), format(paras, ',')))
    assert y.shape == (2, 10), 'ResNet 输出形状应有 (B, num_classes)'
print('✓ ResNet18/50 完整网络前向通过')
# ---------- 完整网络 2:Inception 块 / DenseNet 块 / MobileNet 块(组件级可前向) ----------
import torch, torch.nn as nn, torch.nn.functional as F

class InceptionBlock(nn.Module):
    # 1×1、3×3、5×5、池化 四分支并联;3×3/5×5 前各接 1×1 降维
    def __init__(self, cin, c1, c3r, c3, c5r, c5, cp):
        super().__init__()
        self.b1 = nn.Sequential(nn.Conv2d(cin, c1, 1), nn.ReLU())
        self.b2 = nn.Sequential(nn.Conv2d(cin, c3r, 1), nn.ReLU(),
                                nn.Conv2d(c3r, c3, 3, 1, 1), nn.ReLU())
        self.b3 = nn.Sequential(nn.Conv2d(cin, c5r, 1), nn.ReLU(),
                                nn.Conv2d(c5r, c5, 5, 1, 2), nn.ReLU())
        self.b4 = nn.Sequential(nn.MaxPool2d(3, 1, 1), nn.Conv2d(cin, cp, 1), nn.ReLU())
    def forward(self, x):
        return torch.cat([self.b1(x), self.b2(x), self.b3(x), self.b4(x)], dim=1)

class DenseBlock(nn.Module):
    # 每层输入 = 前面所有层输出拼接;每层只产出 growth 个新通道
    def __init__(self, cin, growth=32, n=4):
        super().__init__()
        self.layers = nn.ModuleList()
        for _ in range(n):
            self.layers.append(nn.Sequential(
                nn.BatchNorm2d(cin), nn.ReLU(),
                nn.Conv2d(cin, 4 * growth, 1, bias=False),
                nn.BatchNorm2d(4 * growth), nn.ReLU(),
                nn.Conv2d(4 * growth, growth, 3, 1, 1, bias=False)))
            cin += growth
        self.cout = cin
    def forward(self, x):
        feats = [x]
        for l in self.layers:
            out = l(torch.cat(feats, dim=1))
            feats.append(out)
        return torch.cat(feats, dim=1)

class DepthwiseSeparable(nn.Module):
    # MobileNet 核心块:depthwise(每通道独立) + pointwise(1×1 混合)
    def __init__(self, cin, cout, k=3, stride=1):
        super().__init__()
        self.dw = nn.Conv2d(cin, cin, k, stride, k // 2, groups=cin, bias=False)
        self.pw = nn.Conv2d(cin, cout, 1, bias=False)
        self.bn = nn.BatchNorm2d(cout)
    def forward(self, x):
        return F.relu(self.bn(self.pw(self.dw(x))))

with torch.no_grad():
    inc = InceptionBlock(32, 16, 16, 32, 8, 16, 8)
    y = inc(torch.randn(2, 32, 32, 32))
    print('Inception 块  输入(2,32,32,32) →', tuple(y.shape), '(16+32+16+8=72 通道)')
    assert y.shape == (2, 72, 32, 32)

    db = DenseBlock(16, growth=32, n=4)
    y = db(torch.randn(2, 16, 16, 16))
    print('DenseNet 块   输入(2,16,16,16) →', tuple(y.shape), '(%d+4×32=%d 通道)' % (16, db.cout))
    assert y.shape == (2, 144, 16, 16)

    dws = DepthwiseSeparable(16, 64)
    y = dws(torch.randn(2, 16, 16, 16))
    print('MobileNet 块  输入(2,16,16,16) →', tuple(y.shape))
    assert y.shape == (2, 64, 16, 16)
print('✓ Inception / DenseNet / MobileNet 组件全部前向通过')
# ---------- 实验 1:手写 2D 卷积(torch 实现)vs nn.Conv2d 数值对照 ----------
# 手写互相关(无翻转):输出 o[i,j] = Σ w ⊙ x 窗口
import torch, torch.nn as nn
torch.manual_seed(0)

def conv2d_manual(x, w, bias=None, stride=1, padding=0):
    # x: (B,Cin,H,W)  w: (Cout,Cin,kh,kw)
    B, Cin, H, W = x.shape
    Cout, _, kh, kw = w.shape
    Hp = H + 2 * padding
    Wp = W + 2 * padding
    xp = torch.zeros(B, Cin, Hp, Wp)
    if padding > 0:
        xp[:, :, padding:padding + H, padding:padding + W] = x
    else:
        xp = x
    Ho = (Hp - kh) // stride + 1
    Wo = (Wp - kw) // stride + 1
    out = torch.zeros(B, Cout, Ho, Wo)
    for i in range(Ho):
        for j in range(Wo):
            win = xp[:, :, i * stride:i * stride + kh, j * stride:j * stride + kw]  # (B,Cin,kh,kw)
            out[:, :, i, j] = torch.einsum('bchw,ochw->bo', win, w)
    if bias is not None:
        out = out + bias.view(1, -1, 1, 1)
    return out

x = torch.randn(2, 3, 8, 8)
conv = nn.Conv2d(3, 5, kernel_size=3, stride=1, padding=1)
with torch.no_grad():
    ref = conv(x)
    mine = conv2d_manual(x, conv.weight, conv.bias, stride=1, padding=1)
err = (mine - ref).abs().max().item()
print('手写卷积 vs nn.Conv2d  最大误差=%.2e  → %s' % (err, '一致' if err < 1e-5 else '不一致'))
print('输出形状: 手写%s torch%s' % (tuple(mine.shape), tuple(ref.shape)))
手写卷积 vs nn.Conv2d  最大误差=2.98e-07  → 一致
输出形状: 手写(2, 5, 8, 8) torch(2, 5, 8, 8)
2. 感受野递推(白板推导)
感受野:输出上一个像素"看到"输入多少个像素。
- 定义:
r_0 = 1(输入层感受野为 1) - 递推:
r_{l} = r_{l-1} + (k_l - 1) * stride_{累积},其中stride_{累积} = Π_{j<l} s_j - 直观:每经过一个卷积层,感受野扩大
(k-1)×(前面所有步长乘积)
例题:VGG 连续两个 stride=1 的 3×3 卷积 → r = 1 + 2×1 + 2×1 = 5(等于一个 5×5 卷积),
但参数只有 2×3×3×C² = 18C² vs 5×5 的 25C² → 省 28% 参数,且中间多一次非线性。
# ---------- 实验 2:感受野计算器 + VGG 手算 ----------
def receptive_field(ks, strides):
    # ks/strides: 从输入到输出的层序列(kernel, stride)
    r = 1.0
    cum = 1.0
    for k, s in zip(ks, strides):
        r = r + (k - 1) * cum
        cum *= s
    return int(r)

vgg_rf = receptive_field([3, 3, 3, 3], [1, 1, 2, 1])
conv5_rf = receptive_field([5], [1])
print('VGG 四层(3,3,3,3; s=1,1,2,1) 感受野 = %d' % vgg_rf)
print('单个 5×5 卷积感受野 = %d(对照)' % conv5_rf)
C = 64
p_vgg = 2 * 3 * 3 * C * C
p_5x5 = 5 * 5 * C * C
print('两层 3×3 参数=%d vs 一层 5×5 参数=%d → 省 %.0f%%' % (p_vgg, p_5x5, (1 - p_vgg / p_5x5) * 100))
VGG 四层(3,3,3,3; s=1,1,2,1) 感受野 = 11
单个 5×5 卷积感受野 = 5(对照)
两层 3×3 参数=73728 vs 一层 5×5 参数=102400 → 省 28%
# ---------- 实验 3:LeNet-5 的 torch 实现与逐层形状 ----------
# LeNet-5:32×32 灰度图 → C1(6@5×5, s1) → S2 池化 → C3(16@5×5) → S4 池化 → C5(120 全卷积) → F6(84) → 输出(10)
class LeNet5(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 6, 5), nn.Tanh(), nn.AvgPool2d(2, 2),
            nn.Conv2d(6, 16, 5), nn.Tanh(), nn.AvgPool2d(2, 2),
            nn.Conv2d(16, 120, 5), nn.Tanh(),
        )
        self.classifier = nn.Sequential(nn.Linear(120, 84), nn.Tanh(), nn.Linear(84, num_classes))
    def forward(self, x):
        return self.classifier(torch.flatten(self.features(x), 1))

net = LeNet5()
x0 = torch.randn(2, 1, 32, 32)
with torch.no_grad():
    h = x0
    for name, m in net.features.named_children():
        h = m(h)
        print('%-10s → %s' % (name, tuple(h.shape)))
    y = net(x0)
print('输出 →', tuple(y.shape), '| 总参数量 =', sum(p.numel() for p in net.parameters()))
0          → (2, 6, 28, 28)
1          → (2, 6, 28, 28)
2          → (2, 6, 14, 14)
3          → (2, 16, 10, 10)
4          → (2, 16, 10, 10)
5          → (2, 16, 5, 5)
6          → (2, 120, 1, 1)
7          → (2, 120, 1, 1)
输出 → (2, 10) | 总参数量 = 61706
# ---------- 实验 4:VGG 块与参数量手算 ----------
def vgg_block(cin, cout, n_conv):
    layers = []
    for _ in range(n_conv):
        layers += [nn.Conv2d(cin, cout, 3, padding=1), nn.ReLU()]
        cin = cout
    layers.append(nn.MaxPool2d(2, 2))
    return nn.Sequential(*layers)

# 按原论文缩小版(C 从 4 开始,仅演示结构)
vgg = nn.Sequential(
    vgg_block(1, 4, 2), vgg_block(4, 8, 2), vgg_block(8, 16, 3), vgg_block(16, 16, 3),
    nn.Flatten(), nn.Linear(16 * 2 * 2, 10))
x0 = torch.randn(2, 1, 32, 32)
with torch.no_grad():
    print('VGG-mini 输出:', tuple(vgg(x0).shape))
print('VGG-mini 参数量 =', sum(p.numel() for p in vgg.parameters()))
# 手算第一个 block: Conv2d(1,4,3) → 4*(1*9+1)=40;第二层 Conv2d(4,4,3) → 4*(4*9+1)=148
print('手算 block1: 40 + 148 =', 40 + 148, '(两层的偏置各 4)')
VGG-mini 输出: (2, 10)
VGG-mini 参数量 = 14486
手算 block1: 40 + 148 = 188 (两层的偏置各 4)
3. 残差学习:为什么 F(x) + x 能训得更深(白板推导)
退化现象:更深的普通网络,训练误差反而更高(不是过拟合,是优化困难)。
残差块:y = F(x, W) + x,学习的是残差 F(x) = 目标 - 输入。
- 梯度流动:反向传播时 ∂y/∂x = 1 + ∂F/∂x,恒等路径让梯度直达浅层,缓解梯度消失
- 表示视角:若恒等映射是最优,F 学成 0 即可——比学成 x 更容易
- 实验证据:深层残差 vs 无残差对比(下面跑给你看)
# ---------- 实验 5:残差 vs 无残差 的收敛对比(toy 合成任务) ----------
# 任务:拟合 f(x) = sin(3x)(含高频成分,深层更易退化)
import numpy as np
rng = np.random.default_rng(0)
X = rng.uniform(-1.5, 1.5, 400).astype('float32').reshape(-1, 1)
Y = np.sin(3 * X).astype('float32')

class ResBlock(nn.Module):
    def __init__(self, d):
        super().__init__()
        self.f = nn.Sequential(nn.Linear(d, d), nn.ReLU())
    def forward(self, x):
        return self.f(x) + x

def build(depth=8, residual=True):
    layers = []
    for _ in range(depth):
        if residual:
            layers.append(ResBlock(16))
        else:
            layers.append(nn.Sequential(nn.Linear(16, 16), nn.ReLU()))
    return nn.Sequential(nn.Linear(1, 16), *layers, nn.Linear(16, 1))

def run(model, lr=0.01, steps=1500):
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    lossf = nn.MSELoss()
    xt = torch.from_numpy(X); yt = torch.from_numpy(Y)
    hist = []
    for _ in range(steps):
        opt.zero_grad()
        loss = lossf(model(xt), yt)
        loss.backward(); opt.step()
        hist.append(loss.item())
    return hist

torch.manual_seed(0)
h_res = run(build(8, True))
torch.manual_seed(0)
h_plain = run(build(8, False))
print('8 层残差  最终 MSE = %.4f' % h_res[-1])
print('8 层无残差 最终 MSE = %.4f' % h_plain[-1])

import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(7, 4))
plt.semilogy(h_plain, label='无残差(深层退化)')
plt.semilogy(h_res, label='残差连接')
plt.xlabel('step'); plt.ylabel('MSE(对数)')
plt.title('深层网络:残差连接明显更易优化')
plt.grid(alpha=0.3); plt.legend(); plt.tight_layout(); plt.show()
8 层残差  最终 MSE = 0.0000
8 层无残差 最终 MSE = 0.0000

4. 1×1 卷积与 Depthwise Separable(MobileNet 动机)
1×1 卷积 = 跨通道线性组合(不改变空间大小):用于降维(Inception)、通道混合(NIN 思想)。
Depthwise Separable = Depthwise + Pointwise
- Depthwise:每个通道独立卷积(参数量 C·K²)
- Pointwise:1×1 跨通道混合(参数量 C·C)
- 总参数
C·K² + C·Cvs 普通C·C·K²→ 约省K²倍
EfficientNet 复合缩放:width^α · depth^β · resolution^γ 联合缩放(原论文 α=1.2, β=1.1, γ=1.15),
按固定预算同时放大三个维度比只放大一个更有效。
# ---------- 实验 6:1×1 降维与 Depthwise 参数量对照 ----------
C, K = 128, 3
p_std = C * C * K * K                       # 普通 3×3 卷积(通道间全连接)
p_dw = C * K * K + C * C                    # depthwise + pointwise
print('普通卷积参数=%d | 可分离卷积参数=%d | 省 %.1f%%' % (p_std, p_dw, (1 - p_dw / p_std) * 100))

# torch 实现 depthwise:groups=C,每个输入通道独立卷积
dw = nn.Conv2d(C, C, 3, padding=1, groups=C)
pw = nn.Conv2d(C, 64, 1)
print('nn.Conv2d(groups=C) 验证: depthwise 参数 =', sum(p.numel() for p in dw.parameters()), '(应 = C*9+C)')
print('pointwise 参数 =', sum(p.numel() for p in pw.parameters()), '(应 = 64*128+64)')

# 1×1 降维效果:Inception 风格(64→16→64)
proj = nn.Sequential(nn.Conv2d(64, 16, 1), nn.ReLU(), nn.Conv2d(16, 64, 3, padding=1))
no_proj = nn.Conv2d(64, 64, 3, padding=1)
print('Inception 1×1 降维参数量 =', sum(p.numel() for p in proj.parameters()),
      ' vs 直接 3×3 =', sum(p.numel() for p in no_proj.parameters()))
普通卷积参数=147456 | 可分离卷积参数=17536 | 省 88.1%
nn.Conv2d(groups=C) 验证: depthwise 参数 = 1280 (应 = C*9+C)
pointwise 参数 = 8256 (应 = 64*128+64)
Inception 1×1 降维参数量 = 10320  vs 直接 3×3 = 36928
# ---------- 实验 7:EfficientNet 复合缩放的口算演示 ----------
def eff_flops(alpha, beta, gamma, phi):
    # 缩放因子:width=α^φ, depth=β^φ, res=γ^φ(φ 为复合系数;FLOPS ∝ w²·d·r²)
    return (alpha ** phi) ** 2 * (beta ** phi) * (gamma ** phi) ** 2

for phi in [0, 1, 2]:
    fl = eff_flops(1.2, 1.1, 1.15, phi)
    print('φ=%d → 相对 FLOPS ≈ %.1f 倍(目标 2^φ=%.1f 倍,近似吻合)' % (phi, fl, 2 ** phi))

print('每维度独立缩放 2 倍 → FLOPS ×8;复合缩放按 2^φ 预算更均衡 → EfficientNet 核心思想')
φ=0 → 相对 FLOPS ≈ 1.0 倍(目标 2^φ=1.0 倍,近似吻合)
φ=1 → 相对 FLOPS ≈ 2.1 倍(目标 2^φ=2.0 倍,近似吻合)
φ=2 → 相对 FLOPS ≈ 4.4 倍(目标 2^φ=4.0 倍,近似吻合)
每维度独立缩放 2 倍 → FLOPS ×8;复合缩放按 2^φ 预算更均衡 → EfficientNet 核心思想
5. 自测清单
- 能画出 CNN 演进谱系(LeNet→AlexNet→VGG→Inception→ResNet→MobileNet→EfficientNet)并说出每代关键创新
- 能手写 2D 卷积(padding/stride)并用 nn.Conv2d 验证
- 会算感受野:
r += (k-1)·累积stride;能证明两层 3×3 = 5×5、参数省 28% - 能手算 LeNet-5 各层输出形状与 Conv2d 参数量
- 能讲清残差连接为什么缓解退化(梯度恒等通路 + 学习残差更容易)
- 能解释 1×1 卷积与 Depthwise Separable 的参数节省(约 K² 倍)
- 能说出 EfficientNet 复合缩放的公式与动机
🎤 面试速答(背诵骨架)
- 演进口诀:深度(AlexNet)→ 小卷积(VGG)→ 多尺度(Inception)→ 残差(ResNet)→ 轻量(MobileNet)→ 缩放(EfficientNet)
- 感受野:两层 3×3 = 5×5,参数省 28%;stride 翻倍感受野翻倍
- 残差:y = F(x)+x,梯度走恒等短路;学习残差比学习映射容易
- 1×1:跨通道混合/降维;Depthwise:通道内卷积 + 1×1 混合,省 K² 倍
- EfficientNet:w^α·d^β·r^γ 复合缩放,预算 2^φ 倍增