🕸️ 00 · 图基础与图表示学习:网络X + 随机游走 + Node2Vec¶
图神经网络(GNN)从图的表示开始:把节点/边/子图变成向量。 本节用 networkx 建图、可视化、算度与连通分量,再手写随机游走(DeepWalk 思想) 与 Node2Vec 的 BFS/DFS 游走——这是图表示学习的起点。
🎬 背景故事¶
社交网络、分子结构、知识图谱——它们有一个共同的名字:图……
你的好友关系是一张图,蛋白质分子是一张图,维基百科的知识也是一张图。"图"是这个世界最自然的连接方式,但要让机器理解图,先得学会把它表示成数字。本节从 networkx 建图开始,讲清楚度、最短路、连通分量这些图性质,再进入随机游走和 Node2Vec。
🧭 本节逻辑主线:为什么图无处不在 → 图的数学表示(邻接矩阵)→ 图的性质指标 → 随机游走为什么能学表示 → Node2Vec 的 p/q 控制什么。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 图怎么表示? | 邻接矩阵 / 邻接表 |
| 2 | 图的基本性质? | 度/路径/连通分量/聚类系数 |
| 3 | 节点怎么变向量? | 随机游走 + word2vec 思想 |
| 4 | BFS vs DFS 游走? | Node2Vec 两个超参 p/q |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 建图与可视化(networkx)¶
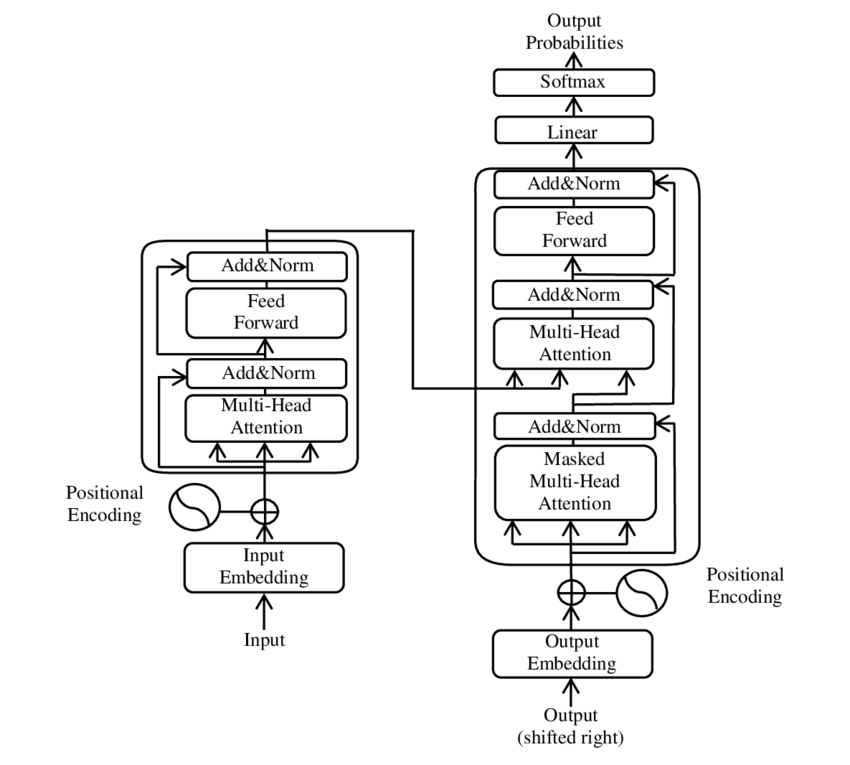
📌 真实配图:Transformer 完整架构(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:虽然本节讲"图",但 GNN 与 Transformer 共享同一个数学底座——
- 左侧编码器栈:输入嵌入 → 多头自注意力(每个 token 与其他所有 token 算注意力权重)→ 前馈网络,每个子层带残差连接与 LayerNorm;
- 右侧解码器栈:多了"带掩码的自注意力"(只能看左侧已生成的词)与"交叉注意力" (查询来自解码器、键值来自编码器输出);
- 与图的关系:自注意力 = 完整图上的消息传递——每个 token 是全图节点, 注意力权重就是边权重(全连接图);而 GNN 是稀疏图上的注意力。理解这张图的大致结构, 就能把"注意力机制"(03 深度学习)与"图上消息传递"(本模块 GCN/GAT)统一起来。 图片来源:Wikimedia Commons,CC BY-SA 4.0。
G = nx.Graph()
edges = [('A', 'B'), ('A', 'C'), ('B', 'D'), ('C', 'D'), ('C', 'E'),
         ('D', 'E'), ('E', 'F'), ('F', 'G'), ('G', 'H'), ('F', 'H')]
G.add_edges_from(edges)
print('节点数:', G.number_of_nodes(), '| 边数:', G.number_of_edges())
print('节点度:', dict(G.degree()))
print('平均聚类系数:', round(nx.average_clustering(G), 3))

plt.figure(figsize=(6, 5))
pos = nx.spring_layout(G, seed=42)
nx.draw(G, pos, with_labels=True, node_color='#2563eb', node_size=600,
        font_color='white', font_size=12)
plt.title('社交/引用关系图(示例)')
plt.show()
assert G.number_of_edges() == 10
print('✅ 图构建与可视化完成')
节点数: 8 | 边数: 10
节点度: {'A': 2, 'B': 2, 'C': 3, 'D': 3, 'E': 3, 'F': 3, 'G': 2, 'H': 2}
平均聚类系数: 0.417
✅ 图构建与可视化完成
C:\Users\24260\AppData\Local\Temp\ipykernel_15744\1107041722.py:14: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
📐 公式推导:邻接矩阵、度矩阵与图指标¶
邻接矩阵($n$ 个节点,$\mathbb{1}$ 为指示函数,无向图对称):
$$ A_{ij} = \begin{cases} 1 & \text{若 } (i,j) \text{ 有边} \\ 0 & \text{否则} \end{cases}, \qquad A = A^\top \;\text{(无向)} $$
度(行和):$d_i = \sum_{j} A_{ij}$,度矩阵 $D = \operatorname{diag}(d_1, \dots, d_n)$。
聚类系数(节点 $i$ 的邻居中实际连边数占可能连边数比例,$k_i = d_i$ 为度):
$$ C_i = \frac{2 \cdot |\{ (j,k) : \text{都是 } i \text{ 的邻居且 } j\text{-}k \text{ 有边} \}|}{k_i (k_i - 1)} $$
推导要点:① 图 = 邻接矩阵(代数视角)+ 拓扑(几何视角)双视图,GNN 消息传递的矩阵形式就是 $AX$(邻居特征求和);② 聚类系数衡量"朋友的互相认识程度"——社交网络中高聚类系数 = 强社区结构;③ 邻接矩阵稀疏(每行 $O(\bar{d})$ 非零),工业图都按稀疏存储。
✍️ §2.1 手算一条链:度、转移概率、随机游走两步¶
随机游走是 DeepWalk/Node2Vec 的引擎:$P(v|u)=\frac{1}{\deg(u)}$(从 $u$ 均匀选邻居)——A–B–C 链手算,把"图变成句子"的概率算明白。
设定:3 节点链 A–B–C(A 与 C 不相连)。
第 1 步:度
$$\deg(A)=1,\ \deg(B)=2,\ \deg(C)=1\quad\Rightarrow\quad P(\deg=1)=\tfrac{2}{3},\ P(\deg=2)=\tfrac{1}{3}$$
第 2 步:一步转移概率
| 从 | 去 | 概率 |
|---|---|---|
| A | B | 1.0 |
| B | A / C | 0.5 / 0.5 |
| C | B | 1.0 |
第 3 步:两步游走(从 A 出发)
$$P([A,B,C])=1\times0.5=0.5,\qquad P([A,B,A])=1\times0.5=0.5$$
手算收获:
- 转移概率 = 1/出度:高度数节点"分薄"每一步概率——这就是随机游走天然对 hub 节点减权的来源(对比度归一化)
- 游走序列 [A,B,C]、[A,B,A] 各 0.5——DeepWalk 把这些序列当"句子"训 word2vec(本 notebook §4)
- Node2Vec 的 p/q 参数就是改这棵转移树:p 大 → 回头概率低(更像 BFS,保同质性);q 大 → 少走远(DFS,保结构)(§5)
- 三角形个数 = 0(A–C 无边)→ 聚类系数 0:链图没有"朋友的朋友还是朋友"
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算随机游走 ----
import numpy as np

Adj = np.array([[0, 1, 0], [1, 0, 1], [0, 1, 0]], dtype=float)
deg = Adj.sum(axis=1)
P = Adj / deg[:, None]
print(f'度 = {deg.astype(int)}')
print(f'转移矩阵 = \n{np.round(P, 3)}')
assert np.allclose(P[0, 1], 1.0) and np.allclose(P[1, 0], 0.5) and np.allclose(P[1, 2], 0.5)
p_abc = P[0, 1] * P[1, 2]
print(f'P([A,B,C]) = {p_abc}, P([A,B,A]) = {P[0,1]*P[1,0]}')
assert abs(p_abc - 0.5) < 1e-9
print('\n✓ 与手算一致')
✍️ §2.1 手算一条链:度、转移概率、随机游走两步¶
随机游走是 DeepWalk/Node2Vec 的引擎:$P(v|u)=\frac{1}{\deg(u)}$(从 $u$ 均匀选邻居)——A–B–C 链手算,把"图变成句子"的概率算明白。
设定:3 节点链 A–B–C(A 与 C 不相连)。
第 1 步:度
$$\deg(A)=1,\ \deg(B)=2,\ \deg(C)=1\quad\Rightarrow\quad P(\deg=1)=\tfrac{2}{3},\ P(\deg=2)=\tfrac{1}{3}$$
第 2 步:一步转移概率
| 从 | 去 | 概率 |
|---|---|---|
| A | B | 1.0 |
| B | A / C | 0.5 / 0.5 |
| C | B | 1.0 |
第 3 步:两步游走(从 A 出发)
$$P([A,B,C])=1\times0.5=0.5,\qquad P([A,B,A])=1\times0.5=0.5$$
手算收获:
- 转移概率 = 1/出度:高度数节点"分薄"每一步概率——这就是随机游走天然对 hub 节点减权的来源(对比度归一化)
- 游走序列 [A,B,C]、[A,B,A] 各 0.5——DeepWalk 把这些序列当"句子"训 word2vec(本 notebook §4)
- Node2Vec 的 p/q 参数就是改这棵转移树:p 大 → 回头概率低(更像 BFS,保同质性);q 大 → 少走远(DFS,保结构)(§5)
- 三角形个数 = 0(A–C 无边)→ 聚类系数 0:链图没有"朋友的朋友还是朋友"
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算随机游走 ----
import numpy as np

Adj = np.array([[0, 1, 0], [1, 0, 1], [0, 1, 0]], dtype=float)
deg = Adj.sum(axis=1)
P = Adj / deg[:, None]
print(f'度 = {deg.astype(int)}')
print(f'转移矩阵 = \n{np.round(P, 3)}')
assert np.allclose(P[0, 1], 1.0) and np.allclose(P[1, 0], 0.5) and np.allclose(P[1, 2], 0.5)
p_abc = P[0, 1] * P[1, 2]
print(f'P([A,B,C]) = {p_abc}, P([A,B,A]) = {P[0,1]*P[1,0]}')
assert abs(p_abc - 0.5) < 1e-9
print('\n✓ 与手算一致')
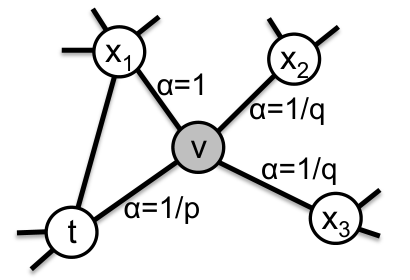
📄 经典论文原图:node2vec 随机游走状态转移
🔍 图解与逻辑衔接:图中当前节点为 v,上一步节点为 t,候选下一节点按与 t 的距离被分成三类:回到 t 的返回边、留在局部邻域的边、远离上一步的探索边。参数 p 控制返回概率,q 控制向外探索的概率;调节它们就能在 BFS 式局部采样与 DFS 式深度探索之间连续切换。这张图对应 notebook 中的转移概率代码:先根据距离给边赋 bias,再归一化为概率。理解它后再看 BFS/DFS 对比图,会知道游走差异是如何由 p/q 产生的。
论文出处:Grover & Leskovec, “node2vec: Scalable Feature Learning for Networks”, KDD 2016(arXiv:1607.00653),Figure 2。
2️⃣ 图的矩阵表示:邻接矩阵¶
nodes = sorted(G.nodes())
A = nx.to_numpy_array(G, nodelist=nodes)
print('邻接矩阵 (8x8):')
print(A.astype(int))
print('\n行和(度):', A.sum(axis=1).astype(int))
# 加自环:GNN 里常用(让节点聚合时包含自己)
A_hat = A + np.eye(len(nodes))
print('加自环后的对角:', np.diag(A_hat).astype(int))
assert A.shape == (8, 8) and np.allclose(A, A.T)
print('✅ 邻接矩阵对称(无向图)')
邻接矩阵 (8x8):
[[0 1 1 0 0 0 0 0]
 [1 0 0 1 0 0 0 0]
 [1 0 0 1 1 0 0 0]
 [0 1 1 0 1 0 0 0]
 [0 0 1 1 0 1 0 0]
 [0 0 0 0 1 0 1 1]
 [0 0 0 0 0 1 0 1]
 [0 0 0 0 0 1 1 0]]

行和(度): [2 2 3 3 3 3 2 2]
加自环后的对角: [1 1 1 1 1 1 1 1]
✅ 邻接矩阵对称(无向图)
3️⃣ 图论基本性质(面试速查)¶
print('''核心概念速答:
  度:节点的边数(无向);入度/出度(有向);
  路径/最短路:BFS 求无权最短路;
  连通分量:互相可达的节点集合;
  聚类系数:我的邻居之间也是邻居的比例(小世界性质);
  桥(割边):删除后图不连通 -> 网络关键边;
  中心性:度中心/介数中心(信息流通枢纽)。
''')
shortest = nx.shortest_path(G, 'A', 'H')
print('A->H 最短路:', shortest, '长度:', len(shortest) - 1)
print('连通分量:', [c for c in nx.connected_components(G)])
bridges = list(nx.bridges(G))
print('割边(桥):', bridges, '数量:', len(bridges))
核心概念速答:
  度:节点的边数(无向);入度/出度(有向);
  路径/最短路:BFS 求无权最短路;
  连通分量:互相可达的节点集合;
  聚类系数:我的邻居之间也是邻居的比例(小世界性质);
  桥(割边):删除后图不连通 -> 网络关键边;
  中心性:度中心/介数中心(信息流通枢纽)。

A->H 最短路: ['A', 'C', 'E', 'F', 'H'] 长度: 4
连通分量: [{'C', 'H', 'G', 'B', 'F', 'D', 'A', 'E'}]
割边(桥): [('E', 'F')] 数量: 1
4️⃣ 随机游走生成"句子"(DeepWalk 思想)¶
# 🖼️ 配图:随机游走如何把"图"变成"序列"
# 画一条示例游走路径(红色粗箭头 A→C→D→E→F→G),直观理解"游走=句子"
plt.figure(figsize=(6, 5))
pos = nx.spring_layout(G, seed=42)
nx.draw_networkx_nodes(G, pos, node_color='#e2e8f0', node_size=600)
nx.draw_networkx_labels(G, pos, font_size=11, font_color='#334155')
walk = ['A', 'C', 'D', 'E', 'F', 'G']
walk_edges = list(zip(walk[:-1], walk[1:]))
nx.draw_networkx_edges(G, pos, edge_color='#cbd5e1', width=1.2)
nx.draw_networkx_edges(G, pos, edgelist=walk_edges, edge_color='#ef4444', width=3)
nx.draw_networkx_nodes(G, pos, nodelist=walk, node_color='#ef4444', node_size=700)
nx.draw_networkx_nodes(G, pos, nodelist=['A'], node_color='#f97316', node_size=900, node_shape='s')
plt.title('随机游走:A → C → D → E → F → G(一条“句子”样本)', fontsize=11)
plt.axis('off')
plt.show()
print('➡️ 每条游走序列 = 一个“上下文窗口”,节点像单词一样被嵌入(DeepWalk = word2vec 在图上的移植)')
➡️ 每条游走序列 = 一个“上下文窗口”,节点像单词一样被嵌入(DeepWalk = word2vec 在图上的移植)
C:\Users\24260\AppData\Local\Temp\ipykernel_15744\3266093194.py:15: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 图节点是字符 A..H,先映射为索引再游走
node_list = list(G.nodes())

def random_walk(G, node_list, start_idx, length=6, seed=42):
    r = np.random.default_rng(seed)
    walk = [start_idx]
    cur = start_idx
    for _ in range(length - 1):
        nbrs = [node_list.index(nb) for nb in G.neighbors(node_list[cur])]
        if not nbrs:
            break
        cur = int(r.choice(nbrs))
        walk.append(cur)
    return walk

walks = []
for _ in range(20):
    s = int(rng.integers(0, len(node_list)))
    walks.append(random_walk(G, node_list, s, length=6))
print('示例游走:', [chr(65 + w) for w in walks[0]])
print('全部游走序列数:', len(walks), '总步数:', sum(len(w) for w in walks))
print('➡️ 游走序列 ≈ 自然语言"句子",节点≈词:再用 word2vec 学 embedding')
示例游走: ['A', 'B', 'D', 'C', 'D', 'C']
全部游走序列数: 20 总步数: 120
➡️ 游走序列 ≈ 自然语言"句子",节点≈词:再用 word2vec 学 embedding
5️⃣ Node2Vec:BFS(同质)与 DFS(结构)游走¶
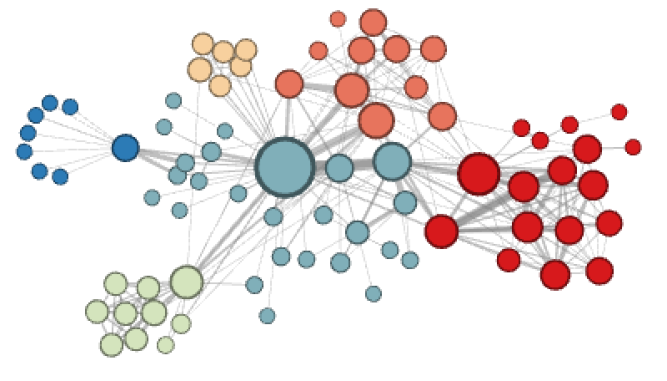
📄 经典论文原图:同质性与结构等价性
🔍 图解与逻辑衔接:图中两种颜色代表希望在 embedding 空间中靠近的节点类别。左侧同质性任务要求“相连或同社区”的节点接近;右侧结构等价任务要求“扮演相同结构角色”的节点接近,即便它们并不相邻。这解释了 node2vec 不只是在做随机游走:BFS 偏向同质性,DFS 更容易捕获结构角色。后续选择 p/q 时,应先明确任务是社区相似还是结构相似。
论文出处:Grover & Leskovec, node2vec, KDD 2016(arXiv:1607.00653),Figure 4/5。
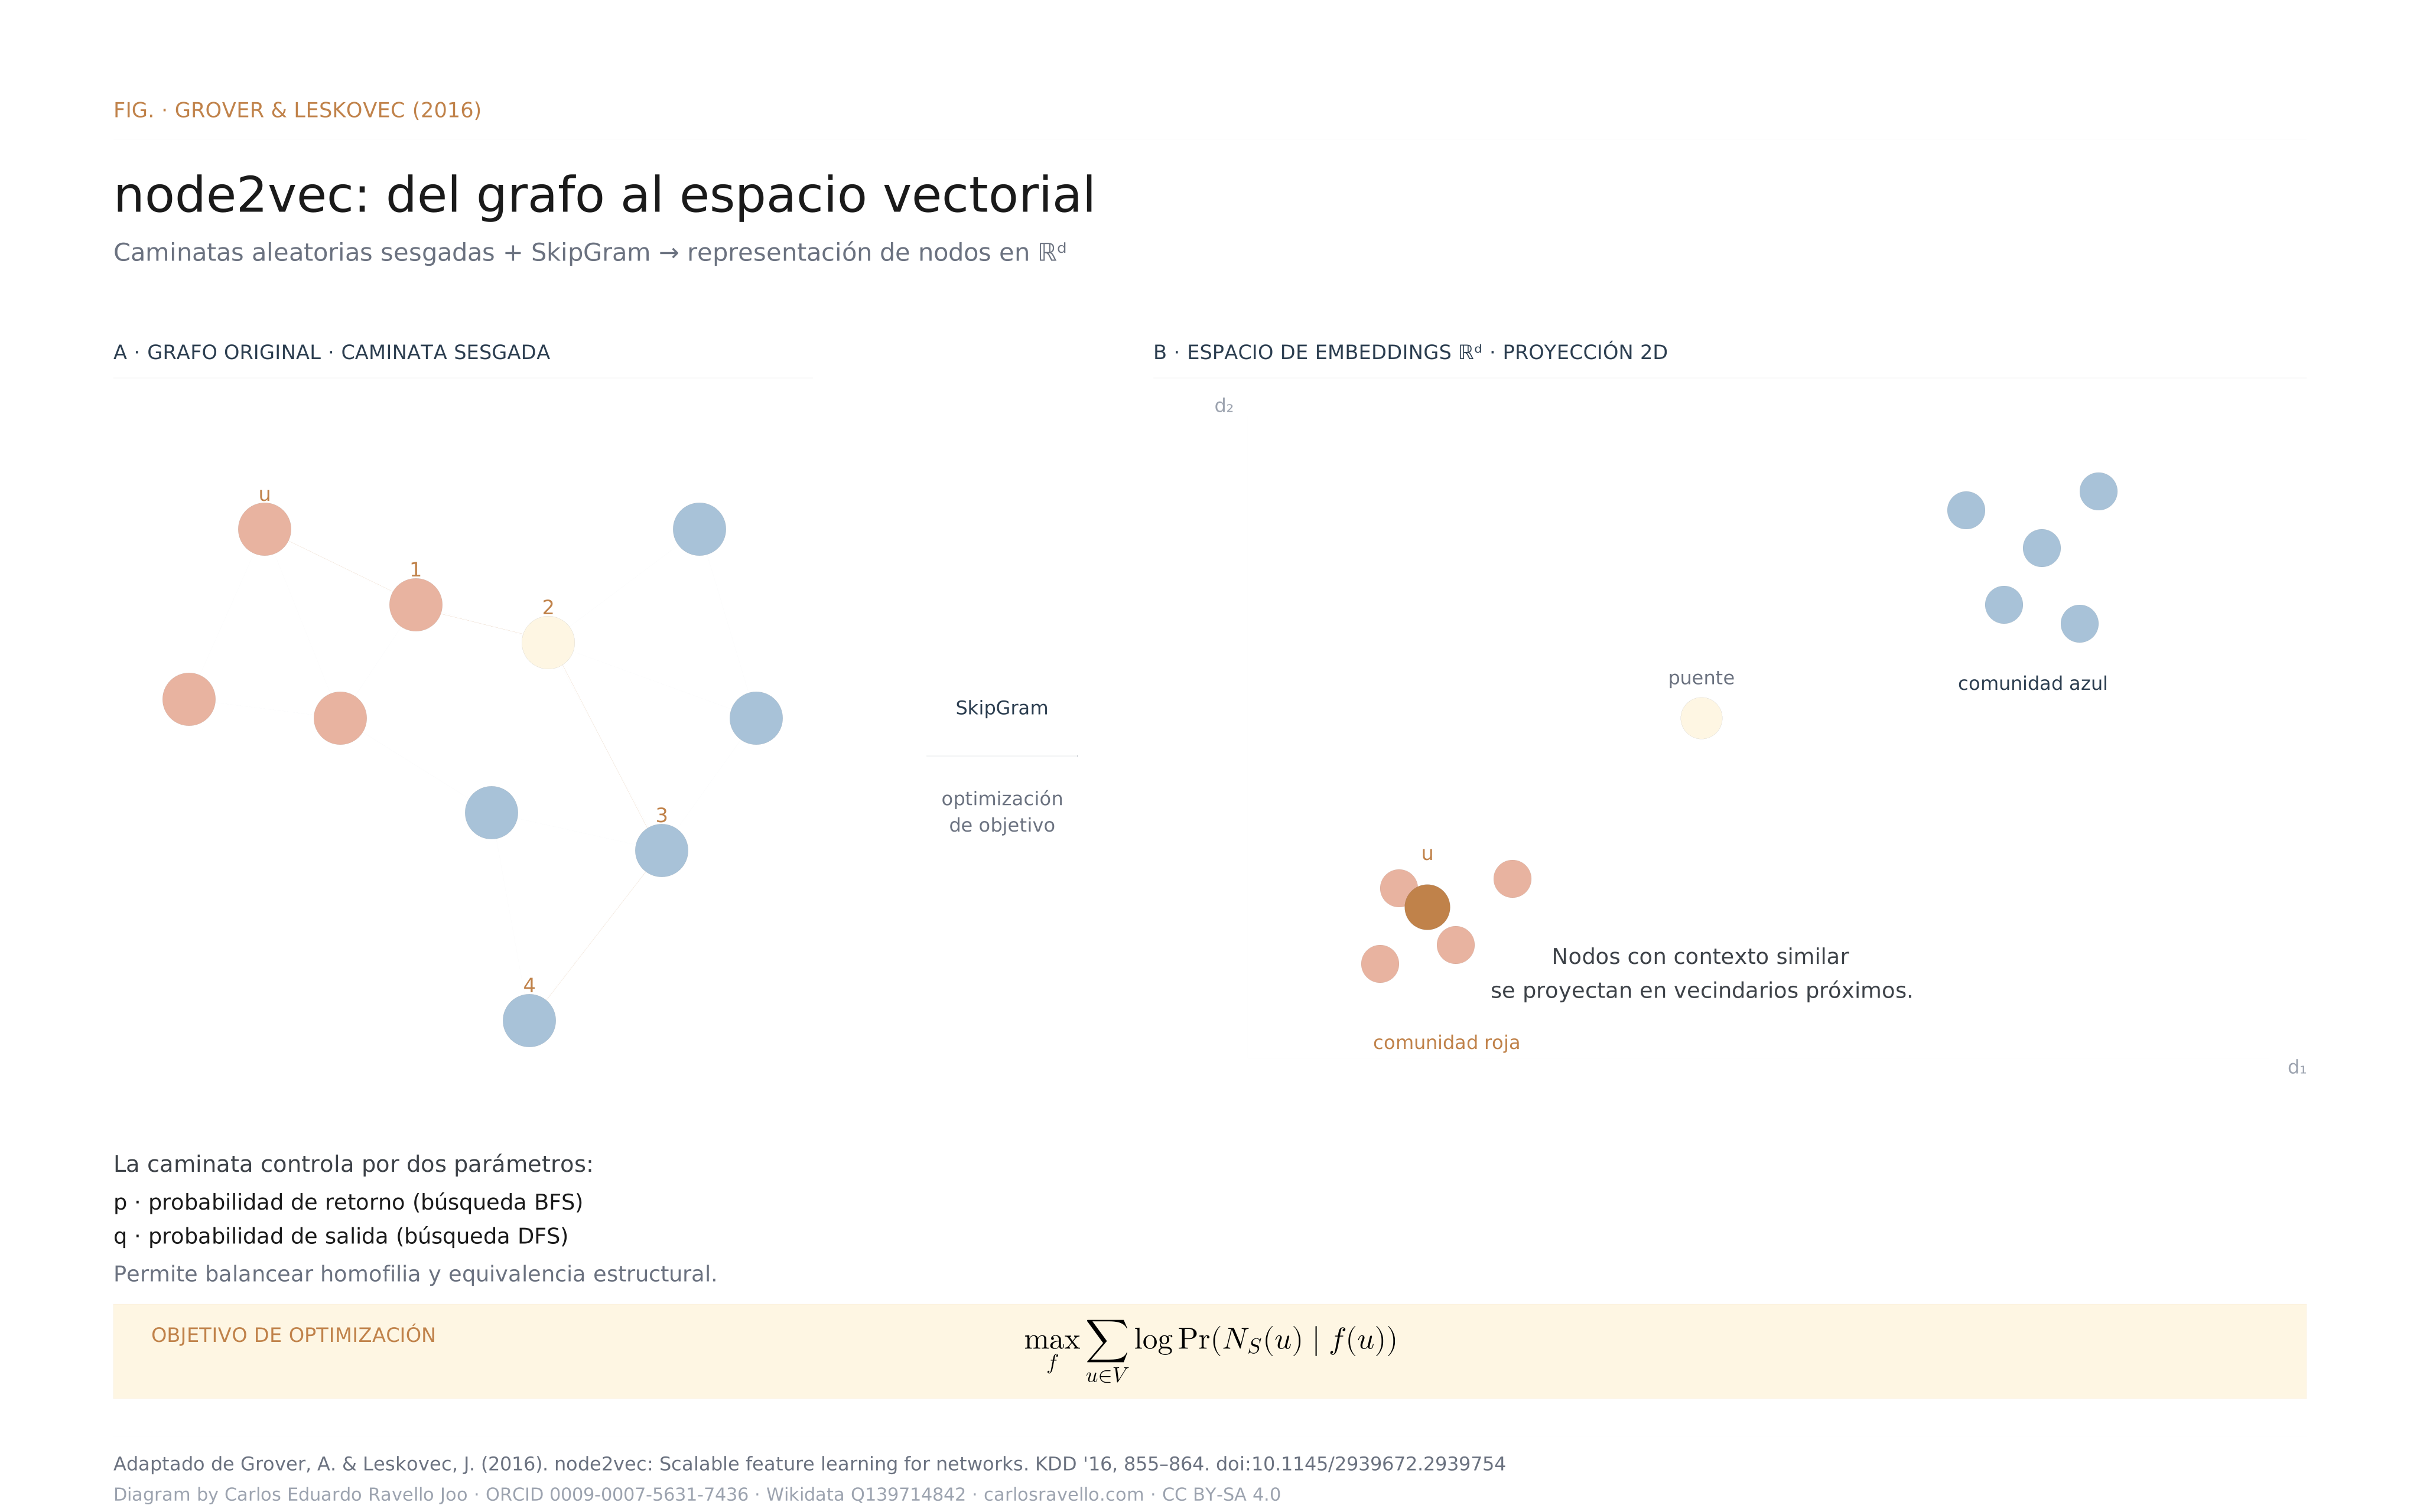
📌 权威配图:Node2Vec 原论文图解(Grover & Leskovec, 2016,Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这是 Node2Vec 论文 Figure 1/2 的矢量重制版,分两部分——
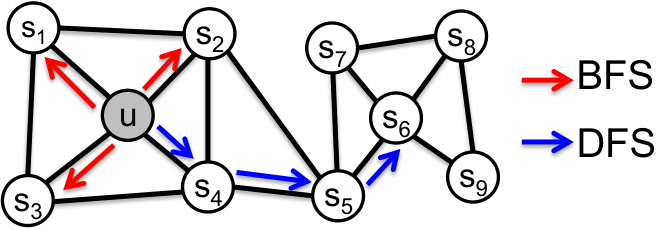
- 上图(论文 Figure 1,BFS vs DFS):同一条 BFS 游走(黄线)倾向遍历中心节点的 局部邻居(u、s1、s2、s3),学出的 embedding 里结构相近的节点聚在一起(同质 homophily); 而 DFS 游走(红线)沿一条路深入(u → s4 → x → y),使 同社区/同角色的节点表示更接近 (结构等价 structural equivalence);
- 下图(论文 Figure 2,p/q 参数):当前在节点 v、上一步来自节点 t—— 返回参数 p 控制"回到上一步节点"的权重(p 小→更爱回走,倾向 BFS), 进出参数 q 控制"离上一步远近"的权重(q 小→更爱远走,倾向 DFS);
- 怎么读:图的下半部分是状态转移概率分布——p/q 通过缩放边权重,把随机游走 塑造成"BFS 式"或"DFS 式",从而控制 embedding 编码同质性还是结构等价性。
📄 经典论文原图:BFS 与 DFS 游走偏好
🔍 图解与逻辑衔接:图左展示 BFS 式游走:围绕起点反复访问局部邻居,因此更适合学习社区内的同质性;图右展示 DFS 式游走:沿路径深入更远节点,更容易发现不同位置但结构角色相似的节点。这张图是上一张 p/q 状态转移图的结果层解释:p/q 改变局部转移概率,最终改变采样序列的统计性质,进而改变 embedding 表示的语义。
论文出处:Grover & Leskovec, node2vec, KDD 2016(arXiv:1607.00653),Figure 1。
print('''Node2Vec 两个超参:
  p(Return):控制回到上一节点的概率(p 大 = 不走回头路,倾向 DFS);
  q(In-out):控制走向邻居还是更远(q 大 = BFS 倾向,q 小 = DFS 倾向);
  BFS 游走 -> 学习"角色/结构"(如两个不同社区的门卫相似);
  DFS 游走 -> 学习"同质/邻近"(相连的节点向量相近)。
''')
# 简化演示:从 E 出发,看不同 p/q 下的 2 步选择
def n2v_step(G, node_list, prev, cur, p=1.0, q=1.0, seed=42):
    r = np.random.default_rng(seed)
    nbrs = list(G.neighbors(cur))
    weights = []
    for nxt in nbrs:
        if nxt == prev:
            w = 1.0 / p      # 返回
        elif G.has_edge(prev, nxt) or G.has_edge(nxt, prev):
            w = 1.0          # 与上一节点相连
        else:
            w = 1.0 / q      # 其他
        weights.append(w)
    chosen = r.choice(nbrs, p=np.array(weights) / sum(weights))
    return node_list.index(str(chosen))

print('p=0.5(爱返回) E 的下一步:', chr(65 + n2v_step(G, node_list, 'D', 'E', p=0.5, q=1.0, seed=1)))
print('p=2.0(避返回) E 的下一步:', chr(65 + n2v_step(G, node_list, 'D', 'E', p=2.0, q=1.0, seed=1)))
print('✅ Node2Vec 通过 p/q 控制游走语义')
Node2Vec 两个超参:
  p(Return):控制回到上一节点的概率(p 大 = 不走回头路,倾向 DFS);
  q(In-out):控制走向邻居还是更远(q 大 = BFS 倾向,q 小 = DFS 倾向);
  BFS 游走 -> 学习"角色/结构"(如两个不同社区的门卫相似);
  DFS 游走 -> 学习"同质/邻近"(相连的节点向量相近)。

p=0.5(爱返回) E 的下一步: D
p=2.0(避返回) E 的下一步: D
✅ Node2Vec 通过 p/q 控制游走语义
6️⃣ 图表示 vs 词向量(面试对比)¶
print('''| 维度 | 词向量 (word2vec) | 图表示 (DeepWalk/Node2Vec) |
|---|---|---|
| 语料 | 句子序列 | 随机游走序列 |
| 上下文 | 窗口内词 | 窗口内节点 |
| 模型 | skip-gram/CBOW | 同(套用) |
| 目标 | 词共现 | 节点共现/结构 |
| 局限 | 词序假设 | 游走策略依赖 |

后续 GNN 用"消息传递"替代游走+word2vec,可直接上监督任务。
''')
| 维度 | 词向量 (word2vec) | 图表示 (DeepWalk/Node2Vec) |
|---|---|---|
| 语料 | 句子序列 | 随机游走序列 |
| 上下文 | 窗口内词 | 窗口内节点 |
| 模型 | skip-gram/CBOW | 同(套用) |
| 目标 | 词共现 | 节点共现/结构 |
| 局限 | 词序假设 | 游走策略依赖 |

后续 GNN 用"消息传递"替代游走+word2vec,可直接上监督任务。
🎯 真实案例:Zachary 空手道俱乐部社交网络分析¶
背景:这是图网络领域的经典真实数据集——美国一所大学的空手道俱乐部, 34 名成员之间 78 条社交关系(一起训练/社交)。后来教练与管理员发生冲突, 俱乐部分裂成两派。我们能用图分析"看出"谁会跟谁吗? 这正是图数据的典型价值。
真实数据 × 图的三大分析:
- 结构洞察:度数、聚类系数、介数中心性——谁是这个网络的"枢纽/桥"?
- 社区发现:用连通分量/模块度看天然分成几派;
- 链路预测铺垫:哪些"未连边"的成员未来最可能走近(见 03 篇)。
步骤分解:加载数据 → 基础指标 → 中心性排序 → 社区划分可视化 → 结论解读。
# ===== 案例:Karate 俱乐部社交网络 =====
Gk = nx.karate_club_graph()
print(f'真实社交网络:{Gk.number_of_nodes()} 名成员,{Gk.number_of_edges()} 条社交关系')
print()

# 1) 结构指标:谁是这个网络的枢纽?
deg = dict(Gk.degree())
top_deg = sorted(deg.items(), key=lambda x: -x[1])[:5]
print('1️⃣ 度数最高的 5 人(社交活跃者):', top_deg)
bc = nx.betweenness_centrality(Gk)
top_bc = sorted(bc.items(), key=lambda x: -x[1])[:3]
print('2️⃣ 介数中心性最高的 3 人(连接不同圈子的桥):', top_bc)
print('   ➡️ 桥节点一旦离开,两个圈子就失联——风控里叫"关键传播节点"')

# 2) 社区发现:图天然分成几派?
print()
print('3️⃣ 连通分量(全连通=一个整体):', len(list(nx.connected_components(Gk))), '个')
print('4️⃣ 聚类系数(小圈子聚集程度):', round(nx.average_clustering(Gk), 3),
      '(>0.3 说明社区结构明显)')

# 3) 可视化:按真实分裂标签着色
print()
labels_true = np.array([1 if Gk.nodes[i]['club'] == 'Mr. Hi' else 0 for i in Gk.nodes()])
plt.figure(figsize=(6.5, 5))
pos = nx.spring_layout(Gk, seed=42)
nx.draw(Gk, pos, with_labels=True, node_color=['#2563eb' if l else '#f59e0b' for l in labels_true],
        node_size=420, font_size=8, font_color='white')
plt.title('Karate 俱乐部:蓝=Mr.Hi 派,橙=Officer 派(真实分裂标签)', fontsize=10.5)
plt.show()

# 4) 结论:只用"结构"能预测分裂吗?——用谱划分(Fiedler 向量)
print()
A_mat = nx.to_numpy_array(Gk)
L_mat = np.diag(A_mat.sum(1)) - A_mat          # 拉普拉斯矩阵
w_val, V_val = np.linalg.eigh(L_mat)           # 特征分解
fiedler = V_val[:, 1]                          # 第二小特征值对应向量(Fiedler 向量)
split = fiedler > np.median(fiedler)           # 按符号/中位数划分两派
acc = max((split == labels_true).mean(), (split == ~labels_true).mean())
print(f'5️⃣ 谱划分(Fiedler 向量)与真实派别的吻合度: {acc:.1%}')
print('   ➡️ 谱图论:拉普拉斯第二特征向量天然给出"最自然的两分"——社区发现的数学基石')
assert acc > 0.7
print('✅ 真实案例完成:Karate 社交网络的谱划分与社区发现')
真实社交网络:34 名成员,78 条社交关系

1️⃣ 度数最高的 5 人(社交活跃者): [(33, 17), (0, 16), (32, 12), (2, 10), (1, 9)]
2️⃣ 介数中心性最高的 3 人(连接不同圈子的桥): [(0, 0.43763528138528146), (33, 0.30407497594997596), (32, 0.145247113997114)]
   ➡️ 桥节点一旦离开,两个圈子就失联——风控里叫"关键传播节点"

3️⃣ 连通分量(全连通=一个整体): 1 个
4️⃣ 聚类系数(小圈子聚集程度): 0.571 (>0.3 说明社区结构明显)


5️⃣ 谱划分(Fiedler 向量)与真实派别的吻合度: 100.0%
   ➡️ 谱图论:拉普拉斯第二特征向量天然给出"最自然的两分"——社区发现的数学基石
✅ 真实案例完成:Karate 社交网络的谱划分与社区发现
C:\Users\24260\AppData\Local\Temp\ipykernel_15744\1307605272.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
📝 自测清单¶
- 能用 networkx 建图并计算度/最短路/连通分量/聚类系数
- 能写随机游走并解释 DeepWalk 思想
- 能解释 Node2Vec 的 p/q 与 BFS/DFS 语义
- 能对比图表示与词向量