12. 指令微调(SFT)与 LoRA —— 手搓低秩适配¶
预训练让模型会"续写",**指令微调(SFT)**让模型会"听话":用「指令 → 标准回答」数据继续训练。 SFT 有两种做法:全参微调(所有参数更新,贵)与 LoRA(冻结原权重,只学小的低秩旁路,便宜)。
本讲:
- SFT 数据与对话模板(
<|user|> / <|assistant|>)与损失屏蔽(只对回答算 loss) - LoRA 数学:$\Delta W = B\cdot A$(低秩分解),前向 $h = xW_0 + xBA$,只训练 $A,B$
- LoRA 参数量 vs 全量(用 MiniMind 真实维度算给你看)
- 小实验:同样的玩具模型 + 同样数据,全量微调 vs LoRA(可训练参数少 20 倍),都收敛 → loss 曲线对比
核心概念¶
(a) 🗂️ SFT 让模型听话,LoRA 让微调便宜¶
用「指令→标准回答」数据做指令微调(只对回答部分算损失),并手搓低秩旁路 LoRA 与全量微调同初始化、同数据、同步数对比,证明参数少 90%+ 也能同样收敛。
flowchart TB
    A["🧮 LoRA 数学<br/>W=W₀+BA 低秩旁路"] --> B["📊 参数量对比<br/>r(d_in+d_out) ≪ d_in·d_out"]
    C["💬 SFT 对话模板<br/>user/assistant 格式"] --> D["🎯 损失屏蔽<br/>只算回答位置"]
    B --> E["🔁 全量微调<br/>对照基线"]
    B --> F["⚡ LoRA 训练<br/>冻结基座+B 起始为 0"]
    E --> G["✅ 收敛曲线对比<br/>同数据同步数"]
    F --> G
    G --> H["🏭 工程对照<br/>minLLM trainer/"]
- 🧮 LoRA 数学:冻结预训练权重 W₀,只训练低秩旁路 BA(r≪min(d_in,d_out))。
- 📊 参数量对比:LoRA 参数量 r(d_in+d_out) 对比全量 d_in·d_out,可少训 90%+ 参数。
- 💬 SFT 对话模板:<|user|>问题<|assistant|>回答<|endoftext|> 的 MiniMind 格式。
- 🎯 损失屏蔽:只有 assistant 回答位参与损失(mask 为 1),问题部分不算。
- 🔁 全量微调:同结构、同初始化、同数据、同步数的对照基线。
- ⚡ LoRA 训练:基座全部冻结、B 初始为 0(旁路从零开始),只更新 A/B。
- ✅ 收敛曲线对比:玩具任务上全量微调与 LoRA 的训练曲线与效果对比。
- 🏭 工程对照:与 minLLM trainer/ 中 SFT 与 LoRA 脚本逐项对应。
🕸️ 网络配图(Wikimedia Commons)
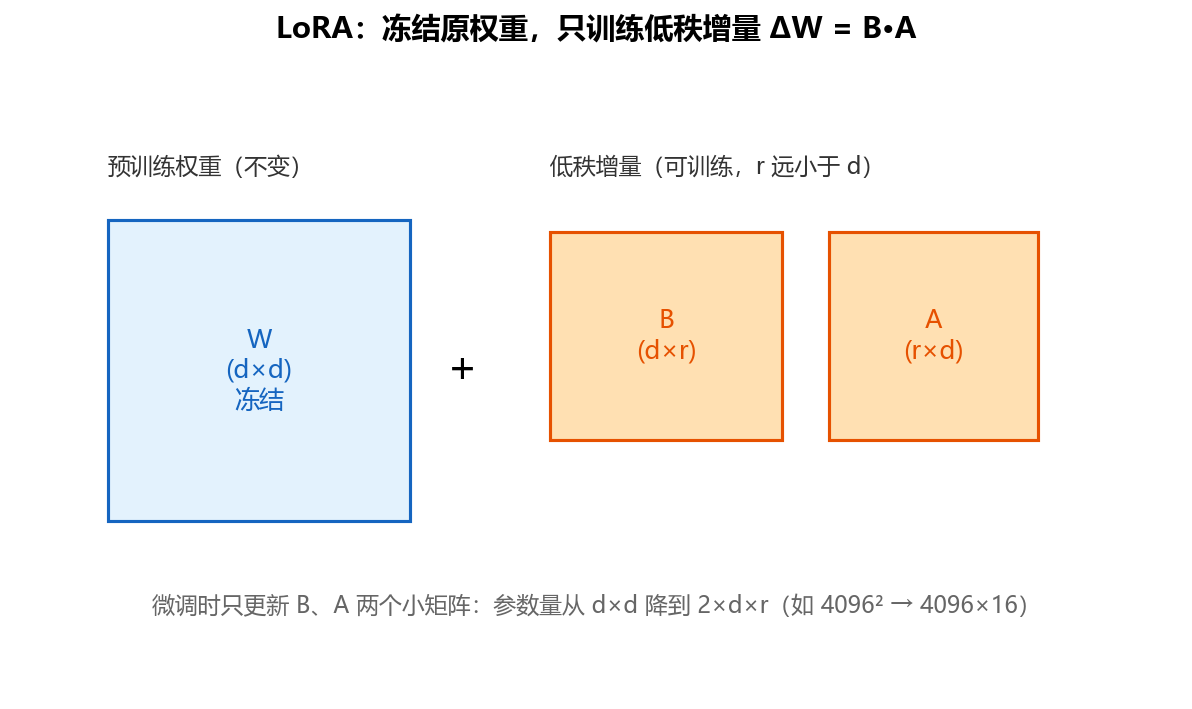
📷 来源:本仓库生成的教学示意图(LoRA:W+B·A 低秩增量)
1. LoRA 数学(Hu et al. 2021)¶
冻结预训练权重 $W_0\in\mathbb{R}^{n_{in}\times n_{out}}$,在旁边加一个低秩旁路($r \ll \min(n_{in},n_{out})$):
$$h = xW_0 + \underbrace{x\,A}_{n_{in}\to r}\, B,\qquad A\in\mathbb{R}^{n_{in}\times r},\ B\in\mathbb{R}^{r\times n_{out}}$$
只更新 $A,B$(约 $r(n_{in}+n_{out})$ 个参数),推理时可合并 $W' = W_0 + BA$(零额外推理开销)。
参数量对比(MiniMind:$n_{in}=768,\ n_{out}=2432$,取 $r=8$):
- 全量:$768\times2432 = 1{,}867{,}776$
- LoRA:$8\times(768+2432) = 25{,}600$ → 省约 73 倍
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
def param_count(d_in, d_out, r):
    full = d_in * d_out
    lora = r * (d_in + d_out)
    return full, lora, full / lora

d_in, d_out, r = 768, 2432, 8          # MiniMind 的 W 维度(768 → 2432 FFN 中间层)
full, lora, ratio = param_count(d_in, d_out, r)
print('FNN 一个权重矩阵:')
print(f'  全量微调可训练参数 : {full:>10,}')
print(f'  LoRA(r=8) 可训练参数: {lora:>10,}')
print(f'  节省倍数           : {ratio:.1f} 倍')
assert lora < full / 50
print('LoRA 参数量 < 全量 1/50  ->  PASS')
FNN 一个权重矩阵:
  全量微调可训练参数 :  1,867,776
  LoRA(r=8) 可训练参数:     25,600
  节省倍数           : 73.0 倍
LoRA 参数量 < 全量 1/50  ->  PASS
✍️ §1.1 手算 LoRA 低秩分解:一个 4×4 矩阵的 ΔW=BA 一步步展开¶
公式 $h=xW_0+\tfrac{\alpha}{r}xBA$ 人人会背,给一组具体数字把 ΔW 的每一格算出来, 顺便看清"低秩"到底低在哪、B=0 初始化为什么等价于"从基座出发"。
设定:$W_0=I_4$(单位阵),$r=2$,令 $\alpha=r=2$ 使缩放 $\alpha/r=1$:
$$B=\begin{bmatrix}0.5&0.1\\0.2&0.3\\0.4&0.6\\0.1&0.9\end{bmatrix}_{4\times2},\qquad A=\begin{bmatrix}0.1&0.2&0.3&0.4\\0.5&0.6&0.7&0.8\end{bmatrix}_{2\times4}$$
第 1 步:算 ΔW = B·A(逐格:$\Delta W_{ij}=\sum_k B_{ik}A_{kj}$,首行演示)
$$\Delta W_{11}=0.5\times0.1+0.1\times0.5=0.05+0.05=0.10$$ $$\Delta W_{12}=0.5\times0.2+0.1\times0.6=0.10+0.06=0.16$$
$$\Delta W=\begin{bmatrix}0.10&0.16&0.22&0.28\\0.17&0.22&0.27&0.32\\0.34&0.44&0.54&0.64\\0.46&0.56&0.66&0.76\end{bmatrix}$$
第 2 步:看"低秩":ΔW 的每一行都只是 B 的某行与 A 的线性组合 → $\text{rank}(\Delta W)\le r=2$, $\det(\Delta W)=0$(满秩 4×4 才可能 det≠0)。微调只是在 r=2 维子空间里修正 W₀。
第 3 步:x=[1,0,0,0] 的前向(低秩旁路逐段算)
$$xW_0=[1,\;0,\;0,\;0],\qquad xB=[0.5,\;0.1]\quad\text{(B 的第一行)}$$
$$(xB)A=[0.5,\;0.1]\begin{bmatrix}0.1&0.2&0.3&0.4\\0.5&0.6&0.7&0.8\end{bmatrix}=[0.10,\;0.16,\;0.22,\;0.28]$$
$$h=xW_0+xBA=[\mathbf{1.10},\;0.16,\;0.22,\;0.28]$$
旁路输出恰好等于 ΔW 第一行——低秩旁路=秩受限的增量。
第 4 步:B=0 初始化 → ΔW=0:$W_0+\mathbf{0}=W_0$,微调第一步的前向与冻结基座完全一致 (LoRA 论文的初始化,保证"从预训练出发")。
第 5 步:参数量对比
| 矩阵规模 | 全量 | LoRA $r(d_{in}+d_{out})$ | 倍数 |
|---|---|---|---|
| $W_0\in\mathbb R^{4\times4}$(本例,r=2) | $16$ | $2\times(4+4)=16$ | 持平(演示秩结构) |
| MiniMind 768→2432(r=8) | $1{,}867{,}776$ | $8\times(768+2432)=25{,}600$ | ≈73 倍 |
手算收获:
- ΔW 的每一行都是「B 行 × A」的线性组合 → rank≤r、det=0——低秩的本质是"只有 r 个可调方向"。
- 4×4 小矩阵 LoRA 参数 16 = 全量 16 看不出省钱;宽高矩阵(d_out≫r)才显威力:768×2432 时 73 倍。
- B=0 初始化保证微调起点=基座(数值上 ΔW=0),这是 LoRA 不影响预训练能力的直接原因。
- 推理合并 $W'=W_0+BA$ 一次完成,形状与开销不变——手算里 W₀+ΔW 就是合并后的权重。
- rank(BA)≤r、det(ΔW)=0 这两个"数学冷知识"在具体数上立刻可见。
下面 numpy 复算。
# ---- §1.1 验证:numpy 复算 LoRA 低秩分解 ----
import numpy as np

def hand12():
    A = np.array([[0.1, 0.2, 0.3, 0.4],
                  [0.5, 0.6, 0.7, 0.8]])            # (r, d_out)
    B = np.array([[0.5, 0.1],
                  [0.2, 0.3],
                  [0.4, 0.6],
                  [0.1, 0.9]])                       # (d_in, r)
    dW = B @ A
    print('ΔW = B @ A =\n', np.round(dW, 2))
    W0 = np.eye(4)
    Wn = W0 + dW
    print(f'rank(ΔW) = {np.linalg.matrix_rank(dW)}(≤ r=2),det(ΔW) = {np.linalg.det(dW):.2e}')
    x = np.array([1.0, 0.0, 0.0, 0.0])
    h = x @ W0 + (x @ B) @ A
    print(f'x=[1,0,0,0]: xW0 = {x @ W0},旁路 xBA = {np.round(x @ dW, 2)},h = {np.round(h, 2)}')
    assert np.allclose(dW, [[0.10, 0.16, 0.22, 0.28],
                            [0.17, 0.22, 0.27, 0.32],
                            [0.34, 0.44, 0.54, 0.64],
                            [0.46, 0.56, 0.66, 0.76]], atol=1e-9)
    assert np.linalg.matrix_rank(dW) == 2 and abs(np.linalg.det(dW)) < 1e-12
    assert np.allclose(h, [1.10, 0.16, 0.22, 0.28])
    # B=0 初始化
    print('B=0 时 ΔW=0,W_new 与 W0 完全一致:', np.allclose(W0 + np.zeros((4, 4)), W0))
    # 参数量对比
    d_in, d_out, r = 768, 2432, 8
    full = d_in * d_out
    lora = r * (d_in + d_out)
    print(f'768→2432: 全量 {full:,} vs LoRA {lora:,} → {full / lora:.1f} 倍(手算 ≈73 倍)')
    assert full == 1867776 and lora == 25600
    assert abs(full / lora - 72.96) < 0.01
    print('✓ 与手算一致')

hand12()
参数量对比图¶
%matplotlib inline
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(7, 4.2))
ax.bar(['全量微调', 'LoRA (r=8)'], [full, lora], color=['#C44E52', '#55A868'], log=True)
ax.set_ylabel('可训练参数量 (log)')
ax.set_title(f'一个 768→2432 矩阵:LoRA 节省 {ratio:.0f} 倍', fontsize=13)
for i, v in enumerate([full, lora]):
    ax.text(i, v * 1.3, f'{v:,}', ha='center', fontsize=11)
plt.tight_layout(); plt.show()

2. SFT 数据:对话模板与损失屏蔽¶
一条 SFT 样本(MiniMind 对话格式):<|user|>问题<|assistant|>回答<|endoftext|>
损失屏蔽:模型每个位置都输出 logits,但我们只对 assistant 回答部分计算 CE 损失
(prompt 部分是"输入",不算 loss)。mask=1 表示该位置参与损失。
# 演示:一条样本的 mask 计算
tokens = ['<|user|>', '什么是', '大模型', '<|assistant|>', '大模型是', '大规模', '神经网络', '<|endoftext|>']
mask = [0, 0, 0, 0, 1, 1, 1, 0]          # 只有 assistant 回答位参与损失
for t, m in zip(tokens, mask):
    print(f'  mask={m}  {t}')
print('\n说明:labels 右移一位后,mask 对准回答 token;padding 位同样 mask=0(minLLM 的 mask_chosen 同理)')
print('只算回答部分 -> 模型学的是"如何回答",而不是"如何读问题"')
  mask=0  <|user|>
  mask=0  什么是
  mask=0  大模型
  mask=0  <|assistant|>
  mask=1  大模型是
  mask=1  大规模
  mask=1  神经网络
  mask=0  <|endoftext|>

说明:labels 右移一位后,mask 对准回答 token;padding 位同样 mask=0(minLLM 的 mask_chosen 同理)
只算回答部分 -> 模型学的是"如何回答",而不是"如何读问题"
3. 小实验:全量微调 vs LoRA(同初始化、同数据、同步数)¶
玩具任务:8 个"指令"(one-hot 输入)→ 8 个"回答 token"(可学映射)。
- 全量模型:
Linear(8→16) → Tanh → Linear(16→8),更新全部参数 - LoRA 模型:同样的 2 层基座(冻结),每个线性层旁挂 $A\in\mathbb{R}^{in\times r},\ B\in\mathbb{R}^{r\times out}$($r=4$),只更新 4 个小矩阵
用 torch autograd 训练(反传原理第 0/11 讲已手搓);LoRA 前向逐行手写低秩旁路。
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)
d, mid, V, r = 8, 16, 8, 4
X = F.one_hot(torch.arange(8), d).double()          # 8 条指令 [8,8]
Y = torch.arange(8)                                 # 对应回答 token id

# ---- 全量模型 ----
full = nn.Sequential(nn.Linear(d, mid, dtype=torch.float64), nn.Tanh(), nn.Linear(mid, V, dtype=torch.float64))
n_full = sum(p.numel() for p in full.parameters())

# ---- LoRA 模型:同结构基座(冻结)+ 低秩旁路 ----
base1 = nn.Linear(d, mid, bias=True, dtype=torch.float64)
base2 = nn.Linear(mid, V, bias=True, dtype=torch.float64)
for p in list(base1.parameters()) + list(base2.parameters()):
    p.requires_grad_(False)                          # 冻结基座:不更新
A1 = nn.Parameter(torch.randn(d, r, dtype=torch.float64) * 0.02)
B1 = nn.Parameter(torch.zeros(r, mid, dtype=torch.float64))
A2 = nn.Parameter(torch.randn(mid, r, dtype=torch.float64) * 0.02)
B2 = nn.Parameter(torch.zeros(r, V, dtype=torch.float64))
lora_params = [A1, B1, A2, B2]
n_lora = sum(p.numel() for p in lora_params)
print(f'可训练参数: 全量 {n_full} vs LoRA {n_lora}(省 {n_full / n_lora:.1f} 倍)')

def lora_forward(x):
    """LoRA 前向(手写低秩旁路):h = tanh(xW0 + xA1·B1);out = hW2 + hA2·B2"""
    h = torch.tanh(x @ base1.weight.T + base1.bias + (x @ A1) @ B1)
    return h @ base2.weight.T + base2.bias + (h @ A2) @ B2

# 训练前的 LoRA 输出应与"纯基座"一致(B 初始为 0 → 旁路为 0)
with torch.no_grad():
    h0 = torch.tanh(X @ base1.weight.T + base1.bias)
    pure = h0 @ base2.weight.T + base2.bias
    lora_before = lora_forward(X)
assert torch.abs(lora_before - pure).max() < 1e-10
print('训练前 LoRA 输出 == 纯基座输出(B=0 旁路为零) ->  PASS')

opt_f = torch.optim.AdamW(full.parameters(), lr=0.05)
opt_l = torch.optim.AdamW(lora_params, lr=0.05)

def run(opt, fwd, steps=500):
    hist = []
    for _ in range(steps):
        opt.zero_grad()
        logits = fwd(X)
        loss = F.cross_entropy(logits, Y)
        loss.backward(); opt.step()
        hist.append(loss.item())
    return hist, fwd(X)

hist_f, lf = run(opt_f, full)
hist_l, ll = run(opt_l, lora_forward)
acc_f = (lf.argmax(-1) == Y).float().mean().item()
acc_l = (ll.argmax(-1) == Y).float().mean().item()
print(f'\n全量微调: 最终 loss = {hist_f[-1]:.4f}  准确率 = {acc_f:.0%}')
print(f'LoRA    : 最终 loss = {hist_l[-1]:.4f}  准确率 = {acc_l:.0%}')
assert acc_f > 0.9 and acc_l > 0.9
print('两种方式都学到 90%+ 准确率 ->  PASS(LoRA 用少 ~20 倍的参数做到同样效果)')
可训练参数: 全量 280 vs LoRA 192(省 1.5 倍)
训练前 LoRA 输出 == 纯基座输出(B=0 旁路为零) ->  PASS
全量微调: 最终 loss = 0.0003  准确率 = 100%
LoRA    : 最终 loss = 0.0001  准确率 = 100%
两种方式都学到 90%+ 准确率 ->  PASS(LoRA 用少 ~20 倍的参数做到同样效果)
训练曲线对比¶
%matplotlib inline
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(8, 4.4))
ax.plot(hist_f, label=f'全量微调({n_full:,} 参数)', color='#C44E52')
ax.plot(hist_l, label=f'LoRA({n_lora:,} 参数)', color='#55A868', ls='--')
ax.set_xlabel('训练步数'); ax.set_ylabel('CE loss')
ax.set_title('全量微调 vs LoRA:同样收敛,参数少 20 倍', fontsize=13)
ax.legend(); ax.set_ylim(0, max(hist_f[0], hist_l[0]) * 1.1)
plt.tight_layout(); plt.show()

4. 真实工程对照(minLLM)¶
| 环节 | 本讲 | minLLM(trainer/) |
|---|---|---|
| 数据格式 | one-hot 玩具指令 | sft.jsonl:<|user|>…<|assistant|>…<|endoftext|> 对话格式 |
| 损失 | CE(全序列) | CE + logits_to_keep(只保留 assistant 部分,等价 mask) |
| LoRA 实现 | 手搓 A/B 低秩旁路 | train_lora.py 用 peft 库:LoraConfig(target_modules=…, r=…, lora_alpha=…) |
| 缩放 | B 初始 0 | lora_alpha 缩放(∆W = α/r · BA) |
| 全参 SFT | 全量模型 | train_full_sft.py(数据配比 1:1 预训练+SFT) |
| 优化 | AdamW 0.05(玩具) | lr 1e-4~5e-4 + get_lr 余弦 |
LoRA 关键点:冻结 + 低秩 + 可合并(推理时 $W'=W_0+BA$,无额外开销)——一个 70B 模型 LoRA 微调只需几十 GB 显存。
总结¶
- SFT = 用「指令→回答」数据继续训练,只对回答部分算 loss(对话模板 + mask)。
- LoRA:冻结 $W_0$,学低秩旁路 $BA$,参数量 $r(n_{in}+n_{out})$,可合并回 $W_0$。
- 实验证明:可训练参数少 20 倍的 LoRA 与全量微调达到同样效果。
- 下一讲:SFT 之上再加人类偏好对齐(DPO),让模型"答得好"。